Онлайн-инструмент позволяет автоматически извлечь данные накладной из отсканированного документа или фотографии бумажного бланка для дальнейшей работы с текстом и числами. Пользователь загружает изображение первичного документа, а система преобразует графические символы в редактируемый текст. Вместо ручного перепечатывания номеров, дат и товарных позиций формируется готовый набор текстовых и числовых значений. Это исключает опечатки при переносе сведений в учетные таблицы и сокращает время на обработку входящей документации.
Исходный скан или снимок представляет собой обычный набор пикселей, в котором учетная программа не видит ни букв, ни табличных ячеек. Инструмент выполняет переход от статичного графического представления к машиночитаемому формату с четким разделением информации по смысловым блокам.
В процессе обработки распознаются как общие реквизиты из шапки бланка, так и многострочные перечни товаров с ценами, количеством и суммами налога. Каждое найденное значение привязывается к соответствующему логическому полю документа. На выходе получается структурированная информация, полностью готовая к копированию, проверке арифметических итогов и прямой загрузке в складские или бухгалтерские базы.
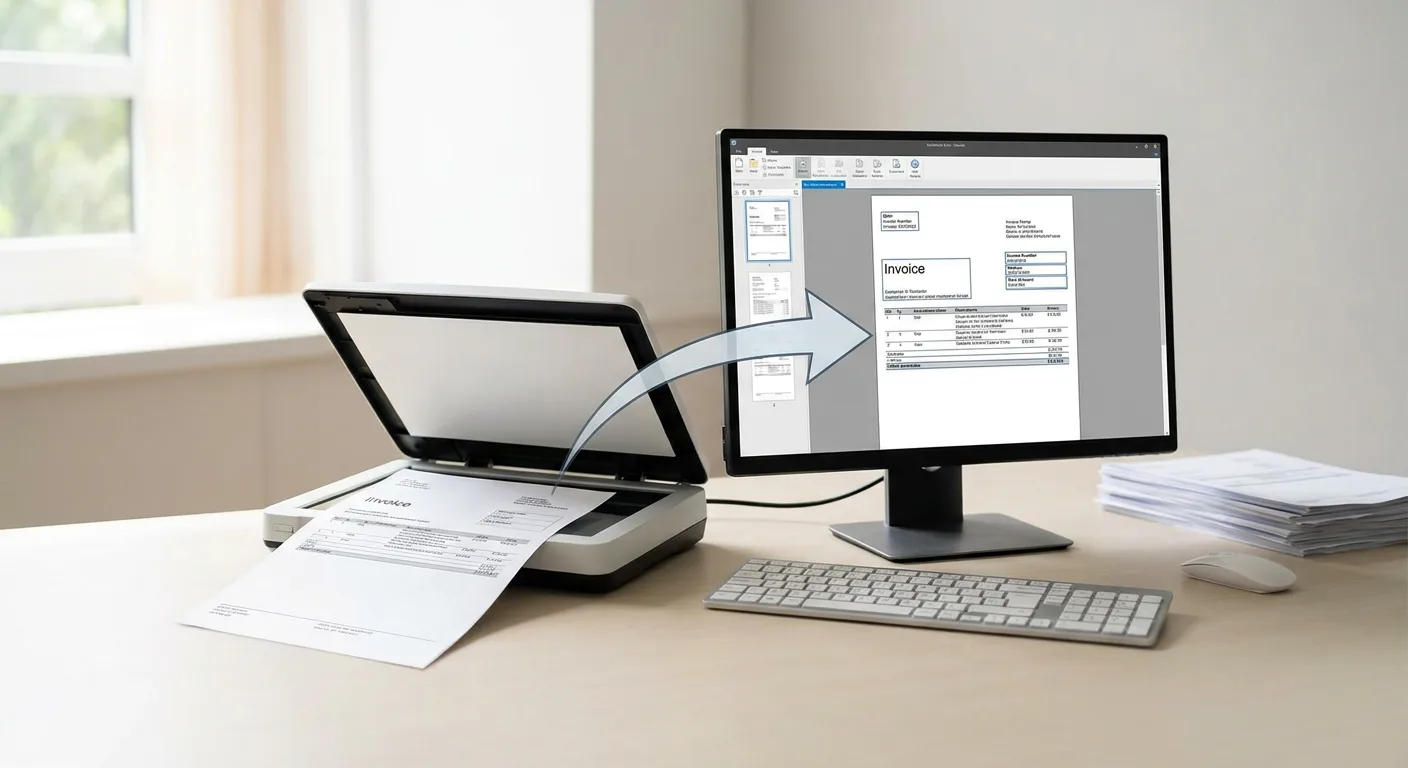
Принцип оптического распознавания текста и полей в накладных
Техническая механика извлечения данных из первичной документации опирается на технологию OCR в сочетании с анализом пространственной структуры документа. Обычное считывание знаков подряд превратило бы накладную в сплошной несвязный массив текста, где названия компаний перемешаны с колонками цен и единицами измерения. Чтобы сохранить деловую логику бланка, процесс разделяется на геометрический разбор макета страницы и непосредственное прочтение символов внутри найденных областей.
Сегментация макета страницы
До начала работы с отдельными буквами и цифрами выполняется структурная сегментация изображения. Алгоритмы анализируют распределение темных и светлых участков, находят горизонтальные и вертикальные разделительные линии, отступы и визуальные границы элементов. На этом этапе плоский лист делится на изолированные функциональные зоны.
При разборе структуры накладной выделяются три основных типа объектов:
- Текстовые блоки, содержащие сплошные строки с описательной информацией, основаниями для отгрузки или дополнительными условиями.
- Зоны реквизитов, где информация организована по принципу «ключ - значение» и располагается в верхней или нижней части бланка.
- Встроенные таблицы, образованные сеткой пересекающихся линий или выровненными по вертикали столбцами чисел и наименований.
Разделение макета на независимые участки позволяет обрабатывать каждую ячейку таблицы или блок реквизитов как отдельную микространицу. Это предотвращает слияние соседних колонок при построчном чтении.
Этапы работы алгоритмов распознавания
После того как границы всех структурных блоков размечены, запускается пошаговая процедура перевода графических контуров в символьные коды и осмысленные записи. Весь цикл обработки внутри выделенных зон можно представить в виде последовательных стадий:
| Этап обработки | Техническая задача | Результат выполнения |
|---|---|---|
| Локализация печатных символов | Поиск границ отдельных знаков внутри строк и ячеек по перепадам яркости пикселей | Набор координатных рамок для каждого отдельного печатного знака на странице |
| Классификация глифов | Анализ геометрических признаков контура (дуг, линий, углов, пересечений) и сопоставление с эталонными начертаниями шрифтов | Присвоение каждому графическому фрагменту цифрового кода конкретной буквы, цифры или знака препинания |
| Сборка слов и строк | Группировка распознанных символов с учетом межбуквенных интервалов, пробелов и словарных правил | Связные слова, числовые значения и фразы в формате редактируемого текста |
| Привязка к логическим полям | Сопоставление текстовых строк с их координатами на макете, заголовками столбцов и текстовыми метками | Структурированный набор пар «поле - значение» и заполненные табличные строки |
На этапе локализации алгоритмы отделяют печатные знаки от фонового пространства и линий табличной сетки. Каждая буква или цифра заключается в индивидуальный ограничивающий прямоугольник. Далее вступает в действие механизм классификации глифов. Глиф представляет собой конкретное графическое изображение символа в определенном шрифте. Алгоритм вычисляет вектор признаков найденного контура и определяет, какому именно знаку алфавита или цифровому ряду соответствует данная фигура.
Разрозненные символы объединяются на стадии сборки слов. Здесь анализируется расстояние между соседними рамками знаков: малый интервал указывает на принадлежность букв к одному слову, а увеличенный разрыв интерпретируется как пробел между словами. Для чисел критически важен точный учет разделителей целой и дробной части, а также пробелов между разрядами тысяч.
Завершающий шаг - привязка извлеченных значений к логическим полям документа. Собранное слово или число само по себе не несет учетного смысла без понимания его роли в бланке. Алгоритмы сопоставляют координаты распознанного фрагмента с соседними текстовыми метками или шапкой таблицы. Если числовой блок находится в колонке под заголовком цены, ему присваивается соответствующий атрибут. Аналогично текст, расположенный справа от подписи грузополучателя, связывается с полем получателя. Благодаря такой привязке на выходе формируется не просто редактируемый текст, а упорядоченная структура данных, точно отражающая содержание исходного бумажного носителя.
Структура извлекаемых реквизитов и табличной части документа
Упорядоченная структура, формируемая после привязки значений к логическим полям, делится на две основные функциональные зоны. Первая содержит общие регистрационные сведения о сделке и ее участниках, вторая детально описывает передаваемые материальные ценности и их стоимостные показатели. Такое разделение отражает стандартную архитектуру первичной учетной документации, где единый блок метаданных управляет множеством подчиненных товарных строк.
Шапка документа и реквизиты сторон
Верхняя зона бланка фиксирует юридический и финансовый контекст хозяйственной операции. Извлечение этих параметров позволяет однозначно идентифицировать документ во времени и определить контрагентов без ручного перепечатывания длинных цифровых кодов. В состав данных шапки входят следующие атрибуты:
- Номер и дата составления - базовые идентификаторы документа, определяющие учетный период операции и служащие для привязки к договорам или счетам на оплату.
- Наименования поставщика и покупателя - полные или сокращенные названия организаций и индивидуальных предпринимателей, включая их организационно-правовую форму, а также сведения о грузоотправителе и грузополучателе, если они отличаются от плательщика и продавца.
- ИНН и КПП - числовые налоговые коды, однозначно определяющие контрагента и его обособленное подразделение. Точное считывание этой пары цифр исключает путаницу между одноименными компаниями.
- ОГРН или ОГРНИП - регистрационные номера, подтверждающие статус юридического лица или индивидуального предпринимателя в государственных реестрах.
- Банковские и адресные сведения - юридические и фактические адреса сторон, адреса доставки груза, а также расчетные и корреспондентские счета, наименования банков и коды БИК, необходимые для финансовых расчетов.
- Номер ГТД - регистрационный код таможенной декларации, который присутствует в реквизитах или специализированных графах при реализации импортной продукции и прослеживаемых товаров.
Табличная часть и итоговые показатели
Основной массив информации сосредоточен в табличной сетке, где каждая горизонтальная строка представляет собой отдельную товарную позицию, а вертикальные колонки задают ее количественные и ценовые характеристики. При оцифровке сохраняется строгая принадлежность каждого значения конкретной строке и столбцу.
Ниже приведена структура данных, извлекаемых из товарной таблицы и подвала накладной:
| Поле табличной части | Тип данных | Назначение в структуре документа |
|---|---|---|
| Порядковый номер | Целое число | Фиксирует очередность записи в списке и позволяет контролировать полноту извлечения всех строк многостраничной таблицы. |
| Артикул или код товара | Символьно-числовой код | Внутренний или каталожный идентификатор позиции, используемый для быстрого сопоставления со справочником номенклатуры. |
| Наименование позиции номенклатуры | Текстовая строка | Полное описание товара, включая марку, модель, сорт, размер или фасовку. Часто занимает несколько строк внутри одной ячейки. |
| Единица измерения | Текст или цифровой код | Обозначение меры учета (штуки, килограммы, метры, упаковки) и соответствующий ей классификационный код по справочнику. |
| Количество | Числовое значение | Объем отгруженной продукции в указанных единицах измерения; может быть как целым, так и дробным числом. |
| Цена за единицу | Денежное значение | Стоимость одной учетной единицы товара без учета косвенных налогов. |
| Сумма без учета налога | Денежное значение | Общая стоимость товарной позиции до начисления налога, определяемая по количеству и цене за единицу. |
| Ставка НДС | Процент или текст | Применяемый тариф налога в процентах, расчетная ставка или текстовая отметка об освобождении от налогообложения (например, «Без НДС»). |
| Сумма НДС | Денежное значение | Денежное выражение налога, начисленного на конкретную товарную строку согласно указанной ставке. |
| Итоговые суммы по документу | Денежные и количественные значения | Сводные показатели в нижней части таблицы (постраничные итоги и финальная строка всей накладной), фиксирующие общее количество мест или массы, суммарную стоимость без налога, общий размер НДС и окончательную сумму к оплате с учетом налога. |
Помимо табличных граф, при обработке нижней зоны бланка могут извлекаться сведения о количестве листов документа и текстовые записи итоговой суммы прописью. Четкое разделение распознанного текста на реквизиты шапки, номенклатурные строки и финальные итоги превращает плоское изображение в готовую информационную модель первичного документа.
Специфика структуры разных типов накладных при оцифровке
Точность привязки распознанных значений к логическим полям напрямую зависит от топологии исходного бланка. В первичном документообороте применяются как регламентированные государственные формы с заранее известным положением каждого блока, так и произвольные коммерческие шаблоны, где геометрия элементов варьируется от поставщика к поставщику.
Жестко структурированные бланки и полуструктурированные документы
С точки зрения анализа макета страницы все первичные учетные документы делятся на две категории по степени фиксации их визуальной сетки.
Жестко структурированные бланки обладают неизменной геометрией: каждое поле имеет постоянные относительные координаты, фиксированный порядок следования граф и стандартные текстовые метки. Однако даже унифицированные табличные формы на практике часто приобретают свойства полуструктурированных документов, поскольку высота строк и общая протяженность таблицы динамически изменяются в зависимости от количества товарных позиций и длины их наименований. В таких случаях шапка и подвал документа сохраняют стандартную верстку, но смещаются по вертикали.
Полуструктурированные документы характеризуются плавающим расположением таблиц и реквизитов. В них отсутствует единый стандарт сетки: блок с данными грузоотправителя может находиться в левом или правом верхнем углу, столбцы таблицы меняются местами, а часть второстепенных граф может быть полностью скрыта. При оцифровке подобных изображений поиск нужных значений опирается не на жесткие координаты зоны, а на обнаружение ключевых слов-маркеров, заголовков колонок и разделительных линий таблицы.
Конструктивные особенности основных видов накладных
Различные типы сопроводительных документов имеют собственную архитектуру размещения данных, которая определяет порядок разбора страницы при переводе изображения в табличный и текстовый вид.
| Тип документа | Ориентация и макет | Структурные особенности при извлечении данных |
|---|---|---|
| Форма ТОРГ-12 | Альбомная, фиксированная сетка с динамической таблицей | Объемная верхняя зона с плотным расположением реквизитов сторон и кодов статистики в правой рамке. Табличная часть насчитывает 15 строго упорядоченных граф с двухуровневой шапкой и сквозной нумерацией столбцов. При большом числе позиций таблица разрывается на несколько листов с формированием промежуточных итогов по каждой странице и сводной строки по всему документу. |
| УПД | Альбомная, зонированный комбинированный макет | Визуально разделен вертикальной чертой в левой части на зону статуса документа (поле с кодом 1 или 2) и основное поле. Верхний блок объединяет реквизиты счета-фактуры и отгрузочного документа. Табличная часть включает дополнительные графы слева от наименования товара для кодов вида продукции, а нижняя область содержит сложную двухколоночную структуру передаточных и приемных подписей. |
| ТТН (форма 1-Т) | Двухсторонняя или многостраничная, смешанная ориентация | Состоит из двух самостоятельных разделов с разной структурой таблиц. Первый (товарный) раздел повторяет логику отгрузочной спецификации со стоимостными показателями. Второй (транспортный) раздел содержит специфические поля маршрута, сведений о транспортном средстве, водителе, способе определения массы груза и погрузочно-разгрузочных операциях. |
| Транспортная накладная | Книжная, блочно-секционная структура | Не содержит классической широкой таблицы со стоимостью и налоговыми ставками по номенклатуре. Документ разбит на 12 и более пронумерованных текстовых секций, расположенных последовательно на нескольких страницах. Основной массив извлекаемых данных представлен текстовыми блоками об условиях перевозки, характеристиках тары, массе брутто и оговорках перевозчика. |
| Форма ТОРГ-13 | Книжная или альбомная, упрощенная табличная сетка | Используется для учета движения ценностей внутри одной организации, поэтому в шапке отсутствуют внешние платежные реквизиты, ИНН и КПП сторонних контрагентов. Вместо них фиксируются наименования структурных подразделений (отправителя и получателя), вид операции и корреспондирующие счета бухгалтерского учета, а таблица содержит минимальный набор граф по количеству и учетной стоимости. |
| Коммерческий инвойс | Произвольная (чаще книжная), полуструктурированный макет | Оформляется на фирменном бланке поставщика без привязки к единому государственному шаблону. Названия колонок и реквизитов могут дублироваться на двух языках, состав столбцов варьируется (часто отсутствуют графы с выделенной суммой косвенного налога), а в документ включаются специфические блоки с условиями поставки, валютой счета и внешнеторговыми банковскими реквизитами. |
Нюансы сегментации сложных и многостраничных форм
При обработке первичных документов со сложной версткой особое значение имеет геометрия ячейки и плотность текста. В альбомах с большим числом колонок, таких как ТОРГ-12 и УПД, ширина числовых граф минимальна, из-за чего длинные денежные значения и дробное количество печатаются мелким шрифтом или переносятся на вторую строку внутри одной ячейки. Для корректного сбора данных границы ячейки должны считываться как единый контейнер, чтобы многострочное наименование товара или перенесенная сумма не приводили к ложному дроблению одной позиции на несколько отдельных записей.
В полуструктурированных инвойсах и отгрузочных спецификациях вертикальные разделительные линии между колонками нередко отсутствуют вовсе - столбцы выравниваются только за счет отступов. В такой ситуации распределение текста по графам опирается на выравнивание чисел по правому или левому краю и вертикальную проекцию заголовков таблицы. Дополнительную структурную особенность создают документы, в которых справочная информация (артикул, код партии, страна происхождения) не вынесена в отдельные столбцы, а вписана в графу с наименованием товара через разделители или скобки, что требует последующего разбора текстовой строки на составные атрибуты.
Требования к исходному изображению и факторы точности извлечения данных
Даже при четкой верстке бланка качество оцифровки напрямую зависит от визуальных характеристик исходного файла. Первичная документация проходит через склады, транспортные службы и кабинеты экспедиторов, поэтому на этапе сканирования или фотографирования бумага часто имеет дефекты, а само изображение получает оптические искажения. Для безошибочного перевода графических знаков в текстовый формат и точного сопоставления значений с графами таблицы исходный снимок должен отвечать базовым оптическим и геометрическим условиям.
Технические и геометрические параметры цифрового снимка
Разрешение сканирования определяет плотность пикселей, формирующих контуры букв и цифр. В многографных бланках, где текстовые и числовые данные набираются кеглем малого размера, недостаточная детализация приводит к ступенчатости краев и слиянию соседних знаков в единое пятно. Оптимальным ориентиром для плоских планшетных и потоковых сканеров считается плотность от 300 DPI. При более низких значениях мелкие индексы, коды и знаки препинания теряют четкость, а чрезмерно высокое разрешение утяжеляет файл и фиксирует микротекстуру бумажного волокна, которая воспринимается как фоновый шум.
Контрастность текста относительно фона отвечает за точность отделения символов от подложки при бинаризации изображения. Четкая граница между темным тонером и белым листом нарушается при сканировании документов на тонкой или серой газетной бумаге, когда сквозь страницу просвечивает оборотная сторона или нижележащий лист. При фотосъемке накладных камерой смартфона аналогичную проблему вызывает неравномерное освещение: тени от рук, блики от ламп или падение света под острым углом создают градиентные перепады яркости по площади листа.
На качество считывания табличной сетки и строк напрямую влияют геометрические и оптические факторы:
- Отсутствие перекосов страницы: поворот листа относительно горизонтальной оси при подаче в протяжный сканер смещает строки таблицы по диагонали, из-за чего значения из правых колонок (цены и суммы) могут ошибочно привязываться к соседним верхним или нижним позициям номенклатуры.
- Исключение перспективных искажений: съемка документа под углом превращает прямоугольный лист в трапецию, где масштаб шрифта и ширина ячеек плавно меняются от одного края кадра к другому, нарушая вертикальную проекцию столбцов.
- Резкость и отсутствие размытия: расфокусировка объектива или смазывание кадра из-за дрожания рук при мобильной съемке размывают четкие грани штрихов, превращая тонкие линии шрифта в полупрозрачный ореол.
Физические помехи и эксплуатационные дефекты бланка
Бумажные экземпляры накладных сопровождают физическое перемещение груза и неизбежно накапливают графические наслоения и механические повреждения. Посторонние элементы на листе перекрывают печатные символы или создают ложные контуры, которые искажают структуру ячеек и мешают распознаванию текста.
Типичные физические помехи на первичных учетных документах и характер их влияния на считывание данных систематизированы в таблице:
| Вид помехи на документе | Зона локализации | Влияние на считывание символов и структуры полей |
|---|---|---|
| Наложение оттисков синих печатей и штампов | Нижняя часть таблицы, блок итоговых сумм, зона реквизитов и подписей | Плотный слой штемпельной краски перекрывает контуры цифр и букв, снижая локальный контраст. Круглая рамка печати или прямоугольный контур штампа («Оплачено», «Груз принят») пересекает линии граф и искажает распознавание границ ячеек. |
| Рукописные пометки и подписи поверх граф | Колонки количества и наименования, строка итогов, подвал документа | Галочки, вычеркивания, ручные корректировки приемщика при расхождении партий и размашистые росчерки авторучкой сливаются с печатными глифами. Диагональный хвост подписи, заходящий в числовую ячейку, считывается как лишний символ или разделитель. |
| Следы сгибов бумаги и заломы | Поперечные и продольные линии по всей площади листа | При хранении сложенного вчетверо бланка на месте сгиба образуется рельефный рубец. При сканировании он дает темную полосу тени, которая визуально имитирует разделительную линию таблицы, либо приводит к осыпанию тонера прямо по строке с текстом. |
| Проколы от дырокола и скоб степлера | Левое или верхнее поле документа, зона порядковых номеров и кодов | При архивной подшивке накладных с узкими полями или альбомной ориентацией круглые отверстия дырокола вырезают начальные символы в названиях контрагентов, первые цифры порядковых номеров позиций или левую границу табличной сетки. |
| Выцветание термобумаги и матричной печати | Весь документ (складские квитанции, кассовые накладные, многослойные бланки) | На термобумаге текст быстро бледнеет от трения, тепла или солнечного света, теряя контраст с фоном. При печати на матричных принтерах с изношенной красящей лентой символы состоят из редких бледных точек, которые не сливаются в цельный контур при оцифровке. |
Соблюдение базовой гигиены сканирования минимизирует влияние этих факторов еще до программной обработки файла. Выравнивание загнутых углов, предварительное разглаживание жестких сгибов, очистка стекла сканера от пыли и съемка строго параллельно плоскости листа при равномерном рассеянном освещении позволяют сохранить целостность шрифтовой гарнитуры и четкость линий табличного макета.
Проверка и верификация извлеченных значений полей накладной
Даже при высоком качестве исходного бланка извлеченный из изображения текст требует обязательной верификации. Незначительный дефект печати или микроскопическая соринка на стекле сканера способны изменить одну цифру в цене или количестве, что приведет к расхождениям в первичном учете. Методология проверки оцифрованной накладной опирается на перекрестный арифметический пересчет табличных показателей и логический анализ структуры реквизитов.
Правила арифметического контроля табличной части
Табличный блок первичного документа представляет собой замкнутую математическую матрицу, где значения в графах и строках жестко связаны между собой. Выявление ошибок считывания цифр выполняется путем проверки базовых расчетных тождеств для каждой товарной позиции и по документу в целом.
Горизонтальный контроль проверяет математическую сходимость внутри одной номенклатурной строки. Для каждой позиции последовательно сверяются следующие соотношения:
- Произведение количества на цену за единицу должно совпадать со значением в графе стоимости товара без учета налога (с учетом стандартного математического округления до двух знаков после запятой).
- Расчетная сумма НДС определяется умножением стоимости позиции без налога на извлеченную процентную ставку НДС. Если в графе ставки указано значение без налога или нулевая ставка, в поле суммы налога должен стоять ноль либо прочерк.
- Итоговая стоимость позиции с учетом налога должна строго равняться сумме двух предыдущих расчетных полей: стоимости без учета налога и начисленной суммы НДС.
Вертикальный контроль заключается в сопоставлении построчных показателей с обобщающими строками документа. Сумма всех значений по отдельным колонкам (количество, стоимость без налога, сумма НДС и общая стоимость с налогом) сверяется с контрольной строкой «Всего по накладной». Если документ занимает несколько листов, дополнительно проверяются промежуточные итоги по каждой странице («Итого по странице»). Любое расхождение между суммой распознанных строк и распознанным итоговым значением прямо указывает на ошибку оцифровки конкретного числа в соответствующем столбце.
При проверке горизонтальных формул важно учитывать обратный метод расчета, который встречается в документах при реализации товаров по ценам, изначально включающим налог. В таких накладных первичной величиной выступает итоговая сумма с НДС, а сумма налога и цена без НДС рассчитываются от обратного. Из-за округления промежуточных значений до копеек при прямом умножении количества на цену без налога может возникать погрешность в одну-две копейки. Подобное расхождение при условии сходимости итоговой суммы с налогом и корректности суммы по столбцу не является ошибкой распознавания, а отражает специфику округления в исходном документе.
Типичные ошибки считывания символов и способы их выявления
При оптическом распознавании знаков искажения возникают не случайно, а по предсказуемым паттернам визуального сходства. Искажения делятся на межклассовые подмены (когда цифра распознается как буква или наоборот) и внутриклассовые ошибки (путаница между похожими цифрами или знаками препинания).
В таблице систематизированы характерные ошибки считывания символов в первичных документах и методы их обнаружения при верификации данных.
| Тип искажения при оцифровке | Примеры подмены символов | Уязвимые поля накладной | Способ выявления ошибки |
|---|---|---|---|
| Подмена цифр схожими по начертанию буквами | 0 и О, 1 и I (или l), 8 и В, 3 и З, 6 и б, 4 и Ч | ИНН, КПП, ОГРН, банковские счета, артикулы, номера документов, числовые графы таблицы | Проверка типа данных поля (в числовых графах и кодах реквизитов присутствие буквенных символов недопустимо). Контроль длины цифровых кодов. |
| Взаимная подмена графически близких цифр | 3 и 8, 5 и 6, 1 и 7, 0 и 8 (при размытии или плотной печати) | Количество, цена, суммы, ставка НДС, дата составления, номер ГТД | Горизонтальный и вертикальный пересчет табличных сумм. В реквизитах - проверка контрольных чисел в ИНН, ОГРН и расчетных счетах по алгоритмам ключевания. |
| Некорректное считывание разделителей дробной части | Запятая или точка пропускаются (125,50 превращается в 12550) либо принимаются за цифру 1; пробел между тысячами считывается как разделитель дроби | Количественные показатели (вес, объем), цена за единицу, стоимостные графы | Сверка порядка величин через произведение цены на количество. При потере разделителя расчетная сумма позиции увеличивается ровно в 100 или 1000 раз по сравнению с итогом по строке. |
| Ложная интерпретация дефектов фона и линий сетки | Вертикальная линия границы ячейки считывается как 1 или I; точка от грязи на сканере распознается как десятичный разделитель; тире в пустой графе считывается как минус | Узкие колонки таблицы (единицы измерения, ставка НДС, количество), поля с мелким шрифтом | Проверка на отрицательные значения (в стандартной накладной суммы и количество не могут быть меньше нуля). Сопоставление разрядности чисел с соседними строками. |
Логическая верификация реквизитов и текстовых полей
В отличие от табличной части, реквизиты шапки документа не связаны прямыми арифметическими формулами суммирования, поэтому для их проверки применяются форматные и логические правила.
Первичный фильтр отсеивает ошибки по длине и составу символов в стандартизированных кодах. КПП всегда состоит строго из 9 знаков, ОГРН юридического лица содержит 13 цифр, ОГРНИП - 15 цифр, а банковский расчетный и корреспондентский счета - по 20 цифр. Если при распознавании в этих полях обнаруживаются буквы О, З, В или I вместо цифр 0, 3, 8 и 1, либо общее количество знаков не совпадает с нормативом, поле помечается как содержащее ошибку оцифровки. Дополнительно для ИНН, ОГРН и банковских счетов применяется математическая проверка контрольного разряда по установленным весовым коэффициентам: случайная замена даже одной цифры (например, 6 на 5) приводит к несовпадению контрольного числа.
Особого внимания требуют смешанные буквенно-цифровые поля: артикулы товаров, серии документов, номера транспортных средств и номера ГТД. В этих значениях буквы и цифры могут чередоваться в произвольном порядке, поэтому простая фильтрация по типу символов не всегда выявляет подмену нуля на букву О или единицы на латинскую I. Для номера ГТД используется структурная проверка: код должен состоять из трех или четырех цифровых блоков, разделенных косой чертой (количество знаков в первых трех блоках строго фиксировано: 8 цифр кода таможни, 6 цифр даты и 7 цифр порядкового номера). В артикулах и номенклатурных кодах выверка проводится путем сопоставления распознанной строки со справочником существующих товарных позиций.
Логический контроль завершается проверкой дат и порядковой нумерации. Распознанная дата документа проверяется на календарную корректность (число месяца не может превышать 31, а номер месяца - 12; исключается считывание года как 2028 вместо 2023 при слиянии тройки). В табличной части проверяется непрерывность первой колонки: порядковые номера строк должны идти строго по возрастанию с шагом в единицу от первой позиции до последней. Пропуск номера в последовательности сигнализирует о том, что одна из строк накладной была пропущена при сегментации или слилась с соседней позицией.
Практическое применение извлеченных данных в товарном и бухгалтерском учете
Прошедшие верификацию текстовые блоки и значения полей передаются в учетные процессы предприятия, заменяя ручной набор с бумажного носителя. Разделение распознанной информации на реквизитную часть и построчный перечень товаров позволяет распределять данные по профильным контурам: складскому, финансовому, налоговому и архивному.
Оприходование материальных ценностей и складской учет
При приемке партии на складе основным рабочим массивом выступает табличная часть накладной. Извлеченные наименования номенклатурных позиций, артикулы, единицы измерения и количество используются для формирования документа поступления товаров. Чтобы избежать задвоения карточек в складской базе, распознанные текстовые наименования и артикулы поставщика сопоставляются с внутренним номенклатурным справочником покупателя.
Если поставщик использует собственные названия товаров или нестандартные сокращения, привязка выполняется по уникальному артикулу или коду позиции. Одновременно контролируется соответствие единиц измерения: когда в накладной товар отгружен в упаковках или бухтах, а внутренний учет ведется в штуках или метрах, извлеченное количество пересчитывается через установленный коэффициент упаковки. Для импортных поставок в карточку прихода дополнительно переносится распознанный номер ГТД и страна происхождения, что необходимо для последующего партионного учета и прослеживаемости товаров при дальнейшей отгрузке.
Проверка контрагентов и банковских реквизитов
До отражения финансового обязательства в учете реквизиты из шапки документа применяются для идентификации и проверки поставщика. Извлеченные ИНН, КПП и ОГРН или ОГРНИП позволяют точно найти организацию или индивидуального предпринимателя в государственных реестрах ЕГРЮЛ и ЕГРИП, исключая ошибки, возникающие при поиске по схожим коммерческим названиям.
Сверка распознанных реквизитов с данными ЕГРЮЛ и ЕГРИП решает несколько прикладных задач контроля:
- Подтверждение действующего статуса юридического лица или индивидуального предпринимателя на дату составления первичного документа.
- Выявление расхождений в юридическом адресе, наименовании или КПП, которые могут сделать документ недействительным при налоговой проверке.
- Сверка распознанного расчетного счета и БИК банка с реквизитами, указанными в договоре поставки, перед формированием платежного поручения на оплату партии.
Отражение операций в бухгалтерском и налоговом учете
Стоимостные показатели из табличной части и итоговой строки накладной служат основанием для формирования бухгалтерских проводок и налоговых регистров. Сумма без учета налога определяет фактическую себестоимость приобретаемых материально-производственных запасов и списывается на счета учета товаров или материалов. При расчете налога на прибыль или единого налога при упрощенной системе эти же значения формируют документально подтвержденную базу расходов после выполнения условий оплаты или реализации.
Отдельный контур обработки связан с учетом косвенных налогов. Если первичным документом выступает УПД со статусом, объединяющим накладную и счет-фактуру, либо к ТОРГ-12 приложен счет-фактура, извлеченные ставки и суммы НДС переносятся в книгу покупок для заявления налогового вычета. При наличии в одной накладной товаров, облагаемых по разным ставкам (например, стандартной и льготной), построчное извлечение данных позволяет автоматически разделить налоговую базу и корректно рассчитать сумму вычета по каждой группе товаров без ручной выборки позиций.
В таблице ниже показано распределение извлеченных полей накладной по конкретным участкам учета предприятия:
| Группа извлеченных данных | Целевой участок учета | Прикладная операция с данными |
|---|---|---|
| Номер и дата документа, ИНН, КПП, ОГРН/ОГРНИП | Контрагентский контроль и договорной учет | Проверка статуса поставщика по базам ЕГРЮЛ и ЕГРИП, привязка отгрузки к действующему договору |
| Артикул, наименование позиции, единица измерения, количество | Складской и товарный учет | Сопоставление со справочником номенклатуры, оприходование остатков на склад, контроль комплектности поставки |
| Цена за единицу, сумма без учета налога, номер ГТД | Бухгалтерский учет запасов и расходов | Формирование себестоимости партии товара, ведение учета по таможенным декларациям, признание материальных расходов |
| Ставка НДС, сумма НДС, итоговая стоимость с налогом | Налоговый учет и расчеты с бюджетом | Регистрация документа в книге покупок, раздельный учет налоговых ставок, формирование кредиторской задолженности перед поставщиком |
Формирование и индексация электронного архива первичной документации
Помимо переноса цифр в учетные регистры, полный массив распознанного текста используется для организации долговременного хранения документов. Обычный скан накладной представляет собой графический файл, поиск внутри которого невозможен. Привязка извлеченной текстовой информации к изображению превращает архив сканов в индексируемую базу данных.
Индексация содержимого применяется в следующих процессах документооборота:
- Карточка электронного документа заполняется метаданными: файл автоматически получает понятный набор атрибутов (тип бланка, номер, дата, наименование контрагента, итоговая сумма).
- Полнотекстовый поиск позволяет находить нужную накладную за секунды не только по номеру или поставщику, но и по части названия конкретного товара, артикулу или номеру ГТД в табличной части.
- При подготовке документов по требованию налоговых органов или для встречной проверки выборка нужных первичных бланков за выбранный период и по конкретному ИНН выполняется по текстовым индексам без визуального просмотра сотен папок со сканами.