Онлайн-инструмент распознавания позволяет получить данные заполненной формы в цифровом виде без ручного перепечатывания информации с бумажных носителей. Пользователь загружает скан-образ или фотографию документа, а система автоматически находит рабочие области, считывает внесенные сведения и преобразует их в редактируемый текст. В качестве входных материалов выступают сканированные бланки, заявления, опросники и первичная учетная документация. Результатом обработки становится упорядоченный набор текстовых и числовых значений, полностью готовый к переносу в электронные таблицы или внешние базы данных.
Обычное оптическое распознавание считывает страницу сплошным потоком, часто теряя связь между названием графы и вписанным в нее значением. При обработке форм критически важно сохранить исходную логическую структуру документа и точное соответствие каждого поля его содержимому.
Типовой бланк объединяет разнородные элементы: печатные заголовки, рукописные пометки в ячейках, табличные блоки и поля выбора с проставленными галочками. Алгоритм отделяет статичную разметку пустого шаблона от пользовательского ввода. Во время анализа программа идентифицирует отдельные графические зоны, считывает машинописный или рукописный текст, определяет состояние чекбоксов и собирает извлеченные сведения в пары «ключ-значение». Такой механизм исключает опечатки, неизбежные при монотонном ручном вводе, и ускоряет оцифровку однотипных документов.
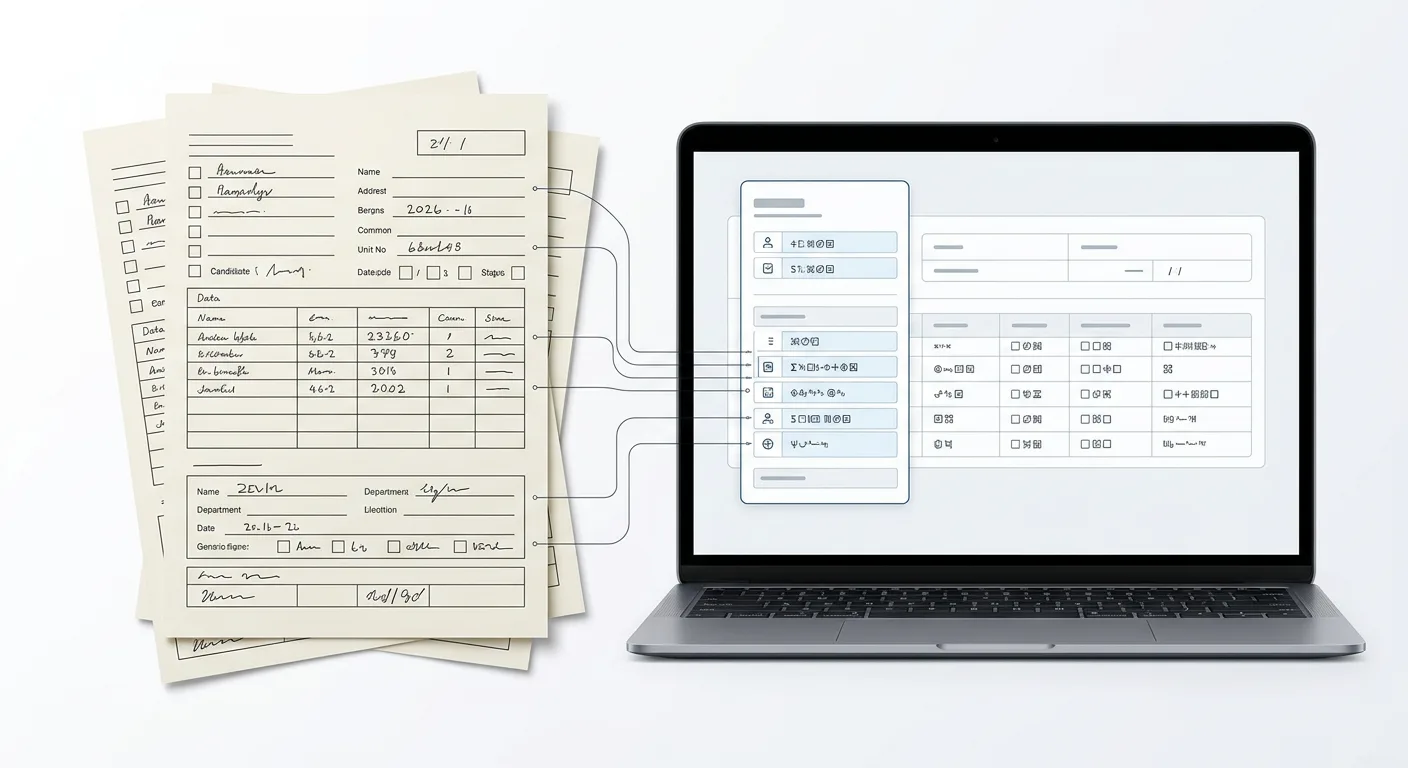
Технологии извлечения данных из заполненных бланков: OCR, ICR и OMR
Заполненный бумажный бланк редко состоит только из одного типа информации. В одном документе одновременно встречаются отпечатанные типографским способом инструкции, вписанные от руки фамилии и проставленные в клеточках галочки. Поскольку визуальная природа этих элементов принципиально различается, для их перевода в цифровой вид применяются три специализированных метода: OCR, ICR и OMR.
Базовые различия между технологиями распознавания определяются типом анализируемых графических объектов на странице:
| Технология | Целевой объект на бланке | Принцип анализа изображения | Результат преобразования |
|---|---|---|---|
| OCR | Машинописный и печатный текст, типографские шрифты | Сопоставление контуров символов со стандартными эталонами шрифтовых гарнитур | Цифровые коды символов и печатные строки |
| ICR | Печатные буквы от руки, связный рукописный почерк, цифры | Анализ геометрии штрихов, углов наклона, точек пересечения и индивидуальных вариаций начертания | Текстовые и числовые значения, переведенные из рукописного ввода |
| OMR | Чекбоксы, поля выбора, радиокнопки, шкалы оценки | Вычисление плотности закрашивания и контрастности внутри замкнутой графической области | Логическое состояние (выбрано или пусто), булевы значения |
Чтение печатного текста методом OCR
Технология OCR предназначена для считывания машинописного текста, который отличается строгой геометрической предсказуемостью. При заполнении форм на компьютере с последующей распечаткой или при чтении заводских реквизитов бланка каждый символ имеет фиксированные пропорции, одинаковый межбуквенный интервал и четкие края. Алгоритм выделяет отдельные знаки, анализирует соотношение линий и сопоставляет их с базой известных шрифтов.
В контексте обработки бланков этот метод решает две задачи: считывает данные, внесенные через принтер или печатную машинку, и распознает статичные текстовые метки самого шаблона. За счет стандартизированного начертания букв и цифр машинописные участки переводятся в кодированный текст с минимальным риском разночтений.
Анализ рукописного ввода с помощью ICR
Когда графы заполняются ручкой или карандашом, стандартное сопоставление с типографскими шрифтами перестает работать. Индивидуальный почерк характеризуется разным наклоном, нестабильным размером букв, разрывами линий и слиянием соседних знаков. Для расшифровки таких участков применяется технология ICR.
При обработке рукописных элементов учет уходит от простого наложения графических масок к разбору топологии символа. Анализируются базовые составляющие знака: дуги, петли, вертикальные мачты, перекладины и точки замыкания контуров. На практике в бланках встречаются два типа рукописного заполнения, влияющих на сложность распознавания:
- Посимвольный ввод в ограниченные ячейки (боксированные поля), где респондент вписывает каждую печатную букву или цифру в отдельную клеточку, что исключает слипание соседних знаков.
- Свободное рукописное заполнение в разлинованных строках, требующее предварительного разделения слитного слова на вероятные сегменты отдельных символов.
Фиксация отметок в чекбоксах по принципу OMR
Опросники, заявления и тестовые бланки активно используют поля выбора, где вместо текста нужно поставить отметку: галочку, крестик, точку или полностью заштриховать кружок. Для их обработки не требуется искать буквы - здесь работает метод OMR.
Данный подход оценивает не форму символа, а изменение оптической плотности внутри заданного контура. Сравнивается количество темных пикселей в границах чекбокса с пороговым значением пустого поля. Если плотность закрашивания превышает установленный порог, поле получает статус активного. Это позволяет достоверно фиксировать выбор пользователя, даже если галочка выходит за края рамки или проставлена небрежным штрихом.
Объединение методов в рамках IDP
Изолированное применение одной технологии не позволяет оцифровать комбинированный документ целиком. Если обработать анкету исключительно алгоритмом для печатного текста, рукописные вставки превратятся в набор случайных знаков, а проставленные галочки в чекбоксах будут проигнорированы или приняты за буквы «V» и «X». Поэтому перевод заполненного бланка в цифровой вид строится на концепции IDP, которая объединяет все три метода в единый рабочий конвейер.
При комплексном извлечении данных каждый участок документа обрабатывается тем инструментом, который соответствует его визуальному типу. Печатное название поля и типографский номер документа считываются через OCR, вписанная от руки сумма или фамилия в соседней графе декодируется механизмами ICR, а выбранный вариант ответа в блоке с клеточками определяется по логике OMR. На выходе результаты работы разных методов сводятся в общую структуру, где текстовые расшифровки и состояния логических меток образуют целостную цифровую запись документа.
Анализ макета, поиск полей и извлечение табличных структур
Для того чтобы распределять задачи между технологиями чтения печатного, рукописного текста и меток, необходимо сначала понять геометрию страницы. Простое считывание знаков слева направо и сверху вниз разрушает логику бланка: подписи сливаются с названиями соседних граф, а колонки превращаются в несвязную строку. Эту проблему решает пространственный анализ документа, который предшествует непосредственному переводу символов в цифровой код.
На этапе анализа макета страница разделяется на обособленные функциональные блоки. Алгоритмы определяют физическую структуру листа: находят границы абзацев, отступы, линии разметки, колонки, заголовки, таблицы и отдельные зоны ввода. На основе этой геометрической карты выполняется семантическая сегментация - классификация найденных участков по их смысловому назначению. Каждый фрагмент изображения размечается на уровне пикселей или ограничивающих рамок, что позволяет отделить статичную типографскую основу бланка от динамических пользовательских данных. После такой разметки запускается поиск структурированных полей: локализуются конкретные области, содержащие целевые значения, и устанавливается их пространственная привязка к поясняющим текстовым меткам.
Шаблонный и бесшаблонный подходы к поиску полей
Логика обнаружения нужных граф внутри документа зависит от того, насколько жестко зафиксирована его структура. В практике извлечения данных применяются два принципиально разных подхода: работа по жесткому макету и динамический анализ структуры.
Шаблонное извлечение данных опирается на заранее известную геометрию бланка. Для выравнивания изображения на листе используются метки регистрации - специальные контрастные квадраты или перекрестия по углам страницы, а также постоянные опорные точки, такие как логотип организации, рамка или фиксированный заголовок. От этих ориентиров отсчитываются точные координаты x/y, которые задают строго определенные области распознавания для каждого конкретного поля. Такой метод эффективен при обработке унифицированных анкет и строгих регламентированных форм, где смещение элементов исключено.
Бесшаблонный анализ используется для документов со свободной или изменяющейся версткой, где положение блоков варьируется от экземпляра к экземпляру. Вместо жесткой координатной сетки здесь применяются алгоритмы компьютерного зрения, нейронные сети и VLM. Нейросетевые архитектуры анализируют страницу комплексно, одновременно учитывая визуальное оформление, взаимное расположение блоков и смысл текста. Модели VLM способны находить нужные поля по контексту и визуальным признакам - например, определять графу с итоговой суммой по характерному выделению шрифта и расположению в нижней части блока, даже если сам документ никогда ранее не встречался в обработке.
Основные различия между двумя методами пространственного поиска представлены в сравнительной таблице:
| Критерий сравнения | Шаблонное извлечение | Бесшаблонный анализ |
|---|---|---|
| Принцип навигации | Опорные точки, метки регистрации и фиксированные координаты x/y | Визуально-семантический поиск через компьютерное зрение, нейронные сети и VLM |
| Объекты фокусировки | Заранее заданные области распознавания | Динамически выявляемые блоки, связанные смыслом и геометрией |
| Устойчивость к сдвигам верстки | Низкая: перенос строки или изменение масштаба нарушают привязку | Высокая: поля находятся независимо от их перемещения по листу |
| Типовые документы | Стандартизированные бланки, экзаменационные листы, типовые заявления | Разнородные договоры, коммерческие счета, формы от разных контрагентов |
Детализация процесса извлечения таблиц
Табличные блоки представляют собой наиболее сложную пространственную структуру в заполненных формах. В отличие от одиночных полей, данные здесь организованы в двумерную матрицу, где смысл каждого значения определяется пересечением вертикальной и горизонтальной осей. Извлечение таблиц выполняется в несколько последовательных этапов:
- Определение структуры таблицы. На странице локализуется внешний контур табличного блока и выявляется его базовая сетка - количество и расположение строк и столбцов. Если таблица расчерчена явными линиями, анализ опирается на графические перегородки. В таблицах без видимых границ структура восстанавливается по вертикальному выравниванию текстовых колонок и горизонтальным пробелам между строками.
- Определение границ ячеек. Вычисляются точные координаты каждой отдельной ячейки внутри сетки. На этом шаге учитываются сложные элементы верстки: объединенные ячейки по горизонтали или вертикали, многострочный текст внутри одного поля, а также разрывы таблиц при переходе на следующую страницу. Это предотвращает слияние данных из соседних граф.
- Связывание заголовков со значениями. После считывания содержимого ячеек устанавливается иерархическая связь между шапкой таблицы и рядовыми строками. Каждому значению в теле таблицы присваивается атрибут соответствующего столбца (и при наличии - бокового заголовка строки).
Благодаря связыванию заголовков со значениями таблица перестает быть просто набором разрозненных чисел и слов. Каждая ячейка получает четкие координаты в структуре данных: например, числовое значение однозначно фиксируется как «Количество» или «Цена» для конкретной позиции в списке. Это позволяет без потерь переносить многострочные перечни из бумажного бланка в реляционные базы данных или электронные таблицы.
Требования к исходным сканам и предварительная обработка изображений
Точность выделения ячеек, полей и отдельных знаков напрямую зависит от визуального качества файла, поступающего на вход. Даже при четкой структуре таблицы размытые контуры букв, темный фон или перекос страницы приводят к ошибкам при чтении данных. Чтобы минимизировать потери информации при переводе бумажных бланков в цифровой вид, исходный файл должен соответствовать базовым техническим параметрам, а само изображение перед чтением текста проходит серию геометрических и цветовых преобразований.
Характеристики исходных файлов
Базовым материалом для оцифровки служит скан-образ или фотография бумажного бланка. Сканированный документ, полученный на планшетном или протяжном оборудовании, обычно отличается равномерным освещением и фиксированным фокусным расстоянием. При съемке формы на камеру смартфона или планшета качество исходника часто снижается из-за теней, бликов и геометрических искажений листа.
На детализацию символов и четкость границ напрямую влияют два физических параметра файла:
- Разрешение изображения. Эталоном для надежного чтения печатного и рукописного текста в бланках считается показатель 300 dpi. При более низкой плотности пикселей мелкие шрифты, индексы и знаки препинания теряют четкость: контуры соседних букв сливаются, а внутренние просветы в символах вроде «о», «е» или «а» закрашиваются. Чрезмерно высокое разрешение утяжеляет файл и замедляет вычисления, не давая прироста в точности чтения стандартных шрифтов.
- Контраст изображения. Для безошибочного отделения текста от подложки необходима выраженная разница в яркости между штрихами символов и фоном бумаги. Выцветшие чернила, бледная печать матричного принтера, заполнение формы твердым карандашом или использование цветных и серых бланков снижают контрастность, из-за чего тонкие линии букв могут сливаться с фоном.
Этапы предварительной обработки изображений
Поскольку реальные документы редко бывают эталонными, в системах распознавания перед непосредственным считыванием символов выполняется предварительная обработка изображения. Этот процесс приводит исходный скан-образ к виду, оптимальному для анализа текста и разметки.
Ниже приведены основные операции подготовки документа и задачи, которые они решают на этапе очистки изображения:
| Этап подготовки | Устраняемый дефект исходника | Технический результат операции |
|---|---|---|
| Коррекция поворота и наклона текста | Перекос листа при подаче в лоток сканера, смещение строк относительно горизонтали | Выравнивание базовых линий текста строго по горизонтальной оси страницы |
| Выравнивание перспективных искажений | Трапециевидная деформация листа при фотографировании документа под углом | Восстановление прямоугольной геометрии бланка и пропорций табличной сетки |
| Шумоподавление | Пыль на стекле сканера, текстура грубой бумаги, мелкие кляксы, следы сгибов | Очистка фона от одиночных темных пикселей и посторонних пятен, не являющихся частью букв |
| Бинаризация | Неравномерное освещение, тени от смартфона, цветной или градиентный фон бланка | Перевод изображения в черно-белый формат методом адаптивной пороговой обработки |
| Удаление артефактов границ и линий сетки | Наложение рукописных букв на печатные рамки полей, направляющие линии или клетки для посимвольного ввода | Стирание графических перегородок с сохранением целостности пересекающих их штрихов символов |
Геометрическое выравнивание страницы
Любой наклон документа нарушает координатную сетку формы. Если бланк отсканирован с перекосом даже в несколько градусов, горизонтальные строки текста смещаются по вертикали, что мешает сопоставлению полей и чтению табличных рядов. Коррекция поворота определяет угол отклонения текстовых строк или рамок таблицы и разворачивает страницу в правильное положение, а также исправляет ориентацию листа, если он был загружен вверх ногами или боком.
Выравнивание перспективных искажений применяется преимущественно к фотоснимкам форм. Когда камера находится не строго перпендикулярно листу, ближний край документа выглядит шире дальнего, а прямые углы таблиц превращаются в острые и тупые. Геометрическая трансформация растягивает и сжимает нужные участки изображения, возвращая документу плоский вид, аналогичный результату работы планшетного сканера.
Цветовая фильтрация и адаптивная пороговая обработка
Очистка от шумов убирает с листа мелкие графические помехи, которые могут быть ошибочно приняты за точки, запятые или диакритические знаки. Вместе с шумоподавлением выполняется сглаживание краев символов, устраняющее ступенчатость пикселей на изгибах букв и восстанавливающее мелкие разрывы в тонких штрихах.
Следующий шаг - бинаризация, то есть преобразование цветного или полутонового скана в двухцветное изображение, где присутствуют только черные пиксели текста и белые пиксели фона. Проorgое разделение по единому глобальному порогу яркости часто дает сбой на фотографиях с тенями или на бланках с цветными плашками: затененный участок становится сплошным черным пятном, а бледный текст на светлом участке полностью исчезает. Поэтому используется адаптивная пороговая обработка: порог яркости вычисляется локально для каждого небольшого участка страницы с учетом окружающего его фона. Это сохраняет читаемость текста даже на неравномерно освещенных или частично загрязненных документах.
Очистка от линий сетки и рамок
Специфическая проблема заполненных форм - тесное соседство текста с графическими элементами разметки. При заполнении анкет от руки или печати на сместившемся бланке буквы часто выходят за пределы отведенного поля и пересекают линии для письма, границы табличных ячеек или стенки прямоугольных окошек для посимвольного ввода. Если оставить эти линии на изображении, рамка сольется с буквой в единый графический объект: например, цифра «1» рядом с вертикальной границей ячейки или буква «Г», примыкающая к верхней линии, будут прочитаны неверно.
После того как структура макета и координаты ячеек уже зафиксированы на предыдущих этапах анализа, сами разделительные линии становятся помехой для чтения текста внутри граф. Удаление артефактов границ и линий сетки бланка программно стирает длинные вертикальные и горизонтальные перегородки, а также пунктирные направляющие. При этом в точках пересечения сетки с текстом пиксели самих букв восстанавливаются, чтобы штрихи символов не распадались на отдельные фрагменты.
Структурирование, постобработка и проверка извлеченных данных
После того как изображение очищено от помех, а символы внутри граф прочитаны, результатом распознавания является несвязный массив текстовых строк. Для работы с информацией в таблицах или базах данных этот «сырой» текст необходимо превратить в упорядоченные цифровые записи. На данном этапе символы группируются по смыслу, очищаются от ошибок оптического чтения, приводятся к единому формату и проходят логическую проверку на достоверность.
Парсинг данных и извлечение пар ключ-значение
Основа структурирования любого бланка - извлечение атрибутов и формирование пар «ключ-значение». Ключом выступает постоянная метка на бланке (название графы, вопрос анкеты, подпись под строкой), а значением - переменная информация, которую вписал или напечатал заполнитель. Задача парсинга данных состоит в том, чтобы безошибочно отделить статический текст самого бланка от внесенных сведений и установить между ними однозначную связь.
В заполненных формах взаимное расположение ключа и значения варьируется в зависимости от верстки документа. При разборе текста учитываются следующие пространственные и синтаксические закономерности:
- Линейное примыкание, когда значение располагается на одной строке справа от ключа после двоеточия, тире или серии пробелов.
- Вертикальная иерархия, при которой заголовок поля напечатан мелким шрифтом над широкой строкой ввода или наоборот - служит поясняющей подписью под чертой, на которой написан текст.
- Рамочная группировка, где ключ и соответствующее ему значение замкнуты внутри одного графического блока или объединены общей линией разметки.
- Многострочный перенос, когда длинное значение (например, полное наименование или подробное основание) не помещается на одной линии и продолжается на следующих строках без повторения ключа.
В процессе парсинга данных лишние элементы оформления - точки на линиях заполнения, скобки вокруг подсказок и сами текстовые подсказки бланка - отбрасываются. В результирующую структуру попадает только нормализованное имя атрибута и чистое извлеченное значение.
Механизмы постобработки текста и оценка Confidence
При оптическом чтении отдельные знаки нередко имеют схожие начертания, особенно если текст набран узким шрифтом, отпечатан с дефектами тонера или написан от руки. Чтобы устранить неоднозначность, применяется постобработка текста, опирающаяся на три механизма: анализ геометрических альтернатив символов, контекстно-зависимую обработку языка и расчет метрики Confidence.
Во время распознавания для каждого знака формируется список гипотез - геометрических альтернатив символов, близких по форме контура. Например, вертикальная черта может быть с разной долей вероятности интерпретирована как цифра «1», заглавная буква «І», строчная латинская «l» или символ разделителя. Аналогичная графическая схожесть возникает между цифрой «0» и буквой «О», цифрой «3» и буквой «З», цифрой «6» и буквой «б», а в рукописном тексте - между буквами «и», «ш», «п» и «т».
Выбор правильной гипотезы из списка геометрических альтернатив символов выполняется через контекстно-зависимую обработку языка. Смысл и тип конкретного поля диктуют правила интерпретации знаков:
- В чисто числовых графах (суммы, коды, количество) любые буквенные альтернативы подавляются, и спорный овальный контур однозначно трактуется как цифра «0».
- В текстовых полях (фамилии, должности, названия городов) используются словари, правила морфологии и статистика сочетаемости букв, что исключает появление цифр внутри обычных слов.
- В полях со смешанным кодом (серии и номера документов, артикулы) применяется позиционная маска, где жестко задано, на каком месте должны стоять буквы, а на каком - цифры.
Каждому распознанному символу, слову и полю в целом присваивается оценка достоверности - показатель Confidence, который выражается в процентах или долях единицы. Высокий уровень Confidence означает, что контур знака четкий, альтернативные варианты начертания имеют большой отрыв по вероятности, а получившееся слово полностью соответствует языковой модели или формату поля. Если же почерк неразборчив или буква перекрыта штампом, разница в вероятностях между геометрическими альтернативами символов становится минимальной. В этом случае показатель Confidence падает, что служит сигналом для маркировки конкретного поля как требующего внимания оператора при проверке результата.
Стандартизация значений, валидация полей и контроль целостности
Даже при безошибочном прочтении каждого символа извлеченный текст часто непригоден для прямой выгрузки в учетные таблицы из-за разнобоя в оформлении. Разные люди заполняют одинаковые бланки по-своему: даты пишут через точку, косую черту или словами, а в суммах используют пробелы, точки или запятые для отделения копеек. Стандартизация полученных значений приводит эти вариации к единому машиночитаемому виду.
После приведения к общему формату запускается валидация полей и сквозной контроль целостности данных. Основные операции проверки и нормализации различаются по типу обрабатываемых сведений:
| Направление обработки | Принцип выполнения операции | Практический пример с данными формы |
|---|---|---|
| Стандартизация полученных значений | Приведение дат, чисел, телефонов и регистров текста к унифицированному формату хранения с удалением лишних пробелов и спецсимволов. | Записи даты «5 мая 2024 г.», «05/05/24» и «05.05.2024» преобразуются в единый вид «2024-05-05». Числовая строка «12 500,00 руб.» переводится в число с плавающей точкой «12500.00». |
| Форматная валидация полей | Проверка соответствия длины строки, набора допустимых символов и структуры значения жестко заданным правилам для конкретного атрибута. | Проверка того, что календарная дата не содержит несуществующих значений (например, 32-го числа или 13-го месяца), а код состоит строго из заданного количества цифр без пробелов и букв. |
| Расчет контрольных разрядов | Математическая проверка числовых идентификаторов по встроенному алгоритму контрольного числа для выявления случайных замен одной цифры на другую. | Если при чтении длинного цифрового кода цифра «8» была принята за «3», пересчет контрольной суммы по весовым коэффициентам покажет несовпадение с последней цифрой номера. |
| Контроль целостности данных | Перекрестная сверка взаимосвязанных полей и табличных итогов внутри одного документа на предмет логических и арифметических противоречий. | Умножение значения графы «Цена» на значение графы «Количество» и сверка результата с графой «Сумма», а также проверка равенства суммы всех строк значению в поле «Итого по документу». |
Сочетание оценки Confidence и правил контроля целостности данных надежно защищает от скрытых ошибок распознавания. Бывают ситуации, когда в рукописной сумме одна цифра написана так, что оптически она идеально похожа на другую - тогда показатель Confidence будет высоким, но перекрестная арифметическая проверка со строкой «Итого» или со суммой прописью сразу выявит расхождение. В результате весь массив извлеченной информации разделяется на полностью достоверные записи, готовые к экспорту, и единичные спорные графы, локализованные для быстрой точечной корректировки.
Прикладные сценарии цифровизации анкет и первичной документации
Прошедшие проверку и структурирование цифровые записи напрямую используются для автоматизации ввода данных в рабочих и административных процессах. В зависимости от жесткости верстки исходного бланка и состава реквизитов практические задачи делятся на обработку строго структурированных пользовательских форм и разбор полуструктурированной деловой документации.
Обработка анкет, опросников, заявлений и медицинских карт
В сегменте работы с физическими лицами, клиентами и пациентами основной массив бумаг представлен документами с фиксированным расположением полей и комбинированным заполнением. Онлайн-распознавание таких форм заменяет ручной набор при массовом сборе сведений:
- Анкеты и опросники. При проведении маркетинговых исследований, социологических опросов, тестирований или сборе обратной связи бланки содержат десятки полей выбора в сочетании с открытыми текстовыми графами. Перевод заполненных листов в цифровой вид позволяет агрегировать выбранные варианты ответов и рукописные комментарии в единую сводную матрицу для последующего статистического подсчета.
- Заявления типового образца. Кадровые заявления на прием или отпуск, заявки на получение услуг, согласия на обработку данных и регистрационные карточки заполняются от руки по жесткому трафарету. Извлечение данных из таких форм формирует готовый набор атрибутов заявителя для быстрого создания карточки клиента или сотрудника.
- Оцифровка медицинских карт и бланков обследований. Амбулаторные карты, листы назначений, направления на анализы и протоколы осмотров совмещают печатные таблицы показателей, рукописные врачебные записи и отметки о выявленных симптомах. Перевод этих сведений в текст решает задачу формирования электронных медицинских архивов и структурированных историй болезни.
Извлечение данных из первичной документации
Бухгалтерский, складской, кадровый и логистический документооборот опирается на первичную документацию. Многие из таких бумаг относятся к полуструктурированным формам: они имеют обязательный набор реквизитов и табличную часть, но ширина колонок, количество строк и точное положение блоков меняются от одного контрагента к другому.
В следующей таблице сгруппированы основные виды первичных и отчетных документов, особенности их структуры и целевые данные, извлекаемые при цифровизации.
| Категория документации | Типы документов | Извлекаемые структурированные данные |
|---|---|---|
| Товарно-сопроводительные и отгрузочные | Счета-фактуры, УПД, ТОРГ-12, накладные, акты выполненных работ | Номера и даты документов, реквизиты продавца и покупателя, многострочные таблицы товаров или услуг с ценами, количеством, ставками налога и итоговыми суммами к оплате. |
| Банковские, кассовые и подотчетные | Платежные поручения, кассовые чеки, авансовые отчеты | Назначение платежа, банковские счета, даты транзакций, фискальные признаки, перечни приобретенных позиций и суммы фактических расходов подотчетных лиц. |
| Логистические и внешнеэкономические | Путевые листы, таможенные декларации, коммерческие инвойсы | Маршруты следования, показания одометра, расход горючего, коды товарной номенклатуры, страна происхождения груза, таможенная стоимость, валюта контракта и вес брутто или нетто. |
| Кадровые и налоговые | Справки 2-НДФЛ | Идентификационные данные налогового агента и сотрудника, помесячная разбивка начисленных доходов, коды вычетов и общая сумма удержанного налога. |
Работа с типовыми реквизитами и табличной номенклатурой
Независимо от конкретного вида бланка, основная прикладная цель распознавания сводится к точному выделению ключевых идентификаторов и содержательных блоков, на которых строится предметный учет.
В первую очередь из шапки или подвала документа извлекаются государственные и банковские идентификаторы: ИНН, КПП, ОГРН, СНИЛС и БИК. Поскольку эти коды имеют строго фиксированную разрядность и четкую привязку к меткам на бланке, их перевод в цифровой вид позволяет однозначно идентифицировать контрагента, банк или физическое лицо без риска опечаток, характерных для ручного набора длинных числовых последовательностей.
Второй базовый блок - адресные данные, включающие юридические адреса организаций, места жительства заявителей или пункты доставки грузов. При извлечении из формы полная строка адреса разбивается на составные элементы (индекс, регион, населенный пункт, улица, дом, помещение), что приводит разнородные записи к единому формату адресных классификаторов.
Третий массив данных - номенклатурные позиции в товарных документах, чеках и инвойсах. При распознавании табличной части каждая строка преобразуется в отдельную запись, где артикул и наименование товара или услуги жестко связаны со своей единицей измерения, количеством, ценой за единицу и общей стоимостью.
Перенос информации в электронные таблицы и учетные системы
Получение данных заполненной формы в цифровом виде устраняет главный барьер бумажного документооборота - несовместимость графического изображения с программной средой обработки информации. Скан или фотография бланка представляют собой обычный набор пикселей, по которому невозможно построить формулу, отфильтровать строки или провести проводку.
Когда текст и значения полей извлечены, проверены и разбиты на логические пары и массивы строк, они становятся пригодными для прямого переноса в целевые хранилища:
- Формирование электронных таблиц. Извлеченные анкетные ответы, реестры чеков или многостраничные списки товаров из накладных сразу образуют готовую сетку строк и столбцов. Пользователю не нужно вручную создавать структуру таблицы и перепечатывать каждую ячейку: цифровые значения сразу готовы к сортировке, фильтрации, объединению массивов и проведению расчетов по формулам.
- Импорт в учетные системы и базы данных. При загрузке первичной документации в бухгалтерские, складские или кадровые программы распознанные реквизиты сопоставляются с соответствующими полями экранных форм. По цифровому значению ИНН или БИК в базе находится нужный контрагент и банк, а распознанные номенклатурные позиции из ТОРГ-12 или УПД целиком заполняют табличную часть документа поступления без построчного ввода оператором.