Онлайн-инструмент позволяет автоматически извлекать значения полей из изображения документа с помощью технологии OCR. Вместо сплошного считывания всей страницы алгоритм находит конкретные графы, реквизиты и целевые атрибуты. На вход подается скан или фотография бланка, а на выходе формируется набор готовых текстовых данных. Ручное перепечатывание информации с графического носителя полностью исключается.
Основная задача пользователя при работе с первичными бумагами, анкетами или удостоверениями - быстро перенести реквизиты в учетную систему или таблицу без опечаток. При поиске и копировании отдельных номеров, дат, сумм или идентификаторов из графического файла тратится время на визуальную сверку каждого символа.
Применение OCR с привязкой к структуре макета решает эту проблему за счет автоматической локализации нужных зон на исходном снимке. Инструмент отделяет названия граф от их фактического содержимого, распознает печатные знаки внутри выделенных областей и возвращает структурированный текст, готовый к дальнейшей проверке и копированию.
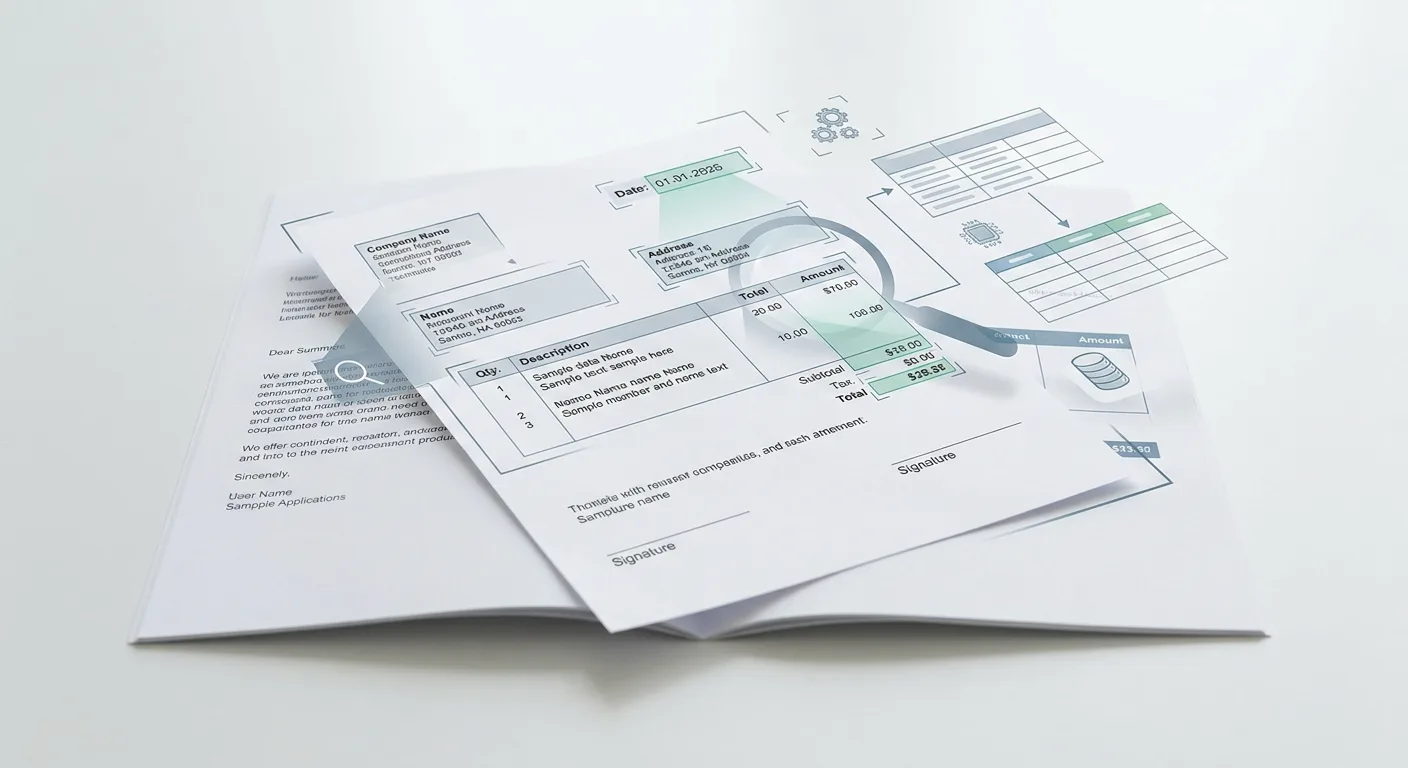
Принцип локализации и OCR-распознавания отдельных полей
Классическое сплошное распознавание преобразует весь графический файл в единый поток символов, читая страницу сверху вниз и слева направо. При таком подходе структура бланка теряется: заголовки таблиц смешиваются со значениями, а колонки текста сливаются в одну строку. Целевое извлечение данных из полей работает иначе - оно опирается на пространственную и логическую связность элементов, разделяя страницу на независимые функциональные блоки до перевода графики в текст.
Задача адресного извлечения реквизитов сводится к нахождению пары «ключ - значение», где ключом выступает постоянная метка на бланке, а значением - переменное содержимое конкретной графы. Чтобы отделить нужные сведения от справочного текста, колонтитулов и декоративных линий, обработка изображения проходит через последовательность геометрических и текстовых преобразований.
Этапы выделения и считывания целевых граф
Процесс получения текстовых атрибутов из графической копии документа состоит из четырех последовательных стадий:
- Анализ пространственной структуры документа. На исходном снимке выделяются базовые элементы верстки: текстовые блоки, разделительные линии, сетки таблиц, рамки для вписывания букв и пустые зоны. Определяется взаимное расположение блоков и общая топология страницы.
- Определение координат текста. Вокруг каждого обнаруженного фрагмента слов, строки или отдельной ячейки выстраивается ограничивающий многоугольник - bounding box. Эта геометрическая фигура фиксирует точные пиксельные координаты вершин текстового блока относительно границ изображения.
- Поиск целевых полей. Среди множества размеченных зон отбираются те, которые содержат искомые реквизиты. Отбор опирается либо на заранее заданные геометрические координаты на листе, либо на соседство с распознанными текстовыми метками.
- Считывание символов внутри выделенной области. Технология OCR применяется локально к графическому фрагменту, заключенному внутри целевого ограничивающего многоугольника. Распознанные печатные или рукописные знаки собираются в итоговую текстовую строку и привязываются к соответствующему атрибуту документа.
Локальное считывание внутри bounding box предотвращает захват соседних символов из смежных граф. Даже если текст в соседней колонке расположен вплотную к границе поля, координаты многоугольника отсекают лишние знаки на этапе сегментации изображения.
Шаблонный и интеллектуальный подходы к поиску реквизитов
Способ нахождения нужного поля на странице зависит от того, насколько строго зафиксирован внешний вид документа. В практике извлечения данных применяются два базовых метода локализации: шаблонный и интеллектуальный.
Шаблонный подход опирается на жесткую привязку к геометрии макета и фиксированным координатам. Положение каждой графы задается заранее через отступы от краев листа или относительно опорных графических элементов, таких как угловые маркеры, логотипы или линии сетки. При обработке изображения вырезается участок с заданными координатами X и Y, после чего внутри него запускается распознавание символов. Такой метод показывает предсказуемый результат на бланках строго установленного образца, где любая графа всегда находится на одном и том же месте.
Интеллектуальный подход не зависит от фиксированной сетки координат и использует поиск по текстовым маркерам, ключевым словам и семантическому окружению. Сначала выполняется предварительное считывание текста для обнаружения опорных слов - названий граф, заголовков колонок или стандартных формулировок. После нахождения ключевого слова анализируется пространство вокруг него: справа, снизу или внутри той же ячейки таблицы. Целевая сущность или атрибут извлекается на основе смыслового контекста и характерных признаков самого значения, таких как формат записи даты, структура кода или наличие денежной единицы.
Ниже приведено сравнение двух методов локализации полей по основным рабочим параметрам:
| Критерий сравнения | Шаблонный подход | Интеллектуальный подход |
|---|---|---|
| Базовый ориентир | Геометрия листа, расстояния и пиксельные координаты | Текстовые маркеры, ключевые слова и контекстное окружение |
| Требования к макету документа | Строго фиксированная форма без смещения граф | Свободная или изменяемая верстка с плавающим положением блоков |
| Реакция на сдвиг текста при печати | Смещение границ приводит к захвату пустого фона или чужого поля | Поле успешно находится вместе со сместившимся текстовым маркером |
| Механизм определения границ значения | Жестко заданная рамка фиксированного размера | Динамический bounding box, охватывающий фактический объем текста сущности |
Выбор или комбинация этих принципов объясняет, почему при работе с разными документами локализация реквизитов ведет себя по-разному. Если в документе со свободной версткой таблица удлиняется из-за большого количества строк, итоговые поля сдвигаются вниз или переходят на другую часть листа. При поиске по семантическому окружению алгоритм находит итоговую графу по ее текстовому обозначению независимо от того, в какой части страницы она оказалась.
Требования к исходному изображению документа и факторы точности
Точность поиска граф и считывания реквизитов напрямую зависит от физического и цифрового качества исходного снимка или скан-копии. Даже при точном совпадении структуры документа с искомыми маркерами низкое качество графики мешает отделить символы от фона и правильно построить границы поля.
Базовые оптические и графические параметры
На этапе перевода бумажного носителя в цифровой вид ключевую роль играют плотность пикселей, четкость границ шрифта и равномерность светового потока. Недостаток детализации или плохое освещение искажают форму букв и линий разметки еще до начала анализа макета.
Основные технические характеристики входного изображения включают следующие параметры:
- DPI. Плотность точек определяет, сколько пикселей приходится на один символ текста. При слишком низком значении мелкие элементы шрифта распадаются на ступенчатые квадраты, просветы внутри букв смыкаются, а близко расположенные знаки сливаются в сплошное пятно. Высокая детализация сохраняет четкую микрогеометрию засечек, знаков препинания и разделителей в кодах.
- Контрастность текста относительно фона. Чем выше разница в яркости между темным красителем шрифта и светлой бумагой, тем точнее отделяются контуры букв и линий таблиц. Бледная печать, выцветшие чернила, использование цветной или серой бумаги, а также сложные фоновые узоры на защищенных бланках снижают локальный контраст и приводят к разрыву штрихов.
- Освещение. При фотографировании документа на камеру критична равномерность света по всей площади листа. Направленный боковой свет или съемка под бытовой лампой создают резкие тени от рук, смартфона или предметов интерьера. При использовании вспышки на глянцевой бумаге, ламинированных бланках или пластиковых удостоверениях возникают блики - засвеченные белые пятна, внутри которых пиксели текста полностью выгорают и становятся нечитаемыми.
Геометрические искажения и смещение координат
Для точной локализации реквизитов важна сохранность исходных пропорций листа. Любое нарушение плоскостности или прямых углов документа изменяет взаимное расположение текстовых блоков и сбивает расчет координат.
При неровной подаче бумаги в протяжный сканер или небрежной укладке на стекло возникает наклон и перекос страницы. Строки текста уходят под углом к горизонтальной оси кадра. При жесткой привязке к координатам горизонтальная рамка поиска рассекает наклонную строку по диагонали, захватывая только часть нужного значения и кусок соседней графы. При поиске по текстовым маркерам сильный наклон нарушает логику объединения отдельных слов в единую строку.
Съемка документа под углом вместо строго вертикального положения камеры сверху вызывает перспективное искажение. Лист на снимке принимает форму трапеции: ближний к объективу край выглядит шире и крупнее, а дальний сужается. Масштаб шрифта и межстрочные интервалы становятся неравномерными по высоте страницы, что нарушает расчет расстояний от названия поля до его значения.
Деформация геометрии происходит, когда сам бумажный носитель имеет физические неровности: сгибы, заломы, помятости или плавный изгиб у корешка сшитой папки. Прямые линии таблиц и строки текста на таком снимке превращаются в дуги. Если сгиб проходит непосредственно через графу с реквизитом, часть символов сжимается или скрывается в складке бумаги.
Визуальные помехи и перекрытие реквизитов
Помимо оптических и геометрических факторов, на считывание данных влияют посторонние графические элементы, которые накладываются на полезный текст или разрушают его структуру.
Ниже приведены основные виды дефектов изображения и характер их влияния на извлечение данных из полей:
| Тип дефекта | Визуальное проявление на снимке | Влияние на локализацию поля и OCR |
|---|---|---|
| Размытие | Нечеткие, расплывчатые контуры букв из-за сбоя фокусировки или дрожания камеры | Слияние соседних символов, потеря тонких штрихов и невозможность точно определить границы знака |
| Визуальный шум и артефакты | Мелкие черные точки от пыли на стекле сканера, следы тонера, пиксельная зернистость и квадраты сильного сжатия | Появление ложных знаков препинания, искажение краев букв и ошибочное объединение мусора с текстом |
| Бледная и прерывистая печать | Непропечатанные участки штрихов из-за нехватки тонера или износа термобумаги | Распад одного символа на несколько разрозненных фрагментов или полный пропуск знака при чтении |
| Наложение печатей и штампов | Синие или фиолетовые оттиски, перекрывающие печатный текст реквизита | Смешение линий штампа со штрихами шрифта, зашумление фона внутри поля и блокировка распознавания перекрытых цифр или букв |
| Рукописные пометки и подписи | Росчерки ручки, выходящие за пределы своей графы и пересекающие соседние строки | Нарушение контура печатных символов в смежных полях и искажение рассчитываемого bounding box |
Оттиски круглых печатей, прямоугольные штампы и размашистые подписи в нижних блоках документов часто ставятся поверх текста должностей, фамилий, дат или итоговых сумм. Когда плотный слой штемпельной краски пересекает тонкий печатный шрифт, контуры букв сливаются с кольцами и текстом самого оттиска. Аналогичную проблему создают жирные линии табличной сетки, если при печати текст съехал и лег вплотную на горизонтальную или вертикальную границу ячейки.
Типы документов и специфика извлекаемых реквизитов
Способ поиска нужной графы напрямую зависит от того, насколько строго зафиксирован внешний вид документа. В делопроизводстве бланки делятся на категории по степени жесткости верстки: от государственных удостоверений с точными размерами до свободных коммерческих форм, где расположение блоков меняется от страницы к странице.
Классификация по структуре расположения полей
Формализованные документы имеют жесткий, заранее утвержденный макет. В таких бланках каждое поле, рамка, подпись или клеточка для ввода символов находятся на строго отведенном месте. Положение любого реквизита относительно краев листа или опорных меток всегда предсказуемо, а размер шрифта и межстрочные интервалы регламентированы стандартами печати. К этой группе относятся удостоверения личности, государственные свидетельства, типовые анкеты для машиночитаемой обработки и бланки строгой отчетности.
Полуструктурированные и неформализованные документы отличаются плавающей структурой. Набор обязательных реквизитов в них определен правилами делового оборота или законодательством, но их визуальное размещение на листе не фиксировано. Разные компании формируют счета, акты или коммерческие предложения в своих учетных программах, меняя ширину колонок, шрифты, положение логотипов и порядок следования текстовых блоков. В таких документах табличная часть с перечнем товаров или услуг может содержать как две строки, так и несколько десятков позиций, из-за чего подвал документа с итоговыми суммами и подписями постоянно смещается по вертикали или переносится на следующую страницу.
Практические сценарии извлечения данных по категориям
У каждой группы документов свой набор целевых атрибутов и особенности визуального оформления, которые влияют на точность выделения текста из конкретной области.
Первичная бухгалтерская и финансовая документация
К этой категории относятся УПД, счета-фактуры, товарные накладные ТОРГ-12, акты выполненных работ и коммерческие инвойсы. Они сочетают шапку с плотным расположением реквизитов сторон, многострочную табличную часть и блок итогов. Основная сложность здесь связана с обилием тонких разделительных линий, мелким шрифтом и частым смещением текста на границы ячеек при печати.
При обработке первичной бухгалтерской документации извлекаются следующие ключевые значения:
- идентификационные реквизиты самого документа: порядковый номер, дата составления, код вида операции, номер и дата платежно-расчетного документа или договора-основания;
- данные контрагентов (продавца, покупателя, грузоотправителя и грузополучателя): наименование организации, ИНН, КПП, юридический и фактический адреса, банковские реквизиты (БИК, расчетный и корреспондентский счета);
- позиции табличной части: артикулы, коды и наименования номенклатуры, единицы измерения, количество, цена за единицу, налоговая ставка;
- финансовые итоги: стоимость товаров или услуг без налога, сумма налога и общая сумма к оплате с учетом налога.
Удостоверения личности и государственные бланки
Паспорта, СТС, ПТС, СНИЛС и водительские удостоверения относятся к жестко формализованным бланкам. Их специфическая особенность - наличие защитной полиграфии: фоновых гильоширных сеток, водяных знаков, микротекста, голограмм и цветных переходов. Такой сложный узорчатый фон снижает локальную контрастность символов, а ламинированное покрытие часто дает блики при фотографировании. Во многих удостоверениях серии и номера наносятся методом перфорации или печатаются специфическими шрифтами разного кегля и ориентации (например, вертикально вдоль края страницы). Из таких бланков считываются персональные и регистрационные атрибуты: ФИО владельца, дата и место рождения, пол, серия и номер бланка, дата выдачи, код подразделения, наименование выдавшего органа, а для автодокументов - VIN, государственный регистрационный знак, марка, модель и год выпуска транспортного средства.
Логистические и кадровые формы
В логистике и кадровом делопроизводстве применяются как строго регламентированные формы (справки 2-НДФЛ, унифицированные транспортные накладные, путевые листы), так и более свободные документы (заявления на отпуск или прием на работу, маршрутные листы, экспедиторские расписки). Транспортные документы часто проходят через несколько рук в складских и дорожных условиях, поэтому на их изображениях нередко присутствуют заломы бумаги, следы грязи, штампы пропускных пунктов и рукописные пометки водителей или кладовщиков о фактическом состоянии груза. Кадровые справки, напротив, отличаются высокой плотностью числовых и кодовых полей, сгруппированных по месяцам и видам доходов или вычетов.
Сравнение основных категорий документов по типу верстки, целевым полям и характерным визуальным особенностям приведено в таблице:
| Категория документов | Примеры форм | Тип структуры макета | Основные извлекаемые поля | Специфика оформления на изображении |
|---|---|---|---|---|
| Первичная бухгалтерия | УПД, счет-фактура, ТОРГ-12, акт, инвойс | Полуструктурированная (плавающая таблица и подвал) | Номер, дата, ИНН, КПП, БИК, счета, номенклатура, количество, суммы | Мелкий шрифт, плотная табличная сетка, оттиски печатей поверх итогов и подписей |
| Удостоверения и бланки | Паспорт, СНИЛС, СТС, ПТС | Жестко формализованная | ФИО, серия, номер, дата рождения, дата выдачи, код подразделения, VIN | Защитные фоновые сетки, водяные знаки, голограммы, блики от ламинации, вертикальный текст |
| Логистические формы | Транспортная накладная, путевой лист, экспедиторская расписка | Смешанная (типовые графы с плавающим заполнением) | Пункты погрузки и выгрузки, масса груза, количество мест, данные водителя и тягача | Множество штампов, рукописные исправления, замятия и загрязнения бумажного носителя |
| Кадровая документация | Справка 2-НДФЛ, заявление, кадровый приказ | Формализованная (справки) и неформализованная (заявления) | ФИО сотрудника, ИНН, СНИЛС, коды доходов и вычетов, суммы начислений, даты | Плотные колонки цифр и кодов в справках, сочетание печатного текста и рукописного ввода в заявлениях |
Интерпретация, нормализация и проверка полученных значений
Первичный результат считывания граф документа представляет собой необработанную текстовую строку, которая воспроизводит визуальное содержимое области, но еще не гарантирует полную готовность к дальнейшим вычислениям или учету. Даже при точной локализации реквизита символы внутри поля могут содержать погрешности оптического распознавания или быть записаны в форме, непригодной для прямого сопоставления. Переход от «сырого» текста к достоверным данным включает три этапа постобработки: устранение символьных искажений, приведение значений к единому стандарту записи и проверку их математической и логической корректности.
Типичные ошибки распознавания на уровне символов
В реквизитах, состоящих из произвольных комбинаций знаков (серии и номера бланков, банковские счета, коды подразделений, идентификаторы VIN), контекст слова не помогает угадать неразборчивый знак. На уровне отдельных глифов возникает оптическая омоглифия - подмена схожих по геометрическому начертанию букв, цифр и знаков препинания.
В зависимости от гарнитуры шрифта и типа ожидаемых данных в конкретной графе наиболее часто встречаются следующие взаимные подмены символов:
| Группа риска | Исходный символ на бланке | Ошибочный результат чтения | Причина искажения и уязвимые реквизиты |
|---|---|---|---|
| Буквенно-цифровые совпадения | Цифра 0, цифра 1, цифра 8, цифра 3, цифра 6 | Буква О (или O), буква I (или l), буква В (или B), буква З, буква б | Идентичность контуров в стандартных гротескных шрифтах; критично для серий удостоверений, госномеров и VIN |
| Слияние и разрыв штрихов | Буквы Ш и Щ, буквы П и Н, сочетание «рн» или «rn», цифра 0 | Взаимная замена Ш/Щ и П/Н, буква «м» или «m», буква С | Слабый пропечат тонких перекладин или заливка пробелов краской; искажает ФИО, наименования и коды |
| Разделители в числах | Точка (.), запятая (,), дефис (-) | Пробел, взаимная подмена точки и запятой, пропуск знака | Малая площадь знака на изображении; меняет разрядность финансовых сумм и структуру дат |
| Лишние крайние знаки | Отсутствует (вертикальная линия рамки графы) | Цифра 1, буква I, вертикальная черта (|) | Захват границы печатного бокса в область чтения символов; добавляет лишний разряд в начало или конец номера |
Интерпретация таких строк опирается на строгую типизацию поля. Если целевая графа по своей природе может содержать исключительно цифры (например, БИК, КПП или сумма к оплате), любые обнаруженные в ней буквенные символы с высокой вероятностью являются результатом графической подмены и требуют обратной замены на соответствующие числовые аналоги.
Нормализация извлеченных данных
В реальном документообороте одни и те же по смыслу сведения оформляются по-разному. Нормализация решает задачу приведения разнородных текстовых строк к унифицированному машиночитаемому виду. Без этого этапа невозможно сравнивать значения между собой, выполнять арифметические действия над суммами или сортировать записи по хронологии.
В практике обработки документальных реквизитов применяются следующие правила стандартизации значений:
- Приведение календарных дат к единому каноническому шаблону (например, ДД.ММ.ГГГГ или ГГГГ-ММ-ДД). Записи вида «14 мая 2024 г.», «14/05/24» и «14.05.2024» преобразуются в идентичный цифровой формат с заменой словесных названий месяцев на их порядковые номера и отсечением служебных сокращений.
- Очистка числовых и финансовых сумм. Из строки удаляются пробелы между разрядами тысяч, неразрывные пробелы, обозначения валют («руб.», «р.», знаки валют) и текстовые отметки вроде «коп.». Дробный разделитель (запятая или точка, а в некоторых бланках - дефис или знак равенства после целой части) приводится к единому десятичному знаку.
- Унификация наименований и организационно-правовых форм. Названия контрагентов очищаются от лишних кавычек различных типографских видов («», ""), а полные формулировки приводятся к стандартным аббревиатурам (например, замена полного написания общества с ограниченной ответственностью на краткое ООО) для однозначного сопоставления записей.
- Удаление форматирующих символов из идентификаторов. Номера телефонов, СНИЛС или коды подразделений очищаются от дефисов, скобок и пробелов, если целевой стандарт хранения предполагает запись в виде непрерывной последовательности цифр.
Валидация и контроль достоверности реквизитов
Проверка (валидация) позволяет подтвердить, что извлеченное и нормализованное значение не просто состоит из допустимых символов, но и является реально существующим или математически верным реквизитом. Для этого используются формальные, алгоритмические и визуальные методы контроля.
Проверка по регулярным выражениям и длине строки
Каждое формализованное поле имеет жесткие структурные рамки. Проверка регулярными выражениями позволяет мгновенно отсеять строки с нарушенной длиной или неверным составом знаков. Например, КПП всегда состоит ровно из 9 знаков (где первые четыре - цифры, пятый и шестой - цифры или латинские буквы, а последние три - цифры), а серия и номер паспорта образуют последовательность из 10 цифр. Если после чтения из графы получено 9 или 11 цифр, реквизит помечается как содержащий ошибку без необходимости ручного чтения всего документа.
Расчет контрольных сумм
Многие государственные и банковские идентификаторы (ИНН, СНИЛС, ОГРН, расчетный счет в связке с БИК) защищены от случайных опечаток встроенным математическим алгоритмом - контрольным разрядом. Последние одна или две цифры такого номера не случайны: они вычисляются по специальной формуле из всех предыдущих цифр с использованием весовых коэффициентов.
При проверке десятизначного ИНН первые девять цифр поочередно умножаются на фиксированные коэффициенты, произведения складываются, а остаток от деления полученной суммы на 11 сравнивается с десятой цифрой реквизита. Если при оптическом распознавании хотя бы одна цифра в середине номера была перепутана (например, «3» прочиталась как «8»), расчетная контрольная сумма не совпадет с последним знаком, что сразу укажет на недостоверность результата.
Перекрестная проверка и сверка с исходным изображением
В финансовых и логистических документах поля связаны между собой математически. Перекрестная (балансовая) валидация проверяет соблюдение внутренних тождеств документа: сумма по строке должна равняться произведению цены на количество, а итоговая сумма с налогом должна строго сходиться с суммой стоимости без налога и величиной самого налога. Расхождение даже на одну копейку сигнализирует об ошибке чтения в одном из слагаемых.
Когда формальная проверка, контрольное число или математический баланс выявляют несоответствие, выполняется визуальная верификация - прямая сверка полученного текстового значения с фрагментом исходного изображения. Сопоставление спорного знака с его графическим оригиналом позволяет человеку быстро разрешить неоднозначность в тех случаях, когда текст на бланке перекрыт оттиском печати, подписью или поврежден при сканировании.
Практическое применение структурированных данных из полей
После верификации и приведения к единому стандарту разрозненные символы превращаются в готовый набор пар «ключ - значение». В отличие от сплошного текстового массива, где реквизиты смешаны с основным содержанием бланка, распределенные по конкретным графам данные готовы к прямой передаче в прикладные рабочие процессы, учетные таблицы и информационные базы.
Ускорение ввода первичной документации в бухгалтерском и кадровом учете
Обработка входящего документооборота традиционно требует ручного переноса чисел и наименований с бумажных или отсканированных носителей в учетные регистры. Использование извлеченных значений отдельных полей позволяет формировать проводки и кадровые записи путем прямого сопоставления граф бланка с ячейками целевой таблицы или учетной формы.
В бухгалтерском и складском учете полученный результат применяется для регистрации накладных, актов и счетов без посимвольного набора номенклатуры, сумм и налоговых идентификаторов. В кадровом делопроизводстве извлеченные атрибуты удостоверений и справок ложатся в основу личных карточек сотрудников, приказов о приеме на работу и расчетных ведомостей.
В таблице ниже показано соответствие между исходными категориями бланков, выделяемыми из них атрибутами и конечными задачами учета:
| Направление учета | Исходная документация | Ключевые значения полей | Целевая прикладная задача |
|---|---|---|---|
| Бухгалтерский учет | УПД, счета-фактуры, акты, инвойсы | Номер и дата документа, ИНН, КПП, итоговая сумма, сумма налога | Регистрация поступлений, формирование книги покупок и реестров платежей |
| Складской и логистический учет | ТОРГ-12, транспортные накладные | Артикулы, наименования позиций, количество, цена, вес, данные перевозчика | Оприходование товарно-материальных ценностей, сверка фактических поставок |
| Кадровое делопроизводство | Паспорт, СНИЛС, справки 2-НДФЛ, заявления | ФИО, дата рождения, серия и номер бланка, кем и когда выдан, суммы доходов | Заполнение личных карточек персонала, расчет налоговых вычетов и пособий |
Формирование карточек клиентов и контрагентов в процедурах KYC и KYB
При первичном взаимодействии с физическими лицами (KYC) или корпоративными партнерами (KYB) организации обязаны зафиксировать и проверить юридически значимые реквизиты стороны. Ручной перенос десятков цифр из учредительных бланков, свидетельств о регистрации и паспортов сопряжен с риском опечаток, которые делают невозможной последующую проверку субъекта по государственным реестрам.
Структурированный набор значений из граф документа используется для создания профиля контрагента или анкеты клиента. Извлеченные идентификаторы - такие как ИНН, КПП, регистрационные номера, серии бланков, адреса регистрации и ФИО руководителей - сразу попадают в соответствующие поля карточки в базе данных. Это сокращает время на заведение нового партнера в реестр и гарантирует, что проверочные запросы в справочные базы будут отправлены по точным реквизитам без случайных искажений в цифрах.
Автоматическое заполнение форм, анкет и перенос в базы данных
В клиентских сервисах, банковском обслуживании, страховании и оформлении заявок пользователю или оператору часто приходится вводить одни и те же сведения из типовых документов в веб-формы и экранные анкеты. Например, при оформлении полиса или заявки на обслуживание требуется перенести данные из паспорта, СТС и ПТС в соответствующие графы анкеты.
Полученные текстовые значения каждого распознанного поля можно напрямую связать с соответствующими ячейками электронной формы или столбцами реляционной таблицы. Вместо перепечатывания двадцатизначных номеров счетов, кодов подразделений или идентификационных номеров транспортных средств оператор получает предзаполненную анкету, где остается только визуально подтвердить корректность подставленных данных перед сохранением записи в базу.
Индексация и атрибутирование электронных архивов
Хранение документов в виде простых графических файлов или неразмеченных сканов превращает электронный архив в неструктурированное файловое хранилище. Найти нужный договор, акт или накладную в таком массиве по конкретному параметру невозможно без последовательного открытия и просмотра каждого изображения.
Извлеченные значения ключевых полей выступают в роли метаданных (карточки атрибутов), которые привязываются к графическому оригиналу при сохранении в архив. Индексация файлов по распознанным графам решает следующие задачи организации документооборота:
- Быстрый многокритериальный поиск документа по точному значению реквизита: номеру бланка, ИНН контрагента, дате составления или диапазону итоговой суммы.
- Стандартизированное переименование графических файлов по шаблону на основе прочитанных полей (например, объединение типа документа, номера, даты и наименования организации в имени файла).
- Хронологическая и тематическая сортировка сканов по папкам, налоговым периодам, проектам или юридическим лицам.
- Связывание разрозненных сканов в единые комплекты документов по общему идентификатору - например, объединение счета, накладной ТОРГ-12 и акта по совпадающему номеру и дате базового договора.