Онлайн-инструмент позволяет автоматически извлечь табличные данные из изображения, определяя границы строк, столбцов и отдельных ячеек. На вход подается графический файл со скриншотом, сканом документа или фотографией печатного листа. Алгоритм анализирует визуальную разметку и преобразует статичную картинку в редактируемый набор значений. Ручное перепечатывание текста и чисел больше не требуется.
При обычном оптическом распознавании символов структура документа часто теряется, а колонки сливаются в сплошной текстовый поток. Этот инструмент решает задачу иначе: он фиксирует точное взаимное расположение элементов и привязывает каждое найденное значение к конкретному пересечению строки и столбца.
В результате пользователь получает упорядоченную матрицу данных, полностью готовую к копированию, проверке и переносу в электронные таблицы или учетные системы. Исходная логика документа - от шапки таблицы до итоговых сумм - сохраняется в точном соответствии с оригиналом.
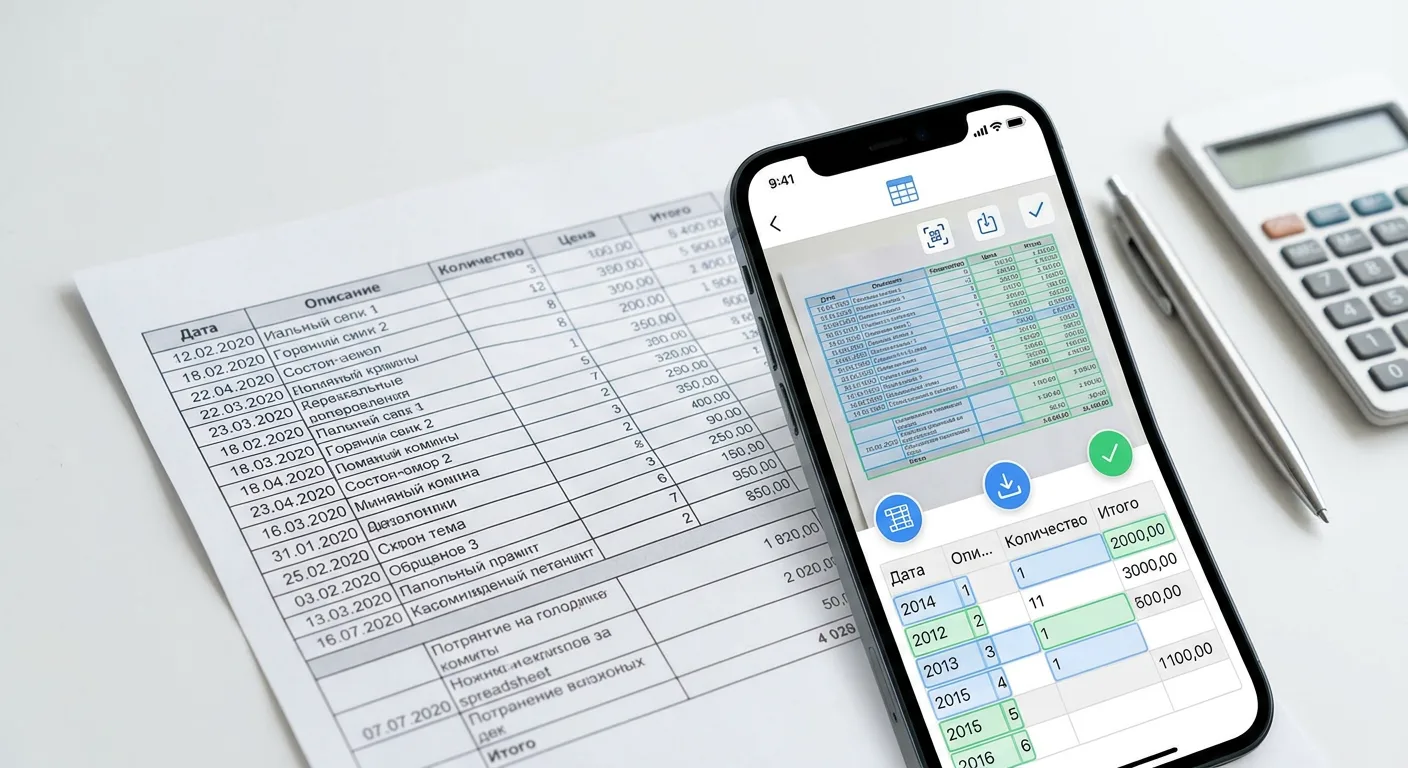
Принцип работы технологии Table OCR при извлечении данных
В основе извлечения таблиц из графических файлов лежит технология Table OCR, которая объединяет методы компьютерного зрения и классическое распознавание текста. В отличие от простого чтения символов, здесь первостепенной задачей является сохранение двумерной топологии документа. Смысл каждого показателя в таблице определяется его положением относительно заголовков строки и столбца, поэтому потеря координат делает извлеченные цифры и слова бесполезными.
Технически процесс преобразования растрового изображения в структурированную матрицу разделяется на два последовательных этапа:
- Пространственный анализ макета и сегментация данных с помощью алгоритмов компьютерного зрения. На этом шаге определяется сам контур таблицы на странице, отсекаются посторонние элементы оформления, после чего внутри найденной области вычисляются границы отдельных строк, колонок и образуемых ими ячеек. Каждой выделенной зоне присваивается собственный индекс положения в общей сетке.
- Зональное распознавание текста методом OCR внутри изолированных сегментов. Когда геометрическая сетка построена, оптическое распознавание символов запускается локально для каждой отдельной ячейки. Найденные буквенные и числовые значения считываются строго в пределах своих ограничивающих рамок и записываются в соответствующую позицию итоговой матрицы.
Такое разделение задач исключает смешивание информации из соседних блоков. Сначала формируется жесткий пространственный каркас, и только затем он заполняется распознанным содержимым.
Отличия Table OCR от сплошного распознавания текста
Стандартные алгоритмы OCR воспринимают изображение как обычный книжный лист и считывают информацию линейно - слева направо и сверху вниз. При обработке табличного макета такой подход приводит к разрушению логических связей. Если в одной ячейке текст занимает несколько строк, а в соседней - только одну, линейный проход разорвет фразы и перемешает значения из разных колонок в одну нечитаемую строку.
Фундаментальная разница между двумя подходами к обработке графических файлов с таблицами наглядно проявляется в результатах каждого этапа анализа:
| Критерий обработки | Стандартное сплошное OCR | Технология Table OCR |
|---|---|---|
| Первичный анализ изображения | Поиск текстовых строк по всей ширине страницы | Пространственная сегментация макета и выделение контуров ячеек |
| Область чтения символов | Весь документ единым потоком | Локальные зоны внутри границ каждого отдельного сегмента |
| Учет координат элементов | Фиксация только порядка следования слов в строке | Строгая привязка значения к пересечению конкретной строки и столбца |
| Итоговое представление данных | Неструктурированный текстовый массив с потерянной разметкой | Упорядоченная двумерная матрица с сохранением исходных связей |
При использовании Table OCR каждое распознанное значение жестко привязывается к конкретной координате пересечения строки и столбца. Даже если отдельные области в оригинальном документе не содержат символов, в итоговой структуре они фиксируются как пустые ячейки. За счет этого предотвращается горизонтальный сдвиг данных и сохраняется точное соответствие между заголовками колонок и содержимым на протяжении всей таблицы.
Анализ структуры макета: обнаружение строк, столбцов и ячеек
Реконструкция табличного каркаса из плоского графического файла опирается на визуальные и пространственные ориентиры внутри макета. В зависимости от способа оформления исходной таблицы определение границ строк и столбцов базируется на двух фундаментальных подходах: поиске прорисованных графических разделителей или анализе геометрического расположения самих текстовых массивов.
Распознавание явных линий сетки и скрытой разметки
При наличии видимой разлиновки основой для построения макета служат горизонтальные и вертикальные линии. Точки их взаимного пересечения формируют замкнутые прямоугольные контуры, каждый из которых фиксируется как отдельная ячейка с точными пространственными координатами. Такая разметка задает жесткую геометрическую решетку, где границы сегментов однозначно отделяют соседние значения друг от друга независимо от плотности заполнения данными.
Во многих документах, отчетах и интерфейсах видимая сетка частично или полностью отсутствует. Таблицы могут содержать только горизонтальные разделители строк, выделяться чередованием фоновой заливки (зеброй) или строиться исключительно за счет отступов. В таких случаях структура реконструируется по выравниванию текстовых блоков и пробельным интервалам между ними.
При анализе безрамочных таблиц оценивается взаимное расположение ограничивающих рамок вокруг каждого слова или числа:
- Сквозные вертикальные коридоры пустого пространства, проходящие через всю высоту области данных от верхней до нижней границы, служат маркерами разделителей между столбцами.
- Единая базовая линия выравнивания фрагментов по левому краю, правому краю или центральной оси позволяет объединить разрозненные по вертикали записи в один логический столбец.
- Горизонтальные проекции текста и межстрочные просветы по всей ширине макета обозначают границы отдельных строк даже без начертанных линий.
| Тип оформления таблицы | Базовый ориентир для выделения структуры | Логика разделения соседних ячеек |
|---|---|---|
| Полная видимая сетка | Непрерывные горизонтальные и вертикальные линии | Фиксация замкнутых контуров по точкам пересечения графических границ |
| Частичная разлиновка (только строки или шапка) | Комбинация горизонтальных черт и вертикальных отступов | Членение на ряды по линиям, а на колонки - по сквозным пробельным коридорам |
| Таблица без границ (на отступах) | Координаты текстовых блоков и пустые пространства | Группировка элементов по осям выравнивания и анализу ширины межколоночных интервалов |
Обработка сложных элементов табличной верстки
Реальные таблицы редко представляют собой равномерную матрицу, где каждая ячейка строго равна соседней. При реконструкции структуры критическое значение имеет правильная интерпретация нестандартных элементов верстки, от которых зависит сохранение смысловых связей между данными.
Объединенные ячейки нарушают стандартный шаг сетки, охватывая сразу несколько смежных позиций по горизонтали (colspan) или по вертикали (rowspan). При анализе макета такие области выявляются по отсутствию внутренних перегородок на участке, где в соседних рядах или колонках проходят разделители. Горизонтальное объединение часто применяется в охватывающих заголовках и итоговых строках, а вертикальное - для группировки нескольких записей, относящихся к одной общей категории или дате. Для сохранения целостности матрицы объединенный сегмент сопоставляется со всем диапазоном перекрываемых индексов строк и столбцов.
Многоуровневые и вложенные заголовки создают иерархическую структуру в верхней части таблицы. Верхний ярус обычно представлен широкой ячейкой, объединяющей группу параметров (например, общий период или категорию показателей), а нижний ярус дробит эту область на отдельные узкие столбцы (конкретные месяцы, единицы измерения, план и факт). При построении итоговой структуры базовое количество колонок определяется по самому детальному нижнему уровню вложенности, чтобы столбцы с фактическими значениями не сливались друг с другом.
Отдельную задачу представляет разграничение многострочного текста внутри одной ячейки и нескольких самостоятельных строк таблицы. Когда длинное наименование или описание переносится на следующую линию в пределах узкой колонки, расстояние между этими строками меньше стандартного интервала между рядами таблицы. При наличии боковых границ или соседних колонок с одиночными значениями весь вертикальный блок текста удерживается внутри одной ячейки. Это предотвращает ложное дробление одного смыслового фрагмента на несколько пустых рядов и сохраняет горизонтальное соответствие данных по всей строке.
Требования к исходным изображениям и влияние качества на точность
Точность извлечения табличной структуры и значений напрямую зависит от визуальных и геометрических характеристик исходного графического файла. Любое оптическое искажение, размытие контуров или нарушение геометрии сетки меняет пространственное расположение пикселей, по которым определяются границы строк, столбцов и отдельных символов. Если исходный снимок имеет дефекты, линии разделителей могут прерываться, а текстовые блоки - сливаться с фоном или соседними графами.
Типы графических источников и их особенности
Набор потенциальных искажений во многом определяется способом получения изображения таблицы. В зависимости от происхождения графического файла входные данные делятся на три основные категории, каждая из которых имеет свои характерные свойства:
| Тип источника | Характерные особенности | Типичные дефекты и риски |
|---|---|---|
| Скриншоты экранов | Идеальная прямоугольная геометрия, отсутствие наклона, равномерный фон и четкие границы линий сетки | Низкое разрешение при захвате мелкого масштаба, артефакты сильного сжатия, сглаживание шрифтов на цветных подложках |
| Отсканированные документы | Стабильное освещение по всей площади листа, высокая плотность пикселей, сохранение пропорций ячеек | Перекос страницы при неровной укладке в лоток, просвечивание текста с обратной стороны листа, мелкий точечный шум или следы от сгибов |
| Фотографии печатных листов | Быстрая фиксация бумажных носителей в полевых условиях без использования планшетного сканера | Перспективные искажения при съемке под углом, неравномерный свет, тени от рук или смартфона, изгиб бумаги, расфокусировка по краям кадра |
Технические и геометрические параметры изображения
Разрешение и резкость определяют детализацию контуров букв, цифр и разделительных линий. При недостаточной плотности пикселей или оптическом размытии тонкие элементы шрифта пропадают, а мелкие пробелы между соседними символами заполняются переходными полутонами. В результате близко расположенные знаки воспринимаются как единый слитный контур, а тонкие линии сетки становятся неразличимыми на отдельных участках.
Контрастность текста относительно фона и отсутствие визуального шума необходимы для точного отделения полезных данных от подложки. Выцветшая печать на кассовых лентах, серые или цветные заливки ячеек, водяные знаки и текстура плотной бумаги снижают разницу в яркости между символами и фоном. Мелкие пятна, пыль на стекле сканера или зернистость матрицы при плохом освещении создают ложные графические объекты, которые могут нарушать оценку пустых пространств между колонками.
Геометрические отклонения делятся на плоский перекос и пространственные перспективные искажения. Перекос возникает, когда документ повернут на несколько градусов относительно горизонтальной оси кадра. Даже небольшой наклон приводит к тому, что левый край длинной строки оказывается выше или ниже правого края соседней строки. При отсутствии явных линий сетки это мешает правильно сопоставить элементы одной горизонтальной записи.
Перспективные искажения появляются при фотографировании листа под углом, а не строго сверху. Прямоугольная таблица на таком снимке приобретает форму трапеции: ближняя к объективу часть кажется шире, а дальняя - сужается, при этом вертикальные линии столбцов сходятся под углом. Если лист бумаги неровный (например, страница толстой книги у корешка или помятый бланк), строки получают дугообразный изгиб, что смещает координаты ячеек относительно прямой координатной сетки.
Рекомендации по подготовке файла перед обработкой
Предварительная подготовка исходного снимка устраняет большинство оптических помех и снижает риск смещения строк или потери значений. Перед отправкой изображения на распознавание целесообразно выполнить следующие действия:
- Выровнять горизонталь и устранить перспективу: при фотосъемке камеру следует держать строго параллельно плоскости листа, а уже готовые наклонные изображения повернуть так, чтобы строки текста и горизонтальные линии таблицы шли параллельно верхнему и нижнему краям кадра.
- Выполнить точное кадрирование: обрезать лишние поля вокруг таблицы, посторонние предметы на столе, штампы, рукописные пометки на полях и массивы сплошного текста, не относящиеся к табличным данным.
- Обеспечить равномерное освещение и контраст: фотографировать документы при рассеянном свете без бликов на глянцевой бумаге и резких падающих теней от корпуса устройства.
- Проверить фокусировку и читаемость: убедиться, что таблица находится в резкости по всей площади от центра до углов, а все символы в ячейках четко различимы невооруженным глазом без увеличения.
- Разгладить бумажный носитель: расправить места сгибов на бланках и плотно прижать страницы разворота, чтобы избежать волнообразного искривления строк.
Специфика распознавания текстовых и числовых значений в ячейках
После того как границы таблицы, строк и столбцов определены, начинается этап посимвольной интерпретации содержимого каждой отдельной ячейки. В отличие от сплошного абзацного текста, где смысл неверно распознанного символа часто восстанавливается по окружающим словам, табличные ячейки обычно содержат короткие изолированные фрагменты: числа, коды, даты или краткие наименования. Отсутствие развернутого языкового контекста внутри ячейки повышает требования к точности различения каждого знака, поскольку замена даже одного символа меняет числовое значение или превращает расчетный показатель в нечитаемую текстовую строку.
Проблема визуально схожих глифов в цифрах и буквах
Одной из главных сложностей при оптическом анализе содержимого ячеек является омоглифия - графическое сходство между цифрами, буквами разных алфавитов и специальными знаками. Во многих шрифтах без засечек, которые часто используются в электронных таблицах, чеках и печатных ведомостях, начертание отдельных цифровых и буквенных символов практически совпадает.
Если буквенный символ ошибочно подменяется цифрой в текстовом описании, запись остается понятной для человека. Однако обратная замена - попадание буквы внутрь числового значения - приводит к тому, что при последующей работе в табличных редакторах вся ячейка воспринимается как текст и исключается из математических расчетов.
Ниже приведены наиболее распространенные пары и группы визуально схожих символов, вызывающие ошибки при извлечении табличных значений:
| Цифровой или специальный символ | Визуально схожие буквенные глифы | Последствия подмены в табличных данных |
|---|---|---|
| Цифра 0 (ноль) | Прописная буква O (в латинице и кириллице) | Превращение числа в текстовую строку, искажение номенклатурных кодов и расчетных сумм |
| Цифра 1 (единица) | Прописная латинская I, строчная латинская l, вертикальная черта | | Сбой при вычислении сумм, искажение количества и порядковых номеров строк |
| Цифра 8 (восемь) | Прописная латинская B, кириллическая В | Потеря числового формата данных в финансовых и количественных столбцах |
| Цифра 5 (пять) | Прописная латинская S | Ошибки в ценах, процентах и серийных номерах |
| Цифра 2 (два) | Прописная латинская Z | Искажение индексов, маркировок и числовых коэффициентов |
| Цифра 6 (шесть) и 9 (девять) | Строчная буква б, прописная и строчная g | Неверная интерпретация дробных частей и показателей при низком качестве печати |
Интерпретация чисел, разделителей и специальных знаков
Для того чтобы извлеченные из изображения числовые столбцы сохранили вычислительную пригодность (возможность сразу применять к ним формулы суммирования, умножения или поиска среднего значения), критически важно точное распознавание не только самих цифр, но и сопутствующей пунктуации.
Особую роль играет корректное различение десятичных разделителей и разделителей групп разрядов (тысяч). В зависимости от локализации документа и стандартов оформления в исходной таблице целая и дробная части числа могут разделяться как запятой (например, 125,50), так и точкой (125.50). В свою очередь, для визуальной разбивки тысяч в крупных числах используются пробелы, точки, запятые или апострофы (например, 10 000, 10.000 или 10,000). На изображениях невысокого качества или при мелком кегле шрифта нижний хвостик запятой может сливаться с фоном, из-за чего она распознается как точка, либо микроскопический дефект бумаги (пылинка, артефакт сжатия) между цифрами ошибочно принимается за разделитель. Такая замена меняет порядок числа в сотни или тысячи раз.
Не менее значима точность извлечения математических знаков и финансовых обозначений, определяющих смысл показателя:
- Знаки положительных и отрицательных величин: дефис или знак минуса перед числом не должен сливаться с вертикальной границей ячейки, иначе отрицательное сальдо или убыток превратится в положительное значение, а знак плюса при низком разрешении может быть спутан с цифрой 4 или буквой т.
- Бухгалтерский формат отрицательных чисел: в финансовой отчетности отрицательные значения часто заключаются в круглые скобки (например, (500) вместо -500); при распознавании скобки не должны интерпретироваться как цифра 1, буква l или часть вертикальной сетки таблицы.
- Символы процентов и промилле: знак % при плотной верстке или размытии нередко распознается как сочетание цифр и слэша (0/0 или 96), что приписывает к исходному числу лишние разряды.
- Обозначения валют: графемы ₽, $, €, £, ¥, расположенные непосредственно до или после суммы, требуют четкого отделения от цифр; например, знак доллара $ при слабой пропечатке вертикальной линии легко путается с цифрой 5 или 8, а символ евро € - с буквой С или Е.
Особенности распознавания мультиязычного текста и смешанных значений
Во многих прикладных таблицах - от товарных накладных до технических спецификаций - в пределах одной строки или даже одной ячейки одновременно встречаются кириллица, латиница и цифры. Например, в графе с наименованием товара русскоязычное описание типа изделия сочетается с латинским названием бренда и буквенно-цифровой моделью.
Сложность посимвольного разбора таких участков связана с межъязыковой омоглифией: более десяти букв кириллического и латинского алфавитов имеют идентичное или крайне близкое графическое начертание (А и A, В и B, С и C, Е и E, Н и H, К и K, М и M, О и O, Р и P, Т и T, Х и X). В обычных словах принадлежность буквы к конкретному алфавиту определяется по соседним специфическим символам (например, буквам Д, Ж, Й, Щ в кириллице или Q, W, R, L в латинице). Однако в коротких табличных ячейках такие однозначные маркеры языка могут отсутствовать.
Наибольшую нагрузку при оптическом распознавании вызывают смешанные (альфа-нумерические) и строго форматированные значения, в которых отсутствует словарная логика:
- Артикулы, SKU и серийные номера: представляют собой произвольные комбинации букв, цифр, дефисов и косых черт (например, АБ-108/S5 или XK-001-B). Поскольку любая комбинация символов в коде потенциально допустима, распознавание опирается исключительно на геометрическую четкость каждого отдельного знака на изображении.
- Календарные даты и время: записываются через точки, слэши или дефисы (например, 05.11.2024 или 2024/11/05). Потеря или неверное прочтение разделителя превращает дату в сплошное многозначное число, а подмена слэша (/) на единицу или цифру 7 полностью искажает временной период.
- Диапазоны значений и размерности: записи вида 10-15 шт., 220В или 100х200х50 мм содержат буквы кириллицы и латиницы вперемешку с цифрами. При этом знак умножения (х) часто совпадает по форме с буквой х, а дефис в числовом диапазоне может быть принят за знак вычитания.
Проверка и выверка извлеченных табличных данных
После завершения распознавания и формирования таблицы наступает этап обязательной проверки полученных данных. Даже при высоком качестве исходного изображения в сложных макетах или плотных цифровых сводках могут возникать локальные расхождения. Системная выверка результата позволяет убедиться, что как структура сетки, так и содержимое отдельных ячеек перенесены в точном соответствии с оригиналом.
Контроль размерности и целостности сетки
Первичный этап валидации начинается со сверки общей геометрии полученной таблицы с исходным изображением. Необходимо сопоставить общее количество распознанных строк и столбцов с оригиналом, прежде чем переходить к чтению отдельных значений.
Особое внимание при проверке структуры уделяется трем типовым ситуациям:
- Соответствие числа колонок и рядов: если на изображении присутствует слабоконтрастная разделительная линия или слишком широкий пробел внутри текста, один столбец может разделиться на два, либо два соседних столбца могут слиться в один. Быстрый пересчет колонок по заголовкам сразу выявляет подобные структурные расхождения.
- Отсутствие горизонтального смещения значений (сдвиг колонок): в таблицах с незаполненными ячейками пропуск пустой позиции приводит к тому, что все последующие данные в строке сдвигаются на одну или несколько ячеек влево. Чтобы исключить такой сдвиг, достаточно проверить последний заполненный столбец таблицы: все значения в нем должны строго соответствовать заголовку своей колонки, а не соседней.
- Целостность многострочных записей: если в оригинале длинное наименование или комментарий внутри одной ячейки располагались в несколько этажей, важно убедиться, что при извлечении этот текст остался внутри одного ряда, а не породил дополнительные фальшивые строки с пустыми значениями в остальных колонках.
Верификация числовых данных через контрольные суммы
Поштучная визуальная сверка больших массивов цифр с графическим оригиналом требует много времени и не исключает пропуска опечаток из-за усталости глаз. Если исходная таблица содержит итоговые строки или столбцы (например, строки «Итого», «Всего» или промежуточные подитоги), проверку точности распознанных чисел выполняют математическим способом.
Принцип математической верификации заключается в пересчете суммы, среднего значения или произведения по извлеченным строкам и столбцам с последующим сравнением вычисленного результата с итоговым значением, которое было распознано из самой таблицы. Полное совпадение расчетной суммы с распознанным итогом подтверждает, что ни одна цифра, десятичный разделитель или разряд в проверяемом диапазоне не были искажены.
Ниже приведена схема диагностики типовых расхождений при проверке табличных данных и способы их быстрого обнаружения:
| Тип расхождения | Признак в извлеченной таблице | Способ быстрой локализации |
|---|---|---|
| Сдвиг значений в строке из-за пропуска пустой ячейки | Данные разных типов оказываются в одной колонке (например, дата попадает в столбец с ценой), а крайняя правая ячейка строки остается пустой | Просмотр крайнего правого столбца сверху вниз и проверка однородности типа данных в каждой колонке |
| Разрыв многострочной ячейки на отдельные строки | Общее количество строк превышает оригинал; под заполненной строкой появляется ряд, где текст есть только в одной колонке, а остальные ячейки пусты | Сверка порядковой нумерации строк (если есть столбец № п/п) или фильтрация пустых значений по ключевому числовому столбцу |
| Подмена цифры или потеря десятичного разделителя | Пересчитанная сумма по столбцу не сходится с числом, распознанным в строке «Итого» | Вычисление разницы между расчетной суммой и распознанным итогом: величина расхождения сразу указывает на порядок числа, в котором допущена неточность |
| Повторное слияние соседних колонок без видимой сетки | В одной ячейке через пробел записаны два независимых показателя (например, количество и цена за единицу) | Сравнение количества столбцов в шапке таблицы с количеством столбцов в области данных |
Порядок выборочной и сплошной выверки
Когда в таблице отсутствуют итоговые строки или таблица состоит преимущественно из текстовых, кодовых и справочных значений, применяется комбинированный порядок проверки. Вместо последовательного чтения каждой ячейки подряд выверку разделяют по типам данных.
Сначала визуально просматриваются колонки со строго фиксированным форматом записей: даты, индексы, артикулы, телефонные номера или коды классификаторов. В таких столбцах любая ошибка распознавания сразу выделяется за счет нарушения длины строки или появления нетипичных символов (например, буквы посреди числового кода или четырехзначного числа на месте даты).
На заключительном этапе проверяются позиции, которые не поддаются автоматическому пересчету через общие итоги: номера документов, процентные ставки, номера партий и единицы измерения. После устранения выявленных неточностей табличные данные полностью готовы к дальнейшему использованию в расчетах, отчетах или учетных базах.
Практические сценарии оцифровки таблиц из изображений
Операция извлечения табличных данных из графических файлов применяется тогда, когда исходный документ существует только в бумажном виде, представлен растровым изображением или закрыт для прямого копирования текста. Преобразование картинки в упорядоченный набор строк и столбцов избавляет от ручного ввода и сохраняет структуру взаимосвязанных показателей.
Обработка первичной документации и финансовых отчетов
В бухгалтерском, складском и управленческом учете значительная часть входящих документов поступает от контрагентов или подотчетных лиц в виде бумажных экземпляров, отсканированных копий или фотографий. Ручной перенос десятков и сотен товарных позиций в учетные регистры отнимает много времени и часто приводит к опечаткам в артикулах или суммах.
Извлечение табличных данных используется при работе со следующими видами документов:
- Товарные накладные, счета на оплату и УПД - перенос списков номенклатуры, единиц измерения, количества, цены за единицу, сумм без налога, налоговых ставок и итоговой стоимости поставки.
- Акты выполненных работ и оказанных услуг - оцифровка перечня этапов, объемов выработки, расценок и закрываемых периодов.
- Кассовые и товарные чеки - извлечение перечня приобретенных позиций, количества и стоимости для оформления авансовых отчетов и сверки фактических расходов.
- Инвентарные и сличительные ведомости - перевод заполненных вручную или распечатанных бланков ревизии в редактируемый вид для сопоставления учетных и фактических остатков на складе.
При оцифровке первичной документации критическое значение имеет точное сохранение соответствия между наименованием позиции и ее количественно-суммовыми показателями в пределах одной строки. Наличие итоговых сумм в нижней части таких бланков упрощает последующую математическую сверку полученных значений.
Аналитика, мониторинг цен и сбор данных
Аналитикам, маркетологам и специалистам по закупкам регулярно приходится собирать данные из внешних источников, которые не предоставляют выгрузку в табличных форматах. Нередко коммерческие предложения, отраслевые обзоры или финансовые результаты публикуются в виде плоских изображений, защищенных от копирования страниц или видеокадров.
Такое преобразование применяется в нескольких типовых ситуациях:
- Скриншоты презентаций и вебинаров - извлечение финансовых показателей, планов продаж, маркетинговых метрик и сравнительных матриц непосредственно со слайдов, показанных во время трансляции или сохраненных в виде картинок.
- PDF-отчеты без текстового слоя - получение статистических сводок, балансовых ведомостей и макроэкономических таблиц из отсканированных отраслевых бюллетеней, годовых отчетов компаний и архивных публикаций.
- Прайс-листы и каталоги поставщиков - перевод расценок, размерных сеток, остатков и условий скидок, присланных в мессенджерах или размещенных в виде баннеров, в структурированный формат для сравнения цен и расчета маржинальности.
- Веб-страницы без доступа к исходному коду и выгрузке - сбор биржевых котировок, курсов, тарифов или рейтингов с динамических дашбордов и защищенных клиентских порталов путем создания снимка экрана и его последующего распознавания.
Учебные, инженерные и научные задачи
В научной, образовательной и проектной деятельности большой объем справочной и экспериментальной информации хранится в печатных изданиях, архивных сборниках, стандартах и лабораторных журналах. Для проведения вычислений, построения графиков или математического моделирования эти сведения необходимо перевести в цифровую форму.
На практике оцифровка таблиц из сканов книг и печатных публикаций решает следующие задачи:
- Работа со справочными таблицами и стандартами - перевод таблиц физических констант, термодинамических свойств веществ, коэффициентов погрешности, допусков и посадок, а также характеристик строительных материалов и металлопроката в редактируемый вид.
- Оцифровка числовых матриц и математических таблиц - извлечение многомерных массивов чисел, таблиц распределения вероятностей и тригонометрических или логарифмических сеток для их прямой подстановки в расчетные модели.
- Обработка результатов измерений и наблюдений - перенос данных из печатных протоколов испытаний, метеорологических сводок, геологических разрезов и социологических опросов, опубликованных в научных статьях и монографиях, для статистической обработки и проверки гипотез.
Сводное сравнение прикладных сценариев
Специфика исходных материалов и требования к проверке полученного результата напрямую зависят от прикладной области. В таблице ниже сопоставлены основные направления использования операции, характерные источники изображений и ключевые акценты при работе с извлеченными данными.
| Сфера применения | Типичные источники изображений | Основные извлекаемые значения | Приоритет при проверке результата |
|---|---|---|---|
| Первичный учет и финансы | Сканы и фотографии счетов, накладных, актов, УПД, чеков, инвентарных ведомостей | Номенклатура, артикулы, количество, цены, налоговые ставки, итоговые суммы | Сходимость арифметических итогов по строкам и столбцам, точность кодов и артикулов |
| Аналитика и коммерция | Скриншоты презентаций, защищенных веб-страниц, PDF-отчетов, графические прайс-листы | Статистические сводки, котировки, тарифы, расценки, проценты динамики | Сохранение структуры многоуровневых заголовков, корректность знаков процентов и валют |
| Наука, образование и инженерия | Сканы книг, справочников, ГОСТов, научных публикаций и архивных журналов | Справочные коэффициенты, числовые матрицы, результаты замеров, погрешности | Точность десятичных разделителей, знаков отрицательных величин и степеней чисел |