Анализ структурированных данных JSON-LD представляет собой процесс автоматического извлечения, синтаксического разбора и верификации семантической разметки из исходного кода веб-страниц. Инструмент принимает целевой URL, загружает HTML и изолирует фрагменты кода, содержащие машиночитаемое описание контента. Выполняется прямая проверка синтаксиса на соответствие строгим спецификациям формата JSON.
Валидация решает базовые задачи технического SEO. Поисковые системы требуют безошибочной структуры кода для интерпретации контента.
Пользователь запускает проверку через ввод адреса страницы. Анализатор идентифицирует все внедренные словари Schema.org и оценивает правильность построения графа данных. Итоговый результат демонстрирует полную иерархию обнаруженных сущностей и статус их валидации. Система точно указывает локализацию синтаксических сбоев. Отчет фиксирует конкретные строки с нарушенной структурой массива, неверным экранированием символов или отсутствующими обязательными свойствами.
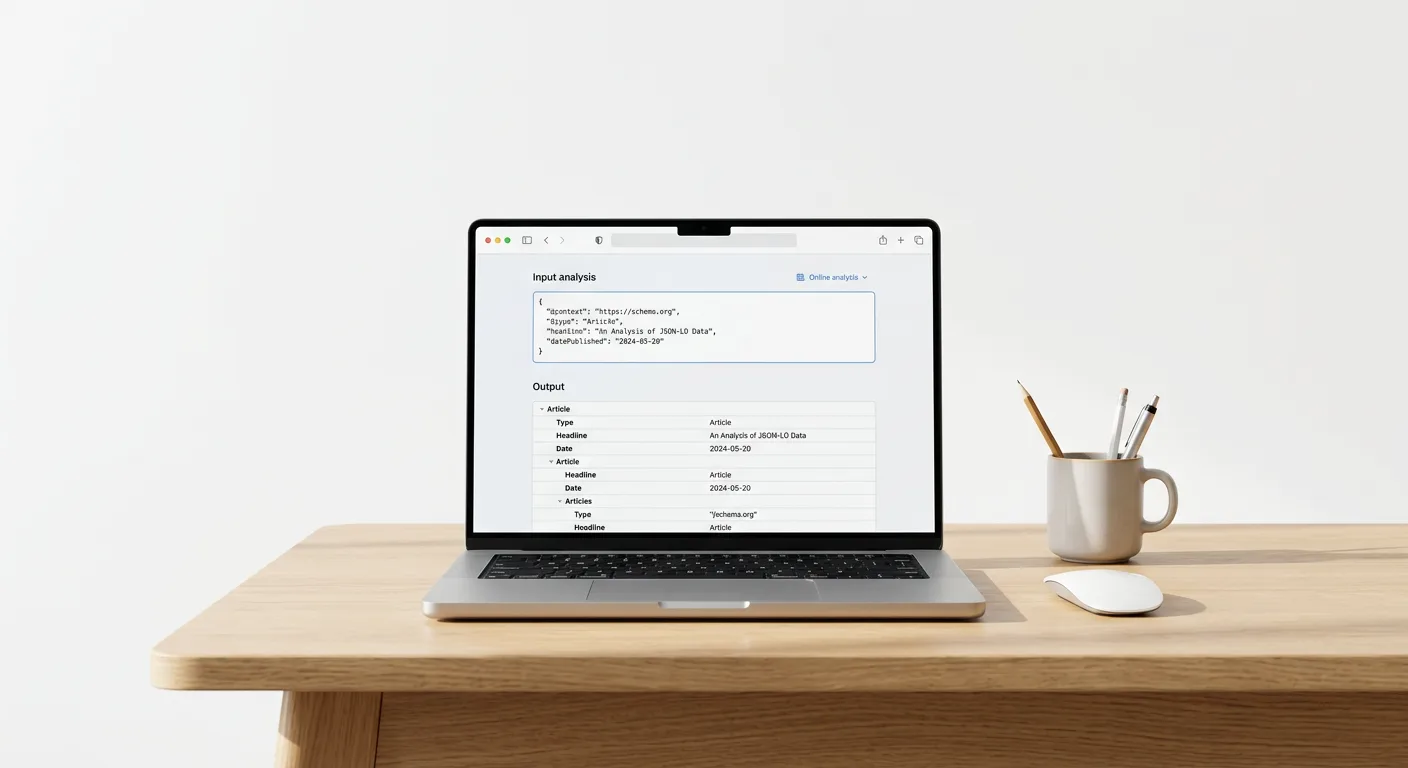
Принципы внедрения JSON-LD в исходный HTML-код
Сериализация LD представляет собой метод кодирования связанных данных с использованием базового синтаксиса JSON. Данный подход позволяет упаковать сложный граф сущностей в простой текстовый формат. Машиночитаемые данные формируются в виде единого блока, который логически изолирован от пользовательского интерфейса. Разделение данных и представления гарантирует, что структурированная информация передается поисковым системам без влияния на визуальный макет веб-страницы.
Внедрение словаря объектов в структуру документа требует точного соблюдения правил контейнеризации. Код разметки размещается внутри тега script. Для идентификации содержимого как графа связанных данных, а не исполняемого сценария, элементу назначается строгий MIME-тип.
<script type="application/ld+json">
// семантическая разметка
</script>
Спецификация HTML допускает интеграцию данного контейнера в различные области исходного кода. Выбор зоны внедрения зависит от архитектуры проекта и метода генерации контента:
- Элемент head: Оптимальная область для размещения глобальной семантической разметки. Данные загружаются на начальном этапе обработки документа до рендеринга визуального контента.
- Раздел body: Альтернативная зона для внедрения кода, применяемая при компонентном подходе или динамической привязке разметки к определенным блокам.
В процессе загрузки веб-страницы браузер преобразует исходный HTML-код в объектную модель DOM. Интегрированный скрипт внедряется в общую структуру как отдельный текстовый узел данных. Такое размещение формирует независимый семантический слой страницы. Машиночитаемое описание существует в иерархии документа параллельно стандартным тегам, что позволяет обновлять верстку или изменять дизайн без риска повреждения графа данных.
Алгоритм синтаксического анализа и извлечения разметки
Первоначальный этап обработки структурированных данных заключается в локализации целевых контейнеров в исходном коде веб-страницы. Парсер сканирует документ, выполняя прямой поиск элементов script, строго содержащих атрибут type со значением application/ld+json. Все остальные сценарии, стили и элементы разметки игнорируются, что позволяет изолировать машиночитаемую семантическую нагрузку от визуального контента страницы.
Механика поиска и извлечения контейнеров напрямую зависит от архитектуры ресурса и способа формирования контента. Доступность скрипта для парсера определяется двумя базовыми сценариями генерации кода:
- Обработка статического HTML: Код JSON-LD присутствует в первичном ответе сервера. Извлечение происходит на этапе лексического анализа текстового документа, не требуя предварительного построения полного дерева DOM.
- Анализ при JavaScript-рендеринге: Разметка генерируется на стороне клиента. В исходном ответе сервера контейнер с данными отсутствует. Для обнаружения и извлечения скрипта требуется среда выполнения JS, способная отрендерить страницу и дождаться внедрения узла данных в структуру документа.
Если парсинг динамического ресурса выполняется без интерпретации клиентских сценариев, алгоритм поиска не обнаружит контейнер application/ld+json, поскольку на момент анализа текстовой строки узел данных еще не сформирован.
После успешной идентификации целевого тега в работу вступает JSON-LD-процессор. Процесс извлечения начинается с захвата чистого текстового содержимого контейнера. Парсер отсекает сами обрамляющие теги script, изолируя внутреннюю текстовую строку, представляющую собой сериализованный граф данных.
Далее инициируется синтаксический анализ извлеченной строки. Текстовая последовательность передается парсеру, который выполняет токенизацию и преобразует плоский текст во внутренние структуры памяти - словари объектов. В ходе этого процесса сериализованная строка десериализуется в программные объекты, состоящие из пар "ключ-значение".
Преобразование текстовой строки в словари объектов позволяет перевести данные из строкового представления в иерархическую древовидную модель. Завершение алгоритма синтаксического разбора формирует структурированный набор узлов, полностью готовый к последующему поэлементному анализу.
Проверка синтаксиса и структуры объектов JSON
Сформированная иерархическая древовидная модель проходит этап строгой синтаксической валидации. Основой структуры выступают пары "ключ-значение". Правила формата требуют, чтобы все строковые ключи обязательно заключались в двойные кавычки. Ассоциированные с ними значения могут принимать форму строк, чисел, логических констант, массивов или дополнительных вложенных объектов.
Корректность построения иерархии напрямую зависит от применения ограничивающих символов. Фигурные скобки используются для формирования словарей объектов, объединяя логически связанные атрибуты отдельной сущности. Квадратные скобки применяются для создания массивов значений, когда одному ключу необходимо присвоить список из нескольких элементов.
Отдельной проверке подлежит обработка текстовых значений, содержащих служебные символы. Для предотвращения разрыва строковых данных и последующего отказа парсера требуется правильное экранирование символов. Использование обратного слеша перед внутренними кавычками и управляющими знаками сохраняет целостность передаваемого текста внутри значения.
Зарезервированные структурные ключи
Спецификация JSON-LD расширяет базовый синтаксис за счет внедрения специальных структурных идентификаторов. Валидация семантического слоя включает проверку наличия, расположения и корректности заполнения следующих зарезервированных ключей:
-
@context: Определяет пространство имен и указывает ссылку на внешний LD-словарь. Является обязательным элементом корневого объекта, задающим правила интерпретации всех последующих атрибутов. -
@type: Устанавливает классификацию описываемой сущности. Значение этого ключа определяет набор допустимых свойств для конкретного словаря объектов. -
@id: Назначает уникальный идентификатор узлу данных. Позволяет связывать различные элементы разметки между собой и ссылаться на один и тот же объект из разных частей документа. -
@list: Обозначает строго упорядоченную коллекцию. Применяется в массивах значений, где точная последовательность элементов имеет семантическое значение и не может быть изменена произвольно. -
@graph: Формирует массив независимых узлов верхнего уровня. Позволяет декларировать несколько равнозначных сущностей внутри одного контейнера, разделяющих общий словарь без создания единого родительского объекта.
Соблюдение правил расстановки скобок, кавычек и зарезервированных ключей формирует синтаксически корректный документ, готовый к проверке на соответствие требованиям конкретных семантических словарей.
Анализ типов данных и вложенных сущностей Schema.org
После подтверждения синтаксической целостности документа выполняется семантический анализ заявленных классов. Процесс основан на строгой явной типизации, где значение ключа
@type
жестко определяет предметную область текущего узла данных. Анализ классификации охватывает основные стандартизированные типы словаря Schema.org:
-
Article -
Product -
FAQPage -
BreadcrumbList -
LocalBusiness -
AggregateRating -
Organization -
Event
Для каждого идентифицированного типа осуществляется проверка соответствия обнаруженных пар 'атрибут-значение'. Логика валидации заключается в сопоставлении ключей внутри словаря объекта с допустимым набором свойств, зарезервированных для конкретного значения
@type
. Назначение узлу свойств, принадлежащих несовместимым ветвям онтологии Schema.org, фиксируется как семантическое несоответствие. Кроме того, проверяется ожидаемый формат значения: атрибут может требовать передачи текстовой строки, числового формата, даты, логического значения или указания на другой структурный узел.
Валидация вложенных сущностей (node objects)
Графовая модель данных подразумевает создание многоуровневых иерархических связей. В таких структурах значениями атрибутов выступают не примитивные типы данных, а самостоятельные словари объектов - node objects. Валидация вложенных сущностей требует анализа контекста их применения в рамках родительского элемента.
При семантическом разборе проверяются следующие структурные свойства связывания:
-
mainEntityOfPage: Связывает объект с документом, в котором он описан. Валидация проверяет, передано ли значение в виде абсолютного URL-адреса или в качестве вложенного объектаWebPage, содержащего собственный идентификатор. -
mainEntity: Указывает на первичный объект внутри абстрактного контейнера. При анализе проверяется корректность инверсии связи: родительский элемент должен ссылаться на основную сущность страницы, например, связывая типWebPageс вложенным типомArticleилиLocalBusiness. -
itemListElement: Формирует структуру упорядоченных или неупорядоченных списков. Логика проверки требует, чтобы значением выступал массив вложенных объектовListItem. Для каждого элемента массива проверяется наличие обязательных внутренних атрибутов, таких какposition(порядковый номер) иitem(ссылка на сущность), что является строгим требованием для структур типаBreadcrumbList.
Анализ графа объектов подтверждает, что иерархия выстроена без циклических зависимостей, а типы вложенных сущностей не противоречат ожидаемым значениям свойств родительского класса.
Идентификация синтаксических ошибок и отладка кода
Формирование корректного семантического графа, описанного ранее, невозможно без соблюдения строгих правил спецификации формата. Критерием недопустимого документа является любое нарушение базового синтаксиса, которое прерывает работу парсера на этапе лексического анализа. Если исходный код содержит структурные аномалии, преобразование текстовой строки в машиночитаемый объект становится невозможным, и весь блок данных дисквалифицируется.
При отладке кода первоочередной задачей выступает выявление синтаксических ошибок. К типичным нарушениям, вызывающим сбой парсинга, относятся:
- Незакрытые скобки: Отсутствие парной фигурной скобки для словаря объектов или квадратной скобки для массива значений разрушает иерархию вложенности и приводит к ошибке конца файла при чтении потока токенов.
- Пропущенные запятые: Отсутствие разделителя между парами ключ-значение или элементами массива вызывает сбой разбора. Аналогично спецификация запрещает использование висячих запятых непосредственно перед закрывающей скобкой.
- Нарушение структуры массива: Попытка передать пары ключ-значение напрямую в список без предварительного оборачивания во внутренний объект или использование некорректных разделителей внутри массива.
- Невалидные элементы строковых данных: Присутствие неэкранированных двойных кавычек внутри строкового значения, а также использование неэкранированных управляющих символов, таких как прямые переносы строк или символы табуляции внутри текстовых узлов.
В процессе отладки необходимо строго разделять проблемы, связанные с базовым синтаксисом передачи данных, и несоответствия правилам построения микроразметки. Разница заключается в уровне обработки документа и последствиях для извлечения информации.
| Критерий оценки | Фатальная синтаксическая ошибка | Эвристическая проверка |
|---|---|---|
| Уровень возникновения проблемы | Лексический и синтаксический анализ структуры документа. | Семантический анализ извлеченного словаря объектов. |
| Влияние на работу процессора | Полная остановка синтаксического анализатора. Весь скрипт признается недействительным. | Парсер успешно извлекает объекты, но выявляет логические несоответствия в парах атрибут-значение. |
| Примеры нарушений | Незакрытая кавычка, пропущенная запятая, нарушение формата массива. | Отсутствие обязательного свойства, использование неверного типа данных, противоречие General structured data guidelines. |
| Следствие для обработки данных | Поисковый робот или анализатор не может распознать наличие структурированных данных на странице. | Разметка считывается и обрабатывается, но сущность признается неполной или логически противоречивой. |
Устранение фатальных синтаксических ошибок восстанавливает машиночитаемость скрипта. Только после того, как валидность базовой структуры подтверждена, целесообразно переходить к эвристической оценке словаря на соответствие требованиям General structured data guidelines для конкретных типов сущностей.
Практическое применение результатов анализа в техническом SEO
Корректно сформированный скрипт JSON-LD напрямую влияет на эффективность сканирования документа поисковыми роботами. Когда Googlebot обнаруживает в исходном коде валидный блок application/ld+json, процесс извлечения семантической информации происходит в обход ресурсоемкого анализа визуальных элементов и текстовых узлов. Отсутствие синтаксических ошибок и логических противоречий в разметке гарантирует, что парсер поисковой системы без задержек преобразует машиночитаемый код во внутренние структуры данных, экономя краулинговый бюджет и ускоряя индексацию критически важных свойств страницы.
Проверенная и соответствующая спецификациям разметка является техническим фундаментом для формирования расширенных результатов в SERP. Поисковые алгоритмы используют извлеченные пары атрибут-значение для генерации визуально обогащенных сниппетов, которые получают приоритет при отображении в поисковой выдаче. Применение валидного кода решает сразу несколько прикладных задач ранжирования и представления:
- Точная и безошибочная передача динамических характеристик объектов в поисковый индекс без зависимости от скорости рендеринга DOM.
- Снижение риска потери расширенных сниппетов в SERP при изменениях структуры HTML-шаблона, так как слой данных изолирован от визуального представления.
- Повышение релевантности документа по низкочастотным запросам за счет явного декларирования скрытых или неявных свойств сущности.
Стратегическая ценность валидных структурированных данных максимально раскрывается в парадигме Entity SEO. Использование точной семантической разметки переводит контент из набора неструктурированных текстовых строк в графовую модель (entity-centric representation). В этой модели страница рассматривается не как коллекция ключевых слов, а как набор взаимосвязанных объектов с четкими атрибутами.
Каждая корректно описанная и верифицированная сущность выступает информационным узлом для передачи нормализованных данных в Google Knowledge Graph. Анализ структуры словарей JSON позволяет убедиться, что связи между объектами выстроены логично, обеспечивая поисковой системе контекст, необходимый для включения фактов в глобальную Сеть знаний.
| Аспект обработки контента | Сценарий без валидного JSON-LD (Document-centric) | Сценарий с валидным JSON-LD (Entity-centric) |
|---|---|---|
| Идентификация объектов на странице | Эвристический анализ текстового контента и структуры HTML-тегов. | Прямое извлечение свойств и типов из изолированного скрипта. |
| Установление связей между фактами | Вероятностная модель, основанная на семантической близости слов. | Однозначные связи через вложенные сущности и уникальные идентификаторы. |
| Интеграция с Google Knowledge Graph | Затруднена, требует длительного накопления сигналов и внешних подтверждений. | Прямая передача нормализованных фактов в графовую базу данных поисковой системы. |
Ориентация на entity-centric representation требует абсолютной технической безупречности скриптов. Любое логическое несоответствие между заявленным типом объекта и набором его атрибутов блокирует интеграцию данных в Сеть знаний, возвращая поисковые алгоритмы к базовому лексическому анализу страницы.