Валидация структурированных данных Schema.org решает задачу автоматического поиска и проверки машиночитаемой разметки на веб-страницах. Инструмент выполняет прямой парсинг исходного кода для точного извлечения семантических элементов. Ручной перебор сотен строк кода полностью исключается.
Процесс синтаксического анализа сверяет извлеченное описание с официальными спецификациями семантического словаря Schema.org. Валидатор последовательно проверяет иерархию узлов, обязательные свойства и типы значений для каждой заявленной сущности. Одно пропущенное поле или лишняя скобка могут сделать весь блок недействительным. Система выявляет такие несоответствия на уровне алгоритмической проверки.
Входными данными для запуска сканирования служит прямой URL адрес проверяемой страницы или текстовый фрагмент HTML. На выходе формируется детализированный отчет.
Пользователь получает общий статус валидности кода и полный список найденных сущностей. Ниже выводится перечень выявленных ошибок синтаксиса и структуры. Проблемные участки кода локализуются для последующего исправления.
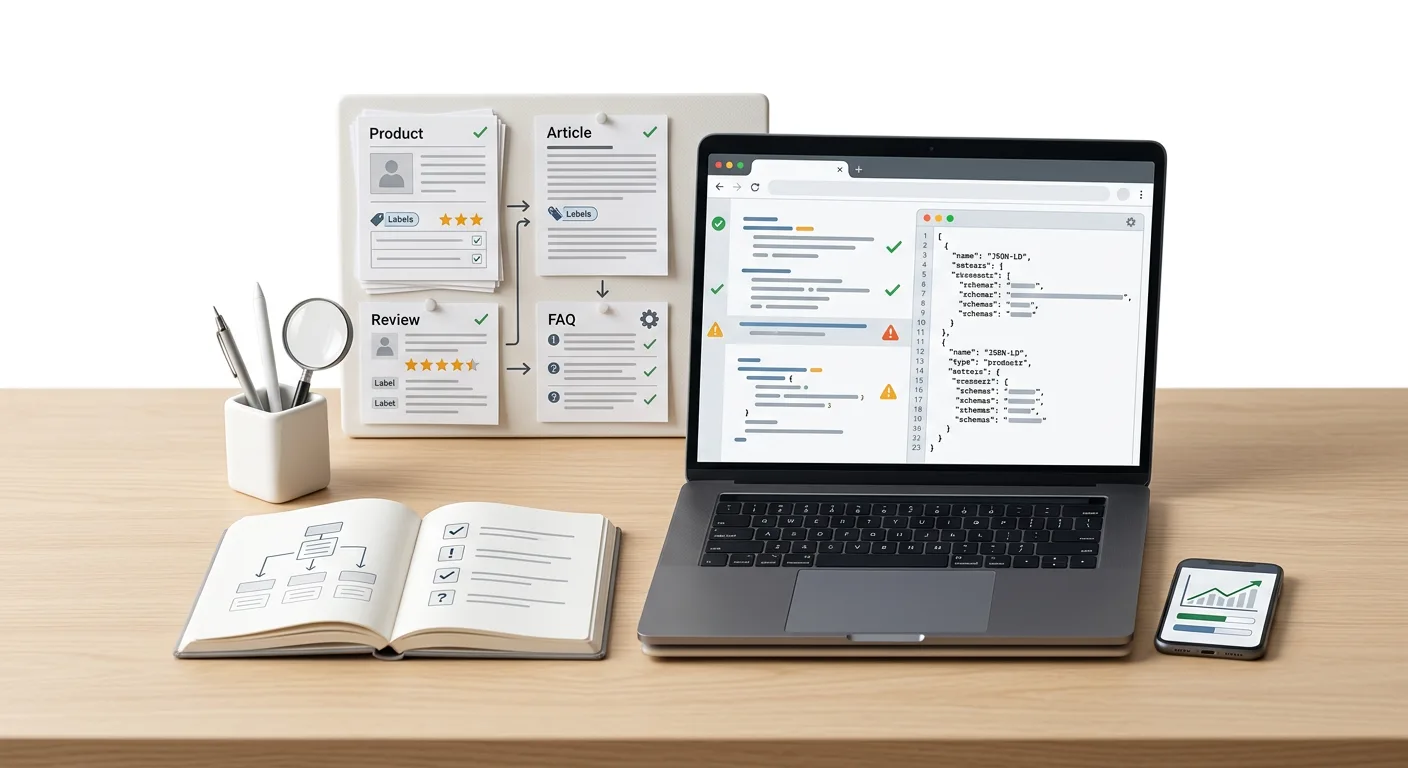
Поддерживаемые форматы разметки: парсинг JSON-LD, Microdata и RDFa
Процесс извлечения семантических данных из исходного кода основан на точной идентификации машиночитаемого контекста. Сканирование документа направлено на поиск стандартизированных форматов, содержащих описание сущностей. Парсер обнаруживает участки кода с микроразметкой и полностью изолирует их от общей структуры веб-страницы для формирования независимого массива данных.
Парсинг JSON-LD
Алгоритм поиска JSON-LD ориентирован на закрытые блоки внутри документа. Парсер сканирует исходный код на наличие тегов script. При обнаружении точного совпадения атрибута type со значением application/ld+json алгоритм считывает внутреннее содержимое тега.
Весь текстовый блок извлекается как единая структура. Механизм изоляции на этом этапе отсекает любые элементы DOM-дерева, находящиеся за пределами найденного скрипта. Исходный код страницы игнорируется, и в рабочую область передается исключительно чистый текстовый фрагмент JSON-LD для последующего анализа.
Обработка Microdata
Формат Microdata интегрируется непосредственно в визуальные элементы HTML. Обработка этого стандарта требует поузлового обхода документа и анализа встроенных атрибутов. В процессе сканирования парсер идентифицирует следующие маркеры:
- itemscope указывает на создание нового блока, определяя границы описываемой сущности в рамках текущего тега.
- itemtype содержит URL, который задает конкретный класс объекта.
- itemprop присваивает значения свойствам сущности, извлекая их из атрибутов тега или его текстового содержимого.
Изоляция данных в формате Microdata происходит путем абстрагирования от самих HTML-тегов. Алгоритм считывает только указанные семантические атрибуты и их иерархическую вложенность. Визуальная функция тегов и классы стилизации полностью исключаются из формируемого массива.
Обработка RDFa
Извлечение данных формата RDFa базируется на анализе атрибутов HTML-узлов, опираясь на собственную спецификацию. Парсер сканирует код для обнаружения базовых директив словаря и типов сущностей. Ключевыми атрибутами при обработке выступают vocab и typeof.
Атрибут vocab задает пространство имен для вложенных элементов, а typeof определяет семантический тип описываемого объекта. Свойства извлекаются через анализ дополнительных атрибутов текущего и вложенных узлов. Как и в случае с Microdata, парсер строит машиночитаемую модель данных, игнорируя несемантические узлы и атрибуты форматирования страницы.
Независимо от исходного формата разметки, итогом работы парсера является очищенный набор структурированных данных. Изолированный код представляет собой стандартизированное описание найденных объектов, полностью подготовленное к проверке на соответствие словарю.
Синтаксический анализ и проверка соответствия словарю Schema.org
После извлечения изолированного машиночитаемого кода процедура валидации разделяется на два последовательных логических этапа. Первоначальная задача заключается в подтверждении технической целостности форматов передачи данных, после чего выполняется семантическая сверка с правилами целевого словаря.
Первый этап: проверка синтаксиса
Проверка синтаксиса гарантирует, что извлеченный фрагмент кода является корректным документом, пригодным для машинного чтения. В случае обработки формата JSON-LD выполняется строгая инспекция структуры JSON. Анализ направлен на выявление базовых технических нарушений, которые делают невозможным формирование объектной модели.
К основным проверяемым синтаксическим конструкциям относятся:
- Наличие парных открывающих и закрывающих фигурных скобок для объектов и квадратных скобок для массивов.
- Точная расстановка запятых между элементами перечислений и парами ключ-значение, а также отсутствие висячих запятых в конце списков.
- Корректное использование двойных кавычек для оборачивания строковых ключей и передаваемых значений.
При обнаружении синтаксических ошибок процесс останавливается, так как поврежденный код не поддается логическому разбору. Только синтаксически верный документ передается на следующий уровень инспекции.
Второй этап: структурная валидация
При условии прохождения первого этапа выполняется структурная валидация. На этом шаге логическая организация данных сопоставляется с архитектурой и правилами стандарта Schema.org. Проверяется не просто правильность написания символов, а смысл переданных инструкций.
Обязательным условием начала семантической проверки является присутствие базовых директив. Валидация требует наличия объявления @context, которое задает корневое пространство имен и жестко привязывает описываемые сущности к словарю Schema.org. Параллельно инспектируются идентификаторы @id, если они присутствуют в коде. Эти директивы обеспечивают корректное связывание разрозненных узлов в единый граф данных и предотвращают цикличные или разорванные ссылки внутри разметки.
После подтверждения базовых системных директив проверяется корректность пар имя-значение для заявленных классов. Анализ включает следующие логические сверки:
- Принадлежность используемого свойства к объявленному типу сущности согласно спецификации словаря.
- Соответствие переданного значения ожидаемому формату данных, который требует конкретное свойство.
- Отсутствие конфликтов в иерархии наследования классов.
Разделение проверки на технический и структурный этапы позволяет точно определить природу дефекта в разметке, локализовав проблему либо на уровне базовых правил написания кода, либо на уровне логики применения семантического словаря.
Валидация типов сущностей, свойств объектов и иерархии вложенности
После подтверждения базовой структуры начинается предметный анализ разметки. Логика проверки обязательных полей напрямую зависит от обнаруженных типов сущностей. Для каждого заявленного класса применяется собственный набор правил, регламентирующий присутствие обязательных и рекомендуемых свойств. Процесс валидации сопоставляет фактические узлы графа данных с актуальными требованиями стандарта.
Важным этапом является проверка соответствия типов данных. Спецификация словаря строго определяет, какой формат значения допустим для конкретного свойства. Механика инспекции анализирует переданные данные на предмет семантических несоответствий. Выполняется проверка ожидаемых форматов: например, валидация отклонит разметку, если свойство, требующее строго числового значения, получит данные в виде текстовой строки. Аналогичным образом контролируются форматы дат, логические значения и стандарты записи URL-адресов.
Предметные сценарии валидации адаптируются под архитектуру конкретных классов. Проверка полноты разметки включает следующие логические сверки:
- Для сущности Product выполняется инспекция коммерческих узлов. Требуется наличие вложенного типа Offer, внутри которого обязательно присутствие свойств цены price и валюты priceCurrency. Дополнительно проверяется наличие блока пользовательских оценок AggregateRating.
- Для разметки FAQPage анализируется структура массивов данных. Логика требует наличия списка сущностей Question, каждая из которых должна содержать строго вложенный объект Answer с текстом ответа.
- Для навигационных элементов BreadcrumbList инспектируется иерархия и последовательность. Проверяется массив itemListElement, где для каждого дочернего узла обязательно наличие свойства position, передающего порядковый номер элемента в навигационной цепи в виде целого числа.
Механика проверки многоуровневых структур опирается на рекурсивный анализ. Многие свойства Schema.org спроектированы таким образом, что в качестве значения принимают не базовый тип данных, а полноценный вложенный объект. Когда парсер встречает такое свойство, запускается отдельный цикл инспекции для дочерней сущности. Проверяется корректность типа вложенного элемента и правильность заполнения его собственных полей. Такой подход гарантирует, что сложная архитектура вложенности сохраняет семантическую целостность на каждом уровне иерархии.
Анализ статуса парсинга и диагностика синтаксических ошибок
Завершение инспекции машиночитаемого описания формирует отчет, требующий корректной интерпретации. Результат проверки классифицирует обнаруженные проблемы по уровню технической критичности, строго разделяя сбои на уровне чтения исходного кода и несоответствия правилам семантического словаря.
Классификация ошибок разметки
Для успешного применения результатов валидации необходимо разграничивать техническую невозможность прочитать данные и логические нестыковки в самой схеме. Процесс диагностики выделяет два фундаментальных типа проблем.
Критические синтаксические ошибки возникают на этапе первичного чтения формата JSON-LD и блокируют парсинг объекта целиком. Если в коде пропущена запятая между парами ключ-значение, не закрыта фигурная скобка или некорректно экранированы кавычки внутри текстового блока, синтаксический анализатор не может построить дерево данных. В подобных ситуациях исходный код признается невалидным на уровне JSON. Дальнейший структурный анализ соответствия классам Schema.org останавливается, так как извлечь сущности из поврежденного массива невозможно.
Семантические ошибки выявляются на втором этапе, когда код технически валиден и успешно прочитан, но его содержимое нарушает спецификации заявленного типа сущности. Такие дефекты не разрушают общую архитектуру разметки, но делают конкретный узел недействительным. Диагностика семантических несоответствий фиксирует следующие сценарии:
- Отсутствие обязательного свойства, требуемого для конкретного класса.
- Неверный формат данных, когда передается произвольная строка вместо ожидаемого типа, например, нарушение формата ISO 8601 для дат.
- Использование недопустимого свойства, которое не поддерживается текущим типом сущности в рамках словаря.
Локализация проблемных узлов в отчете
Для оперативного исправления разметки возвращаемый отчет содержит прямые указатели на проблемные элементы. Способ локализации зависит от характера обнаруженного сбоя и направлен на точную идентификацию участка, требующего вмешательства.
Интерпретация указателей отчета строится по следующему принципу:
| Тип обнаруженного дефекта | Формат указателя в отчете | Алгоритм исправления разметки |
|---|---|---|
| Синтаксический сбой JSON-LD | Фрагмент исходного кода | Поиск незакрытых скобок, лишних или пропущенных запятых в указанном блоке текста. |
| Семантическое несоответствие | Путь к конкретному property | Добавление недостающего поля, удаление нерелевантного свойства или исправление значения под требуемый тип данных. |
Детализация пути к свойству позволяет найти конкретный узел даже в условиях глубокой многоуровневой вложенности. Точное указание на property внутри иерархии объектов избавляет от необходимости инспектировать весь массив данных, направляя фокус исключительно на тот фрагмент словаря Schema.org, который содержит ошибку.
Связь валидности микроразметки с обработкой поисковыми роботами
Поисковые роботы, включая Googlebot и краулеры Yandex, опираются на машиночитаемый контекст для однозначной интерпретации содержимого веб-страницы. При сканировании HTML-документа алгоритмы извлекают структурированные данные и сверяют их со строгими спецификациями семантического словаря. Подтвержденная валидность схемы выступает базовой технической гарантией того, что парсер поисковой системы сможет корректно обработать иерархию объектов без прерывания процесса из-за фатальных сбоев.
Формирование расширенных результатов
Безошибочное извлечение данных алгоритмами напрямую связано с возможностью рендеринга специальных элементов выдачи. Валидная разметка предоставляет поисковым системам структурированную и надежную базу для создания визуально обогащенных ответов.
Корректно обработанные сущности используются поисковиками для генерации следующих компонентов:
- Rich snippets: вывод дополнительных сведений о товарах, совокупном рейтинге, актуальных ценах, датах мероприятий или кулинарных рецептах непосредственно под ссылкой на страницу.
- Knowledge Graph: интеграция подтвержденной информации об организациях, брендах, персонах и локальных компаниях в блок графа знаний.
- Sitelinks Searchbox: активация функциональной строки поиска по конкретному веб-ресурсу в расширенном навигационном сниппете.
Условия отображения семантических элементов в SERP
Отсутствие синтаксических и структурных ошибок является обязательным техническим условием для показа расширенных результатов. Поисковые системы применяют строгий подход к качеству машиночитаемого кода. Если исходный код содержит невалидный синтаксис, препятствующий чтению объекта, или в заявленном типе сущности отсутствует обязательное свойство, краулер полностью игнорирует проблемный фрагмент разметки, обрабатывая страницу как обычный текстовый документ.
Предварительная верификация кода подтверждает, что внедренные структуры данных соответствуют требованиям поисковых систем. Это исключает риск потери видимости из-за технических недочетов, таких как неверный формат даты или нарушение логики вложенности, и обеспечивает беспрепятственную передачу семантических сигналов в индекс.