Получение структурированных данных из HTML представляет собой прямую техническую операцию по извлечению машиночитаемой семантической разметки из исходного кода веб-страниц. Инструмент анализирует переданный текстовый документ, идентифицирует узлы с микроразметкой и трансформирует их в унифицированный формат. В качестве входных данных выступает сырой исходный код или сформированное DOM-дерево.
На выходе генерируется изолированный массив семантических сущностей.
Алгоритмы сканируют структуру документа для выявления синтаксических конструкций, соответствующих словарям Schema.org. Процесс обработки охватывает распознавание блочного внедрения через JSON-LD, а также парсинг инлайновых форматов Microdata и RDFa. Парсер обходит теги и специфические атрибуты, собирая разрозненные значения. Все найденные свойства, типы и вложенные графы конвертируются в стандартизированный набор пар ключ-значение.
Изоляция полезной нагрузки от визуальной разметки обеспечивает точный технический аудит. Очищенные данные позволяют проверять корректность иерархии сущностей, находить пропущенные обязательные атрибуты и выгружать итоговую структуру в JSON или CSV для последующего анализа.
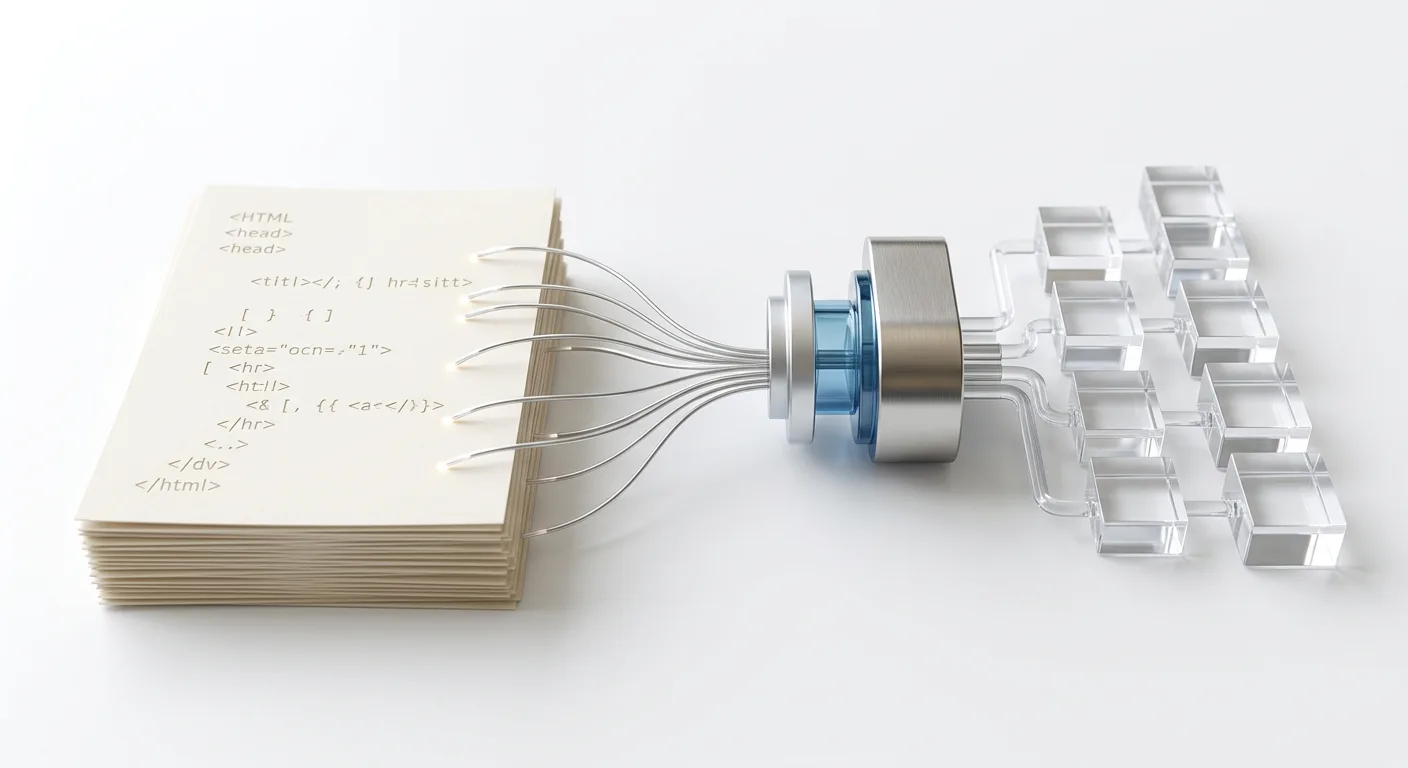
Принцип извлечения семантической разметки из исходного кода
Входными данными для проведения операции выступает сырой HTML или сформированная структура DOM. Исходный текстовый массив представляет собой гетерогенную среду, где семантические узлы интегрированы непосредственно в код, отвечающий за визуальное отображение контента. На начальном этапе машиночитаемая информация неразрывно связана с элементами пользовательского интерфейса, медиафайлами и текстовыми блоками страницы.
Базовая задача сводится к последовательному сканированию переданного документа для выявления целевых синтаксических конструкций. Анализ направлен на точный поиск узлов, соответствующих стандартам Linked Data. В процессе обхода игнорируются элементы, не несущие семантической ценности, фокус сохраняется исключительно на обнаружении маркеров структурированных словарей.
Итоговым результатом применения данного принципа является полная изоляция машиночитаемых данных от рендеринговой разметки. Процесс обеспечивает концептуальное разделение исходного текстового документа на независимые информационные слои:
- Визуальный код, включающий структурные контейнеры макета, элементы типографики и клиентскую логику, который полностью отсекается на этапе фильтрации.
- Изолированный массив семантических данных, представляющий собой чистую выжимку фактологических сведений о сущностях страницы.
Подобное абстрагирование полезной нагрузки от визуальной оболочки исключает влияние ошибок верстки или сложного дизайна на качество получаемой базы. Выделенная информация содержит только структурированные описания, готовые к дальнейшей программной обработке, валидации или экспорту в базы данных.
Синтаксис целевых форматов: JSON-LD, Microdata и RDFa
Для успешного выделения семантического слоя из исходного кода требуется точная идентификация стандартизированных маркеров. Процесс сканирования опирается на выявление специфических синтаксических конструкций, соответствующих трем основным форматам Linked Data: JSON-LD, Microdata и RDFa. Каждый из этих форматов использует собственную модель описания сущностей.
Ключевое различие между форматами заключается в стратегии внедрения машиночитаемой информации в документ. Существуют два подхода: блочный и инлайновый.
- Блочное внедрение обособляет семантическую структуру от визуальной разметки. Данные передаются единым массивом внутри специализированного контейнера, который не участвует в построении DOM-дерева для отображения пользователю.
- Инлайновое внедрение связывает семантические данные напрямую с визуальными HTML-узлами. Формирование машиночитаемых сущностей происходит за счет добавления специальных атрибутов к существующим тегам документа.
Распознавание формата JSON-LD
JSON-LD реализует блочный подход к передаче семантической разметки. Целевым паттерном для поиска выступает HTML-тег
script
. Обязательным условием для идентификации контейнера является наличие атрибута
type
со значением
application/ld+json
.
Содержимое обнаруженного тега представляет собой независимую полезную нагрузку. Извлечение JSON-LD сводится к локализации всех подобных блоков в документе и получению их текстового содержимого. Синтаксис внутри контейнера полностью отделен от HTML-разметки и представляет собой структурированный объект или массив.
Паттерны атрибутов Microdata
Microdata представляет собой классический инлайновый формат. Извлечение данных в этом стандарте требует последовательного обхода узлов HTML-документа для поиска специфических атрибутов расширения. Выявление сущностей и их свойств базируется на следующих целевых паттернах:
-
itemscope- пустой атрибут, указывающий на создание новой области видимости для сущности в рамках текущего тега. -
itemtype- атрибут, содержащий URL-адрес используемого словаря для определения типа описываемой сущности. -
itemprop- атрибут, декларирующий конкретное свойство сущности, значением которого становится текстовое содержимое узла или значение связанного HTML-атрибута.
Синтаксис стандарта RDFa
RDFa также использует инлайновую стратегию интеграции данных, расширяя стандартный синтаксис HTML. Анализ кода для данного формата направлен на поиск набора атрибутов, формирующих связанный семантический граф ресурса. Ключевые маркеры для извлечения включают:
-
vocab- указывает базовый URI словаря, применяемого для описания свойств узла и его потомков. -
typeof- определяет категорию или класс описываемой сущности. -
property- задает свойство сущности, аналогично поведению маркеров свойств в Microdata. -
about- декларирует уникальный идентификатор ресурса, связывая разрозненные метаданные с конкретным объектом.
Для наглядного представления технических маркеров, подлежащих поиску при обработке исходного кода, используется следующая структура соответствий.
| Формат | Тип внедрения | Целевые паттерны поиска |
|---|---|---|
| JSON-LD | Блочное |
Тег
script
, атрибут
type="application/ld+json"
|
| Microdata | Инлайновое |
Атрибуты HTML:
itemscope
,
itemtype
,
itemprop
|
| RDFa | Инлайновое |
Атрибуты HTML:
typeof
,
property
,
vocab
,
about
|
Механика парсинга DOM: Обработка head и body
Процесс извлечения семантических данных требует последовательного обхода структуры DOM-дерева. Логика сканирования разделяется на анализ скрытых метаданных и обработку видимого контента, что обусловлено спецификой размещения различных типов разметки в HTML-документе.
Анализ секции head
Секция
head
преимущественно используется для размещения глобальных семантических узлов, не привязанных к конкретным визуальным элементам страницы. Парсинг этой области направлен на сканирование структуры документа для выявления блоков
script
, содержащих графы данных.
Типичные декларации, изолируемые на этапе обработки заголовка документа, описывают общую информацию о ресурсе. К ключевым объектам относятся:
-
Organization- базовые данные о компании, включая корпоративные логотипы, контактную информацию и связи с профилями в социальных сетях. -
WebSite- техническое описание параметров сайта, часто применяемое для внедрения функционала внутреннего поиска через действие SearchAction.
Обход секции body и сбор контентных сущностей
В отличие от глобальных деклараций, секция
body
содержит разметку, непосредственно интегрированную в отображаемый контент. Механика анализа этой области включает как обнаружение локальных скрипт-блоков, так и поузловой обход HTML-элементов для сбора инлайновых форматов.
На данном этапе собираются сущности, детализирующие специфику конкретного URL. В процессе сканирования узлов извлекаются следующие типы данных:
-
Article- параметры текстового контента, включая информацию об авторе, дате публикации и модификации материала. -
Product- коммерческие спецификации товара, формирующие предложения, актуальные цены и статусы наличия. -
Review- агрегированные пользовательские оценки и детализированные отзывы. -
BreadcrumbList- навигационные элементы, отражающие иерархию текущей страницы в архитектуре сайта.
Извлечение значений из служебных атрибутов
При обработке инлайновых стратегий внедрения логика парсинга не ограничивается чтением текстового содержимого HTML-узлов. Значительная часть валидных семантических данных передается через невидимые для пользователя атрибуты тегов. Это необходимо для обеспечения точных машиночитаемых форматов, независимых от визуального представления на странице.
Обход DOM-дерева включает обязательный сбор значений из специфических атрибутов, если они используются в связке с маркерами семантической разметки. Целевые параметры поиска распределяются следующим образом.
| Атрибут HTML | Связанные теги | Тип извлекаемых данных |
|---|---|---|
content
|
meta
,
span
,
div
|
Точные числовые значения, даты в формате ISO 8601, коды валют. |
href
|
a
,
link
|
Абсолютные URL-адреса страниц, идентификаторы профилей или связи с внешними ресурсами. |
src
|
img
,
iframe
,
audio
|
Прямые пути к медиафайлам, графическим ресурсам и встраиваемому контенту. |
Сканирование этих атрибутов гарантирует, что система получает сырые нормализованные данные, подготовленные вебмастером специально для поисковых роботов, минуя потенциальные ошибки интерпретации отформатированного видимого текста.
Структурирование извлеченных данных: Сущности и свойства
После завершения обхода DOM-дерева и сбора значений из текстовых узлов и атрибутов разрозненные фрагменты формируют единую информационную модель. Независимо от исходного синтаксиса внедрения, итоговый результат представляет собой стандартизированную иерархическую структуру, состоящую из корневых сущностей и вложенных свойств.
Основой структурированного представления выступают базовые декларации, определяющие контекст и природу найденных данных. Иерархия выстраивается вокруг двух ключевых параметров.
-
@contextзадает глобальное пространство имен и словарь терминов. Для семантической разметки веб-страниц значением выступает URI стандарта Schema.org, указывающий парсерам на правила интерпретации последующих полей. -
@typeопределяет конкретный класс извлекаемой сущности, классифицируя блок данных. Значение классификатора задает схему ожидаемых свойств для описываемого объекта.
Внутри корневой декларации располагаются предметные данные, организованные в виде набора пар ключ-значение. Сложные семантические модели страниц редко ограничиваются плоской структурой и требуют обработки многоуровневых связей. Получение вложенных свойств реализуется через следующие структурные элементы.
- Атрибутивные свойства передают конечные текстовые, числовые или логические значения.
- Вложенные сущности формируют объекты внутри объектов, передавая сложные характеристики.
-
Идентификаторы
@idобеспечивают связывание различных узлов данных. Использование уникальных URI позволяет ссылаться на одну и ту же сущность из разных частей документа, исключая логическое дублирование. -
Массивы
@graphгруппируют независимые корневые сущности верхнего уровня в единый логический блок, устраняя необходимость дублирования деклараций глобального контекста.
Особую роль процесс структурирования играет при обработке форматов Microdata и RDFa. В отличие от скриптов JSON-LD, где данные уже представлены сформированным блочным объектом, инлайновые форматы распределяют свойства одной сущности по множеству различных HTML-тегов на разных уровнях вложенности разметки страницы.
Консолидация разрозненных узлов требует точного преобразования визуальной иерархии документа в абстрактную модель. Механизм извлечения сопоставляет каждый найденный целевой атрибут с ближайшим родительским контейнером, объявляющим область действия и тип сущности. Результатом сборки становится унифицированный словарь, где физическое расположение тегов конвертируется в строгую последовательность ключей и значений.
| Исходное состояние в DOM | Процесс консолидации | Итоговая структура данных |
|---|---|---|
| Атрибут области действия типа сущности | Инициализация нового объекта | Корневой узел с декларацией типа |
| Вложенные теги с предметными атрибутами | Привязка значений к текущему контексту | Свойства первого уровня вложенности |
| Теги с атрибутами связи объектов | Объединение независимых контейнеров | Вложенная сущность или ссылка по идентификатору |
Трансформация исходного HTML-кода в стандартизированный набор пар ключ-значение изолирует машиночитаемую информацию от особенностей рендеринга. Полученная иерархическая модель в точности отражает семантический профиль страницы, готовый к дальнейшей валидации и логическому анализу.
Практическое применение извлеченной разметки в семантическом SEO
Изолированный от визуальной разметки массив данных применяется для решения аналитических задач поисковой оптимизации. Работа с чистым payload-объектом позволяет исключить влияние клиентского рендеринга и сосредоточиться исключительно на семантической ценности документа, которую обрабатывают поисковые системы.
Полученная иерархическая модель используется в следующих сценариях семантического анализа:
- Аудит структуры разметки конкурентов. Анализ консолидированного словаря демонстрирует точные типы внедренных сущностей и логику их связей. Это обеспечивает выявление успешных паттернов микроразметки в нише и адаптацию собственной стратегии под выявленные стандарты графа данных.
- Проверка наличия обязательных свойств для формирования Rich Snippets. Построение расширенных результатов поиска в выдаче требует жесткого соответствия спецификациям поисковых систем. Итоговая структура данных служит базой для сверки атрибутов на предмет отсутствия критических ключей, блокирующих генерацию сниппета.
- Экспорт payload-данных для последующей отладки. Извлеченный код полностью отделен от HTML-документа, что делает его оптимальным форматом для тестирования. Передача чистых данных напрямую в Schema Markup Validator или Rich Results Test нивелирует вероятность сбоев из-за таймаутов, проблем маршрутизации или некорректной обработки скриптов официальными сканерами.
Оценка соответствия требованиям Google Knowledge Graph
Интеграция информации в Google Knowledge Graph требует строгой однозначности и связанности машиночитаемых сигналов. Извлеченные данные выполняют определяющую роль в аудите пригодности страницы для включения в граф знаний. Унифицированный словарь наглядно показывает, собираются ли независимые элементы документа в единый смысловой узел, способный идентифицировать конкретную организацию, персону или место.
Анализ чистого результата извлечения позволяет валидировать корректность конфигурации глобальных идентификаторов. При рассмотрении абстрактной модели оценивается присутствие и точность заполнения свойств, указывающих на внешние авторитетные источники. Наличие этих связей в итоговом массиве подтверждает, что поисковый робот способен без искажений сопоставить контент страницы с уже существующими объектами в базе данных поисковой системы.