Онлайн-инструмент позволяет определить значение штрихкода из загруженного изображения и мгновенно преобразовать графический код в пригодную для работы строку символов. Программный декодер анализирует переданную картинку, находит на ней машиночитаемую символику и считывает зашифрованную последовательность без подключения физического ручного или стационарного сканера. В качестве входных данных используется фотография этикетки, скриншот экрана или готовый макет в виде графического файла. На выходе формируется точный текстовый, цифровой или байтовый результат, готовый к копированию в учетную систему, таблицу или документ.
Аппаратный считыватель не всегда доступен при работе с электронными накладными, каталогами поставщиков или архивами фотографий со склада. В таких условиях программная обработка файла заменяет оптическое сканирование лазерным или фотоэлементом.
Алгоритм считывает чередование темных штрихов и светлых пробелов в линейных кодах либо конфигурацию модулей в двумерных матрицах напрямую из пиксельной сетки загруженной картинки. После геометрического выравнивания и распознавания стандарта кодирования система переводит графические элементы в символы согласно таблицам спецификаций. Встроенная проверка контрольных разрядов исключает выдачу искаженных строк при чтении размытых или частично поврежденных участков этикетки. Пользователь получает чистые данные, которые полностью идентичны результату сканирования физического носителя на кассе или терминале сбора данных.
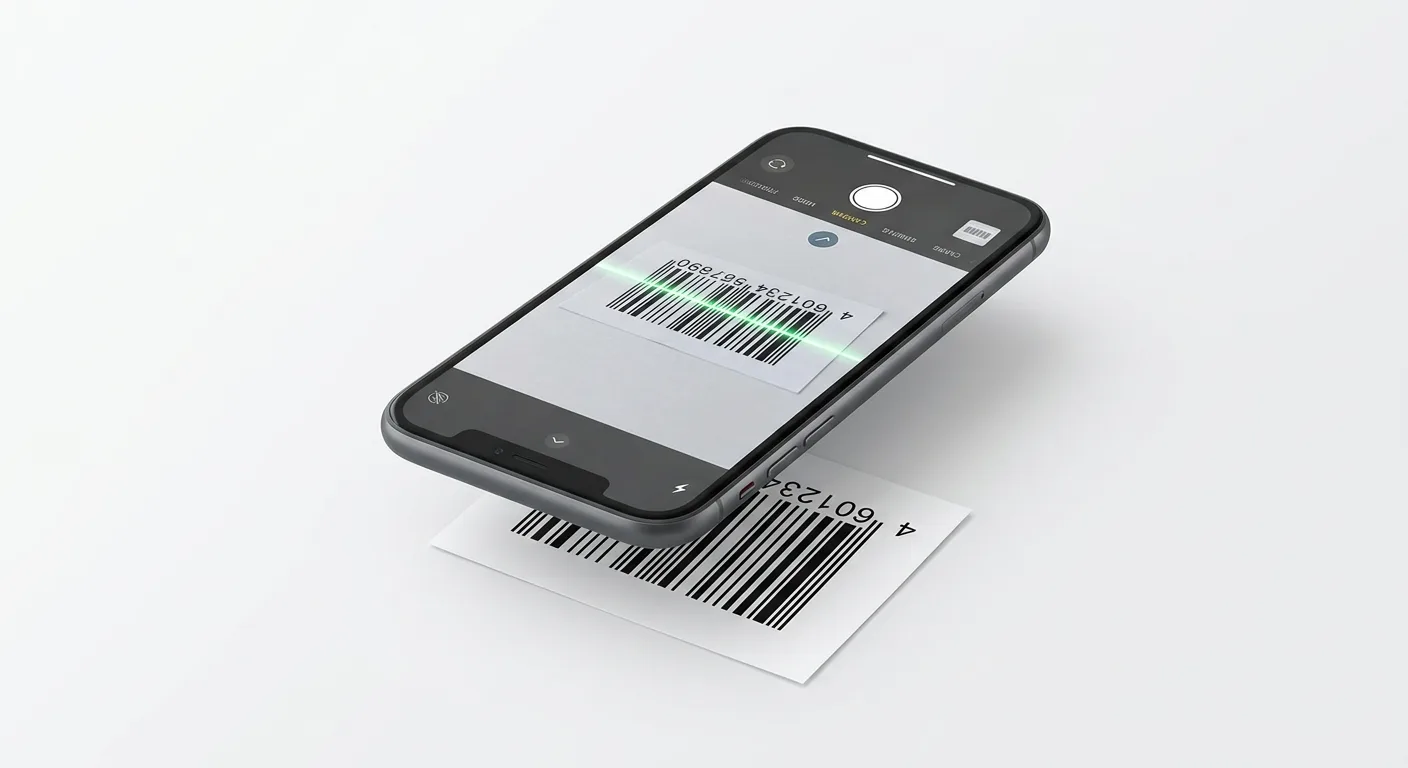
Принцип оптического распознавания и декодирования штрихкодов по изображению
Процесс извлечения информации из графического файла опирается на математический анализ растровой сетки. В отличие от лазерного считывателя, который фиксирует отраженный свет от физической поверхности, программное декодирование работает с массивом пикселей разной яркости. Задача сводится к переводу визуальных перепадов тона в двоичный код с последующей сверкой по таблицам стандартов символики.
Локализация области кода и анализ контрастности
Первичный этап обработки изображения заключается в поиске самой зоны маркировки среди окружающего фона, текста, логотипов или элементов упаковки. На растровой картинке область штрихкода выделяется высокой частотой чередования светлых и темных участков в определенном направлении. При анализе пиксельной карты вычисляются градиенты яркости: резкие перепады значений между соседними пикселями указывают на границы штрихов или ячеек матрицы.
Для точного отделения элементов кода от подложки применяется бинаризация - приведение полутонового или цветного изображения к черно-белому виду. Порог разделения рассчитывается локально для разных участков картинки, чтобы компенсировать неравномерное освещение при съемке. Пиксели со значением яркости ниже порогового принимаются за логическую единицу (темный элемент), а выше порогового - за логический ноль (светлый элемент).
Ключевую роль при определении границ играет обнаружение свободной зоны, называемой зоной молчания. Это чистый светлый участок вокруг графического символа, не содержащий посторонних графических элементов. Фиксация зоны молчания позволяет отсечь фоновый шум и точно определить точку отсчета, где начинается стартовый паттерн символики, и точку завершения за стоповым паттерном.
Механика декодирования линейных и матричных символик
После выделения границ и определения ориентации в пространстве логика считывания разделяется в зависимости от геометрии кода. Одномерные и двумерные стандарты используют разные принципы пространственного кодирования информации.
Этапы преобразования графических элементов в цифровую последовательность различаются по способу измерения базовых единиц кода:
- Прокладка секущих линий для линейных кодов. Через локализованную область проводятся виртуальные линии сканирования перпендикулярно штрихам. Вдоль линии замеряется протяженность каждого темного штриха и светлого пробела в пикселях.
- Вычисление базового модуля в одномерной символике. Абсолютная ширина в пикселях зависит от масштаба фотографии, поэтому для декодирования используется относительная величина. На основе стартовых служебных знаков определяется ширина самого узкого элемента (базового модуля). Ширина всех остальных штрихов и пробелов делится на этот показатель, что дает целочисленные пропорции (например, отношение 1:2:3:4). Полученные комбинаций пропорций сопоставляются со справочной таблицей конкретного стандарта и переводятся в символы.
- Поиск ориентирующих паттернов в матричных кодах. Двумерные коды требуют предварительной привязки к системе координат. Поиск опирается на характерные геометрические фигуры: концентрические квадраты по углам в QR-кодах, сплошную Г-образную границу в Data Matrix или центральную мишень в Aztec. Эти элементы задают угол поворота, масштаб и степень наклона плоскости.
- Построение координатной сетки и опрос ячеек. Между направляющими элементами выстраивается равномерная матричная сетка. Каждая ячейка сетки соответствует одному модулю данных. Алгоритм проверяет цвет центрального пикселя внутри каждой ячейки, формируя битовый поток из нулей и единиц, который затем разбивается на кодовые слова (байты данных).
| Параметр обработки | Линейные (одномерные) коды | Матричные (двумерные) коды |
|---|---|---|
| Носитель информации | Соотношение ширины темных штрихов и светлых пробелов по горизонтали | Позиция и цвет отдельных квадратных или точечных модулей по вертикали и горизонтали |
| Опорные элементы для локализации | Зона молчания, стартовые и стоповые комбинации штрихов | Поисковые квадраты, направляющие линии синхронизации, выравнивающие узоры |
| Метод считывания данных | Измерение линейных пропорций вдоль одной или нескольких прямых линий | Наложение двумерной сетки координат и побитовый опрос центров ячеек |
| Защита от искажений при чтении | Контрольное число (проверка целостности без восстановления) | Избыточные данные с применением кода Рида - Соломона (поиск и исправление ошибок) |
Математическая проверка целостности и коррекция ошибок
Оптическое считывание с изображения часто осложняется артефактами сжатия файла, царапинами на самой этикетке или дефектами печати. Чтобы исключить выдачу неверного значения из-за случайно слипшихся или прерванных штрихов, на финальном этапе декодирования задействуются механизмы математической верификации.
В линейных штрихкодах применяется проверка через контрольное число, которое располагается в самом конце закодированной строки. Наиболее распространен расчет по модулю 10. Принцип проверки строится на пошаговой формуле:
- Суммируются все цифры, стоящие на четных позициях, и полученный результат умножается на весовой коэффициент (обычно на 3).
- К полученному произведению прибавляется сумма всех цифр, стоящих на нечетных позициях (за исключением самого последнего контрольного разряда).
- Вычисляется остаток от деления итоговой суммы на 10. Если остаток не равен нулю, он вычитается из 10.
- Рассчитанное значение сравнивается с последней цифрой считанного штрихкода. Если числа совпадают, распознавание признается достоверным; при расхождении результат отбраковывается как ошибочный.
Контрольный разряд позволяет обнаружить ошибку, но не дает возможности восстановить поврежденный участок, если линия сканирования прошла через пятно или потертость. Поэтому в линейных кодах при дефектах одного участка считывание повторяется по другой высоте штрихов.
В матричных символиках защита реализована иначе: вместо простой проверки используется математическая коррекция ошибок на базе кода Рида - Соломона. Еще на этапе создания штрихкода к исходным данным добавляются избыточные проверочные байты, сформированные с помощью полиномиальной арифметики над конечными полями. При декодировании поврежденного или зашумленного изображения считанные кодовые слова подставляются в систему уравнений синдромов ошибок.
Если часть модулей на картинке оказалась засвечена бликом, перекрыта посторонним предметом или размыта, ненулевые синдромы указывают на наличие искажений. Вычисление полинома локаторов ошибок позволяет найти точные позиции поврежденных байтов в матрице, а полином величин ошибок восстанавливает их исходные битовые значения. За счет этой избыточности двумерный код успешно декодируется в точную текстовую или байтовую строку даже при полной потере части графической площади символа.
Требования к качеству загружаемой картинки для точного считывания
Математические методы восстановления данных компенсируют локальные повреждения символики, однако базовым условием для успешного декодирования остаются физические и графические характеристики самого исходного файла. Когда на картинке нарушена геометрия элементов или размыты переходы яркости, определить точные пропорции штрихов и координаты ячеек становится невозможно даже при наличии проверочных байтов.
Разрешение файла и плотность пикселей на модуль
В основе любого штрихкода лежит минимальный неделимый элемент - модуль. Для линейной символики это ширина самого узкого штриха или пробела, а для матричной - размер одной квадратной или точечной ячейки. Общее разрешение загружаемой фотографии или скриншота не гарантирует читаемость само по себе: решающее значение имеет плотность пикселей, приходящихся именно на один модуль кода.
Если штрихкод занимает на крупном снимке слишком малую площадь, на один его элемент может приходиться всего один-два пикселя. При таком масштабе возникает эффект ступенчатости и усреднения цвета на границах: соседние темные и светлые участки сливаются в промежуточные серые полутона. В результате в линейных символиках искажается соотношение ширин элементов, а в матричных смещается координатная сетка. Исключить подобные ошибки оцифровки помогает достаточная детализация области кода, когда каждый отдельный модуль представлен на изображении группой из нескольких четких пикселей без следов агрессивного сжатия.
Резкость границ, контрастность и цветовое сочетание
Точность разделения графики на значимые элементы и подложку напрямую зависит от перепада яркости между ними. Классическим эталоном считается сочетание матовых черных штрихов на белом фоне. При анализе полутонового изображения вычисляется пороговый уровень яркости: все пиксели темнее порога принимаются за единицы, а светлее - за нули.
Снижение контрастности или размытие границ нарушает этот процесс. Ниже перечислены основные оптические и цветовые факторы, препятствующие корректному выделению элементов на снимке:
- Расфокусировка и смазывание при съемке с рук размывают четкий край штриха в широкий градиентный переход. Из-за этого вычисленная ширина темной полосы оказывается больше или меньше реальной, что приводит к сбою декодирования.
- Низкий контраст между выцветшими чернилами и пожелтевшей, серой или бурой картонной основой сближает яркостные характеристики кода и фона, мешая отделить полезный сигнал от текстурного шума бумаги.
- Инверсные схемы, где светлый код нанесен на темную поверхность, или нестандартные цветовые сочетания (например, красные или желтые элементы на белом фоне) снижают читаемость при переводе цветного снимка в оттенки серого, так как светлые тона сливаются с подложкой.
- Неравномерное освещение, когда одна половина этикетки находится в глубокой тени, а вторая под прямым источником света, создает перепад яркости по площади кадра и затрудняет выбор единого порога разделения тонов.
Геометрические искажения, блики и физические перекрытия
При фотографировании этикеток на реальных товарах, коробках или документах возникают пространственные и оптические помехи. В отличие от цифровых макетов и прямых скриншотов, снимки с камеры часто содержат деформации плоскости и посторонние артефакты.
В таблице сопоставлены распространенные дефекты фотографий и их влияние на считывание структуры разных типов кодов:
| Характер дефекта на изображении | Как проявляется при обработке | Последствия для распознавания |
|---|---|---|
| Сильные перспективные искажения | Съемка под острым углом меняет масштаб: ближняя к объективу часть кода выглядит крупнее дальней, параллельные линии сходятся | Нарушается пропорциональность ширин штрихов в одномерных кодах и деформируется шаг координатной сетки в двумерных матрицах |
| Кривизна поверхности носителя | Нанесение этикетки на цилиндрическую банку, бутылку или мятую мягкую упаковку сжимает элементы по краям изгиба | Крайние штрихи или столбцы модулей визуально сужаются, что искажает расчетные интервалы при линейном и матричном чтении |
| Зеркальные блики и засветы | Отражение вспышки или лампы от глянцевой пленки, ламинации или термоэтикетки создает на коде сплошное белое пятно | Темные модули внутри засвеченной зоны воспринимаются как светлый фон; если площадь блика превышает запас избыточности, чтение блокируется |
| Механические перекрытия и дефекты | Скотч с оптическими искажениями, скобы степлера, поверх наклеенные стикеры, грязь, потертости или непропечатанные полосы | Утрачивается часть графических данных; в линейных кодах требуется хотя бы одна чистая сквозная линия по высоте, в матричных - сохранность поисковых фигур |
Сохранность стартовых паттернов и чистой зоны молчания
Даже при высокой резкости и контрастности штрихкод не будет считан, если на изображении обрезаны или зашумлены его края. Вокруг любой машиночитаемой символики предусмотрено обязательное свободное поле - чистая зона молчания. Для линейных кодов это светлые отступы слева и справа от крайних штрихов, а для матричных - светлая рамка по всему периметру квадрата или прямоугольника.
Чистая зона молчания необходима для однозначного отделения самого кода от окружающего текста, рамок таблицы, элементов дизайна упаковки или края фотографии. Именно за счет этого пустого пространства безошибочно фиксируются стартовые и стоповые паттерны в одномерных символиках или поисковые фигуры (уголки и сплошная L-образная граница) в двумерных кодах. Эти служебные элементы задают точку отсчета, направление чтения и шаг модульной сетки.
Когда пользователь кадрирует скриншот или фотографию вплотную к черным штрихам, не оставляя светлого поля по краям, граничные элементы сливаются с пределами самого графического файла. Аналогичная проблема возникает, если при печати этикетки в свободную зону попала буква из названия товара, линия разметки или штемпельная краска. Посторонний объект в этой области воспринимается как дополнительный ложный штрих, из-за чего стартовая последовательность не распознается и декодирование не запускается.
Классификация линейных (1D) штрихкодов и структура их значений
Линейные, или одномерные (1D), штрихкоды кодируют информацию только в одном направлении - по горизонтали, с помощью чередования вертикальных полос и промежутков разной толщины. При успешном декодировании такой символики с изображения итоговым результатом всегда является короткая символьная строка. Состав этой строки, допустимый набор знаков и количество разрядов жестко задаются стандартом конкретного штрихкода, нанесенного на упаковку, этикетку или бланк.
Товарные коды розничной торговли
Маркировка потребительских товаров, проходящих через кассовые узлы магазинов, строится на стандартизированных семействах EAN и UPC. Эти символики кодируют исключительно цифры (от 0 до 9) и имеют строго фиксированную длину: при считывании с картинки всегда возвращается заранее известное количество числовых знаков без букв, пробелов или спецсимволов.
Вся числовая последовательность внутри розничного штрихкода подчиняется единой регистрационной логике. В развернутых форматах она объединяет префикс GS1, код производителя, код товара и замыкающую контрольную цифру. Если на фотографии запечатлен неповрежденный товарный код, на выходе получается сплошной цифровой идентификатор, соответствующий одному из четырех основных форматов:
- EAN-13 - базовый международный стандарт, возвращающий при декодировании ровно 13 цифр. Графически штрихи разделены удлиненными краевыми и центральными ограничителями на две равные части, при этом первая цифра вынесена за пределы левой границы, но считывается в общую строку за счет структуры четности левой группы знаков.
- EAN-8 - укороченная 8-значная версия, предназначенная для малогабаритной упаковки, на которой физически не помещается полноразмерный символ. Включает префикс, короткий номер товарной позиции и проверочный разряд.
- UPC-A - традиционный для североамериканского рынка формат из 12 цифр. По своему назначению и структуре полностью аналогичен 13-разрядному европейскому стандарту, но не имеет ведущего нулевого разряда в начале строки.
- UPC-E - сжатая модификация на 6 знаков (с системным и контрольным разрядами - до 8 цифр), получаемая путем алгоритмического подавления нулей из полного 12-значного номера для экономии места на мелких изделиях.
Логистические и индустриальные коды высокой плотности
В складском учете, производстве, почтовых отправлениях и документообороте цифровых кодов фиксированной длины недостаточно. Здесь применяются одномерные символики переменной длины, способные кодировать произвольное количество знаков (ограниченное лишь физическими габаритами этикетки) и включать в себя латинские буквы, цифры и служебные знаки.
В зависимости от выбранного индустриального стандарта при распознавании изображения извлекаются строки разной информационной емкости:
| Стандарт символики | Кодируемый набор символов | Длина возвращаемого значения | Особенности структуры и применение |
|---|---|---|---|
| Code 128 | Полный набор из 128 символов ASCII (цифры, строчные и прописные латинские буквы, знаки пунктуации, управляющие коды) | Переменная | Имеет три внутренних подмножества (A, B, C). Подмножество C уплотняет запись, кодируя пары цифр одним знаком, что уменьшает ширину штрихкода на картинке |
| GS1-128 | Символы ASCII на базе архитектуры Code 128 со служебным признаком стандарта | Переменная | Используется в логистике для передачи составных сведений о грузе или паллете в рамках одной строки |
| Code 39 | 43 знака: цифры (0-9), заглавные буквы английского алфавита (A-Z), пробел и символы - . $ / + % | Переменная | Крайние символы в графическом коде всегда представлены знаком звездочки, который служит маркером старта и стопа. В режиме Extended Code 39 через парные комбинации кодируется весь спектр ASCII |
| Code 93 | Расширенный буквенно-цифровой набор (включая полный ASCII в расширенной версии) | Переменная | Компактная и плотная альтернатива стандарту Code 39, защищенная двумя скрытыми контрольными символами в конце последовательности |
Коды на основе чередования для транспортной тары
Отдельную группу составляют числовые коды семейства Interleaved 2 of 5 (сокращенно ITF). Их конструктивная особенность заключается в непрерывном парном кодировании: первая цифра пары записывается в ширине пяти черных штрихов, а вторая цифра - в ширине пяти белых пробелов, расположенных между этими штрихами. Из-за такого принципа взаимного чередования любой код типа ITF при считывании с фотографии всегда содержит строго четное количество цифр. Если исходный идентификатор имел нечетное число разрядов, перед генерацией штрихкода в его начало добавляется незначащий ноль.
На базе этой технологии построен стандарт ITF-14, предназначенный для маркировки гофрокоробов, ящиков и транспортных упаковок. Он всегда состоит ровно из 14 цифр. Визуально на изображении такой штрихкод часто окружен толстой черной прямоугольной рамкой (опорными линиями), которая нужна для выравнивания давления печатного клише при нанесении рисунка на грубый картон. При оптическом распознавании со снимка эта рамка не должна сливаться с крайними штрихами, чтобы не нарушать отступы по бокам.
Специализированные и отраслевые стандарты
Помимо универсальных торговых и складских систем, на изображениях встречаются узкопрофильные линейные символики, разработанные под специфические технические процессы. Они отличаются нестандартным алфавитом или особой геометрией элементов.
Стандарт Codabar применяется на станциях переливания крови, в библиотечном учете, фотолабораториях и курьерских службах. Он способен передавать цифры от 0 до 9, шесть специальных знаков (- $ : / . +), а также четыре заглавные буквы (A, B, C, D), которые используются исключительно в качестве стартовых и стоповых символов в начале и в конце строки.
Символика MSI (модифицированный код Plessey) содержит только цифры и служит для маркировки стеллажей и полок в торговых залах при инвентаризации. В свою очередь, фармацевтический стандарт Pharmacode, наносимый на упаковки лекарственных средств для контроля на фасовочных линиях, устроен по двоичному принципу: он читается справа налево и кодирует одно целое число в диапазоне от 3 до 131070 только за счет комбинации узких и широких штрихов, тогда как расстояние между полосами информации не несет.
Особенности двумерных (2D), матричных и композитных символик
В отличие от линейных кодов, распределяющих данные вдоль одной горизонтальной оси, двумерные символики записывают информацию одновременно по горизонтали и по вертикали. Переход к двухкоординатной плоскости кардинально меняет информационную емкость и назначение графической метки. Если одномерный код обычно несет в себе короткий ключ для поиска записи во внешней базе данных, то двумерный способен содержать полный автономный пакет сведений прямо внутри рисунка.
При декодировании с изображения из 2D-кодов извлекаются не только короткие цифровые артикулы, но и объемные текстовые блоки в кодировках ASCII или UTF-8 (включая кириллицу и иероглифы), необработанные бинарные (байтовые) массивы, а также составные идентификаторы со служебными разделителями для автоматизированных систем учета.
Матричные коды и их поисковые паттерны
Матричные символики строятся на основе полигональной (чаще всего квадратной или прямоугольной) сетки из темных и светлых модулей. Чтобы при оптическом распознавании со снимка можно было точно определить ориентацию матрицы в пространстве, ее угол наклона, масштаб и шаг сетки, каждый стандарт использует уникальные графические ориентиры - паттерны поиска и синхронизации.
Наиболее распространенные виды матричных кодов отличаются геометрией ключевых зон и сферой применения:
- QR-код и Micro QR. Классический QR-код легко узнать по трем крупным квадратным поисковым меткам по углам матрицы (кроме правого нижнего), которые позволяют считывать картинку при любом повороте на 360 градусов. Его компактная модификация Micro QR содержит только один угловой квадрат и предназначена для размещения на мелких деталях, печатных платах и узких кромках с ограниченным объемом передаваемых данных.
- Data Matrix и GS1 Data Matrix. Внешними границами этого кода служат две примыкающие друг к другу сплошные темные линии в форме латинской буквы L (направляющий паттерн), а две противоположные стороны образованы чередующимися темными и светлыми модулями (пунктирный паттерн синхронизации для подсчета размерности сетки). Модификация GS1 Data Matrix визуально идентична базовому стандарту, но на логическом уровне имеет строгий регламент записи составных товарных и учетных атрибутов, разделенных спецсимволами.
- Aztec. Поисковый элемент расположен ровно в геометрическом центре кода и представляет собой вложенные друг в друга квадратные контуры. Поскольку вокруг центральной мишени данные наращиваются слоями, стандарту Aztec не требуется свободная светлая зона по внешнему периметру изображения, что экономит место при верстке электронных билетов и посадочных талонов.
- MaxiCode. Специализированная матрица фиксированного размера, состоящая из смещенных рядов шестиугольных (гексагональных) ячеек вокруг круглой центральной мишени из трех концентрических колец. Применяется в высокоскоростной конвейерной сортировке почтовых и курьерских отправлений для кодирования маршрутных индексов и адресов.
- DotCode. Матрица формируется из отдельных несоприкасающихся круглых точек, расположенных в узлах диагональной сетки. Такая структура разработана для промышленных каплеструйных и лазерных маркираторов, наносящих коды бесконтактным способом на высокой скорости (например, при производстве табачной или фармацевтической продукции).
Стековые, многострочные и композитные символики
Промежуточное положение между линейными и полноценными матричными системами занимают стековые (многострочные) и композитные коды. Они конструируются путем вертикального наложения нескольких узких одномерных строк друг на друга или объединения разных типов графики в единый символ.
Стандарт PDF417 представляет собой многострочный стек, где каждый горизонтальный срез является самостоятельным набором штрихов и пробелов со своими стартовыми и стоповыми полосами по бокам. При распознавании с файла такие коды возвращают большие массивы текста или бинарных данных: они часто наносятся на оборотную сторону водительских удостоверений, удостоверений личности, транспортных деклараций и квитанций. Его облегченная версия MicroPDF417 обходится без массивных краевых ограничителей, заменяя их внутренними индикаторами рядов для экономии площади этикетки.
Семейство стандартов GS1 DataBar объединяет компактные линейные, стековые и композитные форм-факторы. В отличие от классических розничных штрихкодов, расширенные и многострочные варианты GS1 DataBar способны поместить на крошечной наклейке (например, на весовом товаре, свежих продуктах, ювелирных изделиях или косметике) не только основной товарный код, но и дополнительные динамические параметры: точный вес нетто, дату фасовки, цену или номер партии. В композитных модификациях нижняя часть символа выглядит как линейный ряд штрихов, а непосредственно над ним печатается двумерный микрокомпонент (на базе MicroPDF417), причем при декодировании обе графические зоны считываются и объединяются в единую результирующую строку.
Форматы и структура извлекаемых данных
Высокая плотность записи двумерных символик позволяет хранить в них готовые к использованию прикладные структуры. В зависимости от того, для какой задачи генерировался код на исходной картинке, результатом его расшифровки становится либо плоский текст, либо размеченный по определенному протоколу блок данных.
Типовые форматы данных, получаемые после декодирования двумерных и стековых кодов, различаются по синтаксису и назначению:
| Тип закодированного содержимого | Структура строкового значения на выходе | Основные символики |
|---|---|---|
| Произвольный текст (UTF-8 / ASCII) | Обычная текстовая строка с поддержкой многоязычных символов, знаков препинания и переносов строк | QR-код, Data Matrix, Aztec, PDF417 |
| Сетевые адреса и URI-схемы |
Строка с префиксом протокола (например,
https://...
,
mailto:...
,
tel:...
), определяющим целевое действие
|
QR-код, Micro QR, Data Matrix |
| Контактные карточки (vCard / MeCard) |
Многострочный блок с тегами
BEGIN:VCARD
...
END:VCARD
или компактная запись вида
MECARD:N:Имя;TEL:...;;
|
QR-код, PDF417 |
| Параметры подключения Wi-Fi |
Форматированная строка вида
WIFI:S:ИмяСети;T:WPA;P:Пароль;H:false;;
|
QR-код |
| Составные учетные идентификаторы | Последовательность полей фиксированной и переменной длины с префиксами и непечатаемыми разделителями | GS1 Data Matrix, GS1 DataBar, DotCode |
| Бинарные (байтовые) массивы | Последовательность сырых байтов, хэш-сумм, зашифрованных блоков или строк в кодировке Base64 | PDF417, Aztec, Data Matrix, QR-код |
Если в матричный код заложена структурированная карточка контакта, географические координаты, событие календаря или конфигурация беспроводной сети, при извлечении значения из графического файла пользователь видит исходную текстовую разметку этого шаблона со всеми служебными ключами и точками с запятой. Это дает возможность скопировать нужный фрагмент - например, вычленить пароль от сети Wi-Fi между маркерами
P:
и
;
или забрать номер телефона из блока
TEL:
- без выполнения автоматических действий на устройстве.
Интерпретация и расшифровка полученного значения штрихкода
Результат декодирования штрихкода с изображения представляет собой необработанную строку символов, которая в большинстве коммерческих и логистических стандартов подчиняется строгой позиционной или префиксной разметке. Чтобы извлечь из полученной последовательности конкретные учетные параметры - код товара, номер партии, дату производства или криптографическую подпись, - необходимо сопоставить разряды строки со спецификацией соответствующей символики.
Позиционная структура GTIN в кодах розничной торговли
При распознавании линейных символик EAN-13, EAN-8, UPC-A или транспортного ITF-14 результатом выступает цифровая строка длиной 8, 12, 13 или 14 символов, формирующая номер GTIN. В учетных базах все эти форматы часто приводятся к единому 14-значному виду путем дополнения ведущими нулями слева. Каждая группа цифр внутри считанного номера занимает фиксированную позицию и несет определенную справочную нагрузку.
На примере стандартного 13-разрядного результата вида
4601234567893
позиционная расшифровка выполняется следующим образом:
-
Первые три цифры (
460) представляют собой префикс национальной организации GS1, в которой зарегистрировано предприятие. Этот диапазон указывает на юрисдикцию держателя бренда, но не гарантирует физическое место производства самого товара. Внутренние коды для весового товара и локального учета внутри магазина начинаются с префиксов из диапазона200-299. -
Следующие от 4 до 6 цифр (
123456) образуют регистрационный номер предприятия, присвоенный производителю или импортеру. -
Последующая группа разрядов (
789) содержит порядковый номер или артикул конкретной товарной позиции, который производитель назначает самостоятельно в рамках выделенной ему емкости номеров. -
Последняя цифра (
3) всегда является контрольным разрядом, подтверждающим отсутствие ошибок при чтении предшествующих цифр.
Если из изображения извлечен 14-значный номер (например, из кода ITF-14 или из блока данных внутри составного кода), первая цифра перед префиксом GS1 играет роль индикатора логистической упаковки. Значение от
1
до
8
указывает на тип групповой тары (короб, блок, паллета), цифра
9
обозначает товар переменного веса, а
0
указывает на то, что код соответствует единичной потребительской упаковке.
Идентификаторы применения AI и разделитель FNC1 в стандартах GS1
Сложные учетные строки, получаемые при декодировании линейных кодов GS1-128 и матричных GS1 Data Matrix, строятся по принципу конкатенации нескольких информационных полей. Перед каждым значением в такой строке размещается числовой префикс длиной от 2 до 4 цифр - идентификатор применения AI. Он сообщает учетной системе, какие именно данные следуют за ним и какую длину они имеют.
На печатных этикетках префиксы AI для удобства чтения человеком выделяются круглыми скобками, например:
(01)04601234567893(17)261231(10)A45B
. При программном извлечении значения из графического файла круглые скобки в результирующей строке отсутствуют, так как в сам штрихкод они не кодируются. Вместо этого декодированная строка имеет слитный вид:
01046012345678931726123110A45B
.
Правила чтения и разделения такой слитной строки определяются таблицей стандартных идентификаторов AI:
| Префикс AI | Назначение поля | Формат и длина данных | Правило выделения из общей строки |
|---|---|---|---|
01
|
Глобальный номер товара GTIN | Строго 14 цифр | Поле фиксированной длины. Следующий префикс AI начинается сразу после 14-го символа без разделителей. |
10
|
Номер партии или лота | До 20 буквенно-цифровых символов | Поле переменной длины. Если за ним следует еще один блок данных, конец партии отмечается управляющим символом FNC1. |
11
/
17
|
Дата производства (
11
) / Срок годности (
17
)
|
Строго 6 цифр в формате
ГГММДД
|
Поле фиксированной длины. Если день не регламентирован, в последних двух разрядах указываются нули (
00
).
|
21
|
Индивидуальный серийный номер | До 20 буквенно-цифровых символов | Поле переменной длины. Требует закрывающего разделителя FNC1 перед следующим префиксом AI. |
310n
|
Вес нетто в килограммах | Строго 6 цифр |
Четвертая цифра префикса (
n
) указывает положение десятичной запятой (например,
3103
для значения
001250
означает 1,250 кг).
|
Ключевую роль при разборе слитной строки играет специальный служебный символ FNC1. В начале штрихкода он выступает признаком соответствия формату GS1, а внутри строки работает как разделитель полей переменной длины (таких как партия
10
или серийный номер
21
). При выводе распознанного текста этот символ преобразуется в непечатаемый управляющий код ASCII 29 (символ разделителя групп GS). В текстовом поле он может отображаться как пустой промежуток, спецсимвол вида
\u001d
,
<GS>
или вовсе оставаться невидимым, однако при копировании строки в буфер обмена его байтовое значение сохраняется.
Структура кодов маркировки КИЗ и представление криптохвоста
При распознавании двумерных кодов GS1 Data Matrix, применяемых для обязательной маркировки товаров средствами идентификации КИЗ, извлекается составная строка, построенная по правилам префиксов AI, но дополненная блоком криптографической защиты. Типовая расшифрованная последовательность состоит из трех или четырех сегментов, разделенных символами ASCII 29:
-
Первый блок всегда начинается с префикса
01и содержит 14 цифр кода GTIN маркируемой продукции. -
Второй блок открывается префиксом
21и включает индивидуальный серийный номер экземпляра товара (обычно из 6 или 13 символов, включая латинские буквы, цифры и спецсимволы), после которого следует непечатаемый разделитель. - Третий и последующие блоки содержат так называемый криптохвост - ключ и код проверки, сформированные оператором системы маркировки.
Структура криптографической части зависит от товарной группы. Для большинства категорий товаров криптохвост состоит из префикса
91
(4 символа ключа проверки) и префикса
92
(44 или 88 символов электронной подписи в кодировке Base64, содержащей латиницу в верхнем и нижнем регистре, цифры, знаки плюса, слэша и равенства). В альтернативных коротких форматах используется префикс
93
, за которым следуют 4 символа кода проверки без разделителя в конце. При работе с полученной строкой важно учитывать регистр каждого символа после префиксов
21
,
91
,
92
и
93
, так как замена прописной буквы на строчную делает код идентификации недействительным.
Отраслевые идентификаторы изданий и логистических единиц
Отдельные категории продукции и грузовых мест используют специализированные номера, которые кодируются внутри стандартных символик EAN-13 или GS1-128 и распознаются по характерным начальным префиксам:
-
Книжные и нотные издания (ISBN и ISMN). При считывании штрихкода с книги возвращается 13-значный номер, начинающийся с префикса
978или979(«Книжный мир»). Для музыкальных нотных изданий зарезервирован поддиапазон с началом9790. Остальные цифры внутри такого кода распределяются между номером языковой группы (или страны), кодом издательства, порядковым номером публикации и финальной контрольной цифрой. -
Периодические печатные издания (ISSN). Газеты и журналы маркируются кодом с префиксом
977. За ним следуют первые 7 цифр уникального номера ISSN издания (без его собственной восьмой контрольной цифры), далее располагаются 2 резервных разряда для обозначения изменения цены или спецвыпуска, и замыкает строку пересчитанный по правилам EAN-13 контрольный разряд. Дополнительно справа от основного штрихкода часто считывается двух- или пятизначный код Add-On, обозначающий порядковый номер выпуска или недели в году. -
Логистические единицы (SSCC-18). Для сквозного отслеживания паллет, контейнеров и сборных грузов в цепочке поставок применяется 18-разрядный серийный код транспортной упаковки. В декодированной из штрихкода GS1-128 строке ему всегда предшествует двухзначный префикс AI
00. Сами 18 цифр включают цифру расширения (1 символ), префикс компании GS1, уникальный серийный номер грузового места, присвоенный отправителем, и замыкающую контрольную цифру.
Прикладные сценарии извлечения данных штрихкода из файла
Необходимость получить зашифрованную строку именно из сохраненного графического файла - скриншота, фотографии этикетки или цифрового макета упаковки - регулярно возникает тогда, когда физического носителя нет под рукой либо обычный аппаратный считыватель не справляется с задачей. Декодирование по картинке переводит графическую символику сразу в редактируемый текст, готовый к копированию в учетные таблицы, поисковые строки баз данных и формы электронного документооборота.
Электронная коммерция и подготовка поставок на маркетплейсы
При отгрузке товаров на склады торговых площадок критическую роль играет безошибочная считываемость индивидуальных наклеек товара и коробочных ярлыков. Продавцы и операторы фулфилмента сохраняют сгенерированную этикетку или дизайн-макет упаковки в графический файл и проверяют его до отправки всего тиража на термотрансферный или прямой термопринтер.
Полученный результат декодирования используют для контроля двух ключевых параметров перед запуском печати партии:
- Сверка фактического значения баркода. Извлеченная последовательность цифр или символов сопоставляется с номером, сгенерированным в личном кабинете площадки, чтобы исключить пересортицу из-за опечаток в шаблоне или сбоя при генерации этикетки.
- Контроль графической читаемости макета. Если символика успешно распознается на изображении макета, значит пропорции штрихов и пробелов не нарушены при верстке или масштабировании, а сам код не перекрыт текстовыми блоками и декоративными рамками.
Складской учет, приемка и транспортная логистика
В процессе транспортировки и складской обработки бумажные и полипропиленовые ярлыки подвергаются трению, выгоранию, намоканию или заклеиванию скотчем. Аппаратный лазерный сканер при наведении на такую замятую, бликующую под пленкой или частично стертую этикетку часто не может зафиксировать целостную линию отраженного луча и выдает отказ чтения.
В подобных ситуациях кладовщик или специалист по приемке делает четкую фотографию проблемного участка на смартфон и передает снимок на программное распознавание. Извлеченное строковое значение позволяет восстановить внутренний SKU, складской артикул, инвентарный номер имущества или идентификатор паллеты для оприходования груза без вскрытия тары и составления актов о немаркированной поставке. Такой же подход применяется при дистанционном разборе претензий: поставщик проверяет спорную позицию по присланной со склада фотографии ярлыка.
Работа с национальной системой маркировки
Участники оборота маркированных товаров регулярно сталкиваются с задачей извлечения полной строки кода Data Matrix из файлов этикеток, заказанных в системе «Честный ЗНАК», либо из фотографий уже нанесенных средств идентификации. В отличие от одномерных товарных номеров, напечатанная под двумерной матрицей текстовая расшифровка обычно содержит только GTIN и серийный номер единицы товара, тогда как проверочная часть (криптохвост) в виде открытого текста на наклейку не выводится.
Декодирование графического файла возвращает полную символьную последовательность, включая группы идентификаторов применения и криптографическую часть. Полученный результат можно использовать для следующих операций:
- Ручная проверка статуса и владельца кода маркировки в реестре без подключения 2D-сканера к рабочему компьютеру бухгалтера или менеджера.
- Точный перенос полной строки идентификатора при формировании, проверке или корректировке УПД в системах электронного документооборота.
- Сверка фактически нанесенных на продукцию кодов с перечнем, заявленным в отгрузочных документах контрагента, по фотоотчетам со склада.
Обработка электронных документов и цифровых каталогов
В офисном документообороте, закупках и каталогизации штрихкоды часто присутствуют исключительно в цифровом виде: на отсканированных копиях товарных накладных, счетах на оплату, таможенных декларациях, сертификатах, электронных билетах или на страницах прайс-листов поставщиков. Считывать такие коды ручным сканером с экрана монитора неудобно из-за бликов матрицы дисплея и пиксельной сетки, а визуальное перепечатывание длинных номеров неизбежно приводит к механическим ошибкам ввода.
Сохранение фрагмента документа в виде скриншота и последующее извлечение зашифрованной строки избавляет от ручного набора десятков цифр. Декодированный идентификатор документа, номер отправления или товарный код сразу копируется в буфер обмена для быстрого поиска позиции в ERP, CRM или складской базе данных.
В таблице ниже сведены типовые рабочие ситуации, виды исходных изображений и практическое назначение извлекаемых из них данных.
| Сфера применения | Исходное изображение | Извлекаемые данные | Практическое действие с результатом |
|---|---|---|---|
| Маркетплейсы и розница | Макет наклейки, скриншот этикетки из личного кабинета | Баркод товара, GTIN, код поставки | Предпечатная сверка номера с карточкой товара для защиты от обезличивания партии |
| Склад и логистика | Фотография затертого, мятого или залитого ярлыка на коробке | SKU, артикул, инвентарный номер, SSCC-18 | Идентификация и приемка груза в учетной базе при отказе лазерного сканера |
| Оборот товаров («Честный ЗНАК») | Графический файл выгрузки кодов или фото упаковки с Data Matrix | Полная строка КИЗ с серийным номером и криптохвостом | Проверка статуса кода в системе, сверка поставок и заполнение УПД |
| Электронный документооборот и закупки | Скан-копия накладной, квитанции, скриншот электронного каталога | Регистрационный номер документа, трек-номер, код позиции | Прямое копирование строки в учетную программу без ручного перепечатывания цифр |