Онлайн-инструмент позволяет определить формат штрихкода по его структуре на основе анализа текстовой строки, содержащей закодированные данные. При работе со складскими реестрами, выгрузками в форматах CSV или XLSX и логами сканирования часто известна только сама последовательность знаков без указания типа символики. Анализатор принимает эту строку на входе, проверяет ее параметры и выдает точное название стандарта или список подходящих спецификаций. Это избавляет от ручного перебора кодировок при настройке оборудования, генерации этикеток или проверке товарных баз.
Каждая символика подчиняется строгим правилам записи данных.
Идентификация стандарта выполняется путем последовательного сопоставления нескольких параметров входной строки. Алгоритм подсчитывает общую длину кода, определяет допустимый набор символов (строго числовой ряд, буквенно-цифровой состав или полный спектр ASCII) и ищет служебные префиксы со стартовыми знаками. Для стандартов с жесткой привязкой к математической валидации инструмент дополнительно пересчитывает контрольное число по соответствующему модулю. Если13-значная цифровая комбинация проходит проверку контрольного разряда по модулю 10, система однозначно идентифицирует стандарт EAN-13, отсекая произвольные наборы цифр.
В результате проверки формируется перечень стандартов линейных и двумерных кодов, спецификациям которых полностью удовлетворяет введенная последовательность.
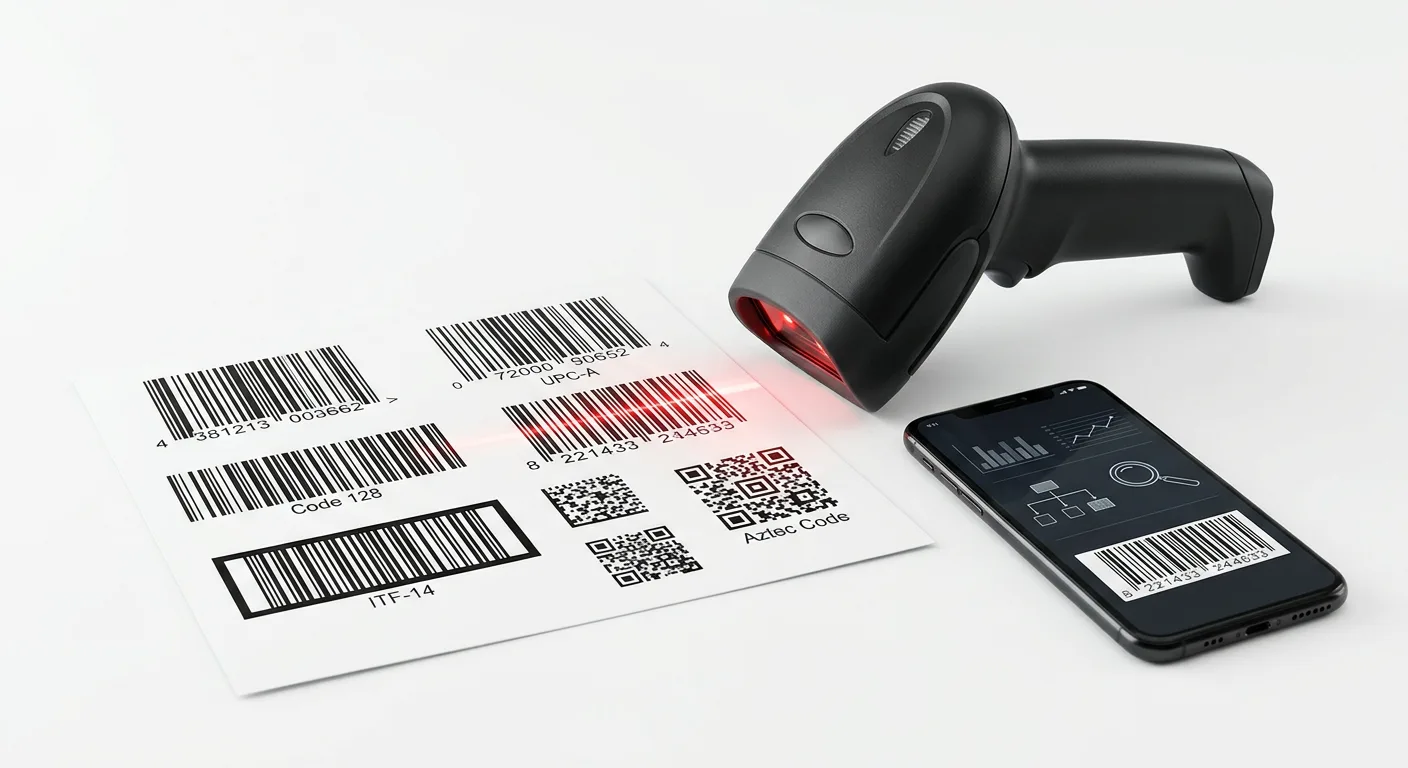
Принципы определения стандарта по структуре закодированных данных
Анализ текстовой строки для распознавания символики строится на последовательной фильтрации возможных форматов. Каждая спецификация штрихкода накладывает жесткие ограничения на емкость, алфавит и синтаксис записи. Если проверяемая последовательность нарушает хотя бы одно базовое правило стандарта, этот формат исключается из списка кандидатов.
При разборе строки данных последовательно проверяются четыре базовых параметра:
- общая длина последовательности и четность количества знаков;
- состав символов и регистр буквенных элементов;
- наличие обрамляющих стартовых и стоповых маркеров;
- присутствие регламентированных идентификаторов применения и разделителей.
Фиксированная и переменная длина последовательности
Подсчет количества знаков во входной строке сразу разделяет все существующие символики на две группы: форматы со строго фиксированной разрядностью и стандарты переменной длины. Товарные и логистические номера требуют точного числа символов. Последовательности из 8, 12, 13 или 14 разрядов проверяются на соответствие стандартам розничной и складской торговли. Отклонение даже на один знак делает генерацию такого штрихкода невозможной без предварительного дополнения нулями или усечения.
Стандарты переменной длины не имеют жесткой привязки к точному числу знаков и ограничиваются только физическими размерами этикетки или разрешением сканера. Отдельное условие для некоторых числовых форматов переменной длины - обязательная четность общего количества цифр, поскольку данные в них кодируются попарно.
Допустимый алфавит и символьный состав
Следующий шаг фильтрации - оценка типов знаков, входящих в анализируемую строку. По широте поддерживаемого алфавита стандарты делятся на четыре категории, характеристики которых приведены в таблице.
| Категория алфавита | Допустимые символы в строке | Особенности идентификации |
|---|---|---|
| Строго числовой | Цифры от 0 до 9 | Появление любой буквы, пробела или дефиса исключает стандарт из выборки |
| Числовой с расширением | Цифры от 0 до 9 и до 6 математических или валютных знаков | Разрешены знаки минус, плюс, точка, косая черта, двоеточие и символ доллара |
| Ограниченный буквенно-цифровой | Цифры 0-9, заглавные буквы A-Z и базовые спецсимволы | Строчные буквы не поддерживаются в базовом режиме кодирования |
| Полный спектр ASCII | Все 128 символов таблицы ASCII, включая строчные буквы и управляющие коды | Подходит для сложных серийных номеров, веб-ссылок и структурированных текстов |
Регистр букв играет решающую роль при отборе кандидатов. Если входная строка содержит строчные латинские символы (например,
id-450b
), базовые складские символики отсеиваются, а проверка переключается на современные линейные стандарты высокой плотности, расширенные режимы кодирования и двумерные форматы.
Стартовые и стоповые знаки
В ряде линейных символик начало и конец штрихкода обозначаются специальными служебными символами, которые указывают сканеру направление чтения и границы информационного поля. При выгрузке базы данных из учетной системы или чтении логов сканера эти знаки часто сохраняются внутри текстовой строки как обычные печатные символы.
Обнаружение одинаковых обрамляющих символов по краям строки прямо указывает на конкретное семейство кодов. Классический маркер стандарта Code 39 - знак звездочки в начале и в конце последовательности (например, строка
*ABC1234*
). В формате Codabar роль стартовых и стоповых элементов выполняют заглавные латинские буквы A, B, C или D, обрамляющие чисто числовую середину кода (например,
A4015600B
). Наличие таких краевых маркеров в сочетании с допустимым внутренним алфавитом однозначно определяет стандарт без дополнительных вычислений.
Структура идентификаторов применения
Сложные логистические и промышленные штрихкоды объединяют в одной строке сразу несколько параметров товара: код продукта, номер партии, дату производства, срок годности и серийный номер. Для разграничения этих полей используются стандартизированные идентификаторы применения - числовые или буквенные префиксы длиной от 2 до 4 знаков, которые ставятся перед каждым значением.
В текстовом представлении такие префиксы часто заключаются в круглые скобки для удобства чтения человеком, например:
(01)04601234567890(17)251231(10)BATCH5
. При анализе строки наличие скобок или строго заданной последовательности префиксов фиксированной длины позволяет отличить структурированный отраслевой формат от произвольного набора символов. Проверка сопоставляет найденные префиксы со справочником существующих идентификаторов и проверяет формат данных, идущих сразу за ними (например, требование строго 6 цифр в формате ГГММДД после префикса даты). Если структура префиксов и длина соответствующих им полей совпадают с нормативами, строка классифицируется как специализированный стандарт автоматической идентификации.
Анализ числовых стандартов фиксированной длины: семейство EAN, UPC и ITF
Линейные штрихкоды, состоящие исключительно из цифр и не содержащие служебных буквенных маркеров или скобок, классифицируются прежде всего по строгому количеству разрядов. В розничной торговле и складском учете каждый такой стандарт закреплен за определенной размерностью строки: 6, 8, 12, 13 или 14 знаков. Помимо общей длины, проверка опирается на внутреннюю структуру номера, где жестко зафиксированы позиции для кода национальной организации, идентификатора владельца бренда и артикула продукции.
Розничные форматы на 12 и 13 разрядов: EAN-13, JAN-13 и UPC-A
Базовым мировым стандартом для маркировки товаров народного потребления выступает 13-значный числовой код EAN-13. При анализе такой последовательности цифр строка разбивается на четыре функциональных сегмента:
- Префикс национальной организации GS1 (первые 3 цифры) - указывает на региональное представительство, в котором зарегистрирована компания, что условно называют кодом страны.
- Регистрационный номер производителя (от 4 до 7 цифр в зависимости от объема выпускаемого ассортимента) - уникальный номер предприятия внутри национальной базы.
- Код товара (от 2 до 5 цифр) - внутренний артикул конкретной товарной позиции, назначаемый самим изготовителем.
- Контрольная цифра (последний, 13-й разряд) - расчетное число для проверки целостности считывания.
Частным случаем этого стандарта является формат JAN-13, применяемый для товаров, зарегистрированных в Японии. Технически и структурно он полностью идентичен EAN-13, а его выделение в отдельную категорию происходит исключительно при обнаружении в начале 13-значной строки префиксов
45
или
49
.
Строка из 12 цифр указывает на североамериканский розничный стандарт UPC-A. Его архитектура аналогична 13-разрядным кодам, но первый знак отводится под системную цифру (обычно
0
,
1
,
6
,
7
или
8
для стандартных товаров), за которой следуют 5 цифр кода производителя, 5 цифр кода товара и 1 завершающий контрольный знак. Исторически и технически UPC-A представляет собой подмножество EAN-13: если перед 12-значным кодом UPC-A поставить незначащий ноль, образуется валидный 13-разрядный номер с префиксом
00
-
09
.
Компактные коды для малогабаритной упаковки: EAN-8 и UPC-E
Когда площадь поверхности изделия не позволяет разместить полноразмерный штрихкод, используются укороченные числовые форматы. Строка ровно из 8 цифр соответствует стандарту EAN-8. В отличие от старшей версии, этот номер не содержит отдельного кода производителя: первые 2-3 цифры составляют префикс GS1, следующие 4-5 цифр напрямую идентифицируют сам товар (номер выдается национальным регистратором индивидуально на каждый продукт), а замыкает ряд контрольная цифра.
Сжатый формат UPC-E распознается по длине в 6, 7 или 8 цифр. Этот стандарт образуется путем удаления незначащих нулей из полноразмерного 12-значного кода UPC-A по строго заданным правилам позиции. Вариативность длины при текстовом анализе связана со способами записи крайних служебных знаков:
-
6 цифр - передается только сжатое тело кода без системной и контрольной цифр (например,
425261). -
7 цифр - строка включает ведущую цифру системы счисления (
0или1) и 6 знаков основного тела, но опускает контрольное число. -
8 цифр - полная запись, где первый разряд строго равен
0или1, далее идут 6 знаков сжатого кода, а на конце стоит контрольный разряд, рассчитанный по исходному 12-значному эквиваленту.
Если на анализ поступает 8-значная числовая строка, разграничение между EAN-8 и полной формой UPC-E выполняется по первым знакам и проверке возможности развертывания строки до 12 разрядов по алгоритму восстановления нулей.
Логистические 14-разрядные стандарты: ITF-14 и EAN-14
Последовательность из 14 цифр применяется для маркировки транспортной тары - коробок, ящиков и паллет. В основе такой строки лежит 13-значный код вложенного розничного товара, перед которым добавляется один дополнительный разряд. Эта первая цифра называется индикатором логистического уровня упаковки и принимает значения от
1
до
9
:
-
Цифры от
1до8обозначают различные уровни групповой упаковки с фиксированным количеством товара внутри (например,1- малый короб на 10 штук,2- большой ящик на 50 штук). -
Цифра
9служит маркером упаковки с переменным весом или количеством, когда точная масса продукции определяется при каждом взвешивании. -
Значение
0на первой позиции указывает, что код относится к единичному товару, а сами 14 разрядов получены путем простого выравнивания 12- или 13-значного номера ведущими нулями.
За цифрой-индикатором следуют первые 12 знаков базового розничного кода (включающие префикс GS1, регистрационный номер производителя и код товара), а 14-я позиция отводится под заново пересчитанную контрольную цифру для всей 14-разрядной последовательности.
На уровне чистой строки из 14 цифр данные для форматов ITF-14 и EAN-14 выглядят одинаково, так как оба кодируют один и тот же глобальный номер товарной продукции. Различие между ними кроется в физической символике и способе записи служебных признаков. ITF-14 строится на базе символики Interleaved 2 of 5, которая кодирует только четное количество цифр попарно (одна цифра в штрихах, вторая в пробелах) и предназначена для прямой печати на гофрокартоне. Стандарт EAN-14 формируется на базе линейного кода высокой плотности и в полной структуре всегда предваряется двухзначным идентификатором применения
01
. Если в анализируемой строке из 14 цифр отсутствует префикс
01
, формат по умолчанию соотносится со структурой ITF-14; если же строка насчитывает 16 цифр и начинается с комбинации
01
, это указывает на формат EAN-14.
Сводная таблица характеристик цифровых форматов фиксированной длины
Сопоставление количества разрядов, начальных цифр и внутренней компоновки позволяет точно классифицировать числовой штрихкод:
| Стандарт | Количество цифр | Структурные элементы строки | Характерные признаки и префиксы |
|---|---|---|---|
| UPC-E | 6, 7 или 8 | Системная цифра (опционально) + 6 цифр сжатого кода + контрольный разряд (опционально) |
В 8-значном виде всегда начинается с
0
или
1
; разворачивается в 12-значный UPC-A
|
| EAN-8 | 8 | Префикс GS1 (2-3 знака) + код товара (4-5 знаков) + контрольный разряд (1 знак) | Отсутствует код производителя; не подлежит развертыванию до 12 или 13 знаков |
| UPC-A | 12 | Системная цифра (1 знак) + код производителя (5 знаков) + код товара (5 знаков) + контрольный разряд (1 знак) |
При добавлении ведущего нуля переходит в диапазон префиксов
00
-
09
формата EAN-13
|
| EAN-13 | 13 | Префикс GS1 (3 знака) + номер производителя и код товара (9 знаков в сумме) + контрольный разряд (1 знак) | Любые трехзначные префиксы национальных организаций GS1 |
| JAN-13 | 13 | Префикс Японии (2 знака) + номер производителя и код товара (10 знаков в сумме) + контрольный разряд (1 знак) |
Строго начинается с префиксов
45
или
49
|
| ITF-14 | 14 | Цифра-индикатор упаковки (1 знак) + база кода товара без его старой контрольной цифры (12 знаков) + новый контрольный разряд (1 знак) |
Базируется на символике Interleaved 2 of 5; первая цифра от
1
до
8
(фиксированная тара) или
9
(переменный вес)
|
| EAN-14 | 14 (или 16 с префиксом) |
Префикс
01
(при полной записи) + 14-значный логистический код, идентичный структуре ITF-14
|
Отличается от ITF-14 наличием ведущего идентификатора
01
в полной строке данных
|
Структурные признаки буквенно-цифровых и высокоплотных 1D-символик
Линейные коды переменной длины не привязаны к фиксированному количеству разрядов, поэтому их идентификация строится на оценке допустимого алфавита, плотности записи и специфических служебных знаков. Если проверяемая строка выходит за рамки стандартных 8, 12, 13 или 14 цифр либо содержит латинские буквы, знаки пунктуации и управляющие символы, область поиска смещается в сторону универсальных индустриальных, складских и специализированных форматов.
Универсальные буквенно-цифровые стандарты: Code 39, Code 93 и Code 128
Базовый стандарт Code 39 распознается по строгому набору из 43 символов: заглавные латинские буквы (A-Z), цифры (0-9) и семь специальных знаков (дефис, точка, пробел, знак доллара, косая черта, плюс и процент). Отличительным маркером при передаче полной строки со сканера выступает символ звездочки, обрамляющий данные в начале и в конце, хотя многие считыватели отсекают эти краевые знаки при выводе текста. Для кодирования всех 128 знаков таблицы ASCII применяется расширенный режим Code 39 Extended. В нем строчные буквы и дополнительные спецсимволы формируются путем комбинации базовых знаков со служебными префиксами
$
,
/
,
+
и
%
. Например, если в необработанной строке регулярно встречаются пары вроде
+A
(строчная буква a) или
/A
(символ восклицательного знака), это указывает на физическую запись в Code 39, предназначенную для декодирования в режиме Full ASCII.
Стандарт Code 93 разрабатывался как более компактная и защищенная альтернатива Code 39. В базовом варианте он использует идентичный репертуар из 43 видимых символов, однако отличается повышенной плотностью записи и обязательным наличием двух скрытых проверочных знаков в конце структуры перед стоповым элементом. Расширенная модификация Code 93 Extended аналогично покрывает всю таблицу ASCII, но задействует для составного кодирования четыре собственных внутренних управляющих сдвига, которые не имеют прямого графического эквивалента в базовом алфавите и обрабатываются на аппаратном уровне сканера.
Высокоплотная символика Code 128 поддерживает весь спектр из 128 символов ASCII напрямую, без потери физического места на составные конструкции. Определение этого формата и его внутренней архитектуры опирается на анализ трех переключаемых подмножеств, которые могут динамически сменять друг друга внутри одного штрихкода:
- Подмножество Code 128-A включает цифры, заглавные латинские буквы, знаки пунктуации и управляющие коды ASCII (значения от 00 до 95), такие как возврат каретки или табуляция.
- Подмножество Code 128-B охватывает цифры, заглавные и строчные латинские буквы, а также стандартные печатные спецсимволы (значения от 32 до 127), что делает его основным вариантом для смешанных буквенно-цифровых артикулов с разным регистром.
-
Подмножество Code 128-C предназначено для сверхплотной упаковки числовых данных, где один символ штрихкода кодирует сразу пару цифр от
00до99, сокращая физическую длину метки вдвое при четном количестве разрядов.
Если анализируемая строка содержит строчные буквы без признаков составных префиксов, выбор сужается до Code 128 (режим B) или декодированного режима Extended для Code 39 и Code 93. Если же строка состоит из длинного четного ряда цифр, но не укладывается в жесткие рамки кассовых стандартов, наиболее вероятным кандидатом выступает Code 128-C.
Специализированные цифровые и ограниченно-символьные форматы
В лабораторной диагностике, телекоммуникациях, библиотечном учете и авиационной логистике применяются узкопрофильные символики. Их алфавит шире чисто цифрового, но значительно уже полноценного буквенно-цифрового набора.
Формат Codabar легко идентифицируется по комбинации цифр (0-9), шести специальных знаков (
-
,
$
,
:
,
/
,
.
,
+
) и обязательному присутствию стартового и стопового символов из диапазона заглавных букв
A
,
B
,
C
,
D
(в ряде спецификаций обозначаемых как
T
,
N
,
E
). Буквы в Codabar никогда не встречаются в середине информационного поля - их появление строго на первой и последней позициях строки (например,
A40156B
) однозначно указывает на этот стандарт.
Телекоммуникационный стандарт Code 11 оперирует исключительно цифрами от 0 до 9 и знаком дефиса (
-
). При анализе строки вида
981-45-02
отсекаются чисто числовые форматы, а выбор между Code 11, Codabar и Code 39 делается по отсутствию буквенных ограничителей и проверке внутренних контрольных знаков (одного при длине до 10 символов и двух - при более длинной записи).
Складской формат MSI Plessey кодирует только цифры (0-9) произвольной длины и не допускает спецсимволов или букв. В отличие от розничных кодов, он используется для маркировки стеллажей и внутренних полок, где длина идентификатора определяется локальной системой учета предприятия.
Отдельную группу составляет семейство числовых кодов 2 of 5, где каждая цифра формируется комбинацией пяти элементов, два из которых широкие. При отсутствии букв и спецсимволов различие между модификациями этого семейства определяется сферой применения, плотностью и четностью длины строки:
- Standard 2 of 5 (Industrial 2 of 5) кодирует информацию только в ширине темных штрихов, оставляя пробелы узкими, и принимает цифровые строки любой длины, но характеризуется низкой плотностью записи.
- Matrix 2 of 5 задействует для кодирования как штрихи, так и пробелы, обеспечивая более компактную запись числовых последовательностей произвольной длины по сравнению с версией Standard.
- IATA 2 of 5 представляет собой регламентированную версию на базе стандартного кода, используемую в авиационной отрасли для маркировки багажных бирок и грузовых накладных со строго заданной структурой рейса и кода авиакомпании.
- DataLogic 2 of 5 является модифицированной вариацией матричного принципа с измененной таблицей соответствия ширин элементов для специфического промышленного оборудования.
Сравнение допустимых символьных наборов и структурных ограничений помогает разграничить линейные стандарты переменной длины при анализе текстовой строки:
| Символика | Допустимый набор символов | Служебные и краевые маркеры в строке | Характерный признак структуры |
|---|---|---|---|
| Code 39 |
Цифры
0
-
9
, буквы
A
-
Z
, пробел и знаки
- . $ / + %
|
Стартовый и стоповый знак звездочки (часто скрыт при выводе) |
Отсутствие строчных букв; в режиме Extended - пары символов с префиксами
$ / + %
|
| Code 93 | Базовый набор из 43 знаков (в версии Extended - все 128 символов ASCII) | Внутренние управляющие сдвиги для полного ASCII | Высокая плотность при том же алфавите, что у Code 39; два обязательных проверочных знака в конце |
| Code 128 | Полный набор из 128 символов ASCII (подмножества A, B, C) | Служебные коды старта и переключения режимов (A/B/C) | Наличие строчных и заглавных букв без префиксов; режим C требует четного числа цифр для парной записи |
| Codabar |
Цифры
0
-
9
и спецсимволы
- $ : / . +
|
Обязательные буквы
A
,
B
,
C
или
D
строго по краям строки
|
Буквенные знаки присутствуют только на первой и последней позициях |
| Code 11 |
Цифры
0
-
9
и знак дефиса
-
|
Собственные графические старт/стоп элементы без текстового вывода | Чисто цифровой ряд, разделенный только дефисами, без букв и других знаков пунктуации |
| MSI Plessey |
Только цифры
0
-
9
|
Отсутствуют в текстовом представлении | Произвольная длина числового ряда; применяется для внутренней складской навигации |
| Семейство 2 of 5 (Standard, Matrix, IATA, DataLogic) |
Только цифры
0
-
9
|
Специфические комбинации узких и широких стартовых штрихов | Переменная длина без жесткой привязки к четности разрядов (в отличие от парного Interleaved 2 of 5) |
Такое сопоставление отсекает заведомо неподходящие форматы по одному несовпадающему знаку. Например, присутствие двоеточия или плюса в цифровом коде с буквами
A
по краям исключает Code 11 и семейство 2 of 5, оставляя только Codabar и универсальные буквенно-цифровые символики. Если же строка состоит исключительно из цифр и не имеет специфических краевых маркеров, окончательное разграничение между MSI Plessey, Code 128-C и модификациями 2 of 5 требует математической проверки контрольного разряда.
Роль контрольной цифры и математической валидации при идентификации типа
Математическая проверка последнего знака - решающий этап распознавания стандарта, когда длина строки и набор символов совпадают сразу у нескольких форматов. Например, произвольная последовательность из 13 цифр внешне подходит под структуру EAN-13, но одновременно может оказаться внутренним складским номером в кодировке Code 39, MSI Plessey или семействе 2 of 5. Вычисление контрольной суммы отсекает случайные совпадения: если последний разряд не сходится с расчетным значением по жесткой формуле стандарта, проверяемая гипотеза о принадлежности к товарной или логистической маркировке отклоняется.
Алгоритм расчета по модулю 10 для структур GTIN и SSCC-18
Товарные и транспортные идентификаторы - включая форматы EAN, UPC, ITF-14 и 18-разрядный логистический код SSCC-18 - используют единое правило валидации по модулю 10 (Mod 10) с чередующимися весовыми коэффициентами 3 и 1. В этом расчете участвуют все цифры кроме самой последней (контрольной), а отсчет позиций для универсальности ведется строго справа налево, начиная с предпоследнего знака всей строки.
Пошаговая проверка числового ряда по алгоритму Mod 10 выполняется в следующем порядке:
- Отделение крайнего правого знака, который выступает эталоном для сравнения в конце вычислений.
- Нумерация оставшихся цифр справа налево (крайняя правая рабочая цифра получает первую, то есть нечетную позицию).
- Сложение всех цифр на нечетных позициях при отсчете справа и умножение полученной суммы на весовой коэффициент 3.
- Сложение всех цифр на четных позициях при отсчете справа (их весовой коэффициент равен 1, поэтому сумма остается без изменений).
- Суммирование обоих результатов для получения общего взвешенного значения.
- Нахождение остатка от деления общей суммы на 10: если остаток равен 0, контрольная цифра также равна 0; для любого другого остатка он вычитается из 10.
Для наглядности можно разобрать проверку 13-значной строки
4601234567893
, где цифра
3
на конце проверяется на соответствие правилу GTIN:
Рабочие разряды (12 цифр): 4 6 0 1 2 3 4 5 6 7 8 9
Нечетные позиции справа:   9 + 7 + 5 + 3 + 1 + 6 = 31
Умножение на вес 3:        31 × 3 = 93
Четные позиции справа:     8 + 6 + 4 + 2 + 0 + 4 = 24
Общая взвешенная сумма:    93 + 24 = 117
Остаток от деления на 10:  117 mod 10 = 7
Итоговый контрольный знак: 10 - 7 = 3
Поскольку вычисленная тройка совпадает с тринадцатым знаком исходной строки, код проходит математическую валидацию как корректный EAN-13. При анализе 12-значного UPC-A или 14-значного ITF-14 порядок действий остается идентичным: крайний правый рабочий разряд перед контрольным числом всегда получает множитель 3. Если бы на конце стояла любая другая цифра, строка была бы классифицирована как простой цифровой код переменной длины (например, Code 128-C или Standard 2 of 5), не связанный с товарной номенклатурой.
Валидация по модулю 43 и модулю 103 в буквенно-цифровых кодах
Линейные форматы переменной длины используют более сложные делители, так как их алфавит включает латинские буквы и спецсимволы. В базовой спецификации Code 39 контрольный разряд необязателен, но при повышенных требованиях к точности считывания применяется модификация Code 39 Mod 43. В этой схеме каждому из 43 допустимых знаков присваивается числовой индекс: цифры от
0
до
9
сохраняют свои номиналы (0-9), буквы от
A
до
Z
получают значения от 10 до 35, а оставшиеся символы (дефис, точка, пробел, знак доллара, косая черта, плюс и процент) - индексы от 36 до 42.
При проверке строки на соответствие Code 39 Mod 43 числовые значения всех информационных знаков складываются без весовых множителей, после чего вычисляется остаток от деления общей суммы на 43. Полученное число переводится обратно в символ по той же таблице и сверяется с последним знаком строки. Например, в коде
PART-10Z
сумма индексов для
P
(25),
A
(10),
R
(27),
T
(29),
-
(36),
1
(1) и
0
(0) дает 128. Остаток от деления 128 на 43 равен 42, что соответствует знаку
%
, а не букве
Z
(индекс 35). Следовательно, строка записана либо в обычном Code 39 без проверки, либо в формате Code 128.
В отличие от открытого проверочного знака в товарных кодах и Code 39 Mod 43, высокоплотный стандарт Code 128 использует обязательную внутреннюю проверку по модулю 103 (Mod 103). Этот контрольный символ жестко зашит в графическую структуру штрихов перед стоповым знаком, проверяется оборудованием при сканировании, но практически никогда не передается в текстовую строку результата. Расчет Mod 103 строится на суммировании кода стартового символа (определяющего подмножество A, B или C) и произведений числового индекса каждого знака (от 0 до 102) на его порядковый номер в строке слева направо. Такое различие в архитектуре напрямую влияет на методику текстового анализа данных, представленную в сравнительной таблице:
| Алгоритм валидации | Связанные стандарты | Принцип вычисления | Присутствие в текстовой строке и роль при распознавании |
|---|---|---|---|
| Mod 10 (веса 3 и 1) | EAN-8, EAN-13, UPC-A, UPC-E, ITF-14, SSCC-18 | Взвешенная сумма цифр справа налево, вычитание остатка от деления на 10 из десяти | Всегда присутствует как последняя цифра; несовпадение сразу исключает форматы GTIN и SSCC-18 |
| Mod 10 (алгоритм Луна) | MSI Plessey, отдельные модификации 2 of 5 | Удвоение каждой второй цифры справа со сложением разрядов произведений, кратность суммы 10 | Передается в конце числового ряда; помогает отличить складской код MSI Plessey от случайного набора цифр |
| Mod 43 | Code 39 Mod 43 | Прямое сложение табличных индексов знаков (0-42) и нахождение остатка от деления на 43 | Виден в конце строки как буква, цифра или спецсимвол; подтверждает защищенный режим Code 39 |
| Mod 103 | Code 128 (A, B, C) | Сумма стартового кода и произведений индексов символов (0-102) на их позицию, остаток от деления на 103 | Скрыт на уровне штрихов и отсекается сканером; позволяет распознать Code 128 там, где внешняя проверка Mod 10 или Mod 43 не сходится |
Отсутствие видимого контрольного знака в текстовом выводе для Code 128 объясняет, почему любая цифровая последовательность из 8, 12, 13 или 14 символов с «неправильной» последней цифрой по Mod 10 остается технически валидной для высокоплотной линейной маркировки. Если математический тест на стандарт GTIN дает отрицательный результат, строка не считается поврежденной - она классифицируется как контейнер произвольных данных в символике без внешнего контрольного разряда.
Идентификация стандартов системы GS1 и идентификаторов применения
Графическая основа символики Code 128 используется как для произвольной внутренней маркировки, так и для глобальных логистических цепочек в формате GS1-128, ранее известном как UCC/EAN-128. Визуально штрихи обоих стандартов идентичны, а их разграничение при анализе строки базируется на проверке внутренней структуры данных и служебных маркеров.
Главным техническим отличием GS1-128 выступает обязательное присутствие специального непечатаемого символа FNC1 сразу после стартового знака штрихкода. Эта комбинация указывает сканирующему оборудованию, что далее следует строка, сформированная по строгим правилам синтаксиса GS1. В текстовом выводе сканера стартовый FNC1 часто преобразуется в префикс идентификатора символики
]C1
или опускается, оставляя на виду упорядоченную последовательность идентификаторов применения AI.
Синтаксис AI и разделительная функция FNC1
Вся информация внутри контейнеров GS1 разбивается на логические поля при помощи AI - числовых префиксов длиной от 2 до 4 цифр, которые однозначно определяют назначение и формат следующего за ними блока данных. На текстовой подписи под штрихкодом префиксы AI для удобства чтения заключаются в круглые скобки, например
(01)04601234567892(17)261231(10)ABC123
. Однако в самой закодированной последовательности скобки никогда не прописываются, и сканер передает сплошную строку вида
01046012345678921726123110ABC123
.
Для корректного разбора такой сплошной строки при определении формата проверяются длина и порядок следования полей. Все идентификаторы AI делятся на две категории: фиксированной и переменной длины. Поля фиксированной длины всегда занимают строго заданное количество знаков, после чего без разделителей начинается следующий префикс AI. Если же поле имеет переменную длину и не стоит в самом конце штрихкода, для обозначения его границы вновь применяется символ FNC1, который в потоке данных выступает разделителем и транслируется сканером как управляющий символ ASCII 29 (Group Separator,
<GS>
).
Основные идентификаторы применения AI, по которым распознаются стандартные структуры GS1 в логистике и торговле, представлены в таблице ниже.
| Префикс AI | Обозначаемая структура или атрибут | Формат и длина поля данных | Необходимость разделителя FNC1 после поля |
|---|---|---|---|
00
|
SSCC-18 (серийный код транспортной упаковки) | Строго 18 цифр (включая расширение и контрольный разряд Mod 10) | Не требуется (фиксированная длина) |
01
|
GTIN (идентификатор товарной позиции) | Строго 14 цифр (EAN-13 дополняется ведущим нулем) | Не требуется (фиксированная длина) |
02
|
GTIN содержащихся внутри груза единиц |
Строго 14 цифр (используется в паре с AI
37
)
|
Не требуется (фиксированная длина) |
10
|
Номер партии или лота | От 1 до 20 буквенно-цифровых символов | Обязателен, если за полем следует еще один AI |
11
/
15
/
17
|
Дата производства / минимального срока / годности | Строго 6 цифр в формате ГГММДД | Не требуется (фиксированная длина) |
21
|
Серийный номер экземпляра | От 1 до 20 буквенно-цифровых символов | Обязателен, если за полем следует еще один AI |
310n
|
Вес нетто в килограммах (
n
указывает позицию десятичной запятой)
|
Строго 6 цифр | Не требуется (фиксированная длина) |
37
|
Количество единиц товара в логистической упаковке | От 1 до 8 цифр | Обязателен, если не в конце строки |
410
-
414
|
GLN (код локации или контрагента: получатель, отправитель, физическое место) | Строго 13 цифр с контрольным разрядом Mod 10 | Не требуется (фиксированная длина) |
Такая проверка синтаксиса позволяет точно отделить специализированный код GS1-128 от обычного Code 128. Например, 20-значная цифровая строка, начинающаяся с нулей (префикс
00
) и заканчивающаяся корректной контрольной цифрой по Mod 10 для последних 18 знаков, однозначно идентифицируется как логистический этикеточный код SSCC-18, тогда как несовпадение контрольного разряда или нарушение структуры дат (например, месяц больше 12 в AI
17
) переводит строку в разряд произвольного кода.
Семейство символик GS1 DataBar
Для маркировки малогабаритных товаров, свежих продуктов переменного веса и ювелирных изделий, где недостаточно места для классического EAN-13 или протяженного GS1-128, используется компактное семейство линейных и многострочных кодов GS1 DataBar. При анализе раскодированной строки принадлежность к этому семейству выявляется по характерному 14-разрядному формату GTIN (часто с неявным AI
01
, который добавляется сканером автоматически) и специфическим ограничениям отдельных модификаций:
- GS1 DataBar Omnidirectional, GS1 DataBar Truncated и многострочный GS1 DataBar Stacked кодируют исключительно 14-значный номер GTIN. Наличие букв или дополнительных AI исключает эти три типа. Omnidirectional и Stacked предназначены для всенаправленного кассового сканирования, а Truncated представляет собой урезанную по высоте версию для плоских поверхностей.
-
GS1 DataBar Limited также вмещает только 14-разрядный GTIN, но имеет жесткое математическое ограничение на первый знак: индикатор упаковки должен быть равен только
0или1. Если строка начинается с цифр от2до9, формат GS1 DataBar Limited технически невозможен. -
GS1 DataBar Expanded и его многострочная версия GS1 DataBar Expanded Stacked - единственные представители семейства, поддерживающие сцепку нескольких идентификаторов применения AI. Они позволяют объединить в компактном коде 14-значный GTIN с весом (AI
310n), сроком годности (AI17) или номером партии (AI10) общей емкостью до 74 цифровых или 41 буквенно-цифрового знака.
Композитная символика и стандарт GS1 Digital Link
В случаях, когда на малой площади упаковки требуется совместить стандартное кассовое сканирование с передачей расширенных сведений о партии или серийном номере, применяется композитная символика (Composite Codes, обозначаемая как GS1 Composite). Такой гибридный код физически состоит из двух частей: внизу располагается базовый линейный носитель (EAN-8, EAN-13, UPC-A, GS1-128 или любой вариант GS1 DataBar), в котором зашит основной идентификатор товара, а непосредственно над ним печатается двумерный микрокомпонент (CC-A, CC-B или CC-C), хранящий дополнительные атрибуты AI. При считывании сканер объединяет данные обоих уровней в единую строку синтаксиса GS1, но внутри служебного заголовка отмечает наличие связки между базовым и двумерным компонентами.
Современным развитием системы идентификаторов применения стал формат GS1 Digital Link, который переносит классическую структуру AI в синтаксис веб-адресов URI. Такой подход позволяет использовать один штрихкод одновременно на кассе и в мобильных приложениях покупателей. Вместо плоской последовательности цифр данные выстраиваются в виде иерархического URL-пути, где идентификаторы ключей и атрибутов выступают сегментами адреса и параметрами запроса.
Распознавание GS1 Digital Link в анализируемой строке выполняется по наличию протокола (
http://
или
https://
), доменного имени и строгого чередования цифровых кодов AI с их значениями через косую черту. Например, классическая строка GS1 с товаром, партией и серийным номером в формате веб-ссылки принимает вид
https://example.com/01/04601234567892/10/ABC123/21/98765?17=261231
. Обнаружение подобного шаблона в текстовых данных свидетельствует об использовании стандарта GS1 Digital Link, который физически размещается внутри двумерных матричных носителей. Notice how it transitions smoothly to 2D codes without explaining them.
Признаки двумерных (2D), матричных и многострочных штрихкодов
Линейная маркировка (1D) хранит информацию только в одном направлении - по горизонтали, что жестко ограничивает объем записи несколькими десятками символов. При анализе строки переход к двумерным кодам (2D) определяется прежде всего по информационной емкости и структуре данных: если последовательность превышает сотню знаков, включает переносы строк, табуляцию, иероглифы, структуры JSON, XML или сырой двоичный код, использование линейных форматов физически невозможно. Двумерные стандарты распределяют данные сразу по двум осям - горизонтали и вертикали, за счет чего в компактной геометрической области помещаются тысячи символов.
Вторым фундаментальным отличием выступает автономность данных и защита от повреждений. Линейный код обычно содержит только короткий ключ для поиска записи в внешней базе данных и простейшую контрольную цифру, которая лишь фиксирует факт ошибки при чтении. Двумерные символики способны хранить полное досье объекта без обращения к серверу, а для защиты информации используют встроенные алгоритмы коррекции ошибок (чаще всего математический аппарат Рида-Соломона). Даже при физическом стирании или загрязнении части графического элемента избыточные блоки данных позволяют полностью восстановить исходную строку.
Матричные стандарты: геометрия сетки и емкость
Матричные штрихкоды строятся на основе координатной сетки из темных и светлых модулей (квадратных, круглых или шестиугольных). При проверке декодированной строки определить принадлежность к конкретному матричному стандарту помогают специфические режимы сжатия текста, максимальные пороги длины и наличие служебных заголовков.
Семейство QR Code получило широкое распространение благодаря высокой скорости чтения и поддержке четырех основных режимов кодирования: цифрового, буквенно-цифрового, байтового и кандзи. В зависимости от ограничений по площади нанесения и формата данных выделяют несколько модификаций этого стандарта:
- Классический QR Code - вмещает до 7089 цифр, 4296 буквенно-цифровых знаков или 2953 байт двоичного кода, поэтому длинные веб-ссылки, электронные визитки vCard и платежные реквизиты почти всегда указывают на этот формат.
- Micro QR - уменьшенная версия для маркировки мелких деталей с жестким лимитом емкости до 35 цифр или 21 буквенно-цифрового символа.
- rMQR - прямоугольная разновидность матрицы, разработанная для вытянутых и узких поверхностей, где не помещается классический квадрат, но требуется сохранить емкость до 361 цифры.
- GS1 QR - использует стандартную матричную сетку, но на программном уровне начинается со скрытого признака FNC1, подчиняя всю внутреннюю строку правилам построения идентификаторов применения.
Стандарт Data Matrix применяется в промышленности, микроэлектронике и логистике за счет высокой плотности записи на малых площадях. Полная версия кода способна хранить до 3116 цифровых, 2335 текстовых знаков или 1556 байт двоичных данных. Формат выпускается в двух геометрических исполнениях: классическом квадратном и вытянутом прямоугольном (Data Matrix Rectangular), который удобен для нанесения на кабели, ампулы и торцы печатных плат. Если в начале структуры записан управляющий символ системы GS1, код классифицируется как GS1 Data Matrix и используется для поштучной прослеживаемости товаров.
Для специфических задач транспорта, скоростной печати и курьерской доставки применяются другие матричные архитектуры:
- Aztec Code - компактный матричный код, не требующий свободного поля вокруг границ, который вмещает до 3832 цифр или 3067 текстовых знаков и активно используется в электронных билетах на железнодорожном и авиационном транспорте.
- MaxiCode - матрица фиксированного размера из шестиугольных модулей, вмещающая около 93 буквенно-цифровых или 138 цифровых символов, созданная для высокоскоростной сортировки посылок на конвейерных лентах; внутри строки таких кодов часто обнаруживаются структурированные почтовые индексы, коды стран и номера маршрутов.
- DotCode - двумерная символика, состоящая из массива отдельных несоприкасающихся точек в прямоугольной сетке, предназначенная для каплеструйного и лазерного нанесения на быстрых производственных линиях (например, при маркировке табачной продукции).
Многострочные (стековые) символики
Промежуточным звеном между 1D и матричными 2D-кодами выступают многострочные, или стековые, штрихкоды. Геометрически они представляют собой набор узких линейных кодов, сложенных друг на друга в несколько этажей. Такой подход позволяет считывать маркировку как фотосканерами, так и специализированными лазерными считывателями.
Ранние стековые форматы создавались путем прямого объединения классических линейных стандартов в единый вертикальный блок:
- Codablock-F - формируется из нескольких строк на базе логики Code 128, поддерживает от 2 до 44 рядов и позволяет закодировать полный набор из 128 символов ASCII и расширенной таблицы ISO, преодолевая ограничение ширины обычной линейной этикетки.
- Code 16K - многострочная структура из 2-16 рядов, построенная на архитектуре символьных наборов Code 128, способная вместить до 77 буквенно-цифровых знаков или 154 цифр.
Полноценным двумерным многострочным стандартом является PDF417. В отличие от простых стековых кодов, он содержит встроенный механизм коррекции ошибок Рида-Соломона с настраиваемым уровнем надежности. В одном символе PDF417 помещается до 2710 цифр, 1850 текстовых знаков или 1108 байт двоичной информации. Из-за высокой плотности записи этот тип часто применяется в складских накладных, удостоверениях личности, водительских правах и посадочных талонах, где внутри строки передаются целые таблицы данных, разделенные управляющими символами ASCII или разметкой ANSI. Для ограниченного пространства существует модификация MicroPDF417, которая за счет отказа от части служебных разделителей имеет меньшие габариты и вмещает до 366 цифр или 250 текстовых символов.
Сравнение параметров двумерных и стековых стандартов
При анализе большой или сложно структурированной строки сопоставление объема и характера данных позволяет сузить круг возможных двумерных носителей:
| Стандарт | Архитектура | Максимальная емкость (цифры / текст / байты) | Характерные признаки кодируемых данных |
|---|---|---|---|
| QR Code (включая Micro QR, rMQR, GS1 QR) | Матричная | До 7089 / 4296 / 2953 (для стандартной версии) | URL-ссылки, структуры GS1 Digital Link, текст в кодировке UTF-8, кандзи, длинные JSON-строки |
| Data Matrix (включая Rectangular, GS1 Data Matrix) | Матричная | До 3116 / 2335 / 1556 |
Плотные строки с идентификаторами AI и разделителями
<GS>
, серийные номера деталей, криптохвосты
|
| PDF417 / MicroPDF417 | Многострочная (2D) | До 2710 / 1850 / 1108 (до 366 / 250 / 150 для Micro) | Многострочные текстовые блоки, анкетные данные, упаковочные листы, двоичные слепки |
| Aztec Code | Матричная | До 3832 / 3067 / 1914 | Билетные структуры данных, зашифрованные последовательности, криптографические подписи |
| MaxiCode | Матричная (гексагональная) | До 138 / 93 / - | Фиксированные логистические пакеты данных с почтовыми индексами, кодами стран и классов сервиса |
| DotCode | Матричная (точечная) | Зависит от площади нанесения (обычно до 100-200 знаков) | Короткие высокоскоростные идентификаторы партий, времени производства и сериализации упаковки |
| Codablock-F / Code 16K | Стековая (1D) | До 2725 знаков (Codablock-F) / до 154 цифр (Code 16K) | Длинные строки набора ASCII без сложных бинарных вложений, разбитые на строки для узких этикеток |
Если проверяемая последовательность содержит непечатаемые байты, символы перевода каретки (
CR
), новой строки (
LF
) или превышает длину в 100-150 символов, линейные форматы полностью исключаются из результатов проверки. В этом случае точное определение стандарта между Data Matrix, QR Code, Aztec Code или PDF417 опирается на внутренний синтаксис отраслевого документа или визуальную форму самого графического штампа.
Отраслевые, фармацевтические, книжные и почтовые форматы маркировки
Во многих прикладных сферах поверх базовых линейных и матричных символик действуют отраслевые спецификации. Графически такой штрихкод может быть сформирован по правилам EAN-13, Code 39, Code 128 или Data Matrix, однако внутри него заложена жесткая маска данных. Распознавание конкретного отраслевого стандарта по текстовой строке выполняется путем проверки зарезервированных префиксов, фиксированной разрядности, специфического алфавита и специализированных алгоритмов расчета контрольного символа.
Книжные и сериальные идентификаторы на базе EAN
Издательская продукция маркируется линейными кодами на основе 13-разрядной структуры, где первые три цифры выделены под виртуальные коды стран Bookland и сериальных реестров. Для точной классификации издательского номера проверяются стартовые префиксы и наличие дополнительных 2- или 5-значных секций (Add-on), кодирующих цену или номер выпуска:
-
ISBN-13 и ISBN-10: современные книжные издания используют 13-значный код с префиксом 978 или 979 (за исключением поддиапазона 979-0). При анализе устаревшего формата ISBN-10 строка состоит из 10 символов, где последний контрольный знак рассчитывается по модулю 11 и может принимать цифровое значение от 0 до 9 либо буквенное обозначение
X(соответствует числу 10). - ISMN: международный номер нотных изданий формируется как 13-разрядный код, который безошибочно определяется по фиксированному стартовому префиксу 979-0.
- ISSN: восьмизначный идентификатор периодических печатных и электронных изданий. При генерации штрихкода на обложке он преобразуется в 13-разрядную структуру с префиксом 977, за которым следуют первые 7 цифр самого номера ISSN (без его исходной контрольной цифры по модулю 11), двухзначный код варианта цены или переиздания и общая контрольная цифра Mod 10.
Фармацевтические и медицинские стандарты
Фармацевтическая отрасль и производство медицинских изделий используют как собственные двоичные символики для упаковочных линий, так и строгие буквенно-цифровые шаблоны для клинического учета и защиты от фальсификата.
Базовый Pharmacode (включая двухдорожечный Two-Track Pharmacode) применяется на этапе фасовки для автоматической сверки инструкций, туб и вторичных коробок. В отличие от розничных кодов, он кодирует исключительно одно целое число в диапазоне от 3 до 131070 в двоичном представлении, не имеет стартовых и стоповых знаков, не содержит контрольной цифры и может считываться в обоих направлениях (зависит от настройки датчика на конвейере).
Для розничного и госпитального обращения лекарств применяются национальные и международные структуры данных:
-
Italian Pharmacode (Code 32): базируется на графике Code 39, но использует алфавит из 32 символов (цифры и заглавные согласные буквы, исключая
A,E,I,O,Uи цифру0во избежание визуальной путаницы). В открытом текстовом виде всегда представляет собой 9 цифр, где первый символ - ведущий ноль (или префиксAпри отображении на этикетке), а внутри штрихкода кодируется как 6 знаков в системе счисления с основанием 32. -
PZN7 и PZN8: немецкий фармацевтический номер товара на базе Code 39. Строка всегда начинается со знака минус (
-), за которым следуют 7 или 8 цифр. Последний разряд рассчитывается по взвешенному алгоритму Mod 11 (если остаток от деления равен 10, комбинация цифр считается невалидной и не присваивается). -
HIBC LIC и HIBC PAS: стандарты маркировки медицинских изделий. Коды HIBC отличаются обязательным стартовым символом плюс (
+). В структуре HIBC LIC за плюсом следует 4-буквенный идентификатор производителя (первый знак всегда латинская буква), код продукта (от 1 до 18 буквенно-цифровых знаков), одноразрядный индекс единицы измерения и контрольный символ по модулю 43. Вторичный код HIBC PAS (или объединенная строка через слэш/) содержит данные о сроке годности и номере партии. -
NTIN и PPN: в глобальных цепочках поставок национальные номера лекарств либо интегрируются в 14-разрядную структуру GTIN под видом NTIN (с сохранением национального номера внутри префикса страны), либо упаковываются в формат PPN. Код PPN использует синтаксис Data Matrix с внутренними макросами (префикс
06) и собственными идентификаторами данных:9Nдля самого регистрационного номера препарата,1Tдля партии иDдля даты истечения срока годности.
Национальные системы прослеживаемости: Честный ЗНАК и ЕГАИС
В государственных системах контроля оборота товаров используются двумерные штрихкоды со встроенной криптографической защитой. Хотя физическим носителем выступает стандартная матрица, тип кода определяется по жесткому составу полей и наличию проверочных ключей.
Контрольный идентификационный знак (КИЗ) системы Честный ЗНАК формируется на базе символики GS1 Data Matrix. Строка всегда начинается с управляющего символа
FNC1
и состоит из двух функциональных блоков: кода идентификации и кода проверки. Для товарных групп используются различные шаблоны длины и состава идентификаторов применения (AI):
-
Стандартный шаблон (обувь, одежда, шины, парфюмерия, фототовары, вода): включает
AI (01)с 14-значным GTIN,AI (21)с 13-символьным серийным номером, разделительGS(ASCII 29),AI (91)с 4-символьным идентификатором ключа проверки иAI (92)с 44-символьной (для молока и воды - 24-символьной в укороченных схемах без91/92, где используетсяAI (93)на 4 знака) криптоподписью в кодировке Base64. -
Лекарственные препараты (МДЛП): содержит
AI (01)(14 цифр),AI (21)(13 знаков),AI (91)(4 знака) иAI (92)(44 знака), при этом дополнительно в код могут включаться партияAI (10)и срок годностиAI (17). -
Табачная и никотинсодержащая продукция: для потребительской пачки применяется компактный обычный Data Matrix (или GS1 Data Matrix для групповой упаковки) без скобочных AI в первой части. Строка пачки состоит ровно из 29 символов: 14 цифр кода товара, 7 символов индивидуального серийного номера, 4 символа максимальной розничной цены (МРЦ) и 4 символа проверочного кода (или структура с
AI (93)).
Маркировка алкогольной продукции в системе ЕГАИС выполняется на федеральных специальных и акцизных марках с использованием форматов PDF417 или Data Matrix. В современном помарочном учете наносится матричный код Data Matrix, содержащий строку ровно из 150 символов: первые 22 знака (для старых марок 68 символов в PDF417) кодируют версию, тип, серию и номер марки в системе счисления Base36, а оставшиеся 128 символов (с 23 по 150 позицию) представляют собой криптографическую подпись ГОСТ в шестнадцатеричном или Base-представлении.
Автомобильные, оборонные и промышленные логистические стандарты
В автомобилестроении, тяжелой промышленности и оборонных поставках действуют стандарты этикетирования на базе Code 39, Code 128 и Data Matrix, использующие систему идентификаторов данных (Data Identifiers, DI) по стандарту ANSI MH10.8.2.
| Отраслевой стандарт | Базовая символика | Структурные признаки и префиксы (DI) | Назначение и особенности данных |
|---|---|---|---|
| VIN | Code 39 (без стартовых/стоповых знаков при прямой передаче) |
Фиксированная длина 17 символов; опциональный префикс импорта
I
(18 знаков)
|
Идентификационный номер транспортного средства. В строке строго запрещены латинские буквы
I
,
O
,
Q
. Девятая позиция - контрольный символ по модулю 11.
|
| VDA 4902 / Odette | Code 39, Code 128 |
Буквенные префиксы полей:
N
(номер накладной),
P
(артикул),
Q
(количество),
S
(серийный номер),
V
(код поставщика)
|
Европейский стандарт автомобильной логистики. Каждое поле на этикетке печатается отдельным линейным кодом со своим префиксом DI. |
| AIAG | Code 39, Code 128, PDF417, Data Matrix |
Идентификаторы ANSI:
1P
(деталь производителя),
K
(заказ),
1T
(партия),
3S
,
4S
(уникальный ID упаковки)
|
Североамериканский стандарт автопрома. В двумерных кодах строки объединяются через заголовок
[)>RS06GS
.
|
| LOGMARS | Code 39 | Обязательный контрольный символ Mod 43; плотность от 3.0 до 9.4 знаков на дюйм | Военно-логистическая спецификация министерства обороны США. Кодирует номенклатурные номера NSN (13 цифр) и номера контрактов. |
Почтовые символики и коды курьерских служб
Почтовые операторы применяют как стандартные штрихкоды с жесткими масками трек-номеров, так и специализированные высотные (4-state) символики, где данные кодируются не шириной штрихов, а их вертикальным смещением (верхний выносной элемент, нижний элемент, полный штрих и центральный трекер).
-
UPU S10: международный стандарт Всемирного почтового союза для регистрируемых отправлений (кодируется в Code 128 или Code 39). Текстовая строка имеет строгую длину 13 символов и маску
AA999999999AA: 2 заглавные латинские буквы кода сервиса (например,RA-RZдля заказных писем,CA-CZдля посылок,EA-EZдля экспресс-отправлений EMS), 8 цифр серийного номера, 1 контрольная цифра (рассчитывается по взвешенному алгоритму Mod 11 с весами 8, 6, 4, 2, 3, 5, 9, 7) и 2 буквы ISO-кода страны отправления. - POSTNET: числовая высотная символика почтовой службы США, состоящая из длинных и коротких вертикальных штрихов. Длина раскодированной строки составляет ровно 5 цифр (базовый ZIP), 9 цифр (ZIP+4) или 11 цифр (с кодом точки доставки), плюс одна обязательная контрольная цифра, дополняющая сумму всех разрядов до числа, кратного 10.
- USPS Intelligent Mail (IMb): 4-позиционный высотный код длиной 65 вертикальных штрихов, заменивший POSTNET. В числовом представлении содержит строку из 20, 25, 29 или 31 цифры: 2 цифры идентификатора штрихкода, 3 цифры типа сервиса, 6 или 9 цифр идентификатора отправителя, 9 или 6 цифр серийного номера и до 11 цифр почтового индекса маршрутизации.
- RM4SCC (Royal Mail 4-State Customer Code): британская 4-позиционная символика (на ее основе также работают нидерландский KIX и австралийский 4-state код). Кодирует только цифры и заглавные латинские буквы, включая британский почтовый индекс (от 5 до 7 знаков) и двухзначный суффикс точки доставки, завершаясь контрольным символом, который вычисляется по двумерной матрице четности верхних и нижних штрихов по модулю 6.
- Deutsche Post Identcode и Leitcode: специализированные модификации Interleaved 2 of 5, используемые немецкой почтой. Identcode всегда содержит 12 цифр (2 - код центра обработки, 3 - ID клиента, 6 - номер отправления и 1 контрольная цифра). Leitcode состоит из 14 цифр (5 - почтовый индекс, 3 - код улицы, 3 - номер дома, 2 - код продукта и 1 контрольная цифра). Оба формата отличаются от стандартного ITF-14 нестандартными весовыми коэффициентами при расчете контрольного числа Mod 10: вместо чередования 3 и 1 здесь применяются веса 4 и 9.
Анатомия и визуальные маркеры штрихкодов для ручного сопоставления
Когда проверка текстовой строки выдает сразу несколько подходящих стандартов, окончательно подтвердить тип маркировки помогает визуальный осмотр физического носителя. Например, простая последовательность из 12 цифр без специфических префиксов математически подходит под UPC-A, ITF, Code 128 или Code 39. Сопоставление графической структуры отпечатанного символа с характерными геометрическими признаками разных символик позволяет безошибочно отсечь лишние варианты.
Базовые элементы конструкции и размерность
Любой графический код строится из темных элементов (штрихов в 1D или модулей в 2D) и светлых промежутков (пробелов). Ключевой физический параметр здесь - размерность минимального элемента, обозначаемая как X-dimension. Это ширина самого узкого штриха или сторона одной ячейки матрицы, которая традиционно измеряется в милах (1 мил равен одной тысячной дюйма, или 0,0254 мм) либо в миллиметрах. Оценка X-dimension и пропорций остальных полос дает важную подсказку при идентификации:
- Двухширинные символики (такие как Code 39, ITF, Codabar) используют элементы только двух размеров: узкие и широкие. Визуально в таком коде легко заметить четкое, монотонное чередование тонких и толстых линий (обычно в пропорции 1:2 или 1:3).
- Многоширинные (модульные) символики (семейство EAN/UPC, Code 128, Code 93) формируют знаки из штрихов и пробелов четырех разных градаций ширины - кратно от 1X до 4X. Из-за этого графический рисунок выглядит более плотным и разнообразным по толщине полос.
Обязательным структурным элементом любой маркировки выступает зона молчания (Quiet Zone) - чистая белая рамка вокруг кода или светлые поля слева и справа от линейных штрихов. Она необходима для того, чтобы оптический сенсор отделил графический символ от внешнего фона и текста на упаковке. В розничных форматах EAN-13 и UPC-A целостность левой и правой зон молчания дополнительно подчеркивается вынесенными за пределы основных полос цифрами (индикатором системы счисления слева или знаком больше справа).
Визуальные маркеры линейных форматов
Линейные стандарты легко различить невооруженным глазом по архитектуре ограничительных линий и оформлению текстовой подписи под полосами (Human Readable Interpretation). При ручном осмотре этикетки внимание обращают на следующие детали:
- Удлиненные краевые и центральные разделительные штрихи: безошибочный признак розничного семейства EAN и UPC. В кодах EAN-13, EAN-8 и UPC-A по краям и ровно посередине расположены сдвоенные тонкие линии, которые выступают вниз заметно ниже остальных рабочих полос. Текстовая расшифровка цифр при этом аккуратно вписана в две образовавшиеся ниши между этими удлиненными ограничителями. В сжатом формате UPC-E центральный разделитель отсутствует, но сохраняются удлиненные штрихи слева и справа.
- Опорная черная рамка (Bearer Bars): характерный визуальный маркер логистического кода ITF-14 на гофрокоробах. Толстая сплошная черная линия опоясывает штрихкод по всему периметру (или проходит только сверху и снизу вплотную к полосам). Эта рамка нужна для выравнивания давления флексографского клише при печати на картоне, но при визуальном анализе она сразу выделяет ITF-14 среди других 14-значных кодов, таких как GS1-128.
- Выступающие стартовые и стоповые полосы без текста: встречаются в некоторых реализациях Pharmacode, где вообще нет цифровой подписи, а код состоит исключительно из одного ряда толстых и тонких вертикальных линий.
Паттерны поиска и выравнивания в двумерных кодах
Двумерные символики не имеют линейных направляющих, поэтому для ориентации камеры сканера в пространстве они используют специальные графические мишени - паттерны поиска (Finder Patterns) и синхронизации (Timing Patterns). Именно форма и расположение этих служебных фигур позволяют за секунду отличить один матричный стандарт от другого даже без считывания данных.
| Символика | Форма и расположение паттерна поиска | Дополнительные визуальные признаки |
|---|---|---|
| QR Code | Три крупных квадрата (концентрические рамки) по углам матрицы: в верхнем левом, верхнем правом и нижнем левом. | Четвертый (нижний правый) угол не имеет большого поискового квадрата, но в крупных версиях кода ближе к этому углу и по полю матрицы видны мелкие выравнивающие квадраты. |
| Micro QR и rMQR | Всего один поисковый квадрат в верхнем левом углу. | Micro QR всегда компактный и квадратный, тогда как rMQR имеет вытянутую прямоугольную форму с точечными маркерами по краям. |
| Data Matrix | Г-образный сплошной периметр (обычно образует левую и нижнюю границы символа). | Две противоположные стороны (верхняя и правая) выглядят как пунктирная линия - это паттерн синхронизации из чередующихся темных и светлых квадратов. Крупные коды делятся внутри на секции сплошными перекрестными линиями. |
| Aztec Code | Концентрические квадратные рамки («бычий глаз») строго в геометрическом центре кода. | Вокруг центрального квадратного ядра расположены мелкие угловые маркеры ориентации. В отличие от многих других форматов, Aztec Code не требует видимой белой зоны молчания по краям. |
| MaxiCode | Концентрические круглые кольца (круглая мишень) в центре символа. | Вместо квадратных пикселей данные вокруг центральной круглой мишени закодированы массивом шестиугольных ячеек, напоминающих пчелиные соты. Размер кода всегда фиксированный. |
| PDF417 и MicroPDF417 | Широкие вертикальные стартовые и стоповые колонки штрихов по левому и правому краям. | Код выглядит как таблица из нескольких поставленных друг на друга узких линейных штрихкодов. В MicroPDF417 боковые ограничительные полосы заметно уже или заменены центральными колонками. |
| DotCode | Специальные выделенные поисковые фигуры отсутствуют. | Прямоугольный массив из отдельных круглых точек, расположенных по диагональной сетке (как черные клетки на шахматной доске), где по углам предусмотрены свободные от точек позиции. |
Сочетание анализа структуры текстовой строки с визуальной проверкой этих графических маркеров исключает неоднозначность. Если 13-значный числовой код имеет контрольную сумму по модулю 10, но на этикетке у него нет удлиненных центральных и краевых штрихов, перед вами не розничный EAN-13, а строка GTIN-13, отпечатанная в другой линейной символике (например, в Code 128 для внутреннего складского учета).