Онлайн-инструмент позволяет извлекать текстовые данные и коды из изображения в один проход, преобразуя статические растровые файлы в редактируемую и машиночитаемую информацию. В качестве входных данных используются фотографии, сканы документов и скриншоты, содержащие как печатные или рукописные блоки, так и графические идентификаторы. Вместо ручного перепечатывания реквизитов и применения физических сканеров пользователь загружает графический файл и получает готовый к копированию результат. Это решает прикладную задачу быстрой оцифровки накладных, кассовых чеков, транспортных этикеток и электронных билетов.
Внутри одного графического файла текстовые блоки и штрихкоды обрабатываются принципиально разными вычислительными методами.
Для считывания букв, цифр и знаков препинания применяется технология OCR, которая анализирует пиксельную сетку, выделяет контуры отдельных глифов и сопоставляет их с символами заданного алфавита. Чтение 1D и 2D символик опирается на прямое алгоритмическое декодирование геометрических элементов. Программный модуль находит опорные метки на изображении, вычисляет ширину чередующихся штрихов и пробелов в линейных кодах (например, EAN-13 или Code 128) либо считывает бинарную сетку в матричных стандартах (таких как QR Code, Data Matrix или PDF417). Математические алгоритмы коррекции ошибок восстанавливают зашифрованную последовательность даже при частичном повреждении или размытии исходной картинки.
Итогом обработки становится разделенный и структурированный набор строковых данных. Графические области с текстом конвертируются в обычный редактируемый текст с сохранением логического порядка строк, а распознанные кодовые таблицы возвращают точную полезную нагрузку - от товарных артикулов и кодов маркировки до URL и текстовых контейнеров.
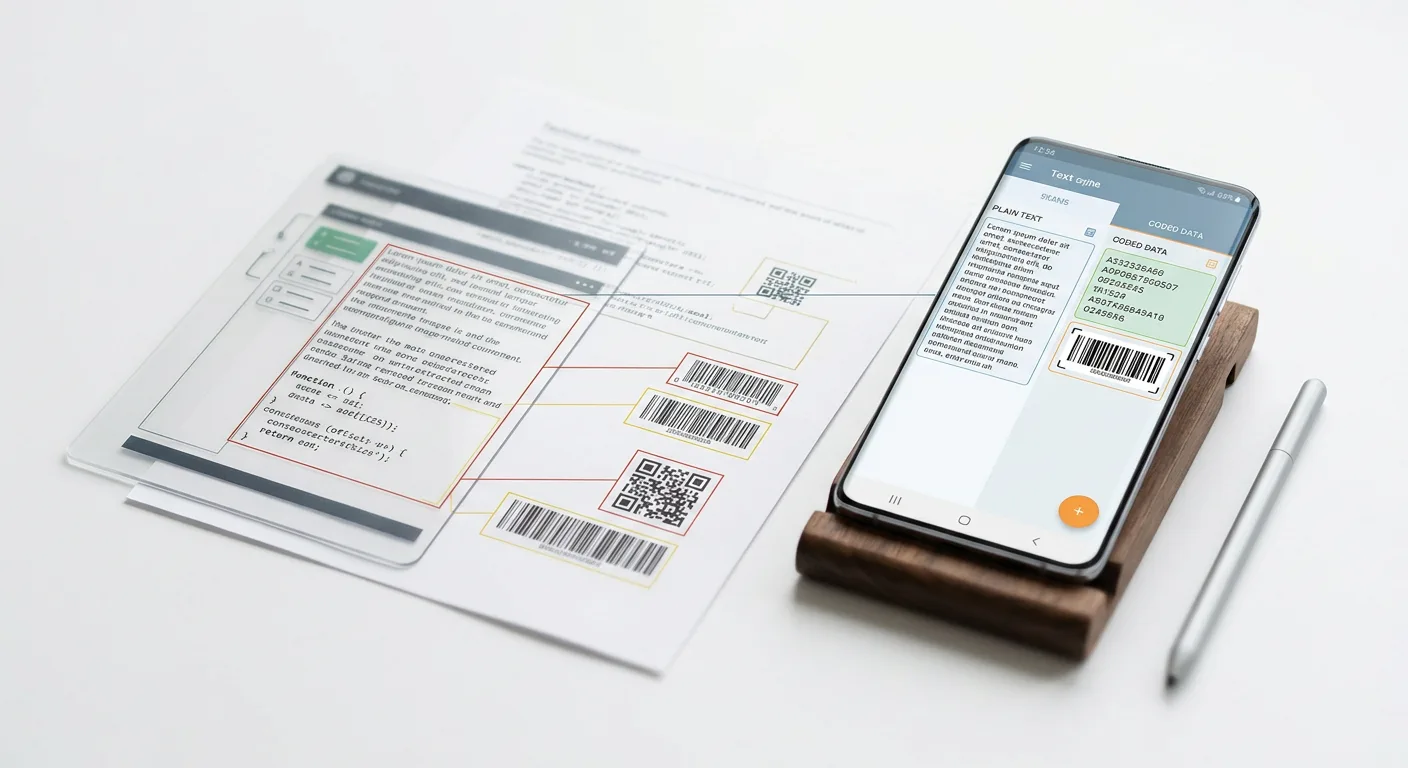
Принципы оптического распознавания текста (OCR) на изображениях
Механика извлечения текста по технологии OCR строится на последовательном анализе растровой матрицы и переводе графических очертаний в цифровые символьные коды. На первом этапе выполняется обнаружение текстовых областей на изображении. В рамках этой операции рабочее поле делится на функциональные зоны: массивы символов отделяются от фоновых текстур, фотографий, табличных рамок, печатей и графических кодов. Это позволяет локализовать блоки данных и определить общую топологию документа, включая многоколоночную верстку, врезки и колонтитулы.
После локализации текстовых блоков запускается процесс иерархической сегментации, который разбивает найденные области на составные элементы по следующим уровням:
- Выделение строк - определение базовых горизонтальных или наклонных линий, вдоль которых выстроены последовательности знаков, и расчет межстрочных интервалов.
- Сегментация слов - разделение непрерывной строки на отдельные лексические единицы на основе анализа широких пробельных зон между группами пикселей.
- Изоляция символов - кадрирование каждого отдельного знака в индивидуальную ограничивающую рамку по вертикальным и горизонтальным проекциям плотности закрашенных точек.
Когда отдельный глиф изолирован, выполняется извлечение его геометрических и топологических признаков. Анализируется структура начертания: количество и направление прямых линий, дуг, замкнутых контуров, точек пересечения, концевых элементов и углов наклона. При матричном сопоставлении пиксельная сетка глифа накладывается на эталонные шаблоны, а при структурном анализе оценивается взаимное расположение векторных примитивов. Итогом интерпретации глифа становится присвоение ему конкретного числового кода из стандартизированной таблицы символов, такой как Unicode.
Особенности работы с печатным и рукописным текстом
Вычислительная сложность интерпретации глифов напрямую зависит от способа нанесения текста на исходный носитель. Обработка типографских шрифтов и распознавание рукописных записей по технологии Handwriting OCR опираются на разные подходы к сегментации и анализу связности символов.
Ключевые различия при обработке машинописного и рукописного текста представлены в таблице:
| Параметр анализа | Печатный текст | Рукописный текст (Handwriting OCR) |
|---|---|---|
| Геометрия глифов | Строгая стандартизация пропорций, высоты знаков и толщины штрихов в рамках гарнитуры | Высокая вариативность начертаний, нестабильный наклон и разный размер одних и тех же букв |
| Межсимвольные границы | Четкие дискретные отступы между соседними знаками в слове | Слитное написание с непрерывными соединительными штрихами или наложением элементов |
| Базовая линия строки | Прямая и предсказуемая ориентация относительно краев документа | Плавающая траектория строки с возможным смещением вверх или вниз |
| Метод интерпретации | Посимвольное сопоставление изолированных контуров с признаками шрифтовых эталонов | Распознавание целых слов или фрагментов строк без жесткого предварительного разрезания на буквы |
В задачах Handwriting OCR различают печатное рукописное письмо, когда человек вписывает раздельные буквы в клеточки бланка или анкеты, и курсивное письмо. При курсивном начертании прямая сегментация на отдельные символы до этапа распознавания часто невозможна, поэтому анализируется непрерывная траектория штриха и контекст всего слова.
Учет алфавитов, спецсимволов и сложных текстовых структур
Точность перевода пиксельных данных в символьные коды требует строгого учета языковых моделей и типографских особенностей текста. При совместном или раздельном распознавании кириллицы и латиницы основной задачей становится разрешение проблемы омоглифов - символов из разных алфавитов и цифрового ряда, имеющих идентичное или крайне схожее графическое начертание.
Классическими примерами таких визуальных совпадений выступают кириллическая и латинская буквы «С», «А», «Е», «О», «Р», «Х», а также буква «З» и цифра «3» или буква «О» и цифра «0». Для выбора правильного кода из таблицы символов анализируется окружение знака: если внутри слова преобладают уникальные кириллические глифы (например, «Д», «Ж», «И», «Ы»), то и спорный символ кодируется в кириллическом диапазоне.
Помимо базовых алфавитных знаков, при анализе графической матрицы учитываются специфические элементы письма и верстки:
- Диакритические знаки - надстрочные, подстрочные и внутристрочные элементы (точки над «ё», краткая дуга в «й», умлауты, акуты, грависы и седили в латинице). Поскольку такие элементы физически оторваны от основного контура буквы, при вертикальной сегментации они связываются с базовым глифом в единый символ, а не отбрасываются как мелкий графический дефект.
- Типографские лигатуры - слитное написание двух или более букв в виде одного графического знака (например, сочетания «fi», «fl», «ff», «æ»). При сегментации лигатура выделяется как единый неделимый контур, но на этапе перевода в текст раскладывается на соответствующую последовательность отдельных символьных кодов.
- Сложные текстовые структуры - составные элементы верстки, включая многоуровневые таблицы, списки с маркерами, дробные значения, верхние и нижние индексы, а также сноски. При обработке таких участков фиксируются пространственные координаты каждого текстового фрагмента, что позволяет отделить основное содержание от вспомогательных индексов и не допустить слияния текста из соседних столбцов в одну непрерывную строку.
Декодирование линейных и матричных кодов: типы и спецификации
В отличие от чтения буквенно-цифровых глифов, расшифровка графических кодов опирается на строгие геометрические пропорции и бинарную логику. Кодовая символика представляет собой зашифрованную по определенному стандарту последовательность битов, где темные элементы (штрихи или модули) соответствуют логическим единицам, а светлые участки (пробелы) - нулям. Для перевода такого графического паттерна в текстовую или числовую строку вычисляются пространственные соотношения между элементами, а не внешнее сходство контуров с алфавитными эталонами.
Все машиночитаемые символики делятся на две фундаментальные группы в зависимости от способа размещения информации на плоскости: одномерные (1D) и двумерные (2D).
Одномерные линейные штрихкоды
Линейные 1D символики кодируют данные только в одном направлении - по горизонтали. Информация закладывается в чередование вертикальных черных штрихов и белых пробелов различной ширины. Высота полос не несет информационной нагрузки и делается достаточной лишь для того, чтобы линия сканирования пересекла все элементы кода даже при небольшом наклоне.
При анализе растрового изображения вдоль выбранной горизонтальной оси строится профиль яркости пикселей. На основе этого графика измеряется ширина самого узкого элемента (базового модуля или X-размера), после чего ширина всех остальных штрихов и пробелов выражается как кратное этому модулю значение (например, 1X, 2X, 3X или 4X). Полученная числовая последовательность сопоставляется с таблицей спецификации конкретного стандарта.
В зависимости от назначения и структуры данных применяются различные спецификации 1D кодов:
- EAN-13 и EAN-8 - товарные символики фиксированной длины (13 и 8 цифр соответственно), где каждый символ кодируется двумя штрихами и двумя пробелами суммарной шириной в семь модулей. Содержат стартовые, центральные и финальные разделительные знаки, определяющие границы чтения.
- UPC-A - 12-значный числовой стандарт для розничной торговли, структурно схожий с EAN-13, в котором ведущий нулевой разряд кода страны опускается при визуальном отображении.
- Code 128 - высокоплотный линейный стандарт, способный кодировать все 128 символов таблицы ASCII за счет переключения между тремя внутренними наборами знаков (A, B и C). В наборе C пары цифр сжимаются в один кодовый знак, что сокращает физическую длину штрихкода.
- Code 39 - дискретная буквенно-цифровая символика, в которой каждый знак состоит из девяти элементов (пять штрихов и четыре пробела), при этом три из них всегда широкие, а шесть - узкие. Границы кода обозначаются специальным стартовым и стоповым символом (обычно в виде звездочки).
- ITF-14 - непрерывный числовой код для транспортной упаковки, использующий принцип чередования «два из пяти». Цифры кодируются попарно: нечетная позиция записывается в ширину пяти черных штрихов, а четная - в ширину пяти белых пробелов, расположенных между этими штрихами. Код часто обрамляется толстой черной прямоугольной рамкой (опорными линиями).
- Codabar - специализированный дискретный стандарт, кодирующий цифры от 0 до 9, шесть специальных знаков и четыре служебных символа старта/стопа (A, B, C, D). Использует элементы двух или трех градаций ширины и не требует обязательного контрольного разряда.
Двумерные матричные и стековые символики
Двумерные 2D коды распределяют данные сразу по двум осям - горизонтали и вертикали. За счет этого на площади в несколько квадратных сантиметров размещаются сотни и тысячи символов. Вместо измерения ширины полос при чтении 2D кода на изображение накладывается координатная сетка, в узлах которой проверяется цвет каждого отдельного квадратного или прямоугольного модуля.
Для точной ориентации сетки в пространстве и определения размерности кода в структуру 2D символик встраиваются жестко заданные позиционные метки (паттерны поиска и синхронизации). В таблице ниже приведены конструктивные особенности основных двумерных стандартов, определяющие механику их поиска и декодирования.
| Стандарт 2D кода | Архитектура и элементы позиционирования | Принцип считывания матрицы | Специфика кодирования и защиты данных |
|---|---|---|---|
| QR Code | Три крупных квадратных паттерна поиска с соотношением чередования черных и белых зон 1:1:3:1:1 по углам матрицы (кроме правого нижнего) и дополнительные выравнивающие маркеры для крупных версий. | По трем угловым меткам вычисляется угол поворота и наклон плоскости. Между поисковыми квадратами проходит пунктирная полоса синхронизации, задающая шаг координатной сетки для чтения битовых блоков. | Поддерживает числовой, буквенно-цифровой, побайтовый и кандзи режимы. Для устранения регулярных пустот на матрицу накладывается битовая маска, код которой хранится рядом с поисковыми метками. |
| Data Matrix | Сплошная L-образная рамка (граница поиска) по левому и нижнему краю кода, дополненная пунктирной чередующейся рамкой (дорожкой синхронизации) сверху и справа. | Сплошной угол фиксирует ориентацию кода, а подсчет черных и белых клеток на противоположных пунктирных сторонах определяет точное количество строк и столбцов матрицы. | Данные записываются компактными фигурными блоками (углами) из восьми бит. Крупные матрицы делятся внутренними разделительными линиями на несколько подматриц (регионов данных). |
| PDF417 | Многострочный стековый код, состоящий из поставленных друг на друга миниатюрных линейных штрихкодов. Ограничен широкими полосами старта слева и стопа справа. | Каждая строка считывается как последовательность кодовых слов. Каждое слово состоит из 17 модулей, разделенных ровно на 4 штриха и 4 пробела. Крайние служебные столбцы содержат номер строки и общее число рядов. | Позволяет считывать строки не по порядку благодаря встроенным индикаторам ряда, после чего разрозненные фрагменты собираются в единый массив данных. |
| Aztec | Центральная мишень («бычий глаз») из вложенных друг в друга квадратных контуров, окруженная по углам ориентационными метками в один пиксель и пунктирной сеткой для больших размеров. | Поиск начинается из центра изображения наружу. Угловые маркеры вокруг центральной мишени задают направление обхода, а данные считываются по спирали против или по часовой стрелке от центра к краям. | Не требует обязательной светлой свободной зоны вокруг внешних границ кода, что позволяет размещать его вплотную к тексту или графическим рамкам. |
Контрольные суммы и алгоритмы коррекции ошибок
При чтении кодовых последовательностей с графических файлов часть элементов может оказаться нечитаемой из-за перекрытия посторонними предметами, потертостей на этикетке или дефектов печати. Механизмы защиты от сбоев принципиально различаются для линейных и матричных стандартов.
В 1D штрихкодах применяется проверка целостности через контрольный разряд (например, по алгоритму Луна или модулю 10 в кодах EAN/UPC, либо по модулю 103 в Code 128). Последний символ кода не несет товарной информации, а является математическим результатом сложения и умножения предыдущих цифр по строгой формуле. Если при считывании штрихов один из элементов распознан неверно, вычисленная контрольная сумма не совпадет с записанной в конце штрихкода. Это блокирует выдачу ошибочного результата, но не дает возможности восстановить поврежденный символ без повторного сканирования другого участка полос.
В двумерных символиках (QR Code, Data Matrix, PDF417, Aztec) используется математический аппарат избыточного кодирования на базе алгоритма Рида-Соломона. При генерации 2D кода к исходным байтам данных прикрепляется массив проверочных кодовых слов (байтов коррекции), вычисленных с помощью полиномиальной арифметики над конечными полями Галуа. Эти избыточные биты равномерно распределяются по площади матрицы.
Если на изображении участок 2D кода затерт или закрыт, при считывании бинарной сетки в последовательности образуются пропуски или ложные биты. Алгоритм декодирования составляет систему уравнений на основе уцелевших блоков и проверочных кодовых слов, находит позиции искаженных байтов и математически вычисляет их исходные значения. За счет этого закодированная строка полностью восстанавливается даже при физической утрате значительной части графических модулей матрицы.
Этапы обработки изображения и факторы точности распознавания
Способность математических алгоритмов восстанавливать поврежденные кодовые слова или сопоставлять контуры символов напрямую зависит от качества растровой матрицы, поступающей на вход анализатора. Перед тем как приступить к выделению глифов или чтению штрихов, компьютерное зрение переводит пиксельный массив из исходного цветового пространства в подготовленную геометрическую и яркостную структуру. Итоговый коэффициент распознавания складывается из физических параметров исходного снимка и точности выполнения промежуточных этапов цифровой фильтрации.
Влияние характеристик исходного файла на извлечение данных
Растровое изображение представляет собой сетку пикселей, где каждый элемент обладает координатами и значениями яркости по цветовым каналам. Отклонения при съемке или сканировании приводят к тому, что границы объектов размываются, а полезный сигнал смешивается с фоном. В таблице ниже приведены основные характеристики графического файла и характер их воздействия на чтение текста и кодовых символик.
| Параметр или дефект изображения | Воздействие на OCR текстовых блоков | Воздействие на декодирование 1D и 2D кодов |
|---|---|---|
| Низкое разрешение и плотность точек (DPI) | Ступенчатость контуров, слияние близко расположенных букв, исчезновение тонких засечек, знаков препинания и диакритических элементов. | Нарушение пропорций между узкими и широкими штрихами в 1D кодах; превращение мелких модулей 2D матрицы в единое серое пятно. |
| Низкая контрастность и неравномерная экспозиция | Слияние светлого или выцветшего шрифта с текстурой бумаги, пропуск целых слов или строк при выделении границ символов. | Невозможность достоверно отличить темный модуль (логическую единицу) от светлого поля (логического нуля) при формировании битовой сетки. |
| Цифровой шум и артефакты сжатия | Появление ложных точек вокруг букв, которые ошибочно интерпретируются как точки, запятые, дефисы или изменяют геометрию глифа (например, превращают «с» в «е»). | Образование ложных темных модулей на светлых участках матрицы, перегружающее лимит коррекции ошибок в 2D символиках. |
| Оптическое размытие и смазывание | Размывание границ штриха, взаимное наложение соседних символов, потеря внутренних просветов в замкнутых буквах («о», «а», «в»). | Заплывание темных полос на соседние светлые пробелы, что искажает расчетную ширину элементов линейного штрихкода. |
| Световые блики и глубокие тени | Локальное выгорание пикселей до чисто белого цвета, приводящее к полному физическому исчезновению фрагментов букв в зоне засветки. | Разрушение позиционных меток и нарушение целостности свободной зоны вокруг кода, из-за чего границы символики не детектируются. |
| Поворот и перспективные искажения | Наклон строк препятствует построчной нарезке текста; съемка под острым углом меняет пропорции символов по краям кадра. | Прямоугольная или квадратная матрица превращается в трапецию, что смещает узлы координатной сетки при попытке считывания битов. |
Цифровая предобработка в компьютерном зрении
Для компенсации оптических дефектов перед запуском распознавания изображение проходит конвейер геометрических и яркостных преобразований. Задача этого процесса - удалить избыточную цветовую информацию, выровнять пропорции объектов и оставить только четкие контуры символов и кодовых модулей.
Технологический цикл подготовки графического файла и последующей доводки результата включает следующие этапы:
- Приведение к градациям серого и бинаризация. Цветное изображение переводится в одноканальный режим яркости, после чего каждый пиксель становится строго черным или строго белым. При равномерном освещении применяется глобальный порог яркости. Если на снимке присутствуют тени, градиенты или блики, используется адаптивная бинаризация (например, по методам Оцу или Сауволы): пороговое значение вычисляется индивидуально для каждого малого участка на основе яркости соседних пикселей.
- Подавление шумов и морфологическая фильтрация. На бинарном изображении удаляются изолированные пиксели и мелкие пятна, возникшие из-за зернистости матрицы камеры или текстуры бумаги. С помощью операций морфологического замыкания и размыкания сглаживаются рваные края штрихов, заполняются микроразрывы внутри линий букв и разделяются случайно слипшиеся соседние глифы.
- Выравнивание геометрии и коррекция перспективы. Математический анализ углов наклона позволяет обнаружить перекос документа. Вычисление проекционного профиля яркости или преобразование Хафа помогает определить базовые линии текста и повернуть холст строго горизонтально. При перспективных искажениях по опорным точкам (краям листа или позиционным квадратам 2D кода) строится матрица гомографии, которая растягивает и трансформирует трапециевидную область обратно в плоский прямоугольник.
- Сегментация данных и зонирование макета. На выровненном бинарном полотне отделяются разнородные информационные блоки. Алгоритмы анализа макета отсекают фоновые линии, рамки таблиц и декоративные элементы, после чего разделяют области с плотным регулярным чередованием контрастных элементов (штрихкоды и матричные коды) и массивы текстовых строк, направляя каждый тип данных на свой профиль декодирования.
- Постобработка для коррекции ошибок распознавания. На завершающем этапе первичные результаты извлечения текста проходят верификацию. Поскольку после оптического анализа визуально схожие графемы могут путаться между собой (например, цифра «0» и буква «О», цифра «1», латинская «I» и строчная «l», кириллическая «З» и цифра «3»), применяется словарный и контекстный контроль. Сопоставление полученных цепочек символов с лексическими словарями, морфологическими правилами языка и регулярными выражениями устраняет единичные подмены знаков в итоговой текстовой выдаче.
Интерпретация извлеченных текстовых данных и расшифрованных последовательностей
Завершение оптического анализа и декодирования переводит визуальные элементы изображения в символьное представление. На выходе формируются два типа данных: редактируемый текстовый массив, снятый с текстовых блоков, и строковая полезная нагрузка (payload), извлеченная из линейных или матричных символик. Хотя оба результата представлены цепочками символов в стандартной текстовой кодировке, принципы их внутренней организации и правила чтения существенно различаются.
Структура и организация распознанного текста
Результат перевода растровых символов в редактируемые строки опирается на пространственную геометрию исходного документа. Чтобы полученный текст сохранял связность и читаемость, при формировании выходного потока воспроизводится логический порядок чтения (reading order). В документах со стандартной версткой текстовые блоки выстраиваются сверху вниз и слева направо. Если исходный макет содержал многоколоночную верстку, правильная интерпретация координат текстовых рамок предотвращает склеивание соседних колонок в одну нечитаемую строку: сначала последовательно выводится содержимое левого столбца, затем - правого.
Базовая структурная разметка переносится в текстовый поток с помощью управляющих и пробельных символов:
- Абзацное членение формируется путем расстановки символов возврата каретки и перевода строки в тех местах, где на изображении зафиксирован разрыв текстового блока, увеличенный межстрочный интервал или красная строка.
- Внутристрочные отступы и выравнивание элементов, удаленных друг от друга по горизонтали (например, в парах «наименование - значение» или строках простых списков), передаются последовательностями пробелов или символами горизонтальной табуляции.
- Разрывы слов при переносах на новую строку сопоставляются на уровне границ строк, что помогает отличить дефис в сложносоставных словах от знака переноса.
Полученный текстовый массив пригоден для прямого копирования, контекстного поиска, редактирования в текстовых редакторах или извлечения отдельных реквизитов по ключевым словам.
Расшифровка полезной нагрузки (payload) кодовых символик
В отличие от свободного текста, результатом чтения 1D и 2D кодов является строго детерминированная строка - полезная нагрузка (payload). Сам графический носитель выступает лишь транспортом для байтовой, цифровой или буквенно-цифровой последовательности, а смысловая интерпретация этой строки целиком зависит от прикладного стандарта, по которому она была сформирована.
Товарные и издательские идентификаторы
Линейные штрихкоды розничной и логистической номенклатуры возвращают фиксированные числовые комбинации. Считанная последовательность цифр представляет собой глобальный номер товарной продукции GTIN. Для книжных и периодических изданий в структуру этого номера интегрированы отраслевые идентификаторы ISBN и ISSN (через выделенные префиксы 978, 979 и 977 соответственно). В такой строке нет прямого текстового описания предмета - числовой код служит уникальным ключом для запроса карточки товара в учетной системе или каталоге, а последняя цифра всегда выступает контрольным числом для математической проверки целостности считанного номера.
Спецификации GS1 и коды маркировки
В логистических, складских и регуляторных задачах внутри линейных (Code 128) или матричных (Data Matrix, QR Code) символик передаются составные строки по стандарту GS1. Их особенность заключается в использовании идентификаторов применения (Application Identifiers) - числовых префиксов из двух-четырех цифр, которые определяют назначение следующего за ними поля данных. В визуальном представлении такие префиксы часто заключаются в круглые скобки, а в «сырой» расшифрованной строке поля переменной длины отделяются специальным непечатаемым символом-разделителем (ASCII 29).
Аналогичную структуру имеют коды цифровой прослеживаемости в системе Честный Знак, записанные в формате Data Matrix. Расшифрованная строка такого кода не является случайным набором знаков, а распадается на строго регламентированные сегменты:
- Префикс 01 и следующие за ним 14 цифр - глобальный код товара GTIN.
- Префикс 21 и переменная цепочка символов - индивидуальный серийный номер конкретного экземпляра продукции.
- Дополнительные поля с префиксами 91, 92 или 93 - ключ и код проверки (криптохвост), используемые для подтверждения подлинности кода.
Структурированные форматы данных в 2D кодах
Матричные символики вмещают до нескольких тысяч символов, что позволяет кодировать в них готовые к выполнению инструкции, метаданные и микроформаты. Тип содержимого определяется по начальному префиксу (схеме) расшифрованной строки. В таблице ниже приведены основные форматы полезной нагрузки и правила их чтения.
| Тип данных в payload | Характерный префикс или маркер строки | Структура и интерпретация содержимого |
|---|---|---|
| Веб-адрес (URL) |
http://
или
https://
|
Полный сетевой адрес ресурса, включая доменное имя, путь к странице и GET-параметры после знака вопроса. Применяется для прямого перехода к веб-страницам и онлайн-реестрам. |
| Электронная визитка (vCard) |
BEGIN:VCARD
...
END:VCARD
|
Многострочный текстовый блок, где каждое поле начинается с тега свойства:
FN:
(полное имя),
TEL:
(телефон),
EMAIL:
(почта),
ORG:
(организация),
ADR:
(адрес).
|
| Параметры подключения к сети (Wi-Fi SSID) |
WIFI:
|
Стандартизированная строка с ключами через точку с запятой:
S:
указывает имя сети (Wi-Fi SSID),
T:
задает тип шифрования (например, WPA или WEP),
P:
содержит пароль доступа,
H:
отмечает скрытый статус сети.
|
| Произвольный текстовый контейнер | Отсутствует фиксированная схема | Любая неформатированная строка символов, JSON-объект, XML-структура, внутренний артикул предприятия или реквизиты, разделенные вертикальной чертой либо точкой с запятой. |
При анализе результатов распознавания сопоставление обычного текста и расшифрованных кодов позволяет провести перекрестную проверку данных. Например, числовое значение GTIN или серийного номера, полученное путем декодирования графической матрицы, можно сверить с дублирующей текстовой подписью (Human Readable Interpretation), которая была прочитана с того же изображения оптическим методом.
Практические сценарии извлечения текста и кодов из графических файлов
Одновременное или раздельное извлечение текстовых строк и машиночитаемых кодов из одного графического файла востребовано там, где бумажный или экранный носитель объединяет визуальную информацию для человека и идентификаторы для автоматизированных систем учета. Такая обработка избавляет от ручного перепечатывания длинных символьных последовательностей и позволяет сопоставить текстовое описание объекта с данными, зашифрованными в графической матрице или штриховом коде.
Оцифровка первичных учетных документов и товарных накладных
В бухгалтерском и складском документообороте сканы и фотографии товарных накладных, актов приема-передачи и счетов-фактур содержат два типа данных: таблично-текстовую часть и штриховой код документа. Текстовая область включает наименования контрагентов, налоговые идентификаторы, даты, номенклатурные позиции, количество и итоговые суммы. В верхнем или нижнем колонтитуле таких бланков часто размещается линейный код (например, Code 128, Code 39 или ITF-14), в котором зашифрован внутренний регистрационный номер документа в учетной базе или идентификатор грузовой партии.
При обработке изображения накладной оптическое распознавание применяется для перевода табличных строк и реквизитов в редактируемый вид, а декодирование штрихкода дает точный уникальный ключ документа без риска опечатки. Если какой-либо символ в печатном номере бланка поврежден штампом, подписью или проколом от дырокола, значение, извлеченное из штрихового кода, служит достоверным эталоном для восстановления номера и привязки документа к карточке сделки.
Извлечение реквизитов и QR-кодов с кассовых чеков и квитанций
Фотографии кассовых чеков и платежных квитанций часто имеют низкую контрастность из-за выцветания термобумаги, заломов или неравномерного освещения при съемке. Для авансовых отчетов, сверки расходов и внесения платежей в таблицы учета с такого изображения требуется получить перечень покупок, дату операции и фискальные признаки, а также расшифровать двумерный матричный код.
При комплексной обработке снимка чека или квитанции извлекаются два взаимодополняющих набора сведений:
- Из текстового блока считываются названия приобретенных товаров или услуг, цены за единицу, примененные скидки, наименование продавца и номер кассовой смены.
- Из матричного QR Code на кассовом чеке извлекается компактная строка фискальных параметров, включающая дату и время расчета, итоговую сумму, заводской номер накопителя, порядковый номер документа и числовой фискальный признак.
- Из платежного QR Code на банковской квитанции или счете на оплату декодируется структурированная строка с расчетным счетом получателя, реквизитами банка, кодом бюджетной классификации, назначением платежа и суммой перевода.
Даже если часть мелкого шрифта на термобумаге стерлась и не поддается оптическому чтению, расшифрованная строка из матричного кода позволяет точно установить ключевые параметры транзакции или скопировать банковские реквизиты без ручного ввода двадцатизначных счетов.
Захват данных со скриншотов электронных билетов и посадочных талонов
Маршрутные квитанции, электронные билеты на мероприятия и посадочные талоны нередко сохраняются пользователями в виде скриншотов экрана смартфона или растровых вложений из электронной почты. На таких изображениях визуальная памятка для пассажира или посетителя соседствует с плотным двумерным кодом стандартов PDF417 или Aztec, принятых в транспортной индустрии и системах контроля доступа.
Оптическое распознавание текстового слоя со скриншота позволяет скопировать в календарь или путевой лист читаемые детали поездки: номер рейса или поезда, время отправления, терминал, выход на посадку и место в салоне. Отдельное декодирование матрицы PDF417 или Aztec возвращает стандартизированную строку данных посадочного талона, где в фиксированных позициях без разделителей или с служебными префиксами записаны фамилия и имя пассажира латиницей, шестизначный код бронирования, трехбуквенные коды аэропортов вылета и прилета, код перевозчика, дата рейса и порядковый номер регистрации. Извлечение этой строки используется при проверке корректности формирования билета, переносе кода бронирования в сторонние сервисы отслеживания перелетов или архивировании проездных документов для командировочной отчетности.
Считывание артикулов и серийных номеров с транспортных этикеток и промышленных шильдиков
При инвентаризации оборудования, приемке комплектующих и ведении каталогов запчастей исходным материалом часто служат фотографии логистических наклеек на коробках, заводских этикеток на кабелях и металлических или полимерных шильдиков на корпусах приборов. Подобные носители сочетают текстовую техническую спецификацию и компактную кодовую маркировку, нанесенную методом термотрансферной печати, лазерной гравировки или ударно-точечного клеймения.
В таблице ниже представлено распределение данных между текстовой областью и кодовыми элементами для типовых графических источников при складском и производственном учете.
| Тип исходного изображения | Данные, извлекаемые из текстовых блоков | Символика и содержание кодовой последовательности |
|---|---|---|
| Товарная накладная или упаковочный лист | Наименования поставщика и грузополучателя, таблица товаров, единицы измерения, вес брутто и нетто, итоговые суммы. | Code 128, Code 39, ITF-14: уникальный идентификатор документа в учетной системе, номер отгрузки или групповой упаковки. |
| Кассовый чек или платежная квитанция | Перечень товарных позиций, стоимость, ставка налога, адрес точки расчета, фамилия кассира. | QR Code: строка фискальных реквизитов операции либо набор банковских реквизитов получателя для формирования платежного поручения. |
| Скриншот посадочного талона или билета | Дата и время отправления, название перевозчика, номер места, класс обслуживания, правила тарифа. | PDF417, Aztec: машиночитаемая строка с кодом бронирования, маршрутом, идентификатором рейса и данными пассажира. |
| Транспортная или складская этикетка | Почтовый адрес доставки, условия транспортировки, номер заказа, текстовое описание вложения. | Code 128, EAN-13, Data Matrix: логистический трек-номер отправления, код контейнера, глобальный товарный номер GTIN и номер партии. |
| Промышленный шильдик оборудования | Модель устройства, параметры электропитания, класс защиты, страна и дата производства, масса изделия. | Data Matrix, QR Code, Code 39: заводской серийный номер экземпляра, аппаратная ревизия платы, MAC-адрес сетевого интерфейса или каталожный артикул детали. |
При работе с фотографиями шильдиков и кабельных бирок раздельное применение двух методов чтения решает проблему трудночитаемых шрифтов. На металлических пластинах символы могут бликовать, а выбитые цифры вроде нуля и буквы «О» либо единицы и латинской «I» визуально практически неразличимы. Декодирование расположенного рядом матричного кода Data Matrix выдает безошибочную строку серийного номера и артикула, тогда как текстовое распознавание захватывает сопутствующие эксплуатационные характеристики (напряжение, мощность, температурный диапазон), которые не дублируются внутри матричного кода.