Анализ адреса страницы URL предназначен для точного разбора введенной веб-строки на составные технические компоненты. Инструмент принимает исходную ссылку и фрагментирует её на логические сегменты. Результатом работы является структурированная сводка, где каждый элемент выведен в отдельное поле для проверки.
Процесс начинается с проверки синтаксиса. Алгоритм контролирует корректность разделителей и соответствие структуры стандартам. После этого происходит последовательное извлечение схемы, основного доменного имени, сетевого порта и пути к конечному файлу или директории.
Отдельный вычислительный этап направлен на оценку валидности применяемых кодировок и обработку динамических параметров запроса. Алгоритм распознает URL-кодирование, конвертируя экранированные спецсимволы в исходные текстовые значения. Строка параметров, расположенная после вопросительного знака, разбивается на изолированные пары ключ-значение. Это позволяет точно определить переданные переменные и метки отслеживания.
Структурированный вывод извлеченных данных помогает выявить ошибки формирования ссылок до отправки HTTP-запроса. Точная сегментация исключает аппаратные сбои маршрутизации.
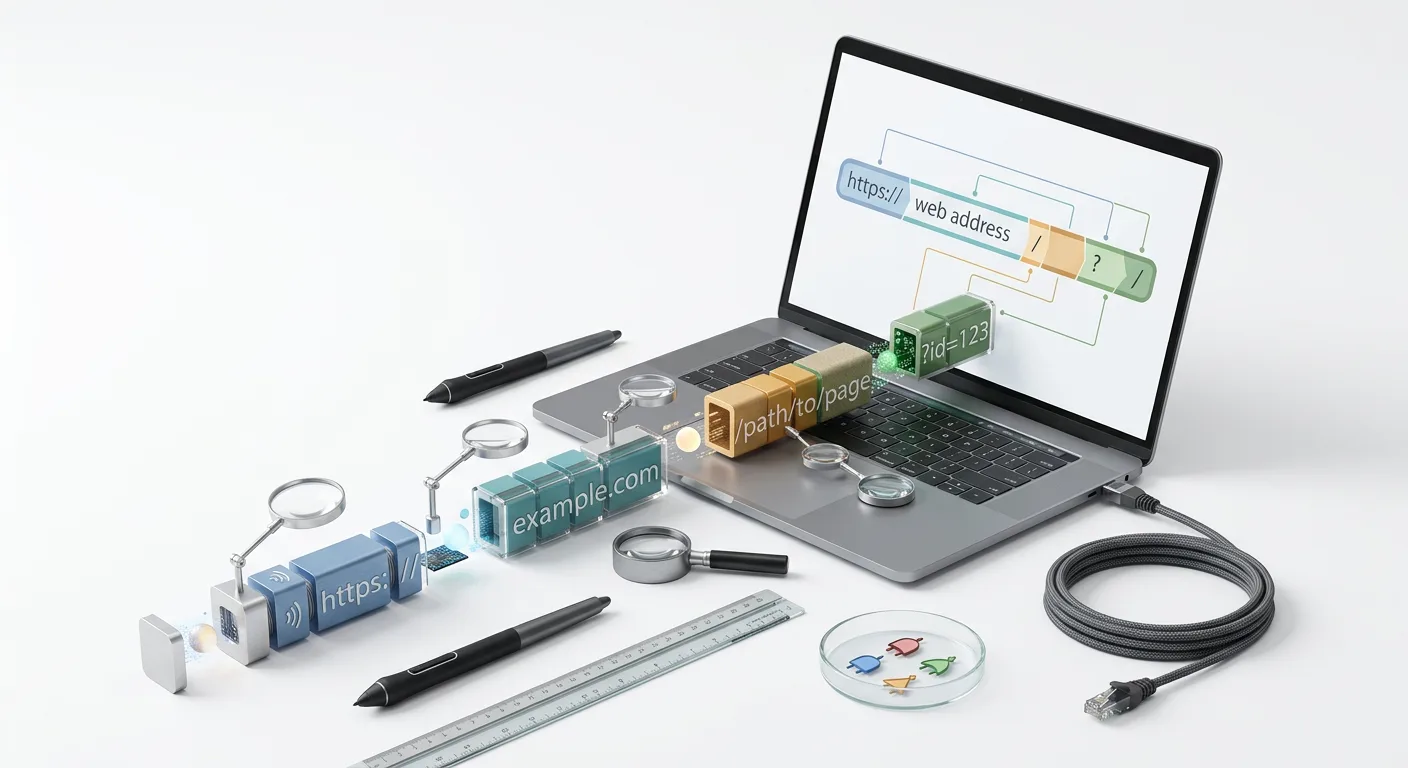
Стандарт RFC 1738 и концепция Единого локатора ресурсов
Основой навигации в сетевой среде выступает Uniform Resource Locator. Этот технический стандарт описывает унифицированную строку символов, которая указывает точное местоположение целевого объекта в интернете и задает способ обращения к нему. В контексте взаимодействия и связывания веб-документов адреса интегрируются в гиперссылки. Гиперссылка представляет собой структурный элемент цифрового документа, содержащий программный указатель на URL, что обеспечивает навигацию между независимыми страницами, файловыми директориями или серверными скриптами.
Базовые правила формирования веб-адресов регламентируются спецификацией RFC 1738. Данный документ устанавливает универсальный синтаксис, применимый для глобальных систем передачи данных. Согласно спецификации, каждая адресная строка должна быть самодостаточной и содержать исчерпывающую информацию для точной идентификации ресурса. Стандарт RFC 1738 жестко определяет допустимый алфавит, строгую последовательность компонентов и применяемые синтаксические разделители, необходимые для машинного чтения.
Синтаксическая корректность адреса имеет критическое значение для успешного выполнения HTTP-запроса. Процесс формирования клиентского обращения к серверу напрямую зависит от абсолютной валидности исходной строки. На основе разобранных данных сетевые клиенты выполняют следующие задачи:
- Идентификация целевого хоста для последующего разрешения доменного имени через DNS.
- Установление сетевого соединения с требуемым узлом.
- Генерация стартовой строки HTTP-запроса с указанием точного маршрута к целевому файлу.
Любое отклонение от требований спецификации RFC 1738 приводит к сбою на этапе программного парсинга строки. Нарушение иерархии компонентов или применение недопустимых символов без соответствующей обработки делает невозможным извлечение служебных данных. В результате веб-клиент не способен маршрутизировать запрос к серверу либо формирует некорректный пакет данных, что полностью блокирует доступ к запрашиваемому ресурсу.
Анатомия базовых компонентов URL: протокол, домен и порт
Анализ структуры любого веб-адреса начинается с разбора его фундаментальной части, которая предшествует маршрутам и параметрам запроса. Базовые компоненты определяют метод связи и точный сетевой узел, к которому направляется обращение. При программном парсинге исходная строка разделяется на четкие логические сегменты на основе стандартизированных синтаксических разделителей.
Извлечение схемы передачи данных
Первым элементом адреса является схема, которая указывает сетевому клиенту требуемый протокол прикладного уровня. В процессе анализа строки этот компонент изолируется путем поиска всех символов, расположенных до первого обязательного специфицированного разделителя
://
.
В результатах разбора стандартных адресов фигурируют следующие основные схемы:
-
http- базовый протокол передачи гипертекста без применения криптографического шифрования транспортного уровня. -
https- защищенная спецификация протокола, требующая инициализации TLS-соединения для обмена данными. -
ftp- протокол передачи файлов, используемый для прямой работы с удаленными файловыми серверами.
Иерархическая структура доменного имени
Непосредственно за разделителем
://
следует целевой хост. В абсолютном большинстве веб-адресов этот компонент представлен доменным именем, которое требует последующего разрешения в IP-адрес через механизмы DNS. При анализе структуры адреса извлеченный хост разбивается на иерархические уровни, которые читаются и интерпретируются справа налево.
Архитектура стандартного доменного имени состоит из следующих элементов:
| Компонент | Определение и структурная позиция |
|---|---|
| Доменная зона | Домен верхнего уровня (TLD), располагающийся в крайнем правом положении. Указывает на принадлежность адреса к национальной зоне или специализированному реестру. |
| Основной домен | Домен второго уровня. Выступает базовым идентификатором конкретного ресурса внутри выбранной доменной зоны. |
| Поддомен | Домен третьего и последующих уровней, добавляемый слева от основного домена. Применяется для логического разделения серверной инфраструктуры и выделения отдельных сервисов. |
Спецификация сетевого порта
Сетевой порт является опциональным компонентом в архитектуре URL. Он следует за доменным именем и отделяется от него строгим синтаксическим разделителем
:
. Наличие порта в структуре адреса необходимо для маршрутизации входящего соединения к конкретному процессу или службе на целевом сервере.
Алгоритм парсинга определяет наличие порта по числовому значению, идущему после двоеточия, до начала первого слеша, обозначающего путь. Если порт в строке не специфицирован явно, сетевые клиенты автоматически подставляют стандартные значения, исходя из извлеченной схемы:
-
При использовании схемы
httpпо умолчанию назначается порт80. -
Для схемы
httpsприменяется порт443. -
При обращении по схеме
ftpзадействуется порт21.
Прямое указание числового значения порта в базовой части URL обычно применяется при обращении к локальным средам разработки, тестовым серверам или при использовании нестандартных серверных конфигураций, где службы прослушивают альтернативные интерфейсы.
Структура пути, параметры запроса и идентификаторы фрагментов
После завершения анализа хоста и опционального порта выделяется путь к конкретному ресурсу на сервере. Эта часть адреса начинается с символа прямого слеша
/
и определяет иерархическую локацию запрашиваемого документа внутри файловой системы или структуры маршрутизатора веб-приложения.
Путь состоит из последовательных сегментов, разделенных слешами. Каждый сегмент соответствует директории или виртуальному разделу в архитектуре ресурса. Терминальный сегмент адреса, идентифицирующий конечную страницу или публикацию, обозначается термином Slug. Извлечение этих сегментов позволяет восстановить логическую структуру вложенности запрашиваемого контента.
Синтаксис параметров запроса
Параметры запроса следуют сразу за путем и служат для передачи дополнительных динамических данных серверному приложению. Начало строки параметров строго обозначается синтаксическим разделителем
?
. Инфраструктура сервера использует эту часть адреса для фильтрации данных, сортировки списков или обработки поисковых запросов внутри сайта.
Структура этих данных строится на основе синтаксиса пар ключ-значение. Для привязки конкретного значения к ключу применяется символ знака равенства
=
. Если адрес содержит множественные параметры, они объединяются в единую цепь с помощью символа амперсанда
&
.
Функциональное разделение компонентов строки параметров:
| Компонент | Символ | Правило обработки |
|---|---|---|
| Инициализатор |
?
|
Отделяет иерархический маршрут страницы от начала строки динамических параметров. Применяется только один раз. |
| Разделитель пар |
&
|
Связывает независимые переменные между собой, позволяя передавать серверу массив различных данных. |
| Оператор присваивания |
=
|
Назначает значение для объявленного ключа. Располагается строго между именем параметра и его содержимым. |
Типичным практическим сценарием использования параметров запроса является применение UTM-меток. Эти стандартизированные переменные добавляются в конечный URL для передачи аналитическим системам точных данных об источнике трафика, рекламной кампании и носителе. Извлечение и анализ ключей
utm_source
,
utm_medium
и
utm_campaign
позволяет идентифицировать маркетинговые атрибуты конкретного перехода без изменения основного контента страницы.
Идентификатор фрагмента
Завершающим элементом полной структуры адреса выступает идентификатор фрагмента, который отделяется символом решетки
#
. В спецификации веб-адресации этот компонент предназначен исключительно для обработки на стороне клиента.
В отличие от пути и параметров запроса, фрагмент не передается на сервер при формировании сетевого соединения. Браузер использует извлеченное значение якоря для прокрутки документа к определенному узлу DOM с соответствующим атрибутом идентификатора. При разборе строки адреса идентификатор фрагмента всегда изолируется как конечная подстрока, следующая за первым обнаруженным символом
#
.
Валидация синтаксиса, URL-кодирование и Punycode
Валидный синтаксис веб-адреса строго ограничивает набор символов, допустимых для передачи по сети. Стандарт опирается на базовую таблицу ASCII и разделяет символы на две категории: незарезервированные и зарезервированные. К незарезервированным относятся латинские буквы, цифры, дефис, точка, подчеркивание и тильда. Эти знаки могут безопасно использоваться в любой части адреса. Зарезервированные символы выполняют служебную функцию разделителей компонентов. Передача любых иных знаков, включая национальные алфавиты и пробелы, требует применения специфических алгоритмов преобразования данных.
Механизм URL-кодирования
Процесс URL-кодирования применяется для безопасной передачи нестандартных символов в пути, параметрах запроса и идентификаторах фрагмента. Этот алгоритм заменяет недопустимый символ на знак процента, за которым следуют две шестнадцатеричные цифры, представляющие байтовое значение исходного символа в кодировке UTF-8.
Такое преобразование исключает синтаксические конфликты при интерпретации строки сервером. Если параметр запроса содержит зарезервированный знак в качестве части текстовой переменной, а не как структурный разделитель, он должен пройти процедуру экранирования.
Список часто встречающихся зарезервированных символов и их соответствующих шестнадцатеричных кодов после преобразования:
| Символ | Синтаксическое назначение | Закодированное значение |
|---|---|---|
| Пробел | Разделение слов в текстовых значениях |
%20
|
| / | Разделитель сегментов пути |
%2F
|
| ? | Индикатор начала строки параметров |
%3F
|
| & | Разделитель независимых ключей запроса |
%26
|
| = | Оператор назначения значения |
%3D
|
Алгоритм Punycode для доменных имен
Обработка IDN выполняется по отдельному стандарту. В отличие от пути или конечных параметров, где применяется шестнадцатеричное кодирование, национальные алфавиты в доменной зоне преобразуются с помощью алгоритма Punycode. Эта система конвертирует символы Unicode в допустимый набор ASCII-символов, обеспечивая полную техническую совместимость с глобальной инфраструктурой DNS.
Технически процесс конвертации заключается в извлечении всех базовых латинских символов из исходного имени и добавлении закодированных не-ASCII знаков в конец строки с использованием дефиса в качестве внутреннего маркера. Для однозначной машинной идентификации преобразованного домена перед полученной строкой всегда добавляется стандартизированный префикс
xn--
.
Особенности обработки адресов с применением алгоритма Punycode:
- Конвертация применяется исключительно к хосту и не затрагивает сегменты пути или параметры запроса.
- Каждый уровень иерархии домена анализируется и кодируется независимо от соседних поддоменов.
- Итоговая строка после конвертации не может превышать лимит в 63 символа для каждого отдельного сегмента.
- Математический алгоритм полностью обратим, что позволяет клиентским приложениям декодировать строку обратно в исходный алфавит для корректного визуального отображения.
Форматы адресации: абсолютные, относительные и ЧПУ
Помимо кодирования отдельных символов и конвертации национальных алфавитов, структура веб-адреса классифицируется по формату записи и способу формирования пути. При анализе синтаксиса выделяют несколько базовых паттернов адресации, определяющих полноту указанных компонентов и предсказуемость итогового маршрута.
Абсолютные и относительные адреса
Формат записи определяет автономность локатора при обработке запроса. Синтаксический разбор позволяет разделить ссылки на две фундаментальные категории в зависимости от наличия корневых компонентов:
- Абсолютные URL содержат полный набор базовых данных для установления соединения. В строке явно присутствуют схема и хост. Такой формат полностью независим от текущего контекста документа и указывает точное местоположение целевого ресурса в глобальной сети.
- Относительные URL включают исключительно конечную часть адреса: путь, параметры или фрагмент. Они не содержат схемы и доменного имени. Вычисление итогового маршрута происходит на стороне клиента путем программного присоединения относительной строки к базовому узлу текущей страницы.
Статические и динамические структуры
По способу взаимодействия с серверной архитектурой и базой данных форматы делятся на статические и динамические. Структурная разница заключается в наличии и роли переменных в конечной части адреса.
| Тип формата | Синтаксические признаки | Особенности структуры |
|---|---|---|
| Статический | Отсутствие операторов ?, = и & | Путь жестко задан в виде последовательности директорий. Строка остается неизменной при каждом обращении к ресурсу и указывает на конкретный узел. |
| Динамический | Наличие пар ключ-значение в query string | Содержит набор переменных, передаваемых серверу. Изменение значения любого параметра в строке приводит к формированию уникального ответа. |
Синтаксис ЧПУ
Концепция ЧПУ подразумевает трансформацию сложных динамических адресов в логически структурированные статические маршруты. В контексте лексического разбора такой формат представляет собой последовательность понятных слов, разделенных дефисами или слешами, без использования открытых системных идентификаторов.
При анализе структуры ЧПУ выделяются следующие технические характеристики:
- Словарь пути преимущественно состоит из букв нижнего регистра и цифр, что минимизирует необходимость применения алгоритмов percent-encoding.
- Иерархия контента выстраивается через последовательные сегменты пути, семантически имитируя вложенность каталогов.
- Технические переменные скрыты на уровне конфигурации маршрутизатора и не фигурируют в видимой части запрашиваемой строки.
Сокращенные ссылки
Сокращенные форматы представляют собой специализированный тип адресации, где оригинальный маршрут заменяется на минимальный токен. Структурно такая запись включает только базовый домен сервиса-генератора и короткий алфавитно-цифровой идентификатор в качестве единственного сегмента пути.
Парсинг сокращенного локатора позволяет извлечь лишь указанные элементы. Полная структура изначального целевого адреса, включая исходные сегменты, метки и параметры запроса, скрыта за непрозрачным токеном и недоступна для прямого синтаксического анализа.
Влияние синтаксиса URL на маршрутизацию и HTTP-статусы
В архитектуре клиент-серверного взаимодействия запрашиваемый адрес выступает в роли точной директивы для маршрутизатора веб-сервера. При получении запроса сервер анализирует сегменты пути и переданные параметры, сопоставляя их с внутренними правилами конфигурации. Синтаксическая структура строки напрямую определяет, какой обработчик будет запущен, и формирует итоговый код ответа.
Точное совпадение маршрута
При строгом соответствии синтаксиса запрашиваемого URL существующей структуре каталогов или правилам динамической маршрутизации сервер успешно локализует целевой контент. В этом случае обработка завершается выдачей ответа с кодом 200 OK. Любые параметры запроса, если они предусмотрены логикой приложения, корректно передаются в вычислительное ядро для генерации релевантной страницы.
Ошибки адресации и битые ссылки
Малейшее отклонение в синтаксисе адреса приводит к сбою сопоставления маршрутов. Пропущенный сегмент пути, опечатка в идентификаторе ресурса или некорректно сформированная строка параметров не позволяют серверу найти запрашиваемый объект. Результатом такой обработки становится отдача статуса 404 Not Found. Наличие подобных адресов в структуре веб-ресурса приводит к появлению битых ссылок, которые обрывают семантические связи и приводят к потере краулингового бюджета.
Перенаправления запросов
При модернизации архитектуры сайта или изменении стандартов формирования путей возникает необходимость перенаправления трафика со старых адресов на новые. Для управления этим процессом на уровне сервера настраиваются правила редиректов, зависящие от синтаксиса входящего URL.
- Постоянное перенаправление сопровождается HTTP-статусом 301 Moved Permanently. Этот ответ указывает, что исходный синтаксис адреса устарел, и сервер маршрутизирует запрос на актуальный локатор ресурса.
- Временное перенаправление использует код 302 Found. Сервер обрабатывает запрос по исходному маршруту, но временно перенаправляет клиент на альтернативный адрес, сохраняя валидность оригинального URL для будущих обращений.
Соответствие между изменением структуры адреса и поведением сервера можно классифицировать по типовым сценариям обработки.
| Изменение в синтаксисе URL | Действие маршрутизатора сервера | Код HTTP-статуса |
|---|---|---|
| Запрос по валидному и существующему пути | Успешное сопоставление ресурса и генерация документа | 200 OK |
| Опечатка в сегменте пути или удаление ресурса | Сбой поиска совпадений в таблице маршрутизации | 404 Not Found |
| Запрос к устаревшему формату пути при наличии правила обновления | Принудительный перевод на новый статический маршрут | 301 Moved Permanently |
| Запрос к ресурсу, временно перенесенному на другой сегмент пути | Делегирование запроса на актуальный временный локатор | 302 Found |
SEO-атрибуты и семантическая иерархия веб-адреса
Структура локатора ресурса выступает первичным сигналом для поисковых краулеров при анализе релевантности документа. Синтаксис адреса передает семантический контекст до этапа рендеринга HTML-кода страницы. Алгоритмы поисковых систем парсят компоненты URL для понимания архитектуры проекта, определения тематической принадлежности контента и распределения краулингового бюджета.
Построение архитектуры ресурса опирается на последовательность сегментов пути. Разделители в виде слешей формируют логическую вложенность, отражающую таксономию контента. Такая структура позволяет поисковому роботу вычислить относительный вес страницы внутри домена и корректно сформировать цепочку навигации в результатах выдачи.
| Уровень иерархии | Синтаксис сегмента пути | Функция в архитектуре сайта |
|---|---|---|
| Корневой узел | / | Главная страница ресурса, обладающая максимальным статическим весом и служащая точкой входа для краулера |
| Родительский сегмент | /category/ | Разводящий узел или агрегатор, задающий границы тематического кластера для вложенных документов |
| Конечный локатор | /category/item-name | Целевой документ, содержащий специфичный ответ на поисковый запрос пользователя |
Консолидация дубликатов и директива canonical_link
Динамическая генерация параметров запроса, применение UTM-меток или фильтров сортировки создает альтернативные адреса для идентичного содержимого. Индексирование таких вариаций приводит к размытию ссылочных сигналов и внутренней каннибализации, когда несколько копий одного документа конкурируют за позиции в выдаче.
Для решения проблемы дублирования применяется тег
<link rel="canonical">
, размещаемый в заголовочной части документа. Данный атрибут устанавливает эталонный синтаксис адреса и инструктирует поисковые системы о правилах обработки сопутствующих копий.
- Агрегация сигналов ранжирования со всех параметрических URL переносится на указанный канонический адрес.
- В индекс поисковой системы попадает исключительно эталонный маршрут, что предотвращает нецелевой расход лимитов сканирования.
- Снижается риск пессимизации алгоритмами, контролирующими уникальность контента в рамках одного домена.
Управление ссылочным весом через атрибуты dofollow и nofollow
Внешние и внутренние гиперссылки формируют направленный граф, по которому поисковые алгоритмы распределяют авторитетность между документами. Текст анкора, привязанный к целевому адресу, выступает дополнительным фактором текстовой релевантности. Управление процессом передачи статического веса при парсинге ссылок реализуется через значения атрибута rel.
Сценарии обработки анкоров гиперссылок зависят от внедренных SEO-атрибутов:
- Поведение dofollow применяется парсером по умолчанию при отсутствии ограничивающих директив. Поисковый робот извлекает веб-адрес из гиперссылки, добавляет его в очередь на сканирование и передает часть PageRank принимающему документу, связывая его тематику с текстом анкора.
- Атрибут nofollow блокирует маршрутизацию ссылочного веса. Краулер считывает синтаксис адреса, но алгоритм исключает передачу авторитетности по данному узлу. Инструмент применяется для изоляции недоверенного пользовательского контента, служебных страниц авторизации или ссылок, размещенных на коммерческой основе.
Индикаторы безопасности в структуре веб-адреса
Синтаксический разбор веб-адреса позволяет не только определить маршрутизацию и семантическую иерархию, но и оценить базовый уровень доверия к целевому ресурсу. При парсинге извлекаются компоненты, которые выступают первичными сигналами безопасности. Идентификация этих элементов необходима для фильтрации потенциально опасных ссылок, предотвращения утечек данных и оценки репутационных рисков при формировании исходящего ссылочного профиля.
Шифрование трафика и протоколы передачи данных
Ключевым индикатором защиты на транспортном уровне выступает схема, указанная в начале адреса. Она определяет механизмы взаимодействия между клиентом и сервером при выполнении запроса.
- Использование HTTP указывает на передачу пакетов данных в открытом виде. Трафик не шифруется, что делает соединение уязвимым для перехвата и модификации. Современные браузеры и алгоритмы ранжирования пессимизируют подобные ресурсы, помечая их как небезопасные.
- Наличие HTTPS подтверждает применение криптографических стандартов. Целевой сервер обладает валидным SSL-сертификатом, а данные передаются в зашифрованном виде, что обеспечивает целостность и конфиденциальность пользовательской информации.
Извлечение схемы при парсинге URL позволяет классифицировать ссылки по уровню защищенности до фактического установления TCP-соединения.
Идентификация фишинговых паттернов при парсинге домена
Анализ иерархии доменного имени дает возможность выявить структурные аномалии, характерные для ресурсов социальной инженерии. Злоумышленники конструируют адреса, визуально напоминающие легитимные корпоративные сети или банковские сервисы. При автоматизированном разборе выявляются следующие признаки вредоносной активности:
- Тайпсквоттинг. Намеренная замена символов визуально похожими глифами, использование опечаток или перестановка букв в теле основного домена.
- Избыточная вложенность. Размещение названия известного бренда в поддомене третьего или четвертого уровня при использовании нерелевантного основного домена.
- Внедрение служебных маркеров. Искусственное удлинение адреса за счет добавления слов login, secure, verification или account через дефис к основному имени.
- Подозрительные доменные зоны. Размещение ресурса в дешевых или слабо администрируемых зонах, которые часто задействуются для развертывания фишинговых кампаний.
Проверка репутации ресурса по блеклистам
Синтаксический анализ является подготовительным этапом для сверки адреса с глобальными базами угроз. Извлеченный канонический вид домена или полный путь используется в качестве точного идентификатора для запросов к репутационным системам.
Концепция валидации безопасности включает сопоставление полученного URL с известными агрегаторами угроз:
- Google Safe Browsing аккумулирует списки веб-ресурсов, уличенных в распространении вредоносного программного обеспечения, эксплойтов или проведении фишинговых атак.
- Специализированные спам-базы фиксируют хосты, задействованные в агрессивных рассылках, поисковом спаме или распространении нежелательного контента.
- Реестры индикаторов компрометации предоставляют списки узлов, связанных с управлением ботнетами и скрытым майнингом.
Совпадение извлеченного доменного имени с записями в блеклистах служит техническим сигналом для блокировки перехода, изоляции контента или исключения данного узла из процессов индексирования.