Проверка параметров запроса в URL требует ввода полной текстовой строки веб-адреса. Инструмент принимает исходную ссылку. Сразу после этого выполняется точный парсинг структуры URL для отделения доменной базы от блока передаваемых данных.
Алгоритм сканирует адресную строку и извлекает все встроенные query-параметры. Результатом работы алгоритма является детализированный список. Обнаруженные параметры группируются и выводятся на экран в формате пар ключ-значение. Разбивка длинного текста на логические элементы полностью исключает ошибки при чтении переменных.
Пользователь получает чистый и структурированный набор извлеченных ключей с соответствующими им значениями.
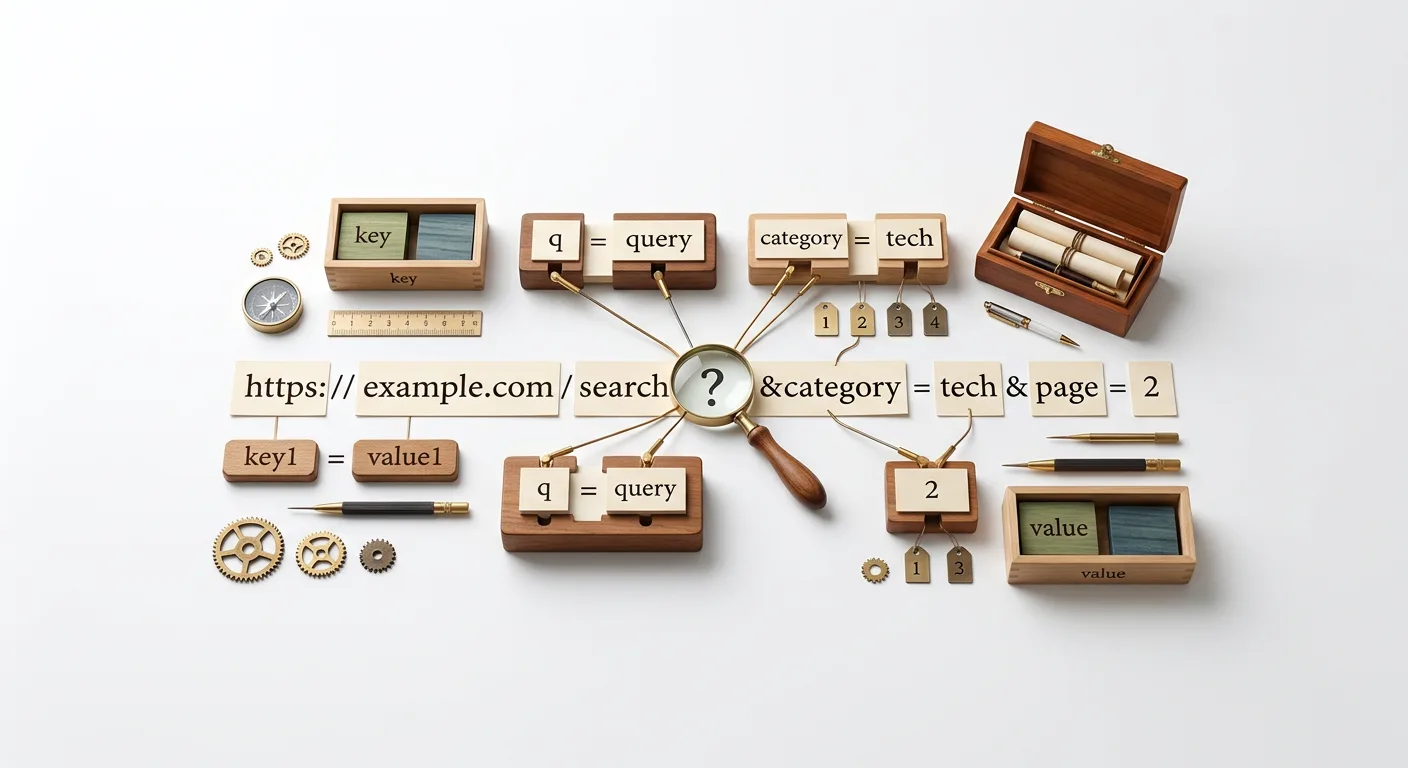
Принцип работы парсера URL и структура адреса
Процесс обработки начинается с декомпозиции переданного веб-адреса на базовые структурные компоненты. Синтаксический анализатор последовательно читает строку слева направо для определения границ каждого логического элемента. На этом этапе происходит отделение протокола (схемы), доменного имени (хоста) и пути к конкретной директории или ресурсу (path). Изоляция этой иерархической части ссылки необходима для того, чтобы исключить навигационные данные из дальнейшей обработки.
Ключевым маркером для идентификации начала блока передаваемых данных служит символ вопроса. Знак
?
выступает в роли строгого разделителя между статическим маршрутом и динамической строкой запроса (query string). Алгоритм фиксирует позицию этого символа в структуре URL. Вся техническая информация, расположенная до него, отсекается, а текст, следующий непосредственно после знака вопроса, классифицируется как целевая область для извлечения параметров.
Критически важным этапом парсинга является определение конечной границы строки запроса. Часто веб-адреса содержат идентификатор фрагмента (hash), который начинается с символа решетки
#
. Фрагмент указывает на якорную ссылку внутри документа и обрабатывается исключительно на стороне браузера, не участвуя в передаче данных на сервер.
Принципы изоляции данных при парсинге сводятся к следующим правилам:
- Схема, хост и путь формируют базовую часть маршрутизации и исключаются из массива переменных.
-
Символ
?маркирует старт строки запроса и запускает процесс захвата текстового блока. -
Символ
#обозначает начало клиентского фрагмента и служит сигналом для принудительной остановки чтения параметров.
Алгоритм производит отсечение блока параметров, обрезая исходную строку ровно перед символом решетки. Это исключает попадание навигационного хэша в массив анализируемых данных.
На данном этапе парсинга инструмент выделяет единую сырую строку запроса. Отсекая базовый адрес слева и клиентский якорь справа, алгоритм формирует чистый, неразмеченный текстовый блок, содержащий всю совокупность неформатированных параметров. Именно эта сырая строка передается на следующий цикл обработки для детального синтаксического анализа.
Синтаксис строки запроса и извлечение GET-параметров
Изолированный текстовый блок требует синтаксического разделения. Строка запроса функционирует как сериализованный словарь, где данные передаются в строго линейном формате. Для преобразования сплошного текста в структурированный список переменных применяется последовательное разбиение на основе зарезервированных символов-разделителей.
Процесс извлечения опирается на два фундаментальных синтаксических правила:
-
Символ амперсанда
&выполняет функцию глобального разделителя. Он разбивает единую строку запроса на отдельные самостоятельные фрагменты. -
Символ равенства
=выступает локальным разделителем внутри каждого выделенного фрагмента. Он разделяет элемент на составные части: левая сторона становится ключом, а правая сторона - значением.
В результате такого двухуровневого разделения формируются пары «ключ-значение». Ключ служит уникальным идентификатором передаваемой метрики или директивы, а значение содержит конкретные данные, привязанные к этому идентификатору. В ситуациях, когда параметр передан без символа равенства или после него отсутствует текст, значение классифицируется как пустое, при этом сам ключ сохраняется в итоговом массиве.
Описанный формат форматирования напрямую связан с механизмом передачи данных протокола HTTP. При использовании метода GET клиентская сторона не отправляет информацию в теле запроса (payload body). Вся полезная нагрузка должна быть интегрирована непосредственно в URL. Серверная архитектура интерпретирует последовательность пар, соединенных амперсандами, как стандартизированный способ получения переменных окружения, команд фильтрации или навигационных инструкций.
Синтаксическое разделение можно проиллюстрировать на примере обработки типовых элементов:
| Сырой блок данных | Ключ (Key) | Значение (Value) |
|---|---|---|
type=article
|
type | article |
page=4
|
page | 4 |
sort=desc
|
sort | desc |
draft=
|
draft | пусто |
Извлечение GET-параметров трансформирует линейный текст в машиночитаемый массив. Каждая обнаруженная пара фиксируется в первозданном виде. На этом этапе сохраняется исходная последовательность символов, которая выступает базисом для дальнейшего выявления экранированных элементов и финального приведения данных к читаемому виду.
Декодирование значений и обработка спецсимволов
После выделения сырой строки запроса и ее разделения на базовые пары требуется приведение данных к исходному читаемому формату. Этот процесс называется URL-decode. Необходимость преобразования продиктована техническими ограничениями веб-адресов: они могут содержать только ограниченный набор символов. Любые пробелы, текст на национальных языках, спецсимволы и эмодзи перед интеграцией в URL проходят обязательную процедуру процентной кодировки.
Процентная кодировка трансформирует недопустимые элементы в экранированные последовательности, состоящие из знака процента и двух шестнадцатеричных цифр. Формирование таких последовательностей опирается на стандарты ASCII и UTF-8. Если символ присутствует в базовой таблице ASCII, он кодируется одним байтом. Для более сложных символов применяется кодировка UTF-8, где один знак может занимать от двух до четырех байт, что в закодированном виде выглядит как цепочка из нескольких последовательных экранированных блоков.
Для корректного извлечения значений важно различать две категории символов, определенных стандартами веб-адресации:
- Незарезервированные символы. Буквы латинского алфавита, цифры, дефис, точка, подчеркивание и тильда. Они могут передаваться в строке запроса в чистом виде и не требуют применения кодировки.
- Зарезервированные символы. Знаки, выполняющие служебные функции в структуре адреса. К ним относятся амперсанд, знак равенства, вопросительный знак, слэш и решетка. Если такой символ должен быть передан как часть значения параметра, а не как синтаксический разделитель, его необходимо экранировать.
Без процедуры URL-декодирования итоговые значения параметров останутся машиночитаемым текстом, непригодным для дальнейшего анализа. Преобразование экранированных последовательностей возвращает данным их первоначальный вид. Типовые примеры таких трансформаций представлены в таблице:
| Тип символа | Экранированная последовательность | Результат декодирования |
|---|---|---|
| Пробел |
%20
(или знак плюса)
|
Пробел |
| Амперсанд |
%26
|
& |
| Знак равенства |
%3D
|
= |
| Слэш |
%2F
|
/ |
| Кириллическая буква А (UTF-8) |
%D0%90
|
А |
Восстановление исходного текста через URL-decode обеспечивает корректное отображение итоговых значений. Например, если в параметре передается поисковая фраза, содержащая пробелы и служебные знаки, именно декодирование превращает последовательность
shoes%20%26%20bags
в читаемую строку
shoes & bags
. Без этого этапа извлеченный массив данных сохранит искаженный синтаксис, что сделает невозможной правильную интерпретацию переданной информации.
Анализ UTM-меток и параметров трекинга
Декодированная и разделенная на элементы строка запроса предоставляет основу для проверки корректности маркетинговых ссылок. Извлечение пар «ключ-значение» применяется вебмастерами и аналитиками для аудита аналитических данных перед массовым размещением URL. Системы веб-аналитики требуют точного соблюдения синтаксиса параметров трекинга. Предварительный разбор структуры веб-адреса позволяет выявить пропущенные значения, опечатки в идентификаторах или нарушение последовательности разделителей.
На практике валидация аналитической структуры чаще всего включает проверку пяти стандартных ключей, используемых для сегментации входящего трафика:
-
utm_source- идентификатор источника перехода. -
utm_medium- тип маркетингового канала или модели оплаты. -
utm_campaign- наименование конкретной рекламной кампании. -
utm_term- ключевая поисковая фраза, инициировавшая показ объявления. -
utm_content- дополнительная информация для различения элементов интерфейса или креативов с одинаковым целевым адресом.
Помимо статических меток, которые формируются вручную, в строке запроса часто присутствуют динамические параметры рекламных платформ. Они добавляются к целевому URL автоматически при клике по рекламному объявлению. К наиболее распространенным платформозависимым ключам относятся
gclid
и
fbclid
.
Извлечение всех перечисленных пар «ключ-значение» из общей массы параметров позволяет валидировать структуру ссылок для систем веб-аналитики. Если в полученном перечне ключ написан с ошибкой (например,
utm_sourse
вместо
utm_source
) или значение слилось с другим параметром из-за пропущенного амперсанда, система аналитики проигнорирует метку. Выделение каждого ключа и соответствующего ему значения в виде структурированного списка гарантирует, что трекинговая информация передается в предусмотренном формате и трафик будет корректно атрибутирован в аналитических отчетах.
Оценка SEO-влияния и технических рисков параметров
Наличие динамических параметров в строке запроса напрямую влияет на процесс сканирования и индексации сайта поисковыми системами. В то время как маркетинговые метки служат для атрибуции трафика, технические ключи управляют состоянием страницы. К таким ключам относятся переменные пагинации, параметры фасетной фильтрации, настройки сортировки списков и идентификаторы пользовательских сессий. Использование этих элементов без должного технического контроля формирует массив уникальных веб-адресов, содержащих идентичный или незначительно измененный основной контент.
Основной технический риск при работе с параметрическими адресами заключается в механизме возникновения дублей страниц. Поисковые роботы воспринимают каждый URL с новой комбинацией пар «ключ-значение» как отдельный независимый документ. Появление нежелательных дублей происходит при следующих условиях:
- Изменение порядка следования ключей в строке запроса, при котором разные URL возвращают одинаковый HTML-код.
- Комбинирование нескольких параметров фасетного фильтра, создающих страницы с пересекающимся ассортиментом.
- Применение параметров, изменяющих только визуальное представление данных, таких как сетка или список, без изменения смысловой части документа.
Генерация множества подобных адресов приводит к нецелевому расходу краулингового бюджета. Поисковые системы выделяют ограниченные вычислительные ресурсы и время на сканирование каждого отдельного хоста. Если краулер тратит доступные лимиты на обход тысяч комбинаций сортировок и пустых фильтров, критически важные коммерческие страницы могут не попасть в индекс или обновляться с задержкой. Дополнительно возникает проблема каннибализации поисковой выдачи и размытия ссылочного веса между множеством вариаций одного документа.
Детализированный список обнаруженных ключей, полученный после парсинга строки запроса, служит базой для нормализации структуры сайта. SEO-специалисты используют выделенные параметры для проектирования архитектурных ограничений и настройки правил краулинга. На основе извлеченных данных реализуются следующие технические решения:
- Внедрение атрибута rel=canonical на параметрических страницах, указывающего поисковому роботу на каноническую версию документа, свободную от ключей сортировки и фильтрации.
- Формирование инструкций Disallow в файле robots.txt для блокировки сканирования служебных параметров.
- Применение директивы Clean-param для явного указания поисковым системам на ключи, которые не меняют контент и должны игнорироваться при склейке дублей.
Точная идентификация всех параметров, участвующих в формировании URL, позволяет исключить архитектурные ошибки маршрутизации, сохранить лимиты сканирования и обеспечить консолидацию сигналов ранжирования на целевых посадочных страницах.
Стандарты формирования URL и API Endpoints
Строгое соблюдение синтаксиса при передаче параметров обусловлено базовыми веб-стандартами. Формирование строки запроса регламентируется документами RFC 3986 и RFC 1738. Эти спецификации определяют допустимый набор символов, правила выделения блока параметров, а также порядок разделения пар ключей и значений. Следование данным техническим регламентам гарантирует, что серверные платформы, маршрутизаторы и клиентские приложения будут одинаково интерпретировать переданные данные независимо от используемого стека технологий.
В контексте клиент-серверного взаимодействия параметры строки запроса активно применяются для формирования обращений к API. При конструировании запросов к Endpoints передаваемые ключи выполняют роль фильтров, модификаторов сортировки или указателей страниц для пагинации. Сервер принимает структурированную строку, выполняет парсинг параметров согласно стандартам RFC и возвращает массив данных, соответствующий заданным критериям. Точная структура пар ключей и значений критически важна для безошибочного выполнения GET-запросов и маршрутизации внутри микросервисной архитектуры.
Для программной обработки и конструирования строк запроса в современных веб-средах применяется объект URLSearchParams. Этот стандартизированный интерфейс предоставляет методы взаимодействия с параметрами, исключая необходимость ручного манипулирования строками и самостоятельной реализации алгоритмов кодирования. Типовые операции интерфейса включают:
- Извлечение конкретного значения по заданному ключу для последующего использования в программной логике.
- Добавление новых параметров в существующую строку с автоматическим применением правил кодирования спецсимволов.
- Удаление ключей перед отправкой запроса к Endpoints для предотвращения передачи избыточных данных.
- Итерацию по всем существующим параметрам для валидации передаваемой информационной нагрузки.
Существуют жесткие архитектурные ограничения на объем данных, передаваемых через строку запроса. Серверное программное обеспечение устанавливает лимиты на максимальную длину обрабатываемого URL для предотвращения переполнения буфера и защиты от сетевых атак. Если суммарная длина базового адреса и всех присоединенных параметров превышает конфигурационные ограничения веб-сервера, возвращается ошибка 414 URI Too Long. При возникновении такого HTTP-статуса сервер прерывает обработку запроса. Стандартное инженерное решение при необходимости передачи избыточного количества параметров сводится к изменению метода HTTP-запроса, при котором массив данных размещается в теле запроса, оставляя URL в пределах допустимых стандартов.