Анализ подзаголовков H2 и H3 страницы представляет собой процесс извлечения структурных элементов из исходного кода веб-документа. Инструмент принимает на вход URL проверяемого ресурса. После сканирования система формирует линейный список всех найденных тегов секционирования. Пользователь получает точное дерево заголовков, отражающее реальную логическую иерархию контента без учета применения каскадных таблиц стилей и визуального оформления.
Данные извлекаются напрямую из технического HTML.
Полученная сводка применяется для решения прикладных задач технического SEO-аудита и конкурентного анализа. Парсинг структуры позволяет мгновенно обнаружить нарушения правил строгой вложенности элементов. К таким ошибкам относится использование H3 без предшествующего логического узла H2 или применение заголовочных тегов для оформления кнопок интерфейса. Специалисты используют извлеченный список для проверки on-page факторов и распределения ключевых фраз по смысловым блокам.
Чистая структура документа определяет точность индексирования поисковыми роботами. Валидная последовательность тегов формирует корректные сигналы для алгоритмов ранжирования. Отсутствие пропущенных уровней разметки является обязательным требованием для попадания текстовых фрагментов в расширенные сниппеты.
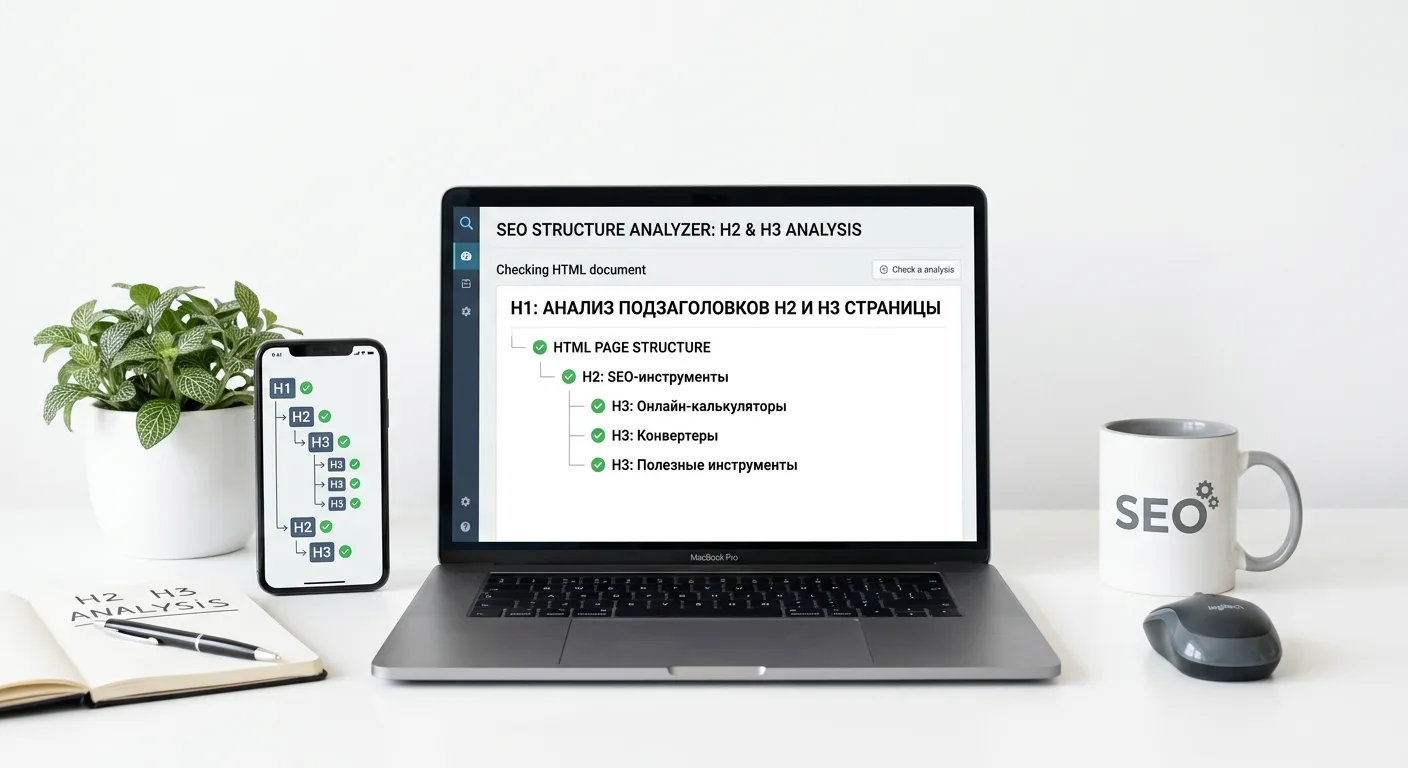
Значение тегов H2 и H3 для логической иерархии документа
Теги секционирования формируют базовый структурный каркас веб-страницы. Иерархия документа представляет собой систему подчинения информационных блоков, где каждый уровень разметки выполняет функцию самостоятельного навигационного узла. Тег H2 разбивает общий объем контента на крупные смысловые разделы, в то время как тег H3 детализирует эти разделы, выделяя специфические подразделы.
На техническом уровне эти элементы определяют связи в DOM structure. Программные обработчики воспринимают веб-документ как дерево узлов. Использование тегов H2 и H3 создает семантическую разметку, которая аппаратно указывает границу начала новой темы и подтверждает ее принадлежность к вышестоящему родительскому блоку.
Совокупность последовательно расположенных заголовочных тегов формирует дерево заголовков. Такое оглавление служит программной картой страницы. Логическая иерархия обеспечивает прямое соответствие HTML-разметки фактическому смыслу контента, позволяя машинам идентифицировать основные темы без полного синтаксического анализа всего текстового массива.
Поисковые роботы опираются на заголовочные теги как на первичные маркеры при обходе веб-ресурсов. Crawlers считывают семантическую разметку для понимания архитектуры контента и взаимосвязи частей статьи. Текст, расположенный между тегом H2 и следующим заголовочным узлом, интерпретируется алгоритмами как единый информационный блок. Индексирование страниц происходит с учетом этих структурных границ, что дает возможность поисковым системам точно классифицировать тематику каждого раздела.
Применение тегов секционирования H2 и H3 реализует следующие задачи организации контента:
- Распределение общего массива данных на изолированные смысловые секции.
- Фиксация родительских и дочерних зависимостей элементов внутри DOM structure.
- Точное определение границ информационных блоков для алгоритмов обхода.
- Построение валидного машиночитаемого дерева заголовков для индексирования.
Принцип извлечения и парсинга заголовков из HTML-кода
Извлечение данных начинается с загрузки исходного кода целевого веб-документа. Процесс парсинга представляет собой построение программной модели загруженной страницы, где каждый элемент становится доступным для поиска и анализа. При этом обрабатывается исключительно технический HTML, представляющий собой сырую структуру документа до этапа применения пользовательских стилей и графического рендеринга.
Для получения списка подзаголовков применяется прямое чтение узлов DOM. Поиск осуществляется с помощью селекторов, работающих по принципу метода
querySelectorAll
, который сканирует древовидную структуру документа и собирает элементы с определенным значением свойства
tagName
. В данном случае целевыми узлами выступают исключительно теги H2 и H3. Сканирование идет последовательно от начала документа к концу, что позволяет извлечь элементы с точным сохранением их исходного порядка следования в коде страницы.
Ключевым аспектом такой обработки является полное игнорирование визуального отображения контента. В основе лежит анализ фактической семантической верстки, а не визуального интерфейса (visual code analysis). Веб-разработчик может оформить обычный текстовый абзац крупным шрифтом с повышенной насыщенностью с помощью CSS, визуально имитируя начало нового раздела для читателя. Однако при техническом парсинге этот элемент будет идентифицирован в соответствии со своим истинным тегом, а не как узел H2 или H3.
Разница между визуальным размером шрифта и наличием фактического HTML-тега определяет следующие сценарии при извлечении структуры документа:
- Текст очень крупного размера, обернутый в непрофильные теги, не попадает в выборку и не учитывается как часть семантического оглавления.
- Подзаголовки, намеренно скрытые в интерфейсе браузера через свойства CSS, успешно извлекаются, так как они физически присутствуют в исходном HTML-коде.
- Узлы H2 и H3, которым принудительно задан мелкий шрифт, визуально не отличимый от основного текстового массива, распознаются парсером как полноценные элементы иерархии.
- Пустые заголовочные теги, не содержащие текстовых символов, фиксируются как существующие структурные элементы разметки.
Механика селекторного парсинга обеспечивает получение объективной картины технического состояния веб-документа. Изоляция процесса сбора от визуальных CSS-стилей позволяет получить структуру статьи точно в том виде, в котором ее извлекают поисковые алгоритмы при первичном обходе страницы.
Аудит последовательности и вложенности структуры (Nesting)
Наличие извлеченного списка подзаголовков позволяет провести аудит логической архитектуры документа. Главным критерием технического качества семантической разметки выступает строгая последовательность вложенности (nesting). Валидная структура требует плавного перехода между уровнями иерархии, где каждый последующий тег детализирует родительский раздел.
В корректно сформированном документе узел H3 всегда подчинен предшествующему узлу H2. Пропуск уровней иерархии разрывает семантические связи блоков текста. Ситуация, при которой за главным заголовком страницы сразу следует H3 без промежуточного H2, классифицируется как ошибка логической структуры. Изолированные теги младшего порядка создают фрагментированное дерево, которое усложняет интерпретацию контекста поисковыми роботами.
Анализ сформированного скелета статьи позволяет классифицировать паттерны вложенности по степени технической корректности:
| Последовательность узлов | Оценка разметки | Техническое обоснование |
|---|---|---|
| H2, затем H3, затем следующий H2 | Валидная структура | Соблюден строгий иерархический порядок. Узел H3 раскрывает тему родительского H2, после чего начинается новый равнозначный раздел. |
| Изолированный H3 без предшествующего H2 | Невалидная структура | Нарушена логика подчинения. Раздел третьего уровня ссылается на отсутствующий родительский контейнер второго уровня. |
| Несколько H3 подряд после одного H2 | Валидная структура | Широкий раздел H2 корректно разделен на несколько равнозначных подразделов третьего уровня. |
| H3, предшествующий первому H2 | Невалидная структура | Обратная вложенность. Младший тег инициирует структуру документа до объявления старших тематических блоков. |
Очищенный от визуального оформления список тегов служит точным индикатором для выявления типичных ошибок внутренней SEO-оптимизации. Изучение последовательности элементов часто вскрывает проблемы нецелевого использования разметки, когда разработчики подменяют таблицы стилей семантическими узлами.
Анализ дерева заголовков помогает обнаружить следующие технические недочеты на странице:
- Применение тегов H3 для стилизации элементов интерфейса. Часто в семантическое оглавление документа ошибочно попадают названия виджетов боковой панели, пункты навигационного меню, футер или заголовки форм обратной связи.
- Использование H2 для оформления служебных блоков, рекламных врезок или секций перелинковки, которые не относятся к основному текстовому массиву текущей статьи.
- Разрывы вложенности внутри основного контента, когда автор использует H3 исключительно ради визуального уменьшения размера шрифта по сравнению с H2, игнорируя логику повествования.
Выявление подобных аномалий в DOM-дереве позволяет SEO-специалисту отделить полезную контентную часть страницы от шаблонных элементов веб-дизайна. Исключение интерфейсных блоков из массива заголовочных тегов нормализует информационный вес документа и выстраивает предсказуемый путь сканирования.
Оценка релевантности и текстовых факторов в заголовках
После валидации технической вложенности элементов фокус аудита смещается на текстовое содержимое тегов. Подзаголовки выступают мощным on-page фактором, который алгоритмы используют для определения тематической принадлежности конкретных блоков документа. Извлеченный изолированный список текста из H2 и H3 позволяет оценить релевантность страницы заявленному поисковому интенту без отвлечения на основной массив контента.
Информационная ценность текста, заключенного в теги секционирования, традиционно определяется как вес подзаголовка. Этот показатель указывает на повышенную значимость фраз внутри H2 и H3 по сравнению с обычным текстом параграфов. Поисковые системы придают больший вес ключам в заголовках, так как они служат навигационными маркерами, суммирующими смысл последующих абзацев.
Работа с готовым списком заголовков сводится к проверке семантического покрытия темы. При анализе текстовых факторов необходимо контролировать присутствие следующих элементов в структуре:
- Прямые и разбавленные вхождения маркерных запросов в узлах H2, определяющих основные векторы статьи.
- LSI-фразы, синонимы и тематически связанные термины, расширяющие контекст и подтверждающие экспертность материала.
- Низкочастотные формулировки и длинные хвосты, которые целесообразно размещать в тегах H3 для сбора микро-трафика по узким спецификациям вопроса.
Визуальная оценка собранного дерева H2-H3 помогает SEO-специалисту оперативно выявлять отклонения в распределении ключевых слов. Очищенный от визуальных стилей каркас документа делает очевидными проблемы плотности семантики, которые трудно заметить при чтении сверстанной страницы.
| Состояние семантики | Признаки в списке подзаголовков | Влияние на on-page факторы |
|---|---|---|
| Переоптимизация (заспамленность) | Многократное дублирование основного ключевого слова в большинстве тегов H2 и H3 без синонимичной вариативности. | Риск наложения текстовых фильтров за переспам, искусственность структуры, каннибализация интента внутри блоков. |
| Недостаточное раскрытие темы | Отсутствие LSI-фраз, использование общих неинформативных формулировок (например, "Введение", "Детали", "Выводы"). | Низкая релевантность страницы семантически близким запросам, потеря видимости по длинным хвостам. |
Сводка текстового содержимого подзаголовков исключает субъективное восприятие текста на готовой странице. Анализ изолированного списка позволяет точно настроить текстовые факторы, сбалансировав плотность ключевых слов и информативность иерархии перед отправкой документа на индексацию.
Влияние структуры H2-H3 на AI-обзоры и Featured Snippets
Современные поисковые системы используют алгоритмы AI retrieval для генерации прямых ответов и формирования сводок без перехода на сайт. Системы, отвечающие за Featured Snippets, Google Overviews и AIO, критически зависят от чистоты семантического каркаса документа. Предсказуемая иерархия тегов H2 и H3 работает как система координат, позволяющая языковым моделям точно извлекать релевантные фрагменты текста из DOM-дерева.
Когда алгоритм сканирует страницу для формирования ИИ-ответа, он не просто читает сплошной текст, а анализирует логически изолированные блоки. Заголовок уровня H2 или H3 выступает в роли триггера контекста, а непосредственно следующие за ним элементы формируют смысловую полезную нагрузку. Если структура документа нарушена или уровни вложенности используются хаотично, алгоритм теряет связь между сущностью и ее описанием, что исключает попадание страницы в расширенные элементы SERP.
Архитектура документа напрямую определяет формат, в котором поисковая система сможет извлечь и представить контент. Связь между тегами секционирования и типами ответов подчиняется строгим паттернам.
| Формат ответа в выдаче | Оптимальный структурный паттерн H2-H3 | Принцип обработки алгоритмом |
|---|---|---|
| Paragraph Snippet (Текстовый ответ) | Тег H2 содержит точную формулировку вопроса или термина. Следующий за ним абзац текста дает прямой ответ. | Поисковая модель классифицирует заголовок как интент, а смежный текстовый узел - как релевантный ответ, связывая их в единый блок. |
| List Snippet (Списочный ответ) | Тег H2 задает общую тему или процесс. Вложенные подзаголовки H3 обозначают конкретные шаги, правила или элементы. | Алгоритм агрегирует текстовые значения всех тегов H3, находящихся под общим родительским H2, преобразуя их в нумерованный или маркированный список. |
| AIO / Google Overviews | Многоуровневая семантика: H2 выступает макро-кластером, H3 раскрывают специфические детали и граничные условия. | LLM использует теги секционирования как жесткие границы контекста (context boundaries) для безопасного синтеза фактов из разных частей документа. |
Базовое правило оптимизации под ИИ-ответы строится на строгой последовательности: макро-интент в H2 переходит в микро-интент в H3 или в прямое утверждение в абзаце. Изолированный анализ дерева заголовков позволяет проверить документ на соответствие этому правилу до его сканирования краулерами. В чистом списке подзаголовков сразу видно, содержат ли узлы H2 четкие вопросы или утверждения, способные стать триггером для Featured Snippets.
Использование общих фраз в тегах секционирования резко снижает вероятность того, что контент будет выбран генеративной нейросетью. Анализ выгруженной иерархии помогает SEO-специалисту перестроить структуру так, чтобы каждый H3 логически развивал тему предшествующего H2. Подобная контекстная изоляция предотвращает смешивание несвязанных фактов алгоритмами извлечения и повышает авторитетность страницы как источника данных для AI-обзоров.
Роль заголовочных тегов в обеспечении веб-доступности (A11y)
Семантически корректная структура документа напрямую определяет качество пользовательского опыта при взаимодействии со вспомогательными технологиями. Программы экранного доступа формируют навигационное оглавление страницы исключительно на основе фактической HTML-разметки. Изолированный список узлов H2 и H3 позволяет оценить готовность контента к корректному восприятию через аудиальные интерфейсы.
С технической точки зрения нативные элементы секционирования обладают встроенной семантикой. На уровне браузерного движка тегу H2 автоматически назначаются атрибуты role="heading" и aria-level="2". Для тега H3 аналогичным образом формируется значение aria-level="3". Данная связка передается в дерево доступности, которое операционная система транслирует скринридеру. Попытка заменить H2 или H3 обычным текстом с увеличенным размером шрифта оставляет узел без соответствующих ARIA-атрибутов, полностью исключая важный блок из навигационной панели скринридера.
Строгая последовательность вложенности без пропущенных уровней является критическим требованием современных стандартов веб-доступности. Пользователи с нарушениями зрения применяют функционал быстрого перехода по заголовкам для сканирования длинных документов, формируя ментальную карту страницы.
Ошибки в логической иерархии приводят к следующим техническим проблемам при чтении документа через скринридеры:
- Пропуск уровня иерархии создает ложное аппаратное предупреждение о потере части контента, поскольку программа озвучивает неожиданный скачок значения aria-level.
- Наличие узла H3 без предшествующего H2 нарушает логическое группирование данных, лишая пользователя понимания родительского макро-интента.
- Включение служебных элементов интерфейса в теги H3 засоряет ротор скринридера нерелевантной информацией, усложняя поиск основного контента.
Анализ выгруженного дерева заголовков предоставляет техническому специалисту информационную картину, идентичную той, которую получает пользователь программы экранного доступа при генерации структуры документа. Верификация последовательности H2 и H3 в формате простого списка дает возможность выявить и устранить критические нарушения семантики на этапе технического аудита кода.
Сценарий применения: Конкурентный анализ структуры контента
Анализ страниц из топа поисковой выдачи требует изоляции семантического каркаса от визуального оформления и основного текстового массива. Извлечение тегов H2 и H3 формирует чистое оглавление документа конкурента, демонстрируя логику раскрытия темы и методы удовлетворения пользовательского интента.
Процесс оценки структуры контента начинается с обработки целевого URL. На основе предоставленного адреса извлекается иерархический список заголовков, представляющий собой контентную матрицу страницы. Данный формат удобен для выявления закономерностей в архитектуре успешных статей и определения смысловых блоков, которые поисковая система считает обязательными для высоких позиций.
Проектирование структуры и кластеризация интента
Изучение полученного семантического скелета применяется для выявления макро-интента и микро-интентов документа. Сравнение деревьев заголовков нескольких топовых страниц позволяет спроектировать собственную, более глубокую структуру статьи на основе следующих параметров:
- Выявление пересекающихся смысловых блоков, присутствующих у большинства лидеров ниши.
- Определение логики перехода от широкого запроса в узлах H2 к детализации в узлах H3.
- Обнаружение дополнительных подтем, расширяющих общий охват семантики страницы.
Расширение семантического ядра
Дерево подзаголовков выступает источником данных для обогащения семантического ядра. Страницы с высокой видимостью часто оптимизируют узлы H2 и H3 под длинные хвосты в виде прямых вопросов или специфических характеристик продукта. Анализ извлеченного списка дает возможность перехватить эту семантику на этапе подготовки технического задания.
Интерпретация выгруженных данных ложится в основу контент-плана. Ниже приведена схема преобразования элементов структуры конкурента в решения для собственного проекта.
| Уровень и тег конкурента | Роль в исходной структуре | Применение при проектировании статьи |
|---|---|---|
| H2: Ключевые преимущества | Раскрытие основного информационного макро-интента | Создание расширенного блока H2 с интеграцией упущенных конкурентом аспектов |
| H3: Технические спецификации | Группировка точных характеристик и включение LSI | Формирование собственного кластера H3 для полного покрытия смежной семантики |
| H2: Часто задаваемые вопросы | Охват вопросительных интентов и длинных хвостов | Сбор базы вопросов из структур нескольких конкурентов для создания исчерпывающего раздела |
Сведение списков заголовков от нескольких конкурентов в единый массив позволяет выявить контентные пробелы. Интеграция недостающих подтем в собственный план гарантирует формирование наиболее полного ответа на поисковый запрос, обеспечивая высокую стартовую релевантность нового документа.