Проверка иерархии заголовков страницы представляет собой процесс парсинга исходного кода HTML для точного извлечения тегов от H1 до H6. Инструмент сканирует предоставленные данные и визуализирует архитектуру контента в виде наглядного дерева. Пользователь получает возможность изучить реальный структурный каркас документа без учета визуального оформления.
Главная цель такого анализа заключается в поиске логических ошибок во вложенности элементов.
Анализатор принимает на вход целевой URL или фрагмент кода. Сформированная схема применяется для проведения технического SEO-аудита и контроля правильного распределения информации. Строгая последовательность тегов формирует базис для поисковых роботов при сканировании. Валидация структуры также служит основным критерием оценки доступности контента. Программы для чтения экрана опираются исключительно на H-теги для навигации пользователей по разделам.
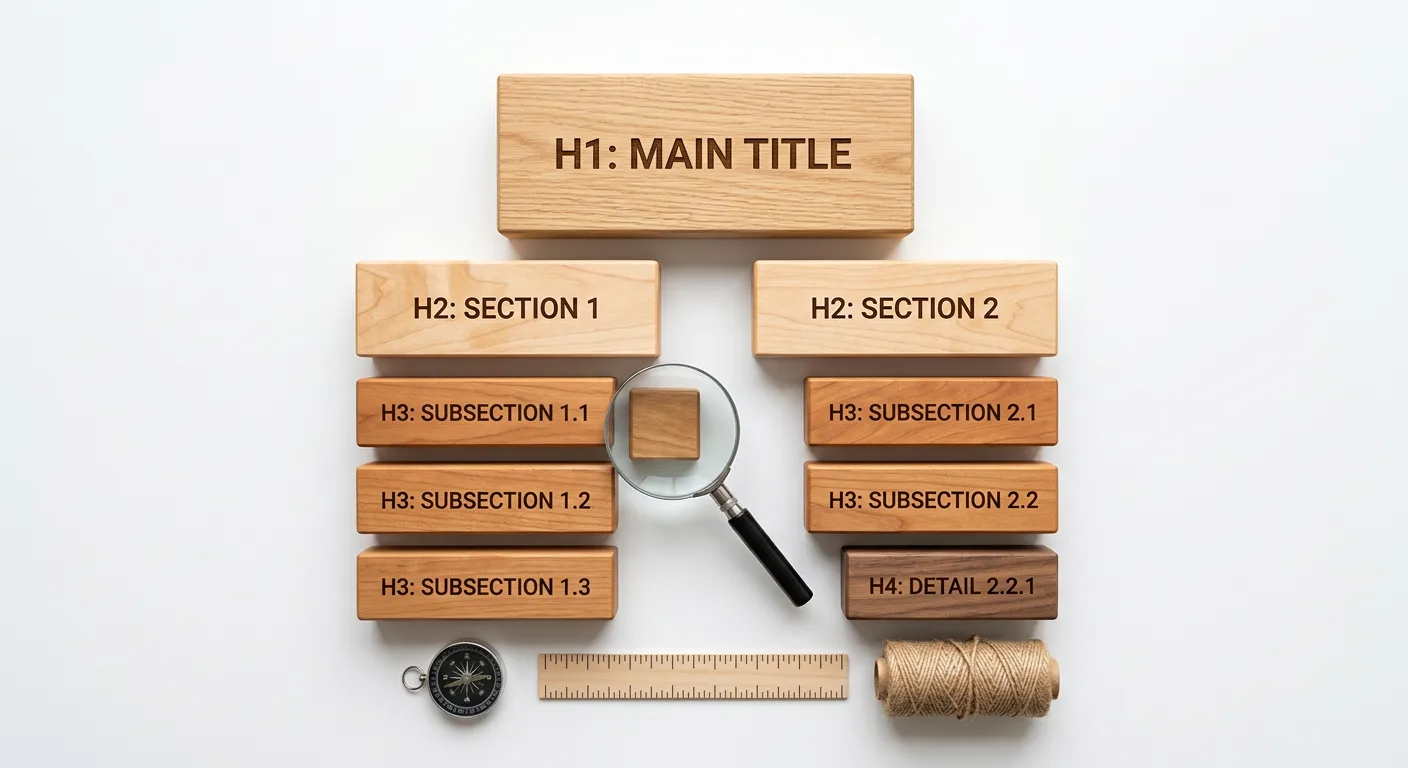
HTML-заголовки и DOM-структура: принцип работы парсера
HTML-заголовки от H1 до H6 выступают базовыми элементами семантической разметки, определяющими приоритет и логическую последовательность контента. В исходном коде страницы эти теги формируют каркас, на который опирается весь остальной текст. Тег H1 обозначает наивысший приоритет и указывает на главную тему документа, тогда как уровни от H2 до H6 применяются для обозначения подразделов с убывающей степенью значимости.
При обработке документа браузер преобразует исходный код в DOM. В этой объектной модели каждый заголовочный тег становится отдельным узлом. Парсер последовательно проходит по дереву DOM, идентифицируя узлы H1-H6 и фиксируя их положение относительно друг друга. Именно этот процесс позволяет извлечь точную последовательность элементов в том порядке, в котором они присутствуют в разметке.
Архитектура документа подразумевает тесную связь заголовочных тегов с семантическими секционными элементами HTML. Анализ структуры показывает, как заголовки работают внутри смысловых блоков:
- section - определяет тематическую группу контента, где заголовок выступает названием конкретного раздела.
- article - выделяет независимый фрагмент информации, внутренняя структура которого строится на собственной иерархии тегов.
- aside - формирует дополнительный или боковой контент, разделы которого структурируются заголовками младших уровней.
Ключевой принцип работы инструмента заключается в анализе исключительно исходного кода HTML с полным игнорированием визуального оформления, заданного через CSS. Парсер извлекает данные, основываясь на технической разметке, а не на внешнем виде элементов. Если обычный текстовый блок визуально увеличен стилями для имитации заголовка, он не попадет в формируемое дерево. И наоборот, если тег H2 визуально скрыт или стилизован под обычный текст, парсер корректно считает его, сохранив его семантический вес. Это обеспечивает построение достоверной карты содержания, которая отражает реальную техническую архитектуру страницы, а не ее графическое представление.
Правила вложенности и архитектура контента
Оценка извлеченного дерева тегов опирается на базовые принципы разметки. Главный критерий корректной структуры документа - строгая последовательная вложенность уровней иерархии. Этот принцип требует, чтобы глубина детализации информации увеличивалась шаг за шагом, без пропуска уровней.
Если за основным тематическим разделом следует подраздел, уровень заголовка должен понижаться ровно на одну ступень. Переход от H2 напрямую к H4 нарушает архитектуру страницы. Подобный разрыв означает потерю родительского узла H3, к которому должен логически относиться контент блока H4. При этом при возврате к более общим темам допускается движение вверх по иерархии на любое количество уровней. Например, после завершения вложенной структуры на уровне H4 можно сразу начать новый глобальный блок с тегом H2.
Архитектура контента строится на разделении массива данных на изолированные смысловые блоки. Каждый заголовочный тег открывает новую логическую секцию, область действия которой продолжается в дереве DOM до появления следующего элемента такого же или более высокого приоритета.
| Паттерн структуры | Последовательность узлов | Оценка логики |
|---|---|---|
| Последовательная детализация | H2, H3, H4 | Корректное углубление темы без пропущенных шагов |
| Возврат к родительскому уровню | H2, H3, H4, H2 | Корректное закрытие ветки и начало нового раздела |
| Разрыв иерархии | H2, H4 | Нарушение архитектуры из-за отсутствия связующего узла H3 |
Особое значение в формировании дерева имеет заголовок первого уровня. Он задает глобальную тему всей страницы и служит корневым узлом для построения вложенной архитектуры. Стандарты использования тега H1 варьируются в зависимости от применяемой спецификации HTML:
- Классический стандарт: Страница содержит ровно один тег H1. Вся последующая структура строго подчинена этому корневому узлу и распределяется по уровням от H2 до H6. Данный подход формирует однозначную и неделимую карту содержания документа.
- Спецификация HTML5: Допускает применение нескольких тегов H1 в рамках одного документа, при условии, что каждый из них выступает заголовком изолированного семантического контейнера. В такой парадигме каждый независимый блок формирует собственную локальную иерархию.
Несмотря на техническую допустимость дублирования в стандарте HTML5, множественные корневые узлы часто усложняют построение единой архитектуры. Анализ структуры, как правило, опирается на базовое правило единственного H1. Появление дополнительных тегов первого уровня вне строгих семантических рамок рассматривается как структурная аномалия, которая размывает логику подчинения контента и нарушает общую иерархию.
Интерпретация результатов проверки структуры
Для проведения анализа структуры документа требуются исходные данные, которые предоставляются в виде URL страницы или фрагмента исходного кода HTML. После парсинга разметки формируется визуализированное дерево заголовков. Данная схема отражает фактическую иерархию тегов от H1 до H6, присутствующих в DOM-дереве, без учета их визуального оформления таблицами стилей. Полученный результат позволяет оценить логику построения контента и выявить технические недочеты в архитектуре.
Анализ полученного вывода сводится к проверке узлов дерева на соответствие правилам последовательной вложенности и семантической корректности. При работе с картой заголовков применяются следующие основные сценарии идентификации ошибок:
- Идентификация пропущенных уровней: Обнаружение участков цепи, где нарушен строгий шаг подчинения. Например, выявление ситуаций, когда после узла H2 сразу следует узел H4, что свидетельствует о разрыве иерархии.
- Обнаружение пустых тегов: Поиск элементов заголовочной разметки, внутри которых отсутствует текстовое содержимое. Подобные узлы создают ложные ветви в дереве и часто возникают из-за ошибок в шаблонах CMS или артефактов визуальных редакторов.
- Выявление дубликатов и множественных корневых узлов: Фиксация полностью совпадающих по тексту заголовков, а также обнаружение нескольких тегов H1, которые расположены вне изолированных семантических тегов разметки.
Для систематизации процесса интерпретации результатов используется сопоставление типа структурной аномалии с ее проявлением в визуализированном дереве.
| Тип структурной аномалии | Проявление в дереве заголовков | Интерпретация результата |
|---|---|---|
| Пропуск уровня (Skipped Heading Level) | Отсутствие промежуточного тега между родительским и дочерним элементами (например, H3 между H2 и H4) | Нарушение логики подчинения. Дочерний контент логически отрывается от родительского блока. |
| Пустой узел (Empty Heading) | Наличие тега H1-H6 без привязанного текста или содержащего только пробельные символы | Загрязнение DOM-структуры неинформативными элементами, формирующими слепые зоны в архитектуре страницы. |
| Несемантический H1 | Появление второго и последующих узлов H1 в общей иерархии без оборачивания в section или article | Размытие корневой темы документа. Создание конфликтующих глобальных веток контента. |
Заключительным этапом анализа является сопоставление извлеченной структуры (header hierarchy) с фактическим распределением информации на отрисованной странице. Визуализированное дерево часто выявляет расхождения между тем, как контент сгруппирован визуально, и тем, как он размечен в коде. Распространенной проблемой является использование тегов H3 или H4 для оформления элементов навигации, заголовков виджетов в боковых панелях или текстовых блоков в подвале сайта.
Такое применение заголовочных тегов встраивает служебные элементы интерфейса в основную смысловую иерархию статьи или документа. В результате при интерпретации отчета можно наблюдать, как второстепенные блоки разрывают логическую цепочку основного контента. Сравнение полученного дерева с визуальным отображением страницы позволяет точно определить участки, где необходимо изменить исходный код HTML, заменив нецелевое использование тегов H1-H6 на корректную семантическую разметку или классы стилей.
Технический SEO-аудит заголовков
Извлеченное дерево DOM-узлов служит прямой картой для поисковых роботов. При сканировании документа краулеры опираются на семантическую разметку HTML для определения иерархии информации и текстовой релевантности. Последовательная структура от главного узла к вложенным создает предсказуемый маршрут парсинга. Логичная архитектура контента позволяет поисковым алгоритмам эффективно расходовать краулинговый бюджет и корректно присваивать вес текстовым блокам в зависимости от их родительского заголовка.
Анализ полученной структуры позволяет оценить логику распределения ключевых слов по уровням документа. Визуализация иерархии помогает специалистам сопоставить карту поисковых запросов с фактическим каркасом страницы, избегая размытия семантического ядра.
- Уровень H1 фиксирует корневую сущность или маркерный запрос всего документа.
- Уровень H2 группирует второстепенные запросы и формирует основные кластеры темы.
- Уровни H3 и ниже охватывают long-tail запросы и узкие информационные нюансы в рамках родительского кластера H2.
Распространенной архитектурной ошибкой, снижающей текстовую релевантность, является подмена семантических заголовков визуальным форматированием. При верстке контента часто используются стили, изменяющие параметры шрифта для имитации заголовочных блоков, при этом сами узлы H1-H6 в коде отсутствуют. Структурный отчет выявляет подобные слепые зоны: если визуально акцентированный блок отсутствует в сгенерированном дереве, поисковые системы интерпретируют его как обычный текстовый параграф без дополнительного семантического веса.
Процесс рефакторинга страницы на основе полученных данных сводится к замене визуального выделения на корректную разметку. Типовой сценарий исправления архитектуры включает следующие шаги:
| Этап аудита | Действие на стороне кода | Влияние на SEO-архитектуру |
|---|---|---|
| Идентификация слепых зон | Поиск текстовых контейнеров с примененными стилями форматирования шрифта, которые выглядят как заголовки, но не присутствуют в дереве H-тегов. | Обнаружение блоков, теряющих потенциал ранжирования из-за отсутствия семантического приоритета. |
| Семантическая замена | Изменение исходного тега на релевантный узел H2-H6 в зависимости от его логической позиции в документе. | Включение текстового блока и связанных с ним ключевых слов в индекс иерархии краулера. |
| Синхронизация стилей | Присвоение новому семантическому узлу исходных CSS-классов для сохранения визуальной сетки. | Обеспечение валидности DOM без разрушения внешнего вида страницы. |
Интеграция семантических узлов вместо визуальных стилей замыкает разрозненные текстовые блоки в единую структуру. При повторной проверке обновленного HTML-кода извлеченная иерархия должна полностью совпадать с визуальным представлением документа, подтверждая готовность страницы к поисковому индексированию.
Влияние иерархии H1-H6 на веб-доступность (Accessibility)
Корректная семантическая разметка, помимо обеспечения машиночитаемости для поисковых систем, формирует базовый уровень доступности веб-контента. Анализ дерева заголовков позволяет оценить UX документа для пользователей, зависящих от вспомогательных технологий. Визуальное форматирование текста передает структуру только зрячим пользователям, тогда как семантические узлы H1-H6 транслируют логику документа на программный уровень.
Навигация посредством скринридеров
Программы для чтения экрана используют иерархию заголовков как основной механизм перемещения по странице. При загрузке документа скринридер компилирует виртуальное оглавление на основе найденных тегов H-уровня. Пользователь получает возможность переключаться между логическими секциями с помощью клавиатурных команд, целенаправленно перемещаясь к нужному блоку и пропуская второстепенный контент. Отсутствие семантических заголовков вынуждает пользователя прослушивать весь исходный код документа линейно, что делает взаимодействие с интерфейсом крайне неэффективным.
Влияние структурных ошибок на UX
Нарушение строгой последовательности вложенности критически ухудшает юзабилити для пользователей с ограниченными возможностями. Проверка визуализированной структуры на логические ошибки применяется для выявления следующих барьеров доступности:
- Пропущенные уровни: Переход от H2 к H4 нарушает предсказуемость интерфейса и дезориентирует пользователя скринридера, создавая ложное впечатление о пропущенном фрагменте контента или техническом сбое.
- Пустые теги: Наличие узла H-уровня без текстового содержимого приводит к озвучиванию служебной информации или пустой паузы, что разрывает контекст чтения.
- Множественные независимые H1: Использование нескольких главных заголовков вне семантических тегов разбиения документа усложняет быструю идентификацию основной темы страницы.
Связь с техническими стандартами доступности
Валидация дерева заголовков является обязательным этапом проверки ресурса на соответствие стандартам WCAG. Извлеченная карта структуры применяется для технического аудита и подтверждения того, что контент удовлетворяет критериям понятности и управляемости.
| Критерий доступности | Требование к разметке DOM | Роль иерархии H1-H6 |
|---|---|---|
| Информационные связи | Структура и логические отношения данных должны быть определены программно. | Теги заголовков передают смысловую подчиненность разделов независимо от их CSS-оформления. |
| Обход блоков | Обеспечение механизма обхода повторяющихся блоков навигации. | Дерево заголовков выступает в роли точек перехода для быстрого программного доступа к основному содержимому. |
| Организация контента | Обязательное использование заголовков для разделения текстовых массивов на логические части. | Корректная вложенность семантических уровней формирует ясный маршрут последовательного чтения. |
Использование результатов парсинга исходного кода позволяет инженерам по доступности выявлять несоответствия между визуальной презентацией страницы и ее программной структурой, гарантируя равный доступ к информации для всех категорий пользователей.