Анализ вхождений слов в HTML-коде решает задачу точного определения наличия заданных строковых значений внутри исходного кода веб-страницы. Инструмент выполняет сплошное сканирование предоставленного текстового массива для поиска конкретного слова или фразы. Выходным результатом операции является точный математический подсчет количества всех найденных совпадений.
Алгоритм обрабатывает всю структуру документа без исключений.
Проверке подвергаются не только видимые пользователю текстовые фрагменты, но и элементы служебной разметки. Система считывает сырые данные целиком. Это означает, что сканирование охватывает содержимое тегов, атрибуты, скрытые блоки и метаданные. Инструмент позволяет автоматизировать рутинный поиск терминов, полностью исключая пропуск значений при работе с объемными фрагментами кода.
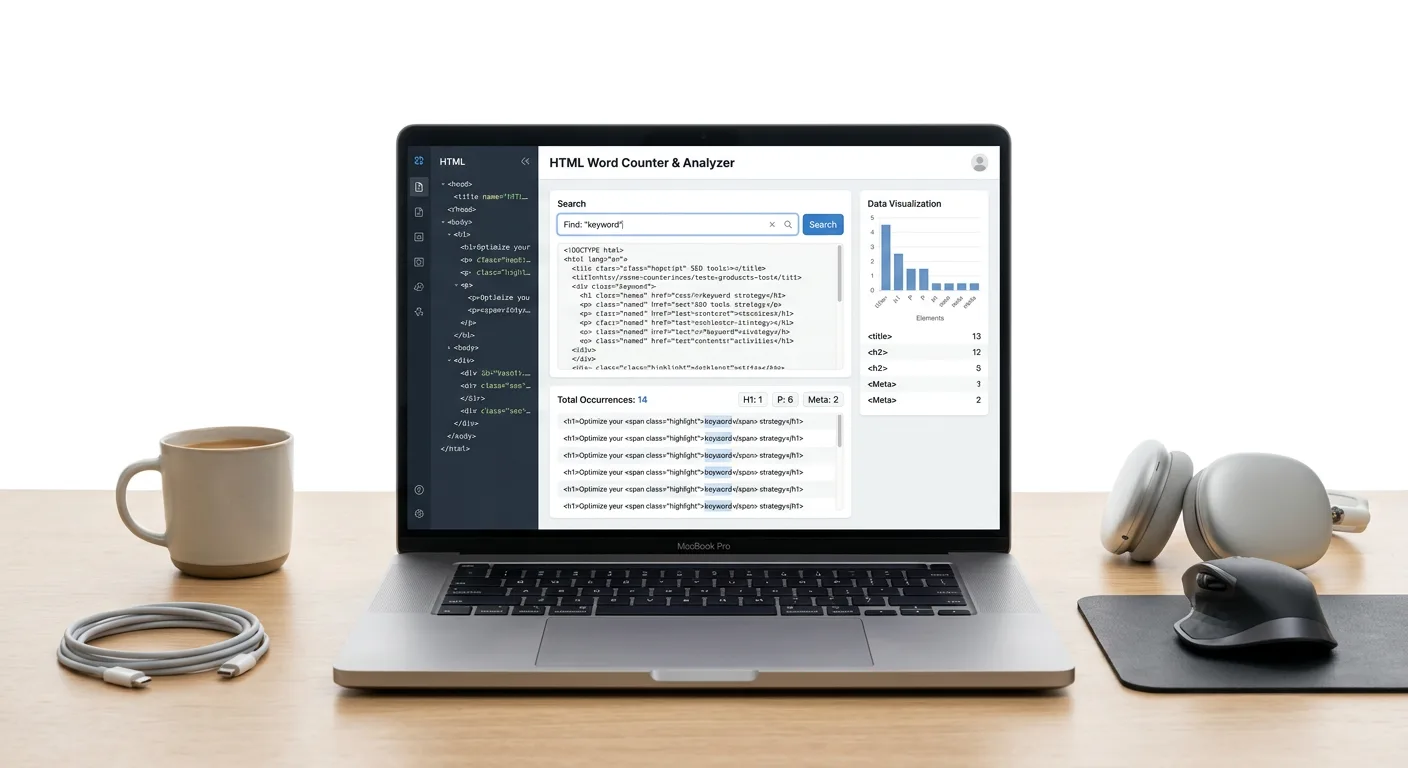
Входные данные и механика подсчета вхождений
Для выполнения операции требуются два базовых набора данных. Первый компонент представляет собой массив сырого HTML-кода анализируемой страницы. Этот массив передается на обработку как сплошной текстовый блок, содержащий всю исходную разметку. Вторым обязательным компонентом является искомое строковое значение. В качестве такого значения выступает конкретное слово, технический параметр или многословная ключевая фраза, совпадения с которой необходимо обнаружить в предоставленном документе.
Механика обработки базируется на линейном сканировании переданного текстового массива.
Процесс поиска инициируется с первого символа структуры, начиная от открывающего тега
<html>
, и продолжается непрерывно вплоть до конца документа, обозначенного закрывающим тегом
</html>
. Алгоритм осуществляет точное сопоставление заданного строкового значения с содержимым всего кода. Анализ выполняется по фактическому совпадению последовательности символов, рассматривая весь код как единую строку, без предварительного парсинга документа на независимые элементы дерева или отсеивания служебных конструкций.
По завершении полного цикла сканирования формируются итоговые выходные данные, интерпретирующие результаты поиска по двум критериям.
- Бинарный статус присутствия. Первичный показатель, фиксирующий сам факт наличия заданного слова в массиве. Результат возвращается в виде однозначного утверждения: строковое значение найдено или не найдено.
- Точное число совпадений. Математический показатель, отражающий сумму всех зафиксированных вхождений. Значение представляет собой целое число, показывающее, сколько раз конкретная ключевая фраза встретилась в пределах всего отсканированного кода от начала до конца.
Если бинарный статус указывает на отсутствие искомого значения, математический показатель совпадений приравнивается к нулю. В случае подтвержденного наличия, итоговое числовое значение служит объективной метрикой для оценки частотности использования конкретного строкового значения в рамках текущего документа.
Специфика поиска по HTML-тегам, атрибутам и текстовым узлам
При анализе веб-страниц фундаментальное различие заключается в объекте поиска: видимом тексте (textContent) и исходном коде документа (innerHTML). Стандартный пользовательский поиск обращается исключительно к отрендеренному содержимому textContent, игнорируя структурную разметку. Анализ сырого массива HTML-кода базируется на содержимом innerHTML. Он охватывает полное содержимое документа, устраняя границу между контентом и служебной информацией. Поиск ведется не только по видимым текстовым узлам, но и по всей структуре разметки.
Процесс сканирования не ограничивается контентной областью страницы, формируемой базовыми блочными элементами
<div>
,
<p>
и строчными тегами
<span>
. Обработка охватывает все служебные зоны DOM, включая атрибуты, значения параметров и скрытые вложенные структуры. Подобный подход позволяет фиксировать вхождения заданного строкового значения в любом узле документа, независимо от того, выводится ли этот узел на экран устройства при рендеринге.
Сплошное сканирование массива кода обеспечивает обнаружение заданных слов в структурных и семантических элементах документа. Типичные объекты такого поиска включают:
-
Метатеги документа. Проверка точного вхождения слов внутри тега
<title>и атрибута content в<meta name="description">. -
Иерархию заголовков. Поиск строковых значений внутри текстовых узлов заголовков всех уровней от
<h1>до<h6>. -
Элементы навигации и ссылки. Обнаружение совпадений в анкорном тексте тега
<a>, а также внутри служебного атрибутаhref. -
Графические элементы. Анализ тегов
<img>на наличие искомого слова в пути к файлу внутри атрибутаsrcи в альтернативном тексте атрибутаalt.
Применение результатов подсчета для On-page SEO-анализа
Полученное точное количество вхождений искомого строкового значения служит базовой метрикой для проведения On-page SEO-анализа. Эти данные позволяют SEO-инженерам и вебмастерам оценивать текстовую релевантность страницы и контролировать качество внедрения семантики на уровне исходного кода.
Зная точное число совпадений конкретного слова или фразы, специалист может вручную рассчитывать ключевые показатели качества контента. Частотность запроса вычисляется путем сопоставления количества найденных вхождений с общим объемом текстовых данных документа. На основе этих вычислений определяется плотность ключевых слов, что критически важно для безопасного ранжирования.
Превышение допустимых значений плотности сигнализирует о переспаме. В профессиональной среде этот показатель часто классифицируется как высокая тошнота текста. Точный математический подсчет совпадений в массиве кода помогает своевременно выявить избыточное использование коммерческих маркеров или поисковых фраз, которое может привести к алгоритмической пессимизации страницы.
Аудит семантического ядра требует проверки распределения точных вхождений ключевых запросов по структуре контента. Специалист последовательно проверяет наличие маркеров из подготовленного кластера, убеждаясь, что заданные слова присутствуют в документе в необходимом объеме.
Практические сценарии использования результатов подсчета включают подтверждение наличия запросов в критически важных зонах документа:
- Оценка оптимизации метаданных. Подтверждение того, что главный фокусный запрос встречается в служебных тегах заданное количество раз, исключая дублирование.
- Анализ архитектуры заголовков. Проверка распределения LSI-фраз и вторичных запросов по текстовым узлам уровней иерархии для формирования правильной семантической структуры.
- Аудит коммерческих элементов. Подсчет точных совпадений транзакционных слов в атрибутах и анкорах элементов навигации для оценки агрессивности внутренней перелинковки.
| Анализируемая метрика | Применяемые данные подсчета | SEO-задача |
|---|---|---|
| Плотность ключевых слов | Точное число вхождений фразы | Выявление переспама и высокой тошноты текста |
| Покрытие семантического ядра | Бинарное подтверждение наличия слов из кластера | Оценка полноты раскрытия интента |
| Оптимизация критических зон | Количество совпадений внутри специфических тегов | Улучшение текстового ранжирования документа |
Использование массива сырого HTML-кода для таких проверок исключает искажения, связанные с динамическим рендерингом стилей. Подсчет опирается на фактическое наличие символов в структуре документа, предоставляя точные исходные данные для последующего ручного или табличного расчета SEO-метрик.
Обнаружение скрытых элементов, скриптов и фрагментов разметки
Поскольку анализ выполняется по всему массиву исходного кода, сканирование не ограничивается видимым текстовым контентом. Такой подход применяется для технической проверки структуры документа и решения базовых задач парсинга. Искомым значением может выступать специфический технический термин, фрагмент синтаксиса или служебный атрибут, который не отображается в окне браузера при финальном рендеринге страницы.
Поиск точных строковых совпадений используется в следующих сценариях технического аудита:
- Поиск фрагментов кода внутри тегов <script> и <style>. Операция позволяет находить встроенные функции, идентификаторы систем веб-аналитики, глобальные переменные или специфические правила стилизации.
- Обнаружение заданных классов или идентификаторов в скрытых полях. Применяется для поиска селекторов внутри элемента <form>, проверки элементов управления и невидимых инпутов.
- Проверка наличия структурированной микроразметки. Подтверждение внедрения схем данных через поиск характерных строковых значений, словарей или разметки формата JSON-LD.
- Идентификация параметров кодировки. Поиск совпадений по словам charset и utf-8 в служебном блоке <head> для верификации технических настроек передачи символов.
| Область поиска в коде | Пример искомого значения | Практическая задача |
|---|---|---|
| Служебный блок <head> | utf-8 | Проверка объявления кодировки документа |
| Блоки <script> | GTM- | Поиск идентификаторов интегрированных трекеров |
| Элементы <form> | type="hidden" | Обнаружение скрытых полей передачи данных |
| Контейнеры микроразметки | application/ld+json | Верификация наличия семантических словарей |
Результаты поиска невидимых элементов и фрагментов разметки предоставляют специалистам фактические данные о наличии необходимых узлов в дереве документа. Поиск по сырому коду позволяет контролировать качество технической оптимизации и находить внедренные скрипты без применения сложных алгоритмов парсинга.