Оценка повторяемости ключевых слов требуется для выявления переоптимизации и контроля распределения поисковых запросов в контенте. Онлайн-инструмент Qivrora автоматизирует этот процесс, анализируя исходный текст на наличие избыточных дублей. На вход подается текстовый массив или готовая статья. После обработки алгоритм формирует точную статистическую сводку.
Главная задача такого анализа состоит в сохранении естественности материала при строгом соблюдении технических требований поисковых систем.
Пользователь загружает исходный текст в рабочую область. Инструмент выполняет лексический разбор документа и рассчитывает метрики частотности. Результат выдается в виде структурированного списка с указанием точного количества вхождений каждого слова. Отдельным значением фиксируется плотность ключей, которая отражает процентное соотношение целевых фраз к общему объему символов или слов. Полученные числовые данные позволяют объективно измерить уровень заспамленности и скорректировать документ.
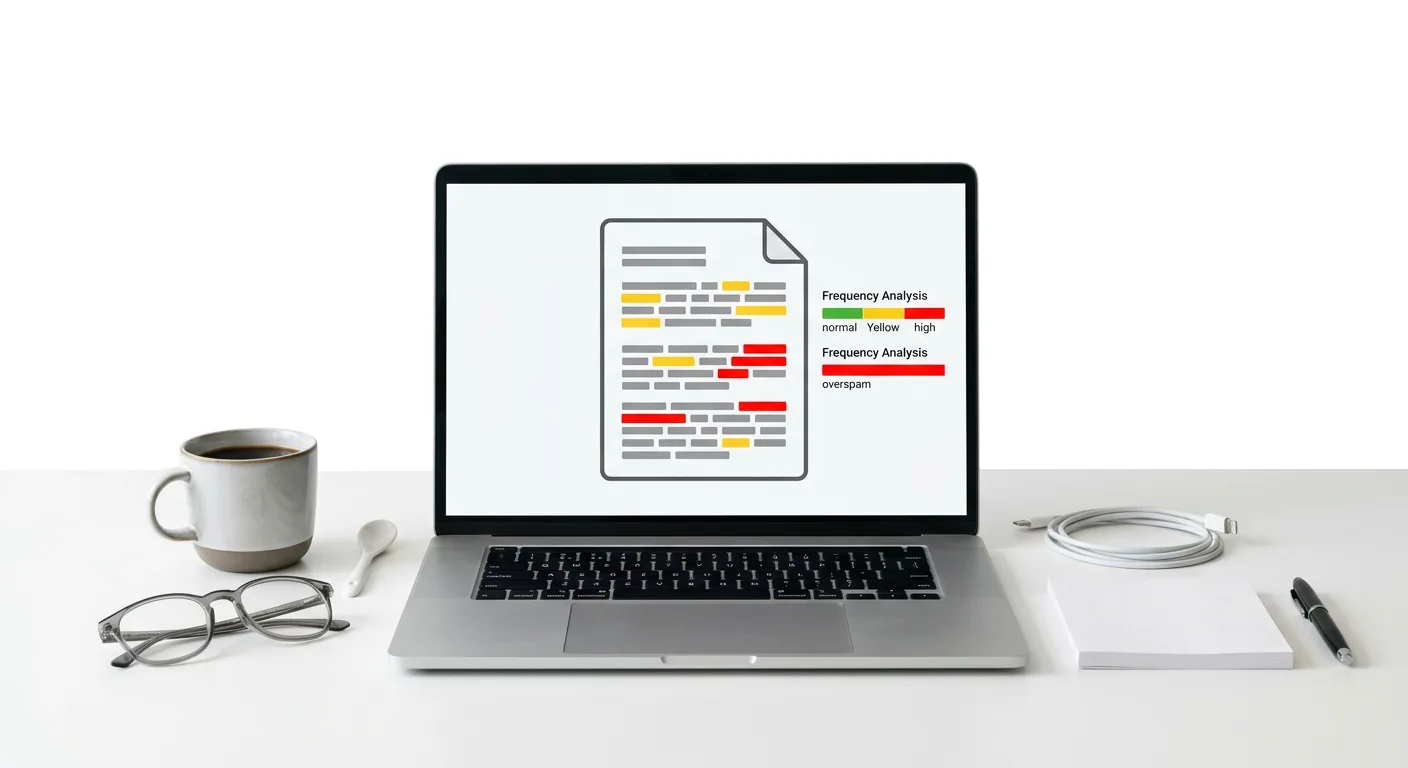
Переоптимизация контента и влияние текстовых фильтров
Переоптимизация контента возникает при искусственном насыщении текста целевыми поисковыми запросами. Набивка ключевых слов, известная как keyword stuffing, представляет собой метод манипуляции видимостью документа, при котором одинаковые фразы многократно внедряются в предложения. В результате формируется текстовый массив, структура которого подчинена не передаче полезной информации, а попыткам воздействовать на факторы ранжирования.
Для пресечения подобных практик поисковые системы применяют специализированные алгоритмы и строгие текстовые фильтры. Алгоритм Баден-Баден направлен на оценку стилистического качества, обнаруживая неестественные языковые конструкции, перегруженные коммерческими запросами. Алгоритм SpamBrain использует механизмы машинного обучения для глубокого семантического анализа, распознавая паттерны спамного текста и выявляя скрытую набивку слов независимо от их морфологической формы.
Чрезмерное повторение целевых ключей влечет за собой автоматическую пессимизацию документа в ТОП выдачи. Алгоритмы классифицируют переоптимизированную страницу как манипулятивную, что критически снижает ее итоговую релевантность.
Негативное воздействие текстовых фильтров на ранжирование страниц происходит по нескольким направлениям:
- Потеря позиций по продвигаемым запросам из-за принудительного понижения веса заспамленного документа.
- Исключение страницы из поискового индекса при критическом нарушении стандартов качества текстового контента.
- Наложение глобальных хостовых санкций на веб-ресурс в случае систематического и масштабного использования keyword stuffing.
- Ухудшение поведенческих показателей ввиду низкой удобочитаемости, что дает поисковым системам дополнительный сигнал о нерелевантности материала.
Современные поисковые системы анализируют документ комплексно. Если концентрация повторяющихся слов нарушает естественные языковые нормы, алгоритм игнорирует техническое наличие целевых фраз и присваивает тексту статус малополезного. Понимание этих механизмов и контроль частотности необходимы для предотвращения алгоритмических ограничений и обеспечения стабильного присутствия страницы в результатах поиска.
Математика частотного анализа: плотность и тошнота текста
Оценка качества документа требует перевода лингвистических характеристик в измеримые математические величины. Частотный анализ опирается на вычисление базовых метрик, которые позволяют объективно определить степень насыщенности контента целевыми запросами. Ключевыми параметрами заспамленности выступают плотность ключевых слов, а также показатели классической и академической тошноты.
Расчет плотности ключевых слов
Плотность отражает удельный вес конкретной лексемы или поисковой фразы в общем объеме документа. Данная метрика вычисляется как отношение частоты вхождений искомого слова к общему количеству текстовых слов, выраженное в процентах.
Математическая модель расчета включает следующие этапы вычислений:
- Подсчет точного количества повторений анализируемого слова.
- Деление полученного значения на общее число слов в тексте.
- Умножение результата на сто для получения итогового процентного показателя.
Вычисление плотности позволяет контролировать распределение семантической нагрузки. Равномерное распределение ключей свидетельствует о естественности текста, тогда как резкие математические отклонения и высокие проценты сигнализируют о возможной набивке конкретным запросом.
Тошнота текста: классический и академический показатели
Тошнота текста представляет собой комплексный показатель, оценивающий избыточность лексических повторов. В частотном анализе применяются два метода расчета этой метрики, каждый из которых имеет собственную логику и выявляет разные типы неестественности контента.
Классическая тошнота вычисляется путем извлечения квадратного корня из количества вхождений самого частого слова в документе. Этот подход направлен на фиксацию абсолютных пиков повторений. Если наиболее частотная единица встречается в исходном тексте шестнадцать раз, показатель классической тошноты составит четыре. Данная метрика не зависит от общего объема документа и реагирует исключительно на максимальную концентрацию одного единственного слова.
Академическая тошнота рассчитывается как доля самых частотных значимых слов по отношению к общему размеру текста. В отличие от классического метода, при вычислении академической тошноты в числитель попадает не один пиковый повтор, а сумма вхождений группы наиболее популярных лексем. Результат выражается в процентах и указывает на общую семантическую перегруженность.
Предметная разница между двумя метриками заключается в масштабе проводимой оценки:
| Метрика заспамленности | Математическая формула | Предметное назначение оценки |
|---|---|---|
| Плотность ключевых слов | Отношение числа вхождений к общему числу слов в процентах | Оценка доли конкретного запроса в общем объеме документа |
| Классическая тошнота | Квадратный корень из количества вхождений самого частого слова | Выявление локальной переоптимизации одним повторяющимся словом |
| Академическая тошнота | Доля самых частотных значимых слов к общему размеру текста | Оценка общей стилистической однообразности и перегруженности семантикой |
Классическая тошнота точно указывает на локальный переспам одной конкретной формой, что характерно для прямой набивки. Академическая тошнота оценивает текстовый массив комплексно, выявляя ситуации, когда автор использует множество разных продвигаемых фраз, нарушая общий баланс лексики.
Принципы обработки лемм, n-грамм и стоп-слов
Машинный анализ текста требует предварительной нормализации исходных данных. Простой подсчет совпадений строк приводит к искажению статистики, так как одно и то же слово используется в разных падежах, числах, родах и временах. Для точного выявления частотности применяется алгоритмическая обработка словарного массива, разделяющая текст на измеримые единицы.
Первым этапом нормализации выступает лемматизация - процесс приведения каждой распознанной лексемы к ее базовой словарной форме (лемме). Для существительных это именительный падеж единственного числа, для глаголов - инфинитив. Лемматизация позволяет сгруппировать все словоформы продвигаемого запроса в единый кластер.
Группировка по леммам обеспечивает точный подсчет реальной частотности семантической единицы. Если не приводить слова к базовой форме, математический алгоритм посчитает различные окончания как совершенно разные слова, что искусственно занизит показатели плотности и скроет фактический переспам.
Оценка семантической структуры не ограничивается одиночными словами. Для выявления заспамленности сложными конструкциями и точными LSI-фразами применяется анализ n-грамм - последовательностей из нескольких слов, идущих подряд в пределах одного предложения:
- Биграммы состоят из двух связанных слов. Их вычисление помогает выявить избыточное использование устойчивых словосочетаний и парных терминов.
- Триграммы включают три слова и указывают на чрезмерное повторение длинных коммерческих запросов или специфических конструкций.
Подсчет n-грамм выявляет структурный переспам. Высокая частотность конкретной биграммы или триграммы свидетельствует о неестественной конструкции текста, когда многословная LSI-фраза внедряется в исходном виде без разбавления другими лексемами.
Параллельно с выделением значимых слов и фраз происходит фильтрация шумовых элементов. К ним относятся стоп-слова: предлоги, союзы, частицы, местоимения, междометия, а также цифры и спецсимволы. Объем этих элементов формирует показатель водности текста - долю лексики, которая выполняет связующую функцию, но не несет самостоятельной смысловой нагрузки.
Исключение стоп-слов формирует чистый массив данных для математической оценки:
| Категория лексики | Характеристика элементов | Участие в расчете метрик |
|---|---|---|
| Значимые леммы | Существительные, глаголы, прилагательные, наречия | Формируют числитель и знаменатель при вычислении академической частоты |
| Стоп-слова | Предлоги, союзы, частицы, вводные конструкции | Определяют уровень водности, полностью исключаются из ядра значимых слов |
| N-граммы | Устойчивые связки из двух или трех лексем | Оцениваются как самостоятельные смысловые единицы для поиска фразового переспама |
Фильтрация водности напрямую влияет на расчет академической частоты значимых слов. Исключение неинформативных элементов из обрабатываемого массива гарантирует, что алгоритм сопоставляет популярные леммы не с общим объемом документа, а исключительно с полезной семантической массой текста.
Порядок проведения онлайн-проверки текста
Процесс семантического анализа начинается с передачи исходных данных. Проверяемый документ или отдельный блок текста помещается в поле ввода инструмента. Исходным материалом выступает текстовый массив, который алгоритм принимает для последующего математического и лингвистического разбора в соответствии с базовыми правилами лемматизации и исключения стоп-слов.
После завершения цикла обработки формируется аналитический отчет. Сгенерированные выходные данные представляют собой структурированный массив метрик, позволяющий оценить текстовый документ сразу по нескольким параметрам:
- Список наиболее частотных слов с указанием точного количества вхождений каждой словарной единицы.
- Процентное значение плотности ключей, рассчитанное по отношению к общему количеству лексем в проверяемом блоке.
- Показатели заспамленности, количественно отражающие текущий уровень тошноты документа.
- Визуальное облако слов, графически демонстрирующее семантическое ядро текста через пропорциональное изменение размера наиболее употребляемых элементов.
Сгенерированный частотный словарь и сопутствующие метрики применяются для оценки соответствия документа техническому заданию SEO-специалиста. Проверка базируется на сопоставлении фактических результатов машинного подсчета с целевыми требованиями, выдвигаемыми к посадочной странице.
Интерпретация полученных выходных данных при аудите контента выполняется по трем ключевым направлениям:
| Анализируемый параметр | Контекст технического задания | Интерпретация метрики |
|---|---|---|
| Иерархия частотного словаря | Присутствие продвигаемых LSI-фраз на вершине списка | Главный целевой запрос должен занимать лидирующие позиции по количеству вхождений, опережая вспомогательную и общетематическую лексику. |
| Процент плотности ключей | Соблюдение лимитов концентрации слов | Превышение установленного порога плотности прямо сигнализирует о явной переоптимизации анализируемого фрагмента. |
| Показатели заспамленности | Удержание значений тошноты в безопасной зоне | Выход за границы нормативных значений индикатора указывает на дисбаланс между повторяющимися значимыми леммами и общим объемом документа. |
Точная расшифровка выходных параметров позволяет определить, насколько естественно ключевые фразы распределены по структуре документа. Анализ облака слов дает мгновенный срез приоритетных тематик текста глазами поискового робота. Если маркерные запросы теряются на фоне второстепенных понятий или, наоборот, формируют критический процент плотности, результаты проверки фиксируют отклонение от заданных SEO-стандартов.
Корректировка текста: устранение повторов и улучшение стилистики
Выявленные на этапе проверки отклонения частотного словаря требуют вмешательства в структуру контента. Полученные метрики плотности и тошноты служат прямыми указателями на участки, где концентрация одинаковых лемм превышает установленные нормы. Доработка материала сводится к равномерному распределению смысловой нагрузки и переписыванию фрагментов с явной переоптимизацией.
Методы снижения заспамленности документа
Превышение академической или классической тошноты устраняется за счет разбавления частотного ядра. Базовый подход заключается в замене прямых повторов и тавтологий на синонимичные конструкции или релевантные LSI-ключи. Такая замена позволяет сохранить тематическую направленность абзаца, снизив математическую концентрацию одного конкретного слова. Повышение семантической связности требует комплексной переработки предложений.
Практические шаги по нормализации частотного словаря включают следующие действия:
- Замена повторяющихся существительных на местоимения в смежных предложениях для исключения прямого дублирования.
- Внедрение узкопрофильной терминологии вместо многократного использования широкого базового запроса.
- Перестроение сложных синтаксических конструкций, требующих вынужденного повторения одних и тех же предлогов или союзов.
- Объединение нескольких коротких предложений с одинаковыми подлежащими в одно емкое предложение с однородными членами.
Улучшение удобочитаемости и удаление штампов
Высокая доля неинформативной лексики часто обусловлена наличием речевых штампов и канцеляризмов. Подобные конструкции увеличивают объем текста без добавления смысла и снижают общую удобочитаемость. Очистка материала от избыточных вводных слов, сложных отглагольных существительных и шаблонных фраз делает изложение естественным и понятным для аудитории.
Типовые паттерны замены сложных конструкций при стилистической доработке распределяются по следующим категориям:
| Проблемная конструкция | Механика корректировки | Естественный формат |
|---|---|---|
| В настоящее время осуществляется реализация | Замена отглагольного существительного на активный глагол | Специалисты реализуют |
| По той простой причине, что | Сокращение сложного составного союза до одного слова | Поскольку |
| Осуществлять деятельность по производству деталей | Удаление расщепленного сказуемого и лишней абстракции | Производить детали |
Систематическая чистка подобных конструкций прямо отражается на итоговых результатах повторного частотного анализа. Сокращается доля вспомогательных частей речи, а значимые термины распределяются по тексту без формирования искусственных пиков плотности. Результатом корректировки становится семантически емкий документ, отвечающий техническим требованиям и сохраняющий высокую информативность для пользователей.