Выявление канонических ссылок на несуществующие страницы позволяет найти критические сбои в технической архитектуре сайта. Инструмент Qivrora выполняет онлайн-поиск некорректных адресов, которые заданы в теге canonical или HTTP-заголовке Link, но при прямом обращении возвращают серверный статус 404 Not Found. Это прямая сверка заявленного приоритета с фактической доступностью целевого URL. Поисковой робот получает команду считать определенный адрес основным, переходит по нему и сталкивается с отсутствующим контентом.
Такой конфликт директив расходует краулинговый бюджет впустую.
Принцип выявления ошибки строится на последовательном парсинге исходного HTML-кода проверяемых страниц. Алгоритм извлекает адреса из атрибутов канонизации и инициирует к ним отдельный HTTP-запрос для фиксации итогового кода ответа сервера. Ситуация становится критичной для SEO, поскольку исходная страница обычно отдает корректный статус 200 OK, но направляет накопленный ссылочный вес в тупик. Поисковая система физически не может передать сигналы ранжирования удаленному или перемещенному документу.
Регулярный поиск подобных аномалий предотвращает раздувание индекса. Если техническая разметка массово ссылается на 404 статусы, алгоритмы ранжирования начинают игнорировать некорректные указания и принудительно индексируют технические дубли.
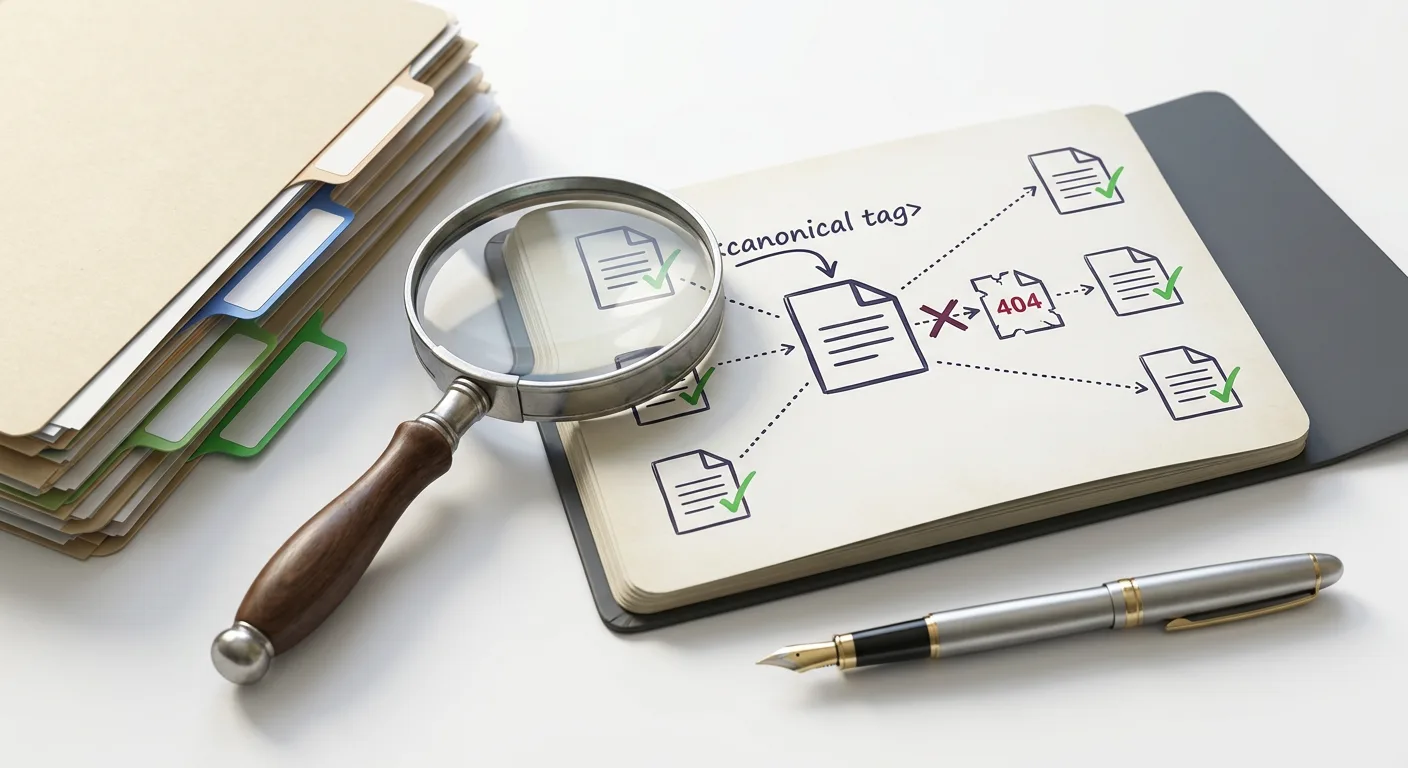
Техническая суть ошибки: тег canonical указывает на 404 страницу
Суть проблемы заключается в системном противоречии между доступностью текущего документа и недоступностью его заявленной главной версии. При прямом обращении к странице сервер успешно отдает статус 200 OK, подтверждая наличие контента. Однако при парсинге технической информации обнаруживается директива канонизации, указывающая на целевой URL, который при запросе возвращает код состояния 404 Not Found или 410 Gone.
Конфликт инструкций формируется на уровне базовой разметки или серверных ответов. Указание приоритетного адреса реализуется через элемент link rel="canonical" в блоке head исходного HTML-кода либо через специальный HTTP-заголовок Link. Поисковый робот считывает эту аннотацию как строгую рекомендацию к объединению параметров страниц, но физически не может ее выполнить из-за отсутствия конечного узла по указанному адресу.
HTTP/1.1 200 OK
Link: <https://example.com/target-404-url>; rel="canonical"

<head>
  <link rel="canonical" href="https://example.com/target-404-url">
</head>
Данный архитектурный сбой необходимо четко отделять от стандартных мертвых ссылок, встречающихся в текстовом наполнении сайта. Разница заключается в локализации элементов и их семантическом назначении в структуре веб-ресурса.
- Мертвые контентные ссылки располагаются в контейнере body исходного кода. Они предназначены для пользовательской навигации и базового распределения внутреннего веса. Возврат статуса 4XX при переходе по такому пути прерывает навигацию пользователя, но является ошибкой уровня контента страницы-донора.
- Некорректная директива канонизации интегрируется на уровне технической конфигурации вне области видимости пользователя. Она выступает императивным служебным сигналом исключительно для алгоритмов поисковых систем. Наличие 404 статуса по целевому адресу ломает саму логику определения главного документа среди технических дублей.
| Характеристика элемента | Битая ссылка в контенте | Некорректная директива канонизации |
|---|---|---|
| Расположение в коде | Внутри контейнера body | Секция head или HTTP-заголовки ответа |
| Область применения | Видимая часть интерфейса | Служебные метаданные документа |
| Техническая задача | Связывание страниц между собой | Объявление приоритетного URL для алгоритмов |
Принцип работы инструмента и алгоритм обнаружения ошибок
Для выполнения проверки требуется подготовить исходный массив данных. Входными данными выступает список проверяемых URL, которые подлежат техническому анализу. Предоставленный перечень адресов инициирует последовательный цикл запросов к указанным документам.
Процесс аудита базируется на пошаговом извлечении служебных директив и проверке фактической доступности целевых узлов. Алгоритм обнаружения ошибок включает следующие этапы обработки:
- Сканирование исходного HTML-кода и HTTP-заголовков проверяемых страниц. Происходит обращение к заданным URL для загрузки содержимого секции head и заголовков ответа сервера.
- Парсинг значений тега link с атрибутом rel="canonical". Извлекается заявленный адрес канонизации, который может быть задан как полный абсолютный URL или как относительный путь от текущего документа.
- Отправка HTTP-запроса к извлеченному каноническому URL. Осуществляется прямое сетевое обращение по найденному адресу для проверки его работоспособности.
- Определение кода состояния. Анализируется ответ сервера по каноническому адресу с целью выявления статусов группы 4XX, указывающих на отсутствие целевого документа.
Сбор данных происходит строго на уровне технической разметки и сетевых протоколов. Выходные данные генерируются по факту завершения цикла проверки всех переданных URL.
Результатом выполнения операции является диагностический отчет, сопоставляющий проверенные документы с обнаруженными конфликтами. Выходные данные формируются в виде парных значений, что позволяет точно идентифицировать источник и цель нерабочей директивы.
| Исходный URL | Битый канонический URL | Фактический статус ответа сервера |
|---|---|---|
| Адрес первоначально сканируемой страницы | Извлеченное недействительное значение директивы canonical | Возвращенный HTTP-код группы 4XX |
Полученная структура данных изолирует проблемные участки конфигурации и предоставляет точную сводку связей между существующими страницами и несуществующими адресами канонизации, заявленными в их коде.
Влияние 404-каноникализации на краулинг и индексируемость
Наличие атрибута rel="canonical", указывающего на несуществующий URL, создает критическое противоречие в инструкциях для поисковых систем. При обработке таких страниц Googlebot и другие краулеры сталкиваются с логическим тупиком: исходная страница отдает статус 200 OK и заявляет о наличии приоритетной версии, однако запрос к этой версии возвращает статус 404 Not Found. Подобная конфигурация ломает стандартный процесс обработки документов и приводит к серии негативных последствий для технического состояния сайта.
Сбой консолидации ссылочного веса и PageRank
Основная функция тега каноникализации заключается в передаче сигналов ранжирования, включая PageRank, от дубликатов к основной странице. При указании целевого URL со статусом 404 эта цепочка обрывается. Ссылочный вес, накопленный исходными страницами за счет внутренних и внешних ссылок, направляется на несуществующий документ. Передача веса уходит в никуда, и общий потенциал ранжирования группы страниц обнуляется, поскольку целевой узел не способен аккумулировать передаваемые метрики.
Конфликт сигналов ранжирования и потеря видимости
Поисковый робот использует канонические ссылки для кластеризации идентичного контента и объединения поведенческих, текстовых и ссылочных сигналов вокруг единого URL. Указание на битый адрес делает такую консолидацию невозможной. Поисковый бот не может объединить сигналы дублей в единый профиль. Страницы-копии теряют способность выступать в поисковой выдаче как один релевантный документ, что приводит к размытию семантики и общему падению поисковой видимости кластера запросов.
Нецелевой расход краулингового бюджета
Алгоритмы сканирования обязаны проверять адреса, заявленные в технической разметке. Обнаружение битой канонической ссылки инициирует отправку HTTP-запроса к отсутствующему документу. В масштабах сайта с тысячами некорректно настроенных страниц краулер начинает тратить выделенные лимиты на постоянный опрос несуществующих URL. Процесс бесполезной траты серверных ресурсов включает следующие этапы:
- Сканирование исходного документа, отдающего корректный HTTP-ответ.
- Извлечение целевого адреса из технической разметки.
- Постановка нерабочего URL в приоритетную очередь краулинга.
- Выполнение фактического сетевого запроса к целевому адресу и фиксация ошибки 404.
Циклическое повторение данной процедуры приводит к нецелевому расходу краулингового бюджета. Обход новых, обновленных и критически важных страниц существенно замедляется, так как лимиты сканирования расходуются на тупиковые ветки.
Игнорирование директивы и раздувание индекса
Поисковые системы воспринимают атрибут rel="canonical" как строгую рекомендацию, а не как абсолютное правило. Стабильный возврат кода 4XX по целевому адресу каноникализации расценивается алгоритмами ранжирования как техническая ошибка конфигурации. В результате робот начинает полностью игнорировать ошибочный тег. Система переходит к самостоятельной оценке контента и начинает индексировать технические дубли.
База поисковой системы заполняется страницами с параметрами сортировки, идентификаторами сессий, UTM-метками и результатами фильтрации. Возникает риск раздувания индекса мусорными страницами, что провоцирует снижение общего показателя качества сайта и алгоритмическую пессимизацию за каннибализацию выдачи.
| Метрика SEO | Техническое следствие 404-каноникализации | Результат для поисковой системы |
|---|---|---|
| PageRank | Сброс передаваемых метрик на несуществующий узел | Потеря ссылочного веса кластером страниц |
| Кластеризация | Невозможность объединения сигналов дубликатов | Снижение релевантности и позиций в выдаче |
| Краулинг | Регулярный опрос битых адресов из разметки | Истощение краулингового бюджета |
| Индексация | Отказ алгоритма от соблюдения ошибочной директивы | Попадание технических дублей в индекс |
Типичные сценарии возникновения битых канонических ссылок
Ошибки маршрутизации в директивах каноникализации редко возникают как единичные технические сбои. В ходе аудита чаще всего выявляются системные паттерны, связанные с логикой работы серверной части, особенностями генерации HTML-шаблонов или нарушением процессов управления контентом.
Физическое удаление основной страницы
Критический конфликт возникает при удалении эталонного документа без синхронного обновления разметки на зависимых дубликатах. Если основная товарная карточка или базовая статья физически удаляется с сервера с закономерным возвратом статуса 404, а страницы с параметрами сортировки, идентификаторами сессий или UTM-метками сохраняют прежний атрибут rel="canonical", формируется тупиковая ветвь сканирования. Изолированные технические дубли продолжают транслировать поисковому роботу директиву на уже несуществующий узел.
Сбои алгоритмов самоканонизации в CMS
Динамические системы управления контентом часто используют автоматическую генерацию самореферентных ссылок. При редактировании URL-адреса документа, например при изменении алиаса или переносе страницы в другую категорию, может возникнуть рассинхронизация базы данных и кэшированных шаблонов. CMS успешно формирует новый физический адрес, по которому страница отдает код 200, но в блоке HEAD сохраняется жестко закодированный старый URL. В результате страница начинает указывать сама на себя по устаревшему адресу, который сервер теперь обрабатывает как 404 Not Found.
Использование некорректных относительных путей
Генерация атрибута каноникализации с использованием относительных путей вместо абсолютных URL приводит к ошибкам конкатенации адресов на стороне парсера поисковой системы. Если в исходном коде прописан относительный путь, краулер присоединяет его к текущему уровню вложенности сканируемого документа.
Технические последствия внедрения относительных путей в разметку:
- Формирование многократно дублированных сегментов пути при глубокой вложенности.
- Создание синтетических URL, не предусмотренных правилами серверного роутинга.
- Неизбежный возврат сервером кода состояния 4XX при попытке краулинга сформированного адреса.
Изменение архитектуры сайта
Глобальные изменения структуры, такие как редизайн, перенос разделов или смена логики формирования URL каталога, требуют строгого контроля технической разметки. Если новые страницы генерируются со старыми значениями канонических тегов, возникает массовое появление битых директив. Отсутствие настроенной цепочки перенаправлений для старых канонических URL превращает весь кластер обновленных страниц в источник технических ошибок, отправляя поискового робота на несуществующие адреса прошлой архитектуры.
Интерпретация результатов и устранение некорректных адресов
Сформированный массив выходных данных представляет собой пары исходных документов и связанных с ними битых директив. Эта информация служит техническим заданием для внесения изменений в шаблоны генерации страниц или правила серверной маршрутизации. Выбор метода устранения ошибки зависит от роли сканируемого URL в архитектуре сайта и исторической ценности мертвого адреса.
Замена битого адреса на валидный абсолютный URL
Если проверяемый документ является фактическим дублем или параметрической копией, он должен указывать на существующую основную версию. Устранение ошибки сводится к корректировке аннотации link в разделе HEAD. Некорректный URL заменяется на актуальный адрес, который гарантированно отдает серверный статус 200 OK. При формировании нового значения необходимо использовать исключительно абсолютный URL, включающий протокол и доменное имя, чтобы исключить риск повторного возникновения ошибок относительных путей при парсинге.
Удаление атрибута каноникализации
В ситуациях, когда исходная страница обладает уникальным контентом, представляет коммерческую или информационную ценность и должна участвовать в поиске, наличие ошибочной директивы блокирует ее сканирование. Решением является полное удаление атрибута rel="canonical" из исходного кода. Без данной директивы поисковый робот начинает обрабатывать документ как самостоятельную и полноправную единицу индекса. В качестве альтернативы полному удалению допускается настройка корректной самоканонизации, при которой страница ссылается сама на себя по валидному абсолютному адресу.
Настройка постоянных перенаправлений
Наиболее сложный сценарий возникает, когда несуществующий канонический адрес ранее находился в индексе, собирал поисковый трафик или накопил внешний ссылочный профиль. Простая замена или удаление тега приведет к безвозвратной потере исторического SEO-веса. Для спасения накопленных сигналов ранжирования применяется настройка 301 редиректа.
Алгоритм действий при спасении ссылочного профиля включает следующие этапы:
- Определение релевантной страницы-преемника, отдающей код 200 OK.
- Настройка правила 301 редиректа на стороне веб-сервера с мертвого канонического адреса на выбранного преемника.
- Обновление тега canonical на всех исходных дублях для прямого указания на нового преемника, минуя цепочку перенаправлений.
Выбор оптимального технического решения можно систематизировать на основе статуса исходного документа.
| Характеристика исходной страницы | Рекомендуемый метод устранения ошибки | Ожидаемый результат для краулера |
|---|---|---|
| Нецелевой дубль или страница с GET-параметрами | Замена адреса в аннотации link на валидный абсолютный URL основной страницы | Консолидация URL и корректная передача сигналов ранжирования |
| Уникальный документ, подлежащий индексированию | Полное удаление атрибута каноникализации из раздела HEAD | Признание URL самостоятельным и добавление в поисковую базу |
| Дубль, ссылающийся на 404 страницу с историческим трастом | Внедрение 301 редиректа с мертвого адреса и обновление тегов на дублях | Перенос накопленного SEO-веса на релевантный рабочий документ |