Отбор адресов по коду ответа - это автоматизированная операция для сегментации списков URL на основе их текущего HTTP-статуса. Инструмент выполняет массовую проверку массива ссылок и оставляет только те, которые возвращают заданные пользователем ответы сервера. В качестве входных данных используется сырой текстовый список адресов. На выходе формируется отфильтрованный перечень URL, строго соответствующий выбранным критериям.
Весь процесс фильтрации выполняется онлайн. Система самостоятельно отправляет запросы к хостам и анализирует возвращаемые заголовки.
Подобный подход применяется при сортировке объемных массивов данных, полученных при сканировании ресурсов. При обработке технических выгрузок в форматах CSV или JSON возникает задача отделить корректно работающие страницы от настроенных редиректов или удаленных документов. Запуск фильтрации по конкретным числовым кодам позволяет мгновенно сузить набор данных. Пользователь получает готовый список ссылок для экспорта, исправления ошибок или передачи разработчикам.
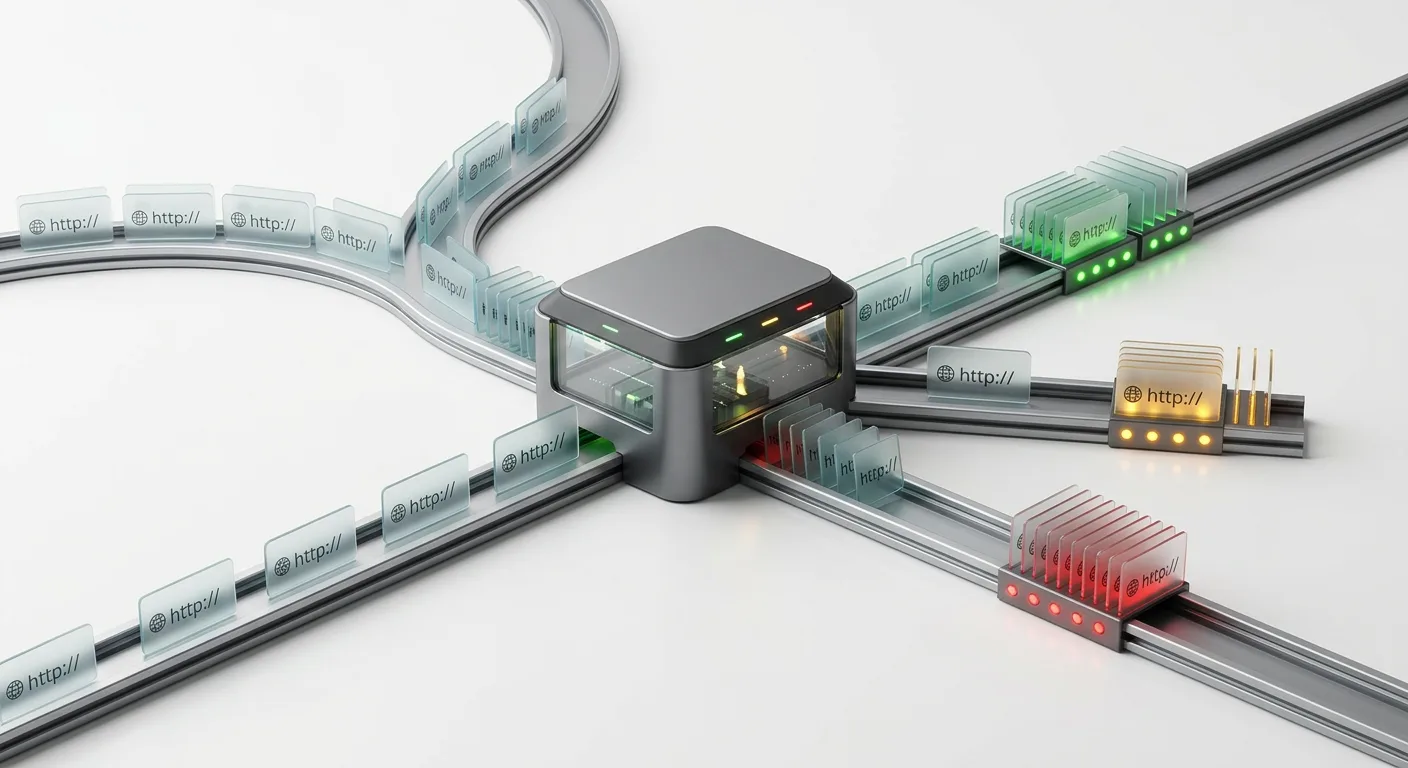
Принцип работы фильтрации URL по HTTP-статусу
Процесс обработки массива ссылок базируется на последовательном выполнении сетевых запросов и анализе возвращаемых серверных данных. После получения входного списка адресов инициируется сетевое соединение с целевыми хостами. Для каждого отдельного URL формируется HTTP-запрос, который направляется к соответствующему серверу для определения текущего состояния документа.
При проверке статуса обычно используются методы GET или HEAD. Стандартный метод GET запрашивает у сервера полный ответ, включающий как заголовки, так и тело документа. Для оптимизации потребления ресурсов и снижения времени ожидания (latency) при массовых проверках применяется метод HEAD. Данный тип запроса инструктирует сервер вернуть исключительно HTTP-заголовки без передачи основного содержимого страницы, что радикально снижает объем передаваемого трафика (payload) и ускоряет процесс сбора данных.
После обработки запроса целевой инфраструктурой система получает ответный пакет данных. Вся необходимая для фильтрации информация содержится в блоке заголовков. Парсер считывает первую стартовую строку ответа сервера, где фиксируется версия используемого протокола и искомый трехзначный код ответа сервера. Это конкретное числовое значение извлекается из общего текстового массива HTTP-заголовков и сохраняется в памяти для проведения операций сравнения.
Сама логика фильтрации представляет собой строгую условную проверку, применяемую к каждой единице исходного списка:
- Фиксация заданного пользователем числового параметра для проведения отбора.
- Построчное сопоставление извлеченного трехзначного кода ответа конкретного адреса с установленным целевым критерием.
- Добавление URL в итоговый массив вывода при полном математическом совпадении значений.
- Игнорирование и удаление адреса из рабочего процесса при несовпадении полученного статуса с заданным условием.
После завершения цикла проверок для всех элементов предоставленного списка формируется финальная выборка адресов. Полученный перечень состоит исключительно из тех URL, фактические заголовки которых подтвердили запрошенное состояние.
Классы состояний HTTP и их влияние на индексацию
Коды состояний HTTP представляют собой стандартизированные трехзначные целые числа, возвращаемые сервером в ответ на запрос клиента. Архитектура протокола HTTP предполагает разделение всех возможных ответов на пять основных категорий, где первая цифра кода строго определяет функциональный класс состояния. Для задач технического SEO и управления сканированием практическое значение имеют четыре класса.
| Класс состояний | Техническое описание | Интерпретация поисковым роботом |
|---|---|---|
| 2xx (Успешное выполнение) | Запрос успешно получен, понят и обработан сервером. Клиенту передаются запрошенные данные. | Краулер загружает содержимое страницы, анализирует контент и передает данные в пайплайн индексирования. URL считается валидным узлом структуры сайта. |
| 3xx (Перенаправление) | Для успешного завершения запроса требуется дополнительное действие, обычно автоматический переход на другой целевой адрес. | Робот фиксирует факт переадресации, извлекает новый URL из HTTP-заголовка Location и добавляет его в очередь сканирования. Осуществляется передача ссылочных сигналов на конечный адрес. |
| 4xx (Ошибка клиента) | Запрос содержит синтаксическую ошибку или не может быть выполнен по вине клиента (например, обращение к несуществующему документу). | Краулер маркирует URL как недоступный. При многократном получении статуса страница исключается из поискового индекса. Контент по данному адресу не сканируется. |
| 5xx (Ошибка сервера) | Сервер признает, что столкнулся с внутренней ошибкой или не способен выполнить корректный запрос из-за перегрузки или таймаута. | Робот временно приостанавливает сканирование, снижает частоту запросов к хосту и планирует повторную проверку. При затяжных сбоях страницы выпадают из индекса. |
Влияние на краулинговый бюджет
В техническом SEO распределение HTTP-статусов внутри архитектуры сайта является первичным фактором оптимизации краулингового бюджета (crawl budget). Данная метрика определяет количество страниц, которое поисковые системы готовы и технически способны просканировать на конкретном домене за заданный промежуток времени. Эффективность расходования этого лимита напрямую зависит от получаемых ответов сервера.
Идеальная техническая база предполагает максимальную концентрацию кодов 2xx при сканировании внутренних ссылок. Любое отклонение от этого стандарта приводит к нецелевому расходу ресурсов поискового бота:
- При обнаружении статусов 3xx краулер вынужден совершать дополнительные сетевые запросы для достижения финального документа, что кратно увеличивает затраты на сканирование одной логической единицы контента.
- Массовая генерация кодов 4xx заставляет бота тратить лимиты на обработку тупиковых ветвей архитектуры вместо обхода новых или обновленных полезных страниц.
- Систематическая отдача кодов 5xx сигнализирует поисковой системе о нестабильности серверной инфраструктуры. В ответ алгоритмы принудительно снижают crawl rate limit, чтобы не перегружать проблемный бэкенд, что приводит к радикальному замедлению индексации всего проекта.
Анализ и классификация ответов сервера позволяют выявлять участки ресурса, на которых происходит утечка краулингового бюджета. Сегментация массива URL по классам HTTP-состояний дает возможность изолировать проблемные адреса и направить ресурсы на устранение структурных дефектов до того, как они окажут негативное влияние на органическую видимость.
Отбор 2xx и 3xx: Анализ доступных страниц и редиректов
Фильтрация массива URL для отбора адресов, возвращающих код 200 OK, позволяет сформировать список полностью доступных конечных документов. Данная операция применяется для подтверждения того, что целевые страницы корректно отдают контент клиенту без дополнительных сетевых маршрутов. В контексте технического аудита именно этот сегмент адресов представляет собой фактическую структуру сайта, пригодную для сканирования, рендеринга и последующего ранжирования.
Отдельная инженерная задача заключается в сегментации перенаправлений. Изоляция статусов 301 Moved Permanently и 302 Found необходима для аудита логики маршрутизации. Основное архитектурное различие между этими кодами ответа заключается в правилах передачи SEO-веса от исходного документа к целевому.
Распределение сигналов ранжирования при переадресации работает по следующим принципам:
- Ответ 301 Moved Permanently указывает на окончательное изменение адреса. При такой маршрутизации поисковые системы склеивают старый и новый URL, передавая накопленные ссылочные сигналы конечному документу и удаляя исходный адрес из индекса.
- Ответ 302 Found сигнализирует о временном перемещении. Краулеры сохраняют исходный URL в базе данных, ожидая возвращения контента по старому адресу. При такой конфигурации полноценная консолидация SEO-веса на новой странице не происходит.
Практические сценарии при аудите маршрутизации
Выделение адресов с кодами 2xx и 3xx из общего пула данных применяется для решения конкретных задач при техническом сопровождении веб-проектов. Полученные списки URL используются для диагностики следующих структурных процессов:
- Контроль карты редиректов при переезде сайта. При миграции на новый домен или глобальном изменении архитектуры URL исходный список адресов проверяется для подтверждения того, что каждый старый адрес строго возвращает код 301. Наличие в отфильтрованном списке кодов 302 указывает на ошибку настройки сервера, которая приведет к потере органического трафика.
- Выявление цепочек редиректов и циклической переадресации. Анализ массива ответов 3xx позволяет обнаружить неоптимальные паттерны, при которых один редирект ведет на другой. Изоляция таких URL необходима для устранения цепочек редиректов, увеличивающих latency, и циклической переадресации (redirect loops), которая приводит к сбросу соединения и потере краулингового бюджета.
- Подтверждение доступности финального адреса. После отбора всех URL с перенаправлениями выполняется извлечение целевых адресов, содержащихся в HTTP-заголовке Location. Этот вторичный список подвергается аналогичной операции проверки для гарантии того, что финальная точка маршрута отдает статус 200 OK, а не ведет на тупиковую страницу с ошибкой.
Поиск 4xx: Изоляция битых ссылок и ошибок доступа
Отбор адресов с кодами класса 4xx направлен на локализацию ошибок взаимодействия на стороне клиента. Присутствие таких URL в архитектуре ресурса формирует тупиковые узлы для поисковых роботов, что приводит к нецелевому расходу краулингового бюджета и негативно влияет на сканирование полезного контента. Изоляция пула недоступных адресов необходима для точечной корректировки навигации и устранения разрывов в ссылочном графе.
В процессе анализа ответов сервера фильтрация применяется для выделения следующих критических статусов:
- 404 Not Found: запрашиваемый документ логически или физически отсутствует на сервере. Это основной технический индикатор классической битой ссылки.
- 403 Forbidden: сервер отклоняет HTTP-запрос из-за жестких настроек прав доступа, блокировки IP-адреса, отсутствия необходимых токенов или ограничений со стороны WAF.
- 401 Unauthorized: обращение к целевому ресурсу требует обязательной аутентификации пользователя для получения контента.
- 429 Too Many Requests: сервер сбрасывает соединение из-за превышения установленных квот обращений (rate limiting), что часто становится причиной блокировки работы краулеров при агрессивном сканировании.
Особую сложность при техническом аудите представляют Soft 404. Это архитектурная уязвимость, при которой несуществующая страница, товар не в наличии или пустая категория возвращает успешный статус 200 OK вместо положенного 404 Not Found. При строгой фильтрации по HTTP-кодам такие адреса сливаются с массивом корректных URL. Выявление Soft 404 требует отдельного, более глубокого анализа: помимо базового извлечения трехзначного кода, необходима проверка HTTP-заголовков на предмет специфических маркеров от CMS, оценка длины ответа в байтах (Content-Length) или парсинг DOM-дерева для поиска текстовых паттернов пустой страницы.
Практический сценарий: очистка ссылочного графа
Выделение кодов 4xx применяется при обработке массивов данных, полученных после сканирования сайта. Исходным материалом выступает сырой список спарсенных внутренних или внешних ссылок, извлеченных из атрибутов href. Фильтрация пула URL по HTTP-статусу позволяет мгновенно сегментировать этот массив, отсекая доступные страницы и оставляя для анализа только дефектные адреса.
Сформированный перечень URL, возвращающих 404 или 403 ошибки, передается вебмастеру для внесения структурных изменений. Полученные данные используются для удаления найденных битых ссылок из шаблонов и контентных блоков, замены неактуальных внешних линков на рабочие аналоги или настройки корректной маршрутизации, если целевой документ был перемещен, но старый адрес сохранился в коде страниц.
Выявление 5xx: Диагностика серверных ошибок
Если изоляция ответов 4xx направлена на исправление клиентских маршрутов и битых ссылок, то отбор URL с кодами 5xx решает задачу диагностики backend-инфраструктуры. Фильтрация пула адресов по этому классу позволяет выделить страницы, при обращении к которым сервер не смог обработать валидный HTTP-запрос. В контексте технического SEO такие ответы выступают критическим блокиратором краулинга, а их регулярная отдача приводит к исключению документов из индекса поисковых систем.
Сегментация сырого массива URL по конкретным трехзначным кодам помогает точно квалифицировать уровень сбоя на стороне сервера, базы данных или балансировщика нагрузки. Отбор адресов по статусам 5xx указывает на следующие инфраструктурные проблемы:
- 500 Internal Server Error: изолирует страницы с фатальными сбоями на уровне выполнения кода приложения, синтаксическими ошибками в скриптах или отказом при подключении к базе данных.
- 502 Bad Gateway: выделяет URL, при обращении к которым proxy-сервер получил некорректный ответ от upstream-сервера или самого приложения.
- 503 Service Unavailable: собирает адреса, недоступные из-за исчерпания лимита рабочих процессов, превышения квот потребления ресурсов или пиковых сетевых нагрузок.
- 504 Gateway Timeout: группирует страницы, время генерации которых превышает установленные лимиты ожидания (latency), что обычно связано с тяжелыми неоптимизированными запросами к базе данных или зависанием внешних API.
Практический сценарий: локализация сбоев маршрутизации и таймаутов
Операция выявления серверных ошибок часто применяется при кросс-функциональном анализе данных SEO-инженерами и DevOps-специалистами. Исходным материалом выступают списки URL, собранные в процессе мониторинга доступности ресурса (uptime) или извлеченные после полного технического парсинга многостраничного сайта.
Применение фильтрации по HTTP-статусам 500-504 отсекает весь штатно работающий контент и формирует список адресов, вызывающих отказ инфраструктуры. Этот перечень используется для выявления архитектурных паттернов сбоя. Анализ изолированного списка URL позволяет локализовать проблему: определить, возникают ли таймауты хаотично на всем домене, либо база данных падает только при обращении к конкретным типам узлов, требующим ресурсоемкого рендеринга или сложной фильтрации товаров.
Сценарии применения в техническом аудите
Фильтрация URL по кодам ответа применяется на различных этапах технического аудита для валидации массивов данных. Изоляция адресов с заданными статусами позволяет очистить рабочие списки от нерелевантных значений и подготовить корректные наборы данных для дальнейшего анализа или передачи смежным специалистам. Ниже приведены типовые сценарии обработки URL при решении задач технической оптимизации.
Анализ выгрузки обратных ссылок
При аудите ссылочной массы исходным материалом выступает сырая выгрузка адресов доноров. Со временем внешние страницы удаляются, переносятся или становятся недоступными, меняя свой статус. Обработка списка URL с применением фильтрации по статусу 200 OK отсекает неработающие страницы и перенаправления.
Полученный результат представляет собой очищенный список активных доноров, доступных для сканирования и способных передавать ссылочный вес. Этот массив данных используется для оценки реального профиля ссылок и планирования стратегии наращивания ссылочной массы, исключая затраты времени SEO-инженеров на анализ несуществующих страниц или сложных цепочек редиректов.
Проверка URL перед отправкой XML-карты сайта
Технические требования поисковых систем предписывают включать в файл sitemap.xml исключительно канонические страницы, отдающие код 200 OK. Наличие перенаправлений, ошибок доступа или серверных сбоев в карте сайта приводит к нецелевому расходованию краулингового бюджета и появлению предупреждений в консолях для вебмастеров.
Извлеченный из CMS или внешнего генератора список адресов проходит предварительную проверку. Операция фильтрации позволяет выявить и изолировать все URL, не возвращающие статус успешного выполнения. Выявленные проблемные адреса исключаются из итоговой XML-карты, что обеспечивает поисковым роботам доступ к полностью валидному контенту.
Сегментация данных из серверных логов
При глубоком техническом анализе источником данных выступают серверные логи. Сырой текстовый массив содержит записи обо всех запросах, включая успешные обращения к статичным ресурсам, что затрудняет поиск конкретных аномалий. Задача заключается в извлечении адресов, генерирующих отказы при обработке запроса.
Применение фильтрации по диапазонам 4xx и 5xx позволяет сегментировать проблемные URL из общей массы запросов. Сформированный список сгруппирован по типам отказов и передается команде разработки.
Использование отфильтрованных списков решает следующие инженерные задачи:
- Устранение необходимости ручного поиска сбоев в массивных лог-файлах.
- Ускорение локализации неоптимизированных скриптов, вызывающих таймауты.
- Формирование точного перечня адресов для корректировки правил маршрутизации.
- Передача DevOps-инженерам конкретных паттернов URL, при обращении к которым падает база данных.