Проверка совпадений по регулярному выражению обеспечивает точное тестирование и отладку текстовых шаблонов. Инструмент Qivrora принимает на вход два обязательных параметра: регулярное выражение (pattern) и целевой текст (test string). Синтаксический анализатор обрабатывает эти данные и определяет, присутствует ли заданная последовательность в исходной строке.
Основная задача инструмента заключается в строгой валидации структуры данных и проверке правил синтаксиса Regex. Специалисты применяют его для настройки алгоритмов поиска перед финальным внедрением в рабочий код. Ошибка в одном спецсимволе часто приводит к неверному извлечению информации из JSON или некорректной обработке параметров URL.
Система моментально выводит результат.
Отладка сложных правил требует визуального контроля. При вводе паттерна алгоритм применяет его к тестовой строке, сопоставляя логические токены с текстовыми символами. Пользователь сразу видит границы всех вхождений и фиксирует их позиции. Это позволяет быстро проверить поведение конкретных групп символов при подготовке скриптов для парсинга лог-файлов или фильтрации ответов API.
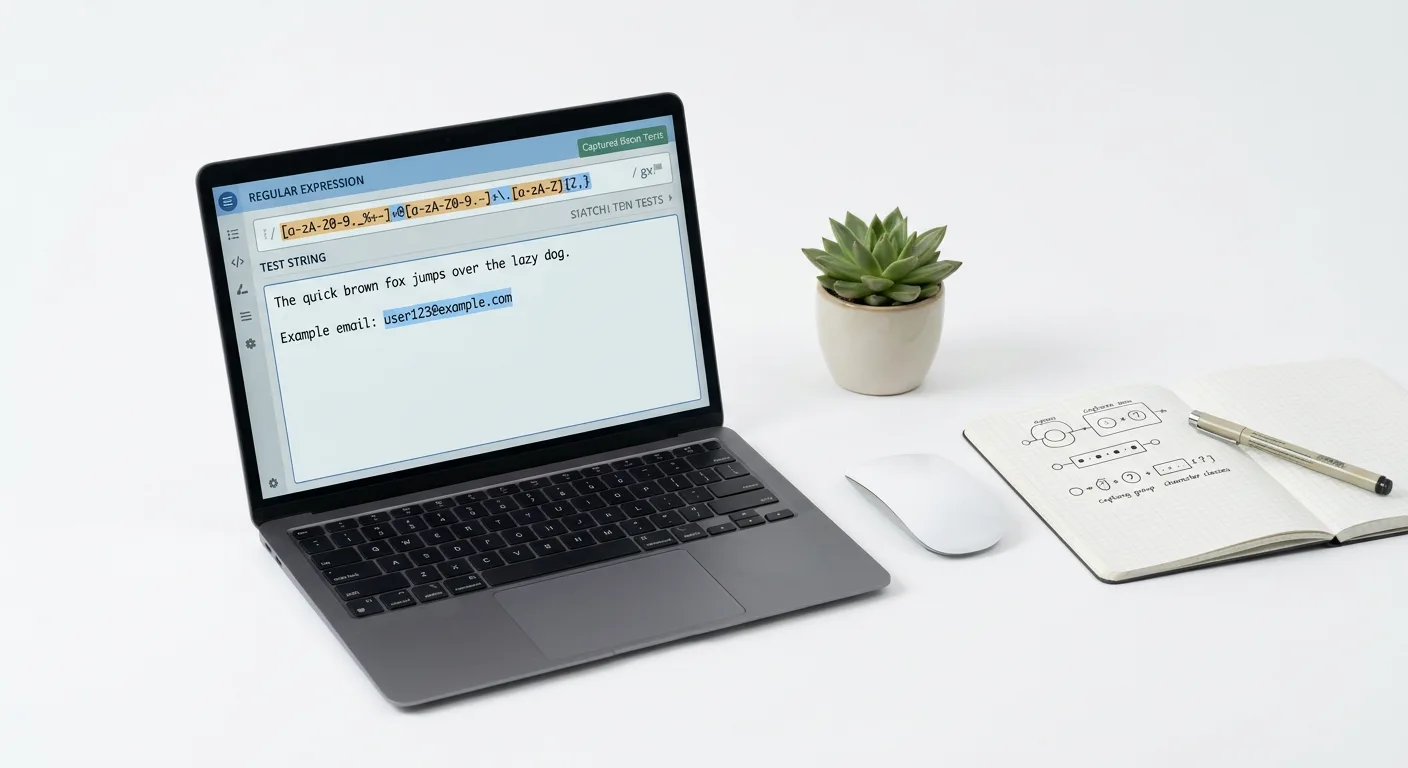
Принцип работы тестирования шаблонов регулярных выражений
Выполнение проверки инициируется после передачи двух базовых компонентов: строки с регулярным выражением и исходного текста для анализа. Вычислительное ядро Regex преобразует заданный шаблон во внутреннее представление, разбивая его на последовательность атомарных инструкций или токенов. Каждый токен описывает конкретное условие сопоставления для отдельного символа или логического блока целевой строки.
Процесс сканирования текста осуществляется строго последовательно, начиная с нулевого индекса. Алгоритм берет первый токен шаблона и проверяет текущий символ строки на соответствие заданному условию. При успешном сопоставлении курсор сдвигается вперед как в шаблоне, так и в тексте. Если алгоритм сталкивается с несоответствием, происходит операция отката: алгоритм сбрасывает текущую цепочку совпадений, сдвигает позицию поиска в исходном тексте на один символ вправо от первоначальной точки старта и запускает цикл проверок заново. Процесс повторяется до нахождения полного совпадения или до достижения конца тестируемой строки.
Итоговый результат работы синтаксического анализатора зависит от успешности прохождения всего цикла сопоставления и формируется в виде структурированного ответа. При тестировании шаблона движок генерирует следующие выходные данные:
- Определение наличия совпадения: базовый логический ответ системы, подтверждающий или опровергающий факт присутствия валидной последовательности в переданном тексте.
- Фиксация позиции в строке: при успешном нахождении подстроки алгоритм вычисляет и возвращает точные числовые индексы. Фиксируется индекс начального символа, с которого стартовало совпадение, и индекс конечного символа. Это позволяет алгоритмам маршрутизации и парсерам извлекать нужный фрагмент по известным координатам.
- Формирование массива вхождений: при выполнении задачи глобального поиска сканирование не прерывается после первого успешного результата. Сохранив координаты первой найденной подстроки, механизм продолжает анализ оставшейся части текста, собирая все последующие валидные совпадения. На выходе генерируется массив, где каждый элемент содержит извлеченную строку и ее индивидуальные индексы позиционирования.
Базовый синтаксис: литералы, метасимволы и экранирование
Формирование любого шаблона регулярного выражения строится на комбинации двух базовых категорий символов: литералов и метасимволов. Понимание разницы между ними определяет точность работы механизма сопоставления текста.
Литеральные символы - это обычные текстовые знаки, которые движок интерпретирует строго буквально. К ним относятся буквы алфавита, цифры и большинство знаков препинания. При сопоставлении анализатор ищет точное совпадение символа из шаблона с символом в тестируемой строке. Если задан шаблон
data
, алгоритм найдет только эту конкретную последовательность из четырех букв, не применяя никакой дополнительной логики поиска.
Метасимволы представляют собой специальные знаки, которые не ищутся в тексте как обычные символы, а выполняют служебные функции. Они передают движку инструкции о том, как именно следует обрабатывать прилегающие элементы или позиции. Одним из фундаментальных метасимволов является точка (
.
).
В синтаксисе регулярных выражений точка выполняет роль универсального подстановочного знака. В процессе парсинга она совпадает с любым одиночным символом в целевой строке, будь то буква, цифра, пробел или знак пунктуации. Исключением по умолчанию является только символ разрыва строки. Если применить шаблон
a.c
, успешным результатом проверки будут признаны фрагменты
abc
,
a1c
,
a-c
и
a c
, так как позиция между первой и третьей буквой может быть заполнена абсолютно любым значением.
Наличие метасимволов создает ситуацию, когда служебный знак необходимо найти в тексте в качестве обычного символа пунктуации или математического оператора. Для этого применяется механизм экранирования с использованием символа обратного слеша (
\
) (Escape-символ). Установка обратного слеша непосредственно перед метасимволом отменяет его специальное значение, превращая его в обычный литерал.
Сравнительные правила интерпретации символов в зависимости от синтаксиса:
| Категория синтаксиса | Пример шаблона | Логика обработки механизмом регулярных выражений |
|---|---|---|
| Литеральный символ |
v
|
Прямое сопоставление. Алгоритм находит исключительно символ «v». |
| Метасимвол |
.
|
Подстановка. Алгоритм находит любой одиночный символ в текущей позиции текста. |
| Экранированный метасимвол |
\.
|
Отмена служебной функции. Алгоритм строго ищет знак препинания «точка». |
| Экранированный Escape-символ |
\\
|
Чтобы найти в тексте сам обратный слеш, он должен экранировать сам себя. |
Отсутствие экранирования является частой причиной ложных срабатываний при валидации форматов. Например, при проверке имени файла с расширением конструкция
file.txt
без экранирования найдет не только
file.txt
, но и
file_txt
или
file0txt
, так как точка сработает как метасимвол. Использование шаблона
file\.txt
гарантирует точное нахождение нужной строки, принуждая синтаксический анализатор искать точку как обычный литерал.
Символьные классы и наборы значений
В то время как литералы ищут точное совпадение конкретного знака, а метасимвол точки допускает любой символ, символьные классы позволяют задать строгий набор допустимых вариантов для одной позиции в тексте. Синтаксис символьного класса определяется квадратными скобками
[]
. Механизм регулярных выражений проверяет строку и фиксирует совпадение, если в текущей позиции находится хотя бы один из символов, перечисленных внутри скобок. Например, шаблон
c[aou]t
найдет слова cat, cot и cut, игнорируя при этом cet или cbt.
Для указания последовательных диапазонов значений применяется дефис
-
внутри класса. Это избавляет от необходимости перечислять весь алфавит или числовой ряд вручную. Шаблон
[0-9]
соответствует любой одиночной цифре, а
[a-zA-Z]
найдет любую букву латинского алфавита независимо от регистра. Если дефис необходимо использовать как обычный литеральный символ внутри класса, его следует разместить в самом начале или конце набора, либо экранировать обратным слешем.
Для инверсии логики поиска используется символ карет
^
. Если он установлен сразу после открывающей квадратной скобки, символьный класс превращается в исключающий (отрицающий). Алгоритм будет искать любой символ, которого нет в указанном перечне. Конструкция
[^0-9]
найдет любую букву, пробел или знак препинания, строго игнорируя числовые значения в исходном тексте.
Вместо перечисления распространенных диапазонов синтаксис регулярных выражений включает стандартизированные сокращения. Они представляют собой экранированные символы, которые интерпретируются как предопределенные классы и напрямую влияют на результаты проверки структур данных.
| Метасимвол | Эквивалент в скобках | Логика сопоставления |
|---|---|---|
\d
|
[0-9]
|
Находит любую десятичную цифру. |
\D
|
[^0-9]
|
Нецифровой символ. Находит любой знак, включая буквы, пробелы и пунктуацию, кроме цифр. |
\w
|
[a-zA-Z0-9_]
|
Словообразующий символ. Находит любую букву латинского алфавита, цифру или знак подчеркивания. |
\s
|
[ \t\r\n\f\v]
|
Пробельный символ. Находит обычные пробелы, знаки табуляции и символы переноса строки. |
Использование сокращенных классов делает шаблоны более компактными при валидации форматов ввода. Комбинация этих элементов позволяет быстро формировать правила проверки. Например, шаблон проверки формата даты может состоять из последовательностей
\d
, а шаблон
\d\w\s
требует, чтобы в анализируемом тексте строго друг за другом следовали цифра, любой словообразующий символ и знак пробела.
Квантификаторы: управление количеством повторений
По умолчанию любой символ, метасимвол или символьный класс в регулярном выражении совпадает ровно с одним знаком в исходном тексте. Для указания того, сколько раз подряд должен встретиться предшествующий элемент, используются квантификаторы. Они добавляются непосредственно после целевого токена и определяют допустимое число его повторений.
Для точного контроля над количеством совпадений применяется синтаксис фигурных скобок, который позволяет задавать фиксированные значения или диапазоны:
-
{n}- строгое совпадение. Токен должен повториться ровно n раз. Шаблон\d{4}найдет ровно четыре цифры подряд. -
{n,}- открытый интервал. Токен должен встретиться не менее n раз, верхний предел не ограничен. -
{n,m}- закрытый интервал. Количество повторений должно быть от n до m включительно. Конструкция\w{2,5}захватит последовательность из словообразующих символов длиной от двух до пяти знаков.
Для наиболее распространенных интервалов синтаксис регулярных выражений включает специальные символы-сокращения, которые делают шаблоны более компактными и читаемыми.
| Квантификатор | Эквивалент в скобках | Правило повторения |
|---|---|---|
?
|
{0,1}
|
Ноль или одно повторение. Делает предшествующий элемент необязательным. |
*
|
{0,}
|
Ноль или более повторений. Элемент может отсутствовать или повторяться бесконечное число раз. |
+
|
{1,}
|
Одно или более повторений. Требует обязательного наличия элемента хотя бы один раз. |
Жадное и ленивое сопоставление
Принципиальной особенностью работы движков регулярных выражений является поведение квантификаторов при поиске границ совпадения. По умолчанию все квантификаторы работают в жадном (greedy) режиме. Это означает, что анализатор пытается захватить максимально возможную длину строки, которая удовлетворяет условиям шаблона.
Жадное поведение часто приводит к захвату лишних данных, когда целевой текст содержит несколько фрагментов, подходящих под условие. Если применить шаблон
".*"
к строке формата
"значение 1" и "значение 2"
, движок найдет первую кавычку, а затем метасимвол точки в сочетании с квантификатором
*
поглотит весь текст до самой последней кавычки в строке. Результатом будет одно большое совпадение, включающее промежуточный текст.
Для изменения этой логики применяется ленивое (lazy) сопоставление. Переход в ленивый режим осуществляется добавлением символа
?
сразу после любого квантификатора (например,
*?
,
+?
,
{n,m}?
). В этом режиме движок останавливает поиск при первой же возможности, захватывая минимально необходимую длину строки.
При использовании ленивого шаблона
".*?"
на той же исходной строке, квантификатор заставит алгоритм остановиться сразу после нахождения следующей закрывающей кавычки. В результате будут найдены точные границы нужных фрагментов, и система зафиксирует два отдельных непересекающихся совпадения вместо одного глобального блока.
Якоря и метасимволы позиции
В отличие от базовых символьных классов и квантификаторов, которые поглощают текстовые символы при поиске, якоря относятся к категории утверждений с нулевой шириной. При обработке таких токенов движок регулярных выражений не сдвигает внутренний указатель позиции в анализируемой строке и не добавляет физические знаки в итоговое совпадение. Вместо этого алгоритм строго проверяет, соответствует ли текущая координата в тексте заданному пространственному условию.
Использование утверждений с нулевой шириной позволяет точно позиционировать искомый шаблон, исключая ложные срабатывания, когда нужная последовательность символов технически присутствует, но находится внутри неподходящего контекста.
Привязка к началу и концу текста
Для жесткой фиксации шаблона относительно границ проверяемых данных применяются метасимволы начала и конца строки. Они гарантируют, что совпадение произойдет только в строго определенных местах текстового блока.
-
Метасимвол
^проверяет, что позиция совпадения находится в абсолютном начале строки. Если применить шаблон^статус, алгоритм найдет это слово только в том случае, если с него начинается весь анализируемый ввод. Любые предшествующие пробелы или другие невидимые символы приведут к отклонению совпадения. -
Метасимвол
$удостоверяет, что сразу после найденного совпадения следует конец строки. Шаблонзавершено$гарантирует захват последовательности исключительно тогда, когда после нее нет никаких дополнительных данных.
Совместное применение двух этих якорей в формате
^регулярное_выражение$
формирует условие, при котором целевая строка должна полностью и без остатка соответствовать заданному шаблону. Данный синтаксис применяется для строгой оценки всего объема входных данных, блокируя частичные совпадения.
Проверка границ слова
При семантическом сканировании текста часто возникает необходимость изолировать самостоятельные слова от подстрок, являющихся частями других конструкций. Для позиционирования токенов относительно логических границ слов применяются специальные утверждения.
Позиция границы слова возникает в точках перехода между словообразующими и несловообразующими символами, а также на абсолютных краях проверяемой строки.
-
Метасимвол
\bобозначает обязательное наличие границы слова. Алгоритм возвращает успешный результат, если с одной стороны от текущего индекса находится текстовый символ, а с другой - пробел, знак препинания или край строки. Применение шаблона\bтокен\bзахватит изолированное слово, но проигнорирует аналогичную последовательность символов внутри других лексем. -
Метасимвол
\Bопределяет строгую инверсию предыдущего правила - обязательное отсутствие границы слова. Это утверждение выполняется только тогда, когда позиция сопоставления находится между двумя однотипными символами. Шаблон\Bтокен\Bпозволит зафиксировать искомую последовательность исключительно в середине другого слова, полностью отсекая изолированные вхождения или вхождения на краях слов.
Интеграция метасимволов позиции в структуру регулярного выражения переводит механизм поиска от линейного сканирования символов к контекстно-зависимому анализу расположения фрагментов.
Группировка символов и альтернатива
Регулярные выражения обрабатывают строку последовательно, применяя правила к отдельным символам или символьным классам. Для применения логики сопоставления к целым последовательностям токенов используется механизм группировки. Заключение части шаблона в круглые скобки
()
создает подвыражение, которое алгоритм воспринимает как единый структурный элемент. Это позволяет изолировать часть проверочной логики и применять квантификаторы не к одному предшествующему символу, а к целому блоку текста.
По умолчанию круглые скобки формируют захватывающую группу. При совпадении шаблона с проверяемым текстом движок не только фиксирует соответствие, но и сохраняет найденную подстроку в изолированном участке памяти. Каждой захватывающей группе автоматически присваивается внутренний индекс, начиная с единицы. Такое поведение необходимо для последующего извлечения конкретных фрагментов данных из общего совпадения.
В ситуациях, когда подвыражение создается исключительно для управления логикой сопоставления, автоматическое сохранение текста создает избыточную нагрузку на память и усложняет массив результатов. Для отключения механизма запоминания применяются незахватывающие группы.
-
Синтаксис
(?:...)указывает движку сгруппировать токены внутри скобок для проверки структуры, но полностью игнорировать этот фрагмент при формировании итогового массива извлеченных данных. - Использование незахватывающих конструкций оптимизирует процесс сканирования, особенно при проверке длинных строк, где требуется только базовая валидация последовательности символов.
Логическое перечисление вариантов
Для поиска одного из нескольких возможных строковых значений применяется оператор альтернативы, обозначаемый вертикальной чертой
|
. Этот метасимвол реализует классическое логическое условие ИЛИ. Шаблон сканирует текст, последовательно проверяя варианты слева направо, и возвращает успешный результат при фиксации первого же совпадения с любой из перечисленных веток.
Оператор альтернативы обладает низким приоритетом и по умолчанию распространяет свое действие на все выражение слева и справа от себя. Для ограничения области действия логического ветвления его необходимо комбинировать с механизмом группировки.
| Структура шаблона | Логика сопоставления |
|---|---|
условиеА|условиеБ
|
Поиск точного совпадения со всей последовательностью токенов слева от разделителя или со всей последовательностью справа от него. |
префикс(вариант1|вариант2)
|
Поиск общей начальной части, за которой следует строго один из перечисленных вариантов внутри захватывающей группы. |
(?:a|b)суффикс
|
Поиск одного из двух начальных токенов, за которым следует общая завершающая часть, без сохранения сделанного выбора в отдельную переменную. |
Комбинация круглых скобок и вертикальной черты позволяет строить разветвленные контекстно-независимые правила, где часть строки остается неизменной, а отдельный фрагмент может принимать строго определенный набор значений.
Флаги (модификаторы) регулярных выражений
По умолчанию обработка регулярного выражения завершается сразу после фиксации первого успешного совпадения, а сам поиск происходит со строгим учетом регистра символов и игнорированием внутренних разрывов строк. Для изменения этого базового поведения применяются флаги - строковые параметры, которые глобально переопределяют логику работы движка при сканировании текста. Они применяются ко всему шаблону целиком, а не к отдельным токенам или группам.
| Флаг | Поведение по умолчанию | Изменение при активации флага |
|---|---|---|
g
|
Остановка сканирования после первого найденного совпадения. | Выполнение глобального поиска всех вхождений шаблона до конца целевого текста. |
i
|
Строгое сопоставление символов с учетом их регистра. | Полное игнорирование разницы между строчными и прописными буквами при поиске. |
m
|
Якоря реагируют исключительно на начало и конец всего переданного текста. | Многострочный режим: якоря реагируют на начало и конец каждой отдельной строки. |
s
|
Метасимвол точки не совпадает с символами переноса строки. | Режим dotAll: точка захватывает абсолютно все символы, включая переносы строк. |
Флаг глобального поиска
g
трансформирует локальную проверку в итеративный процесс. Без этого модификатора инструмент возвращает только первый фрагмент, удовлетворяющий условиям шаблона. При активации глобального флага указатель позиции сдвигается за конец текущего совпадения, и процесс сопоставления возобновляется. Это свойство необходимо для извлечения массивов однотипных данных из больших объемов неструктурированного текста.
Использование модификатора
i
отключает строгую проверку кодировки символов верхнего и нижнего регистра. При активном флаге буквенные токены распознаются как идентичные независимо от их написания. Это исключает необходимость ручного дублирования диапазонов внутри символьных классов и делает шаблон более лаконичным при анализе текста с нестабильным форматированием.
Модификатор
m
напрямую влияет на работу утверждений с нулевой шириной - позиционных якорей
^
и
$
. В стандартном режиме они жестко привязаны к абсолютному началу и абсолютному концу всей проверяемой строки, даже если внутри нее содержатся абзацы. Многострочный режим заставляет движок интерпретировать символы возврата каретки и переноса строки как логические границы. В результате якоря начинают успешно срабатывать в начале и в конце каждой отдельной текстовой строки внутри единого документа.
Флаг
s
снимает встроенное системное ограничение с метасимвола подстановки. В базовом синтаксисе точка способна заменить любой символ в строке, кроме управляющих символов разрыва. Активация режима dotAll включает эти разрывы в область действия точки. Данный параметр критически важен при извлечении многострочных блоков данных, когда начальное условие шаблона находится на одной строке текста, а завершающее - на другой.
Флаги регулярных выражений допускают комбинированное применение. Совместное использование параметров
g
,
i
и
m
формирует комплексную инструкцию, заставляющую движок находить все возможные вхождения шаблона без учета регистра на каждой строке документа. Набор модификаторов обрабатывается системой одновременно, формируя единую среду для выполнения правил поиска.
Практические сценарии проверки и извлечения данных
Тестирование регулярных выражений применяется для отладки синтаксиса перед его интеграцией в программный код. Практические задачи делятся на две основные категории: строгая валидация входящих данных и извлечение целевых фрагментов из неструктурированных текстовых массивов. Для каждой категории применяется отдельная логика построения шаблонов и определения успешного совпадения.
Валидация форматов ввода
Задача валидации заключается в проверке полного соответствия переданной строки заданному формату. В таких сценариях шаблон обязательно заключается между позиционными якорями начала и конца строки. Это гарантирует, что движок не найдет частичное совпадение внутри невалидного текста, а проверит строку целиком от первого до последнего символа.
Для отладки правил валидации используются следующие типичные структуры шаблонов и тестовых строк:
| Тип данных | Ожидаемый формат ввода | Пример структуры шаблона | Критерий успешного совпадения |
|---|---|---|---|
| Email-адрес |
user.name+tag@example.com
|
^[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}$
|
Шаблон полностью покрывает строку: локальная часть содержит допустимые символы, присутствует обязательный символ @, доменная часть содержит точку и домен верхнего уровня длиной не менее двух символов. |
| URL |
https://sub.domain.com/path?query=1
|
^https?:\/\/(?:www\.)?[-a-zA-Z0-9@:%._\+~#=]{1,256}\.[a-zA-Z0-9()]{1,6}\b(?:[-a-zA-Z0-9()@:%_\+.~#?&\/=]*)$
|
Строка строго начинается с протокола http или https, содержит валидную структуру доменного имени и опционально включает путь, параметры запроса или фрагмент без разрывов пробелами. |
| IP-адрес (IPv4) |
192.168.1.1
|
^(?:(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)\.){3}(?:25[0-5]|2[0-4][0-9]|[01]?[0-9][0-9]?)$
|
Строка состоит ровно из четырех октетов, разделенных точками. Каждый октет представляет собой числовое значение строго в диапазоне от 0 до 255. Буквы и лишние разделители приводят к отказу в совпадении. |
Парсинг логов и извлечение метрик
В отличие от строгой валидации, парсинг предполагает поиск конкретных подстрок внутри объемного текста, такого как системные или серверные логи. В этом случае позиционные якоря начала и конца строки обычно опускаются, а глобальный флаг активируется для поиска всех вхождений в документе. Основным инструментом здесь выступают захватывающие группы, позволяющие изолировать нужные параметры от окружающего служебного текста.
Стандартная строка серверного лога часто имеет следующий входной формат:
127.0.0.1 - - [10/Oct/2023:13:55:36 -0700] "GET /api/data HTTP/1.1" 200 2326При тестировании извлечения данных из подобных строк применяются следующие сценарии:
-
Извлечение даты и времени:
Для получения временной метки используется шаблон
\[(\d{2}\/[a-zA-Z]{3}\/\d{4}:\d{2}:\d{2}:\d{2}\s[+-]\d{4})\]. Успешным совпадением считается нахождение текста внутри квадратных скобок. Критерием корректной работы является формирование первой захватывающей группы, содержащей исключительно строку10/Oct/2023:13:55:36 -0700без окружающих скобок. -
Извлечение HTTP-метода и пути:
Применение шаблона
"([A-Z]+)\s(\/[^\s]*)\sHTTP\/1\.[01]"нацелено на парсинг тела запроса. Критерий успеха - создание двух захватывающих групп. Первая группа изолирует метод (например,GETилиPOST), вторая извлекает запрошенный путь (/api/data). -
Фильтрация статус-кодов:
Для анализа ответов сервера применяется шаблон
"\s([1-5]\d{2})\s(\d+)$. Успешное выполнение правила фиксирует трехзначный код состояния (например,200,404или500) в первой группе и размер переданных данных (2326) во второй. Совпадение признается успешным, если код состояния начинается с цифр от 1 до 5, что отсекает ложные срабатывания на случайных трехзначных числах в теле лога.
Корректность тестирования в данных сценариях определяется не только фактом нахождения совпадения, но и точностью границ захваченных групп. Инструмент отладки позволяет убедиться, что в результирующий массив попадают только целевые данные без лишних пробелов, кавычек или разделительных символов, присутствующих в исходном тексте.