Защита специальных символов в Regex требуется при передаче произвольного текста в динамические шаблоны поиска. Если входная строка содержит служебные знаки, движок интерпретирует их как инструкции. Это ломает логику обработки. Данный инструмент решает задачу автоматического преобразования текста в безопасный формат.
Процесс нейтрализации синтаксического значения знаков называется экранированием.
Алгоритм лишает метасимволы их исходных управляющих функций, превращая их в обычные текстовые литералы. Инструмент выполняет точную подготовку строковых данных для их передачи в код. Пользователь загружает необработанный текст, а на выходе получает экранированную последовательность. Она полностью готова для использования внутри движков регулярных выражений без риска случайного срабатывания квантификаторов, групп захвата или логических операторов.
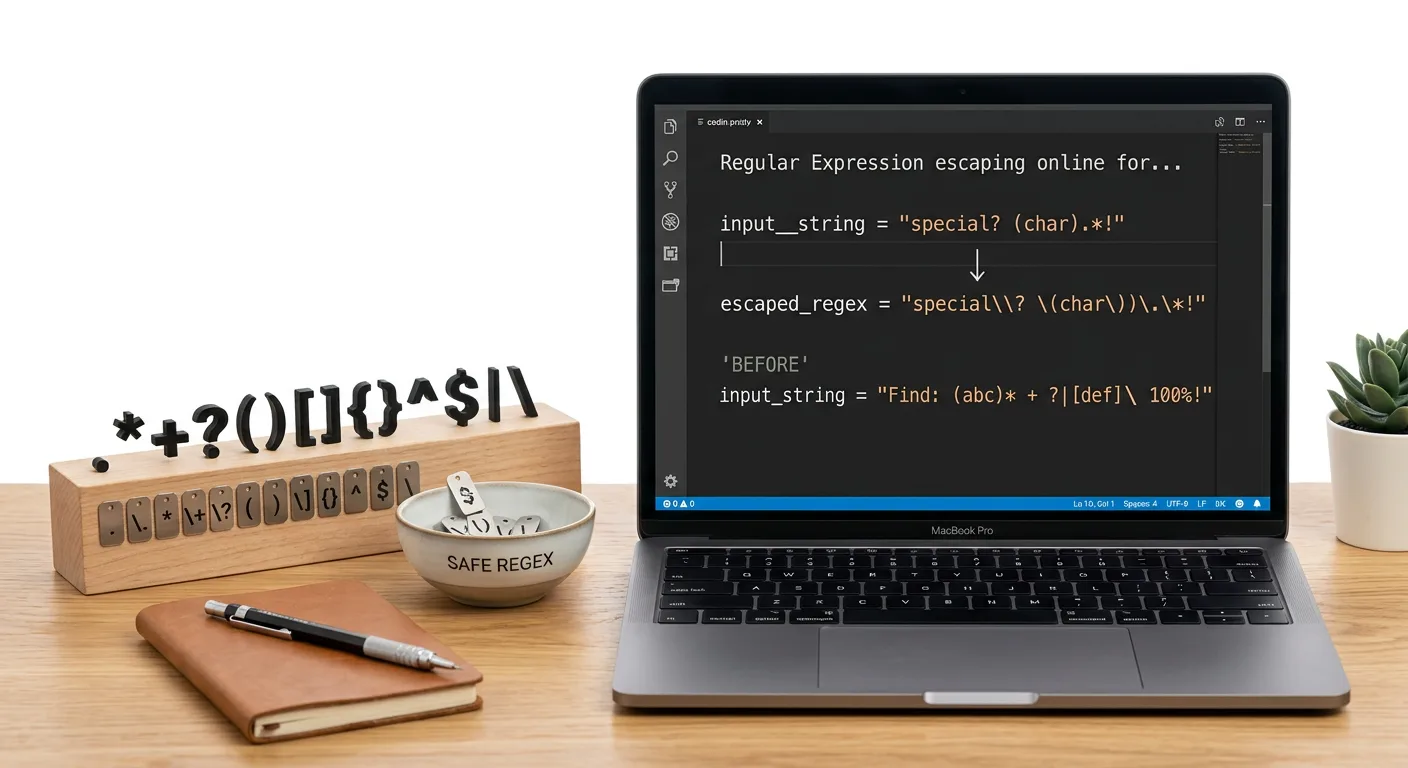
Принцип работы escape-символов и обработка метасимволов
Движки регулярных выражений используют особый набор знаков для построения логики поиска. Эти знаки называются метасимволами. Они выступают не как элементы искомого текста, а как операторы, задающие условия совпадения, границы строк, квантификаторы или логические группировки. При передаче произвольного текста, содержащего такие знаки, возникает конфликт интерпретации: парсер воспринимает их как команды, а не как строковые данные.
Для устранения этого конфликта применяется escape-символ. В стандарте регулярных выражений эту функцию выполняет обратный слеш. Он работает как управляющий маркер для парсера. Обратный слеш отменяет служебное назначение непосредственно следующего за ним знака. В результате метасимвол утрачивает свой синтаксический вес и обрабатывается движком строго как обычный текстовый литерал.
Подготовка безопасной строковой последовательности опирается на детерминированный алгоритм преобразования. Процесс нейтрализации метасимволов состоит из следующих этапов:
- Сканирование исходной строки: происходит последовательное посимвольное чтение переданного текстового массива данных.
- Идентификация: каждый прочитанный знак проверяется на совпадение с системным перечнем операторов регулярных выражений.
- Префиксное добавление: при обнаружении метасимвола перед ним вставляется обратная косая черта, формирующая экранированную пару.
- Генерация последовательности: обработанные элементы объединяются в новую строку, готовую для безопасной передачи в парсер.
Поскольку обратный слеш перехватывает управление парсером ровно на один следующий знак, экранирование применяется точечно. Если подряд идут несколько служебных знаков, префиксное добавление выполняется для каждого из них индивидуально. Такой подход математически точно сохраняет исходную визуальную структуру текста, полностью лишая её способности вмешиваться в логику выполнения регулярного выражения.
Спецификация символов, подлежащих обязательному экранированию
Для выполнения точного сопоставления образцов парсер должен интерпретировать каждый переданный знак исключительно как текстовый литерал. В синтаксисе регулярных выражений существует фиксированный перечень метасимволов, которые выступают операторами управления логикой поиска. Нейтрализация этих знаков предотвращает их распознавание как системных команд.
Ниже приведена спецификация всех служебных символов, которые подвергаются префиксному преобразованию для безопасного внедрения в текстовые шаблоны. Операция выполняется посимвольно: каждый обнаруженный знак из перечня получает собственный управляющий маркер.
| Исходный ввод | Функция при сопоставлении образцов | Экранированный вывод |
|---|---|---|
.
|
Точка: заменяет любой одиночный символ |
\.
|
*
|
Звездочка (квантификатор): ноль или более совпадений |
\*
|
?
|
Знак вопроса (квантификатор): ноль или одно совпадение |
\?
|
+
|
Плюс (квантификатор): одно или более совпадений |
\+
|
^
|
Знак крышки: указывает на начало анализируемой строки |
\^
|
$
|
Знак доллара: указывает на конец анализируемой строки |
\$
|
|
|
Вертикальная черта: выполняет логическую операцию ИЛИ |
\|
|
[
и
]
|
Квадратные скобки: формируют символьные классы и диапазоны |
\[
и
\]
|
(
и
)
|
Круглые скобки: создают группы захвата и изолируют подвыражения |
\(
и
\)
|
{
и
}
|
Фигурные скобки: задают точное количество повторений (интервалы) |
\{
и
\}
|
\
|
Обратный слеш: системный маркер (escape-символ) |
\\
|
Обработка квантификаторов и подстановочных знаков
Квантификаторы управляют количеством ожидаемых повторений предшествующего элемента. Звездочка, знак вопроса и плюс без защиты заставляют движок регулярных выражений искать множественные вхождения или делать символ необязательным. Преобразование исходного ввода
+
в экранированный вывод
\+
лишает знак его математического свойства, принуждая парсер искать точное графическое совпадение со знаком плюса. Аналогичному правилу подчиняется точка, которая в активном состоянии выступает глобальным подстановочным знаком для любого элемента.
Нейтрализация структурных блоков и логических операторов
Синтаксис регулярных выражений опирается на скобки для создания иерархии и ветвлений логики. Круглые скобки формируют группы захвата, квадратные определяют наборы допустимых знаков, а фигурные задают числовые границы совпадений. Обработка этих элементов применяется к обеим частям конструкции. Открывающая и закрывающая скобки экранируются независимо друг от друга. Вертикальная черта, разделяющая альтернативные варианты поиска, переводится в состояние литерала
\|
, что отменяет операцию логического ветвления.
Защита якорей позиционирования и экранирующего маркера
Знак крышки и знак доллара привязывают сопоставление образца к границам строкового массива. Их экранирование переводит проверку позиций в режим поиска конкретных печатных знаков. Особой обработки требует сам обратный слеш. Поскольку он выполняет функцию инициатора экранирования, одиночный обратный слеш в текстовом вводе вызовет ошибку парсера, так как движок попытается применить его к следующему случайному знаку. Преобразование исходного ввода
\
в двойную конструкцию
\\
сообщает системе, что первый слеш отменяет служебную функцию второго, оставляя его обычным символом.
Интеграция экранированных строк в динамические регулярные выражения
Сгенерированная безопасная последовательность символов предназначена для внедрения в программный код, где требуется поиск точного текстового совпадения. Когда строковые данные, содержащие метасимволы, передаются в парсер регулярных выражений в исходном виде, они немедленно модифицируют логику работы шаблона. Предварительное экранирование гарантирует, что движок воспримет переданный текст исключительно как массив стандартных символов, игнорируя их синтаксическое значение.
Статический синтаксис и динамические конструкторы
В программной среде инициализация регулярных выражений реализуется двумя основными методами. Статический синтаксис литерала, определяемый конструкцией
/pattern/
, применяется для жестко закодированных шаблонов, структура которых неизменна. В таких сценариях экранирование выполняется на этапе написания кода, а сам шаблон фиксируется парсером до начала выполнения программы.
Динамические конструкторы, такие как
new RegExp()
, используются для формирования паттернов поиска во время выполнения приложения (runtime). Этот подход позволяет собирать итоговое регулярное выражение из различных строковых переменных. Интеграция изменяемых данных делает шаблон гибким, но одновременно требует строгой подготовки внедряемого текста перед вызовом конструктора.
Обеспечение точного поиска при конструировании шаблонов
При генерации регулярного выражения из переменных движок объединяет значения и компилирует итоговый результат в исполняемый объект. Если исходная текстовая переменная не была экранирована и содержит спецсимволы, парсер обработает их как часть синтаксиса. Внедрение предварительно экранированных данных обеспечивает выполнение следующих технических условий:
- Изоляция синтаксиса: Обработанная строковая переменная становится безопасным текстовым блоком, который не может нарушить внешнюю иерархию собираемого регулярного выражения.
- Переход в режим точного поиска (exact match): Преобразование метасимволов в литералы принудительно переключает движок на поиск графического соответствия исходной строке.
- Предотвращение ошибок компиляции: Нейтрализация случайных квантификаторов и структурных скобок в переменных исключает сбои парсера, возникающие при некорректном расположении метасимволов.
Например, передача неэкранированной переменной со значением
C++
в динамический конструктор вызовет синтаксическую ошибку. Парсер воспримет второй символ плюса как квантификатор, который не имеет предшествующего элемента для повторения. Использование предварительно подготовленной строки
C\+\+
сообщает движку о необходимости найти конкретную последовательность из одной буквы и двух математических знаков.
Защита от ReDoS и безопасность сопоставления образцов
Внедрение неэкранированных динамических данных в регулярные выражения создает критическую уязвимость на уровне парсера, известную как ReDoS. Проблема возникает в движках на базе недетерминированных конечных автоматов, таких как PCRE и ECMAScript, при обработке неоднозначных или перекрывающихся паттернов. Если пользовательские данные содержат неэкранированные квантификаторы, чередования или вложенные группы, итоговое регулярное выражение может спровоцировать состояние катастрофического возврата (catastrophic backtracking). В этой ситуации при частичном несовпадении алгоритм тратит экспоненциальное количество шагов на перебор всех возможных комбинаций ветвления, что приводит к исчерпанию ресурсов процессора и блокировке системы.
Математически точное преобразование спецсимволов в литералы выступает базовым механизмом защиты от подобных инъекций. Принудительное экранирование входящих строковых переменных до их внедрения в динамический шаблон лишает метасимволы синтаксической силы. Движок лишается возможности интерпретировать пользовательский ввод как управляющие конструкции, обрабатывая его строго как графическую последовательность. Это гарантирует предсказуемое линейное время выполнения поиска и полностью исключает компрометацию логики обработки.
Прикладные сценарии безопасной обработки
Подготовка строковых параметров обязательна в любых программных контекстах, где шаблон формируется на основе внешних входных данных. Экранирование применяется для решения следующих прикладных задач:
- Валидация форм: Проверка соответствия пользовательского ввода строгим форматам, исключающая возможность внедрения модификаторов длины строки или группирующих скобок, способных изменить границы паттерна.
- Очистка данных (sanitization): Выявление и удаление потенциально опасных или стоп-слов из пользовательского контента. Преобразование динамических словарей фильтрации гарантирует корректную работу алгоритма очистки даже при наличии технических символов в проверяемых словах.
- Безопасный поиск и замена текста: Использование встроенных функций наподобие replace, где искомое значение передается пользователем в виде переменной. Экранирование позволяет выполнять точный поиск по тексту, исключая активацию незапланированных групп захвата или жадных квантификаторов, которые могут привести к удалению избыточного объема данных.
Применение безопасного строкового представления предотвращает сценарии, при которых легитимный поиск специфических символов превращается в эксплуатацию вычислительного ядра. Формирование регулярных выражений из подготовленных текстовых блоков оставляет движку единственную задачу - посимвольное сопоставление исходного литерала с целевым текстом.