Экранирование символов в HTML-коде требуется для безопасного вывода текста с зарезервированными синтаксическими знаками. Инструмент выполняет двустороннее преобразование между сырым текстом и валидной безопасной разметкой. Браузер жестко интерпретирует служебные знаки. Прямая передача таких символов неизбежно ломает рендеринг.
Доступны две операции.
Алгоритм HTML Encode заменяет спецсимволы на соответствующие сущности. Это изолирует данные от исполняемой среды. Обратный процесс называется HTML Unescape. Метод полностью декодирует сущности для получения первоначального исходного кода.
На входе принимается любая текстовая строка. Результат выдается в виде обработанного текста, готового для интеграции в шаблон, передачи через API или сохранения в формат JSON. Преобразование гарантирует точное визуальное соответствие введенных и отображаемых данных без нарушения синтаксиса документа.
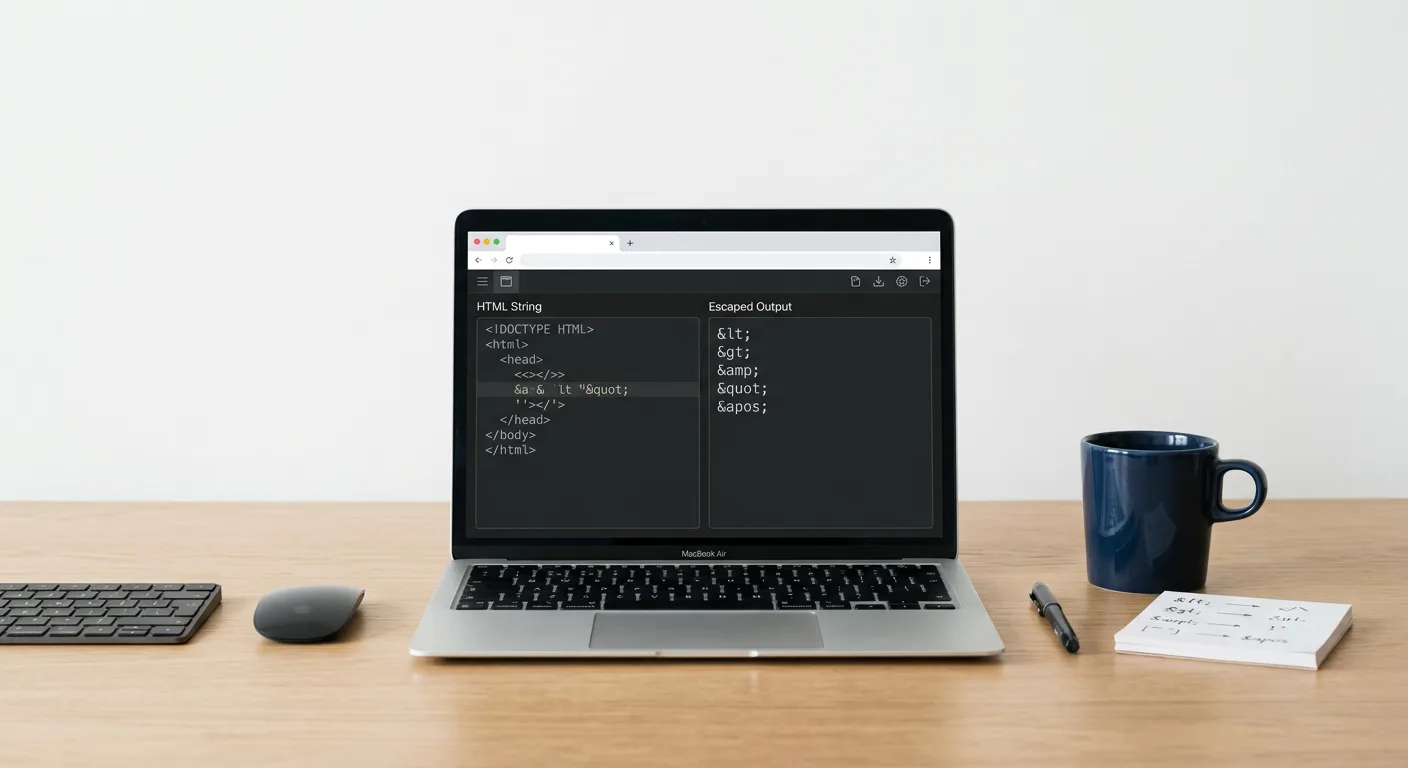
Механизм преобразования: от зарезервированных символов к HTML-сущностям
Браузер обрабатывает исходный код страницы как сплошной текстовый поток, формируя объектную модель документа. В процессе разбора парсер опирается на строгий набор синтаксических маркеров для отделения разметки от контента. Символ левой угловой скобки сообщает анализатору о начале тега, а кавычка определяет границы значения атрибута. Наличие неэкранированных служебных знаков в обычном текстовом узле нарушает алгоритм обработки. Парсер ошибочно интерпретирует пользовательские данные как часть разметки, что неизбежно приводит к искажению семантики документа, преждевременному закрытию тегов и фатальным ошибкам рендеринга.
Процесс кодирования полностью изолирует текстовые данные от синтаксиса разметки. Операция HTML Encode сканирует входную строку и выполняет замену всех зарезервированных символов на безопасные последовательности - HTML-сущности. После такого преобразования браузер отображает символы визуально корректно, но не пытается применить их как управляющие конструкции.
Базовый алгоритм преобразования охватывает пять ключевых символов, критичных для структуры документа и корректной работы парсера.
| Исходный символ | Синтаксическая роль в разметке | Результат преобразования (сущность) |
|---|---|---|
Амперсанд (
&
)
|
Инициализация специальных символов и сущностей |
&
|
Левая угловая скобка (
<
)
|
Открытие HTML-тега |
<
|
Правая угловая скобка (
>
)
|
Закрытие HTML-тега |
>
|
Двойная кавычка (
"
)
|
Выделение значений атрибутов элементов |
"
|
Одинарная кавычка (
'
)
|
Альтернативное выделение значений атрибутов |
'
|
Обратная операция, HTML Unescape, выполняет строгое декодирование текстовой строки обратно в сырые символы. Алгоритм считывает текст, идентифицирует валидные escape-последовательности, которые всегда начинаются с амперсанда и завершаются точкой с запятой, после чего заменяет их на исходные знаки. Этот процесс применяется, когда ранее экранированные данные необходимо извлечь из хранилища и вернуть в первоначальный вид для обработки логикой приложения, математических вычислений или передачи в системы, не связанные с веб-рендерингом.
Типы HTML-сущностей: именованные, десятичные и шестнадцатеричные коды
Согласно спецификациям W3C, представление символов, выходящих за рамки стандартного клавиатурного ввода или требующих изоляции от синтаксиса разметки, осуществляется через HTML-сущности. Строение любой escape-последовательности подчиняется строгому правилу: она инициируется амперсандом и завершается точкой с запятой. Внутренняя часть определяет конкретный формат ссылки на символ, который может быть буквенным или числовым.
Структура форматов кодирования
Спецификации HTML определяют три параллельных метода декларирования специальных символов. Выбор конкретного формата зависит от требований к читаемости исходного кода и наличия символа в стандартизированных словарях.
-
Именованные сущности (мнемоники): используют буквенные аббревиатуры, разработанные для визуального распознавания разработчиком в исходном коде. Например, неразрывный пробел обозначается как
, а знак авторского права -©. Этот формат удобен при ручном редактировании документа, однако спецификация определяет буквенные имена лишь для ограниченного набора часто используемых типографских и математических знаков. -
Десятичные коды: формируются из префикса
&#и десятичного числа. Они указывают точную позицию знака в таблице стандарта Unicode, позволяя закодировать абсолютно любой существующий символ. -
Шестнадцатеричные коды: используют префикс
&#xс последующим шестнадцатеричным значением. Являются альтернативной формой числовой записи, часто применяемой при работе с низкоуровневыми данными или системными шрифтами.
Сравнительная структура форматов для типовых типографских знаков демонстрирует вариативность представления одних и тех же символов в HTML-документе.
| Символ | Назначение | Именованная сущность | Десятичный код | Шестнадцатеричный код |
|---|---|---|---|---|
| Неразрывный пробел | Предотвращение переноса строки |
|
 
|
 
|
| © | Знак охраны авторского права |
©
|
©
|
©
|
| ® | Знак зарегистрированной марки |
®
|
®
|
®
|
| € | Символ евро |
€
|
€
|
€
|
Роль кодировки при интерпретации спецсимволов
Процесс трансляции экранированных символов браузером неразрывно связан с базовой кодировкой текстового документа. Эталоном для сопоставления числовых кодов выступает стандарт Unicode. Десятичные и шестнадцатеричные escape-последовательности в HTML напрямую отражают значения Unicode-кодов, независимо от того, в какой кодировке сохранен сам файл.
В документах, использующих кодировку ASCII, набор ограничен 128 базовыми символами. Использование HTML-сущностей в таких условиях является единственным технически валидным способом отобразить расширенную латиницу, кириллицу, иероглифы или специфические типографские знаки. Любой символ вне диапазона ASCII требует обязательного преобразования в соответствующую сущность.
В современной инфраструктуре стандартом де-факто является UTF-8. Данная кодировка способна нативно передавать подавляющее большинство символов Unicode. Текст, сохраненный в UTF-8, позволяет напрямую использовать знаки валют или символы различных алфавитов без их предварительного кодирования. Несмотря на это, использование HTML-сущностей сохраняет свою практическую ценность. Они применяются для явного обозначения невидимых символов форматирования, предотвращения искажения данных при маршрутизации через транзитные системы без поддержки UTF-8, а также при интеграции текстовых массивов из внешних источников с невалидированной кодировкой.
Информационная безопасность: контекстное кодирование и защита от XSS
Преобразование управляющих символов в безопасные текстовые сущности представляет собой базовый эшелон защиты веб-инфраструктуры от инъекционных атак. Без предварительной обработки любого динамического контента, поступающего от пользователей или из внешних баз данных, браузер не способен отличить легитимную разметку от вредоносного скрипта. Процесс принудительного лишения текста свойств исполняемого кода гарантирует, что интерпретатор отобразит данные исключительно как визуальную информацию.
Механика уязвимости XSS
Вектор атаки XSS базируется на внедрении исполняемого JavaScript-кода в страницы, просматриваемые другими пользователями. Если веб-приложение принимает данные через формы комментариев, параметры URL или API-запросы и выводит их в исходный код без экранирования, переданный скрипт становится частью DOM-дерева. При рендеринге документа браузер интерпретирует неэкранированные теги
<script>
или атрибуты обработчиков событий, инициируя выполнение стороннего кода в контексте сессии текущего пользователя.
Выполнение несанкционированного кода на стороне клиента компрометирует приложение и влечет за собой ряд критических последствий:
- Кража сессионных токенов и файлов cookie, позволяющая перехватить авторизованную учетную запись пользователя.
- Модификация содержимого страницы или скрытое перенаправление трафика на фишинговые ресурсы.
- Выполнение HTTP-запросов и транзакций от имени жертвы без ее ведома.
- Несанкционированное чтение конфиденциальных данных, отображаемых в закрытом интерфейсе веб-приложения.
Стандарты OWASP и контекстное кодирование
Методология защиты, утвержденная в стандартах OWASP, требует применения контекстного кодирования выходных данных перед их интеграцией в ответ сервера. Термин указывает на то, что правила преобразования и набор экранируемых символов должны строго соответствовать месту вставки данных. Вывод строки внутри стандартных HTML-тегов, внутри значения атрибута, в блоке конфигурации JavaScript или в CSS-стилях требует разных подходов к экранированию.
Классическая операция HTML Escape закрывает большинство уязвимостей при публикации текста в теле документа. Замена угловых скобок и кавычек на соответствующие числовые или именованные сущности предотвращает парсинг непредусмотренных HTML-элементов браузером.
Наряду с кодированием применяется санитайзинг - алгоритмический процесс очистки входящего HTML-кода путем удаления потенциально опасных тегов и обработчиков событий при сохранении разрешенной безопасной разметки. В отличие от санитайзинга, который деструктивно модифицирует или удаляет часть исходных данных, полное экранирование сохраняет информацию в неизменном виде для конечного пользователя, делая ее технически инертной. Использование операций кодирования и декодирования позволяет разработчикам тестировать payload-строки, анализировать результат экранирования и верифицировать соответствие формируемых выходных данных строгим требованиям безопасности.
Практическое применение: безопасное отображение сниппетов кода и атрибутов
При публикации примеров исходного кода на веб-страницах браузер продолжает интерпретировать любые встреченные HTML-теги, даже если они размещены внутри специализированных элементов форматирования. Теги
pre
и
code
сохраняют пробелы и переносы строк, но не отключают парсинг разметки. Чтобы отобразить фрагмент HTML, XML или клиентского скрипта в виде читаемого текста, исходная строка предварительно подвергается операции HTML Encode. Замена угловых скобок на соответствующие мнемоники переводит код из исполняемого состояния в безопасное текстовое представление, которое браузер выводит на экран без попыток рендеринга.
Интеграция динамических данных в значения HTML-атрибутов требует применения более строгих правил кодирования, где основное внимание уделяется кавычкам. Если пользовательский ввод помещается внутрь атрибута, такого как
value
в форме ввода или
title
в информационной подсказке, неэкранированная кавычка приведет к преждевременному закрытию атрибута. Это нарушает структуру документа и создает вектор для внедрения сторонних обработчиков событий.
Специфика контекстного экранирования определяет выбор заменяемых символов в зависимости от места вставки данных:
| Контекст размещения данных | Критичные символы для экранирования | Предотвращаемая проблема |
|---|---|---|
| Текстовый узел (внутри стандартных тегов разметки) | Угловые скобки, амперсанд | Несанкционированное создание новых HTML-элементов |
| Значения HTML-атрибутов | Двойные и одинарные кавычки | Преждевременное закрытие атрибута и инъекция параметров |
Предотвращение двойного экранирования и обратное декодирование
При многократной маршрутизации данных между подсистемами возникает технический риск двойного экранирования. Если строка, уже содержащая HTML-сущности, повторно проходит через алгоритм кодирования, символ амперсанда в существующих мнемониках заменяется на свою экранированную версию. Визуально это приводит к ошибочному отображению самих кодов сущностей вместо ожидаемых символов в браузере конечного пользователя.
Для предотвращения подобных ошибок и обеспечения правильного цикла редактирования применяется операция HTML Unescape. Обратное декодирование восстанавливает исходную структуру данных, что является обязательным этапом перед передачей текста в среды, не поддерживающие или не требующие HTML-парсинга.
Сценарии, требующие обязательного применения операции разэкранирования:
- Подготовка экранированного контента для загрузки в визуальные редакторы WYSIWYG, требующие передачи сырой разметки или чистого текста.
- Экспорт текстовой информации из веб-приложения в форматы, не связанные с веб-стандартами, такие как формирование CSV-файлов или генерация PDF-документов.
- Передача данных через API сторонним сервисам, ожидающим текст в исходной кодировке без использования веб-сущностей.
- Анализ логов и отладка баз данных, где требуется чтение предварительно закодированных строк в их оригинальном человекочитаемом виде.
Эквиваленты HTML Escape в серверных языках программирования
Алгоритмы двустороннего преобразования зарезервированных символов стандартизированы и имеют прямые нативные реализации в большинстве серверных сред. Логика замены критичных элементов разметки на безопасные мнемоники идентична как при изолированном выполнении операции, так и при потоковой обработке данных на стороне сервера. Это обеспечивает предсказуемость рендеринга и позволяет использовать единые стандарты санитайзинга независимо от выбранного стека технологий.
В серверной разработке применяются встроенные функции, реализующие логику кодирования и обратного декодирования строк. Основные технические аналоги операции представлены в таблице ниже.
| Среда разработки | Операция кодирования (HTML Encode) | Операция декодирования (HTML Unescape) |
|---|---|---|
| PHP |
htmlspecialchars()
,
htmlentities()
|
htmlspecialchars_decode()
,
html_entity_decode()
|
| Python |
html.escape()
|
html.unescape()
|
В среде PHP функция
htmlspecialchars()
обрабатывает минимально необходимый набор критических символов, включая амперсанды, кавычки и угловые скобки, что делает ее стандартом для предотвращения инъекций разметки при выводе переменных в шаблонах. Функция
htmlentities()
выполняет более агрессивное преобразование, конвертируя все символы, имеющие эквиваленты в спецификации. В Python модуль
html
предоставляет методы
html.escape()
и
html.unescape()
, обеспечивая строгую совместимость с актуальными спецификациями при формировании динамического контента или обработке структур данных.
Использование независимой среды для преобразования строк помогает разработчикам верифицировать правильность формирования escape-последовательностей перед интеграцией соответствующих функций валидации данных в исходный код проекта. Предварительное выполнение операции над фрагментом текста позволяет точно спрогнозировать поведение встроенных библиотек языка и исключить архитектурные ошибки на этапе проектирования.
Сценарии применения предварительной верификации при проектировании бекенда:
- Формирование эталонных наборов данных (mock data) для unit-тестов, проверяющих логику работы модулей санитайзинга и фильтрации пользовательского ввода.
- Анализ поведения сложных строк со вложенными кавычками и спецсимволами для предотвращения синтаксических конфликтов при генерации ответа сервера.
- Сравнение эталонного экранированного вывода с фактическим результатом работы серверного приложения для выявления проблем с локализацией или некорректным применением нативных функций парсинга.
- Подготовка статических конфигурационных файлов и словарей локализации, где наличие неэкранированных символов может нарушить чтение структуры данных интерпретатором.