Декодирование экранированных символов в CSS преобразует служебные escape sequences обратно в привычные читаемые значения. Инструмент выполняет точную конвертацию исходных данных. На вход подается строка или фрагмент кода со скрытыми глифами. Результатом операции становится чистый текст.
Специалисты часто сталкиваются с файлами, где специфичные знаки, кириллица или иконки заменены на шестнадцатеричные коды с обратным слэшем. Читать такой код визуально тяжело. Восстановление исходного синтаксиса таблиц стилей возвращает понятный формат. Полученный текст полностью готов для дальнейшего структурного анализа и ручного редактирования.
Алгоритм извлекает и переводит только целевые участки.
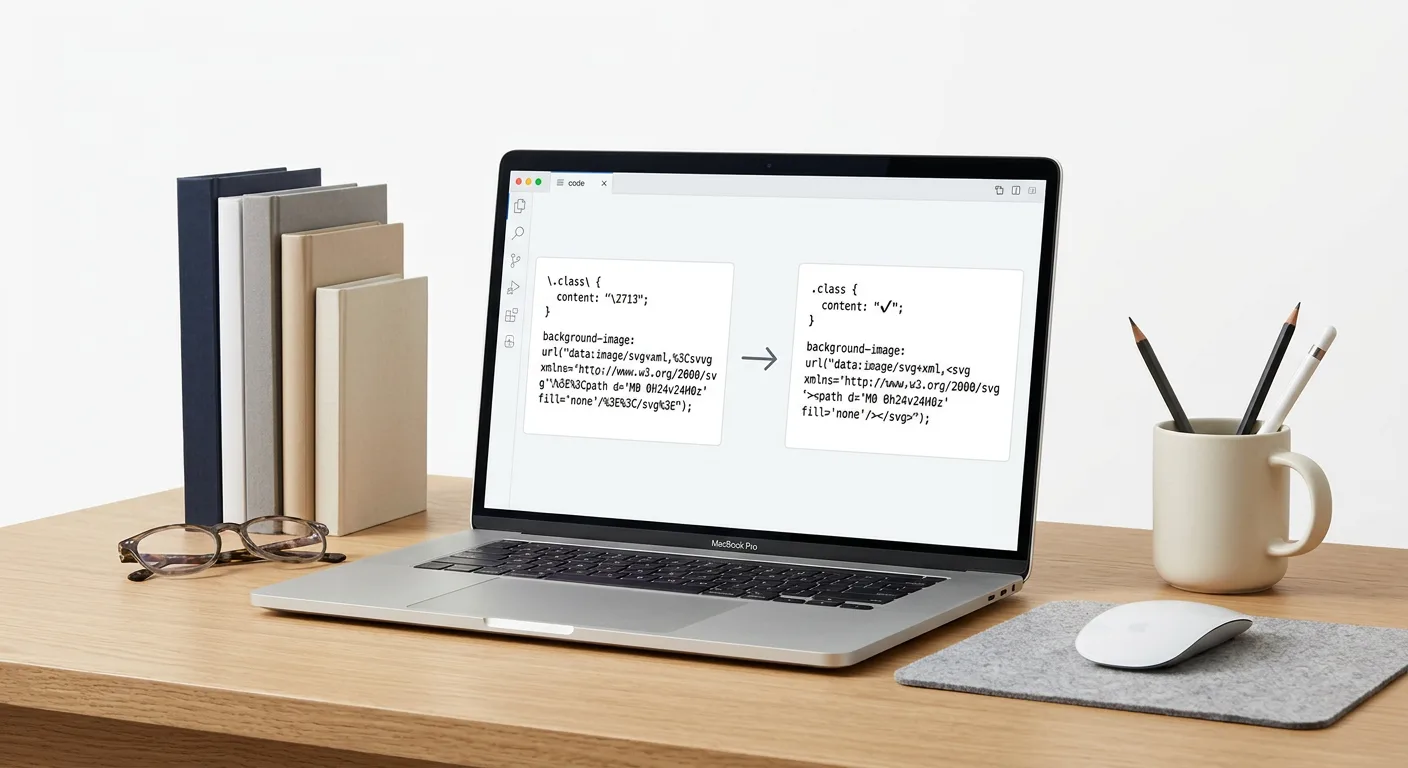
Синтаксис экранирования в CSS: спецификация и форматы
Стандарты CSS определяют строгие правила кодирования знаков, которые конфликтуют с синтаксисом таблиц стилей или выходят за пределы базового набора ASCII. Инициализатором любой эскейп-последовательности выступает обратный слэш (\). Появление этого символа сигнализирует парсеру об изменении логики обработки последующих данных, отменяя их стандартное синтаксическое значение.
Входные данные, содержащие экранированные участки, базируются на двух основных форматах записи:
- Шестнадцатеричные последовательности. Конструкция состоит из обратного слэша и следующего за ним шестнадцатеричного кода длиной от 1 до 6 символов. Допускается использование букв как верхнего, так и нижнего регистра (a-f, A-F). Формат позволяет записывать значения в кратком виде (например, \E9) или дополнять их ведущими нулями до максимальной длины (например, \0000E9).
- Экранированные зарезервированные символы. Формат применяется для знаков, выполняющих служебные функции в CSS-селекторах. Обратный слэш устанавливается непосредственно перед специальным символом, чтобы интерпретировать его как часть текстовой строки или имени, а не как оператор. К таким записям относятся конструкции вида \:, \. или \+.
Спецификация CSS3 устанавливает жесткое правило обработки пробельных символов, которые следуют сразу за шестнадцатеричным кодом. Если эскейп-последовательность содержит менее шести символов, один пробельный символ (пробел, знак табуляции или перевод строки), идущий непосредственно после нее, поглощается парсером.
Поглощенный пробел интерпретируется исключительно как терминатор последовательности. Он указывает на то, где заканчивается шестнадцатеричный код и начинается остальной текст, и не выводится как фактический пробел в итоговом значении. Правило поглощения не применяется к экранированным специальным символам, а также к шестнадцатеричным последовательностям, которые состоят ровно из шести знаков.
| Формат экранирования | Структура синтаксиса | Пример записи в коде |
|---|---|---|
| Шестнадцатеричный (краткий) | \ + от 1 до 5 символов | \E9 |
| Шестнадцатеричный (полный) | \ + 6 символов | \0000E9 |
| Служебный символ | \ + зарезервированный знак | \+ |
Алгоритм преобразования и восстановления исходных символов
Процесс обработки входных данных строится на последовательном анализе строки CSS-кода, содержащей экранированные последовательности. Основная логика заключается в поиске специфических маркеров и их последующем декодировании без изменения общего контекста документа.
Процедура восстановления исходных знаков включает следующие этапы:
- Обнаружение инициализатора. Парсер сканирует переданную текстовую строку слева направо до нахождения обратного слэша, который сигнализирует о начале эскейп-последовательности.
- Чтение и лексический анализ. После обнаружения маркера считываются последующие символы для определения границ и формата текущего блока данных.
- Идентификация значения. Алгоритм определяет природу последовательности: является ли она шестнадцатеричным кодом (Hexadecimal) или экранированным специальным символом.
- Конвертация. Идентифицированный hex-код преобразуется в соответствующий Unicode character. В случае со специальными символами алгоритм отбрасывает обратный слэш, возвращая знак в исходное состояние.
При обработке кратких шестнадцатеричных последовательностей (менее шести символов) алгоритм применяет правило поглощения. Терминирующий пробельный символ, следующий сразу за кодом, корректно распознается как ограничитель, исключается из формируемой строки и не выводится в финальный результат.
Выходными данными операции является очищенный исходный код в кодировке UTF-8. Процесс преобразования характеризуется строгой изоляцией: модификации подвергаются исключительно обнаруженные экранированные участки.
Логика декодирования гарантирует сохранение оригинального синтаксиса таблиц стилей. Инструмент не изменяет структуру CSS-селекторов, иерархию правил, названия свойств, пунктуацию или форматирование. Все элементы исходного кода, не являющиеся эскейп-последовательностями, переносятся в выходную строку в неизменном виде, тогда как экранированные участки точечно заменяются на соответствующие им читаемые глифы.
Практические сценарии использования CSS Unescape
Процесс обратного преобразования экранированных последовательностей применяется при отладке, аудите и реверс-инжиниринге таблиц стилей. Декодирование позволяет вернуть коду исходную читаемость, что необходимо для решения ряда специфических задач Frontend-разработки.
-
Анализ иконочных шрифтов в псевдоклассах. В правилах для
::beforeи::afterсвойствоcontentчасто содержит шестнадцатеричные значения глифов. Определение видаcontent: '\f007'визуально не дает информации о фактической иконке, которая будет выведена на экран. Преобразование таких участков в реальные Unicode-символы упрощает инвентаризацию подключенных шрифтовых наборов и сверку верстки с дизайн-макетами. - Деобфускация после автоматической сборки. При обработке исходных файлов через CSS Minifier, Sass или LESS кириллические символы, текстовые строки и специфическая типографика могут конвертироваться в escape-последовательности. Подобная трансформация применяется для безопасной передачи файлов, но делает ручной анализ кода практически невозможным. Восстановление исходных знаков позволяет прочитать скомпилированный код, проверить локализацию текста и найти ошибки в конфигурации сборочных инструментов.
- Работа с нестандартными CSS-селекторами. Спецификация допускает использование в именах классов и ID различных специальных знаков, которые обязательно экранируются в исходных таблицах стилей. Если архитектура проекта подразумевает использование утилитарных классов со сложным синтаксисом, включающим точки, двоеточия или математические операторы, парсинг такого кода затруднен. Перевод экранированных участков селекторов в читаемый формат помогает визуально сопоставить CSS-правила с атрибутами элементов в разметке документа.
Взаимодействие с Unicode и обработка кодировок
Каждая экранированная последовательность в таблицах стилей представляет собой текстовую ссылку на конкретный символ. Диапазон допустимых значений полностью соответствует спецификации и охватывает кодовое пространство от U+0000 до U+10FFFF. Процесс декодирования преобразует эти шестнадцатеричные идентификаторы непосредственно в соответствующие байты кодировки UTF-8. Такая конвертация позволяет перевести безопасное представление кода в фактический глиф, который этот код обозначает, обеспечивая строгую синхронизацию исходного текста с международными стандартами кодирования.
Ошибки в таблицах стилей часто возникают из-за конфликта кодировок и неправильной интерпретации данных. Если веб-браузер или парсер не может корректно прочитать исходный документ, происходит искажение текста. Это приводит к появлению нечитаемых символов, известных как кракозябры. Подобная ситуация типична при отсутствии явного указания кодировки или передаче неверных заголовков. Восстановление исходных знаков из экранированных последовательностей позволяет нормализовать документ. Это гарантирует, что все специфические символы явно записаны в правильной байтовой структуре UTF-8, исключая двусмысленность при машинном чтении кода.
При работе с файлами таблиц стилей необходимо разделять два принципиально разных подхода к обработке текстовых данных.
| Среда обработки | Механизм интерпретации символов | Целевое назначение |
|---|---|---|
| Динамический рендеринг в браузере | Преобразование экранированных участков выполняется в оперативной памяти при построении CSSOM. Исходный текстовый файл физически не изменяется. | Корректное визуальное отображение контента и применение правил типографики на стороне клиента. |
| Статическая очистка кода | Прямая физическая замена шестнадцатеричных последовательностей на соответствующие байты UTF-8 непосредственно в тексте документа. | Подготовка читаемого синтаксиса для последующего программного и ручного анализа. |
Статическая очистка кода критически важна для корректной работы профилирующих инструментов разработчика. Если передать файл с большим количеством экранированных конструкций в CSS Prettifier или CSS Validator, программы могут неверно вычислить фактическую длину строк, нарушить правила отступов форматирования или выдать ложные предупреждения о синтаксических ошибках. Предварительный перевод кодов из диапазона U+0000-U+10FFFF в нативные символы кодировки UTF-8 устраняет обфускацию, предоставляя анализаторам чистый текст для точной валидации и структурирования.