Структурирование стилей CSS-кода необходимо для приведения каскадных таблиц к читаемому виду. Онлайн-инструмент принимает на вход сырой массив данных. Затем алгоритм автоматически выстраивает четкую визуальную иерархию элементов.
Процесс форматирования строго восстанавливает исходную визуальную структуру документа за счет правильной расстановки отступов и переносов строк. Семантика правил при этом не меняется. Работа селекторов и каскадная логика остаются полностью неизменными.
Полученный результат напрямую упрощает визуальный анализ исходного кода. Четкое разделение блоков деклараций позволяет без труда находить нужные свойства при ручном редактировании объемных файлов.
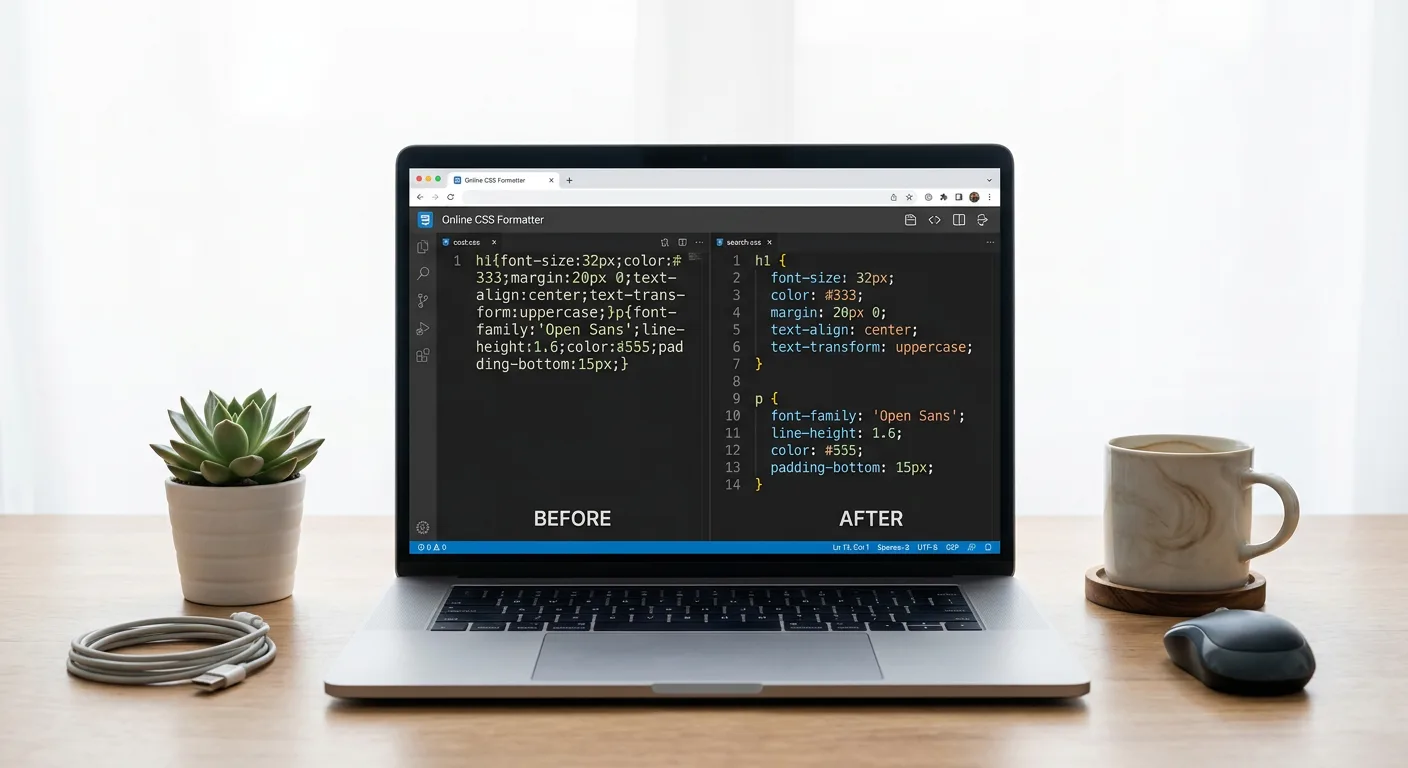
Принципы форматирования таблиц стилей
Читаемость исходного текста напрямую зависит от предсказуемости его оформления. Концепция форматирования (pretty code, beautifier) базируется на применении единых правил выравнивания и разделения кодовых конструкций. Визуальное структурирование каскадных таблиц стилей опирается на создание четкой иерархии, где каждый логический элемент занимает строго отведенное место, что исключает сплошное слияние текста.
Для достижения оптимальной визуальной структуры обработке подвергаются все базовые компоненты CSS-правила. Упорядочивание затрагивает следующие ключевые элементы синтаксиса:
- Селектор: определяет целевой элемент и располагается в начале правила.
- Фигурные скобки: выступают границами, которые открывают и закрывают блок деклараций.
- Блок деклараций: выступает общим контейнером для набора инструкций форматируемого селектора.
- Свойство: конкретная характеристика, которая переносится на новую строку внутри блока.
- Значение: параметр характеристики, который визуально отделяется от свойства.
- Точка с запятой: выступает терминатором декларации, после которого требуется обязательный разрыв строки.
Процесс приведения кода к читаемому виду заключается в систематической расстановке разделителей: пробелов (spaces) и символов переноса строки (line breaks). Логика структурирования требует, чтобы между селектором и открывающей фигурной скобкой находился пробел, а каждое новое свойство со своим значением и точкой с запятой начиналось с новой строки. Закрывающая скобка также изолируется на отдельной строке, визуально завершая текущий блок деклараций.
Принципиальным аспектом такого преобразования является строгая изоляция визуального представления от программного исполнения. Форматирование упорядочивает исключительно синтаксис. Добавленные пробелы и переносы строк игнорируются браузером при рендеринге страницы, поэтому специфичность селекторов и общая каскадная логика остаются полностью неизменными. Обработанные каскадные таблицы сохраняют абсолютную идентичность исходным правилам с точки зрения функциональности.
Деминификация: восстановление сжатого CSS-кода
В производственной среде файлы таблиц стилей, такие как
style.css
, часто подвергаются компрессии для уменьшения их объема и ускорения загрузки веб-страниц. В результате формируется минимизированный код, представляющий собой плотный массив символов. Входные данные для операции обратного преобразования выглядят как непрерывная текстовая строка, из которой полностью удалены лишние пробелы и символы переноса строки. Такой формат оптимален для передачи данных по сети и машинной обработки браузером, но делает исходный текст практически непригодным для визуального восприятия и прямого ручного редактирования.
Процесс приведения сжатого массива к читаемому формату известен как деминификация или анминификация. Эта техническая операция позволяет разминифицировать компрессированные каскадные таблицы, реконструируя их стандартную визуальную иерархию без изменения программной логики. Обработка таких данных базируется на строгом анализе содержимого и применении базовых правил форматирования.
Логика восстановления структуры включает следующие этапы преобразования:
- Парсинг токенов: разделение сплошного потока символов на изолированные синтаксические единицы, что позволяет точно идентифицировать селекторы, свойства, значения и управляющие элементы.
- Восстановление newlines: систематическое внедрение символов разрыва строки после каждой точки с запятой внутри блока деклараций, а также позиционирование закрывающих фигурных скобок на новых строках.
- Расстановка пробелов: добавление пустых интервалов в объявлениях для визуального отделения ключа свойства от присвоенного ему значения.
Результатом выполнения данной процедуры является получение читабельного исходного кода. Извлеченный из компрессированного состояния текст приобретает строгую вертикальную организацию. Декомпрессированный файл становится полностью пригодным для инспекции, позволяя специалисту легко ориентироваться в правилах форматирования и работать с отдельными декларациями без необходимости расшифровывать сплошные текстовые блоки.
Синтаксические правила визуального оформления кода
Стандартизация внешнего вида таблиц стилей требует строгого соблюдения синтаксических норм. Визуальное оформление базируется на иерархическом распределении элементов, где каждый уровень вложенности получает соответствующий визуальный вес. Это достигается за счет точного позиционирования управляющих символов и текстовых блоков.
Для обозначения иерархии применяется система отступов (indentation). Глубина вложенности регулируется добавлением пустого пространства перед началом строки. В зависимости от целевого стандарта форматирования, для создания отступа используется tab character или заданное количество spaces. Каждое открытие нового блока деклараций или управляющей директивы увеличивает уровень отступа на один шаг, а закрытие - уменьшает его, возвращая к исходной позиции.
Оформление сложных структур требует отдельного подхода к распределению элементов, так как они формируют многоуровневую вложенность:
- Медиазапросы (@media): Директивы адаптивного дизайна создают дополнительный контекст. Внешний блок позиционируется на базовом уровне, а все вложенные в него селекторы и их свойства смещаются вправо на один уровень отступа.
- Анимации (@keyframes): Правила ключевых кадров содержат собственные внутренние блоки. Объявление самой директивы остается на нулевом уровне, промежуточные шаги вычислений получают первый уровень отступа, а конкретные свойства внутри шагов - второй уровень.
- Сгруппированные селекторы: При перечислении нескольких селекторов, применяемых к одному набору правил, используется разделение запятыми. Для обеспечения читаемости каждый селектор переносится на новую строку, что предотвращает появление трудночитаемых горизонтальных конструкций.
Точное позиционирование базовых синтаксических конструкций определяет итоговый вид документа. Основные правила распределения включают обработку скобок, разрывов строк и пользовательских аннотаций:
- Позиционирование фигурных скобок (braces): Открывающая скобка размещается на одной строке с селектором, отделяясь от него одним пробелом. Закрывающая скобка выносится на отдельную строку и строго выравнивается по уровню отступа соответствующего селектора или родительской директивы.
- Распределение переносов строк (line breaks): Каждая пара ключа и значения внутри блока деклараций занимает отдельную строку. Между независимыми правилами внедряется пустая строка для визуального разделения логических сущностей.
- Сохранение аннотаций: Существующие CSS комментарии интегрируются в форматированную структуру без изменения их внутреннего текста. Если комментарий находится внутри блока деклараций, он выравнивается по текущему уровню отступа, сохраняя визуальную привязку к комментируемому свойству.
Практическое применение отформатированного CSS
Строгое соблюдение правил визуального позиционирования синтаксических конструкций напрямую влияет на эффективность работы вебмастеров и разработчиков. Структурированный вид таблиц стилей необходим для решения прикладных задач, связанных с поддержкой, масштабированием и аудитом клиентского кода. Предсказуемая организация отступов и переносов обеспечивает основу для глубокого анализа верстки.
Отладка сторонних скриптов и анализ DOM
При интеграции сложных визуальных компонентов часто требуется отладка сторонних скриптов, которые динамически манипулируют стилями. Читаемый формат кода обеспечивает четкое визуальное разделение классов, ID селекторов и селекторов псевдоклассов. Такое разделение критически важно при сопоставлении правил стилизации с текущим состоянием объектной модели документа.
Анализ DOM в инструментах разработчика происходит быстрее, когда исходный код имеет логичную структуру. Это правило одинаково актуально при работе с внешними файлами таблиц стилей и при обработке встроенных правил, расположенных непосредственно внутри HTML-документа через тег
<style>
. Специалист может визуально изолировать конкретный блок деклараций и отследить каскадные изменения, вызванные выполнением JavaScript-логики или изменением состояний элементов.
Рефакторинг таблиц стилей
Процесс рефакторинга таблиц стилей базируется на выявлении дублирующихся правил, избыточных каскадных вложенностей и устаревших конструкций. Поиск неиспользуемых стилей значительно упрощается, когда каждый селектор и его свойства изолированы друг от друга в соответствии со стандартами форматирования. Текстовые поисковые утилиты и скрипты статического анализа выдают более точные результаты при обработке структурированного текста.
Типовые задачи рефакторинга, требующие предварительного структурирования кода:
- Идентификация конфликтующих ID селекторов, переопределяющих глобальные классы логических блоков.
- Группировка разрозненных медиазапросов, относящихся к одному визуальному компоненту, для последующего объединения.
- Удаление пустых блоков деклараций или правил, оставшихся после удаления соответствующих узлов из исходной разметки.
- Выявление избыточной специфичности селекторов, усложняющей переопределение стилей на более низких уровнях каскада.
Семантическая проверка свойств
Семантическая проверка свойств направлена на контроль корректности использования CSS-правил в контексте кроссбраузерной верстки и современных стандартов спецификации. Визуально упорядоченный список свойств внутри блока деклараций позволяет выявлять синтаксические аномалии, конфликтующие директивы или некорректное применение единиц измерения.
Зависимость эффективности ручных и автоматизированных проверок от формата исходного документа наглядно проявляется при сравнении подходов к анализу структур данных:
| Аспект проверки | Сжатый или хаотичный код | Отформатированный код |
|---|---|---|
| Валидация значений | Требует горизонтального скроллинга и сложного визуального разбора непрерывной строки токенов. | Значения выровнены вертикально по левому краю, что ускоряет сканирование ключей и параметров. |
| Поиск дубликатов свойств | Сложно идентифицировать повторные переопределения внутри одного блока из-за отсутствия структуры. | Повторы мгновенно распознаются благодаря строгому построчному распределению пар свойство-значение. |
| Анализ селекторов | Сложные цепочки селекторов сливаются с открывающими скобками и декларациями. | Сгруппированные селекторы разделены переносами строк, структура вложенности очевидна. |
Использование отформатированных исходных файлов исключает влияние синтаксического шума на процесс инспекции. Специалист концентрируется исключительно на логике каскада, правильности применения вендорных префиксов и валидности используемых значений, не тратя ресурсы на расшифровку неструктурированного текста.