Уменьшение размера CSS-стилей выполняется для оптимизации текстового представления таблиц каскадных стилей перед их развертыванием. Инструмент решает задачу преобразования исходного кода путем автоматического удаления всех незначащих символов. Из текстового блока исключаются лишние пробелы, символы табуляции и переводы строк, которые разработчики оставляют для удобства чтения. Такое визуальное форматирование совершенно не требуется браузеру для обработки инструкций.
Входными данными для обработки служит валидный исходный код CSS. От корректности синтаксиса на входе напрямую зависит безошибочная работа алгоритма сжатия.
Выходные данные представляют собой плотный минимизированный код. Операция выполняется без потери функциональности исходных стилей. В результате формируется оптимизированный набор инструкций, который полностью сохраняет первоначальную логику отображения документа.
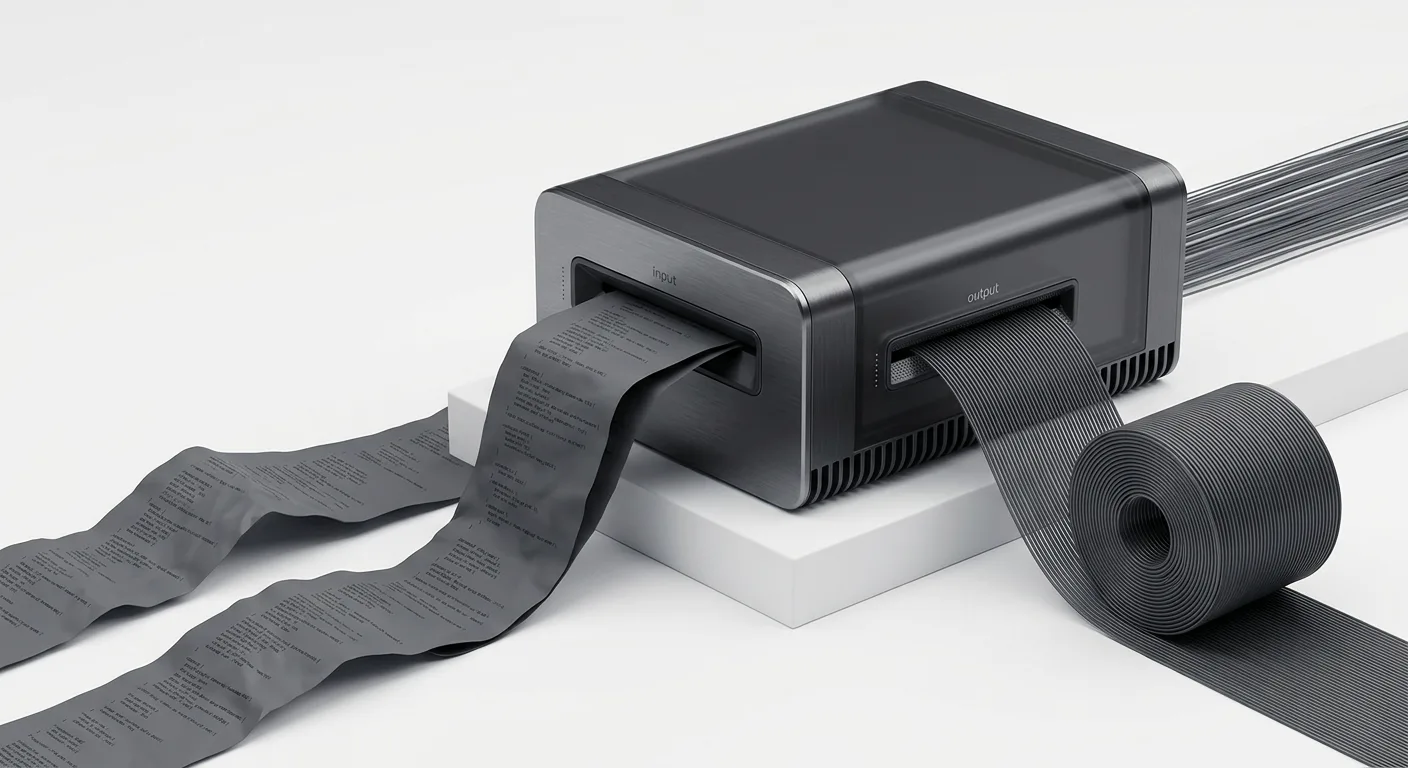
Механика минификации исходного CSS-кода
Процесс текстовой обработки таблиц стилей базируется на лексическом разборе, который отделяет значимые синтаксические конструкции от визуального форматирования. Алгоритм построчно сканирует исходный текст и идентифицирует символы, добавленные исключительно для удобства чтения разработчиком. К таким символам относятся табуляции, переводы строк и последовательности пробелов. Поскольку парсер браузера ориентируется на разделители вроде фигурных скобок и точек с запятой, визуальные отступы безопасно удаляются из структуры.
При преобразовании кода выполняется точечная очистка следующих элементов форматирования:
- Символы перевода строк, разделяющие отдельные правила и блоки.
- Пробелы и табуляции, формирующие отступы внутри конструкций.
- Лишние пробелы между именами селекторов и открывающими фигурными скобками.
- Пробельные символы вокруг двоеточий в объявлениях свойств и после точек с запятой.
При удалении незначащих символов применяется жесткое правило сохранения синтаксической целостности документа. Обработка затрагивает только пробельное пространство, не изменяя текстовые значения, имена и логические операторы. Это позволяет гарантировать, что все стилистические инструкции будут интерпретированы браузером в точном соответствии с задумкой разработчика.
Следующие ключевые элементы синтаксиса остаются абсолютно неизменными:
- CSS-селекторы всех типов, включая классы, идентификаторы и атрибуты.
- Названия и значения CSS-свойств вместе с их единицами измерения.
-
Псевдоклассы, определяющие состояния элементов, такие как
:hover,:activeили:focus. -
Управляющие директивы и
@media-запросы, отвечающие за адаптивное поведение макета. -
Пользовательские свойства и CSS-переменные, в том числе глобальные объявления внутри
:root.
Сохранение оригинальной последовательности правил является критическим условием обработки. Поскольку порядок следования блоков не меняется, базовая логика каскадирования, специфичность селекторов и механизмы наследования свойств работают штатно. В результате отображение веб-страницы в браузере не нарушается: пользовательский интерфейс рендерится идентично тому, как он выглядел бы при использовании исходного неформатированного файла стилей.
Влияние сжатия стилей на метрики Web Vitals
Браузер не может начать отрисовку страницы до полной загрузки и синтаксического анализа всех таблиц стилей, так как CSS является блокирующим рендеринг ресурсом. Уменьшение физического размера файлов, измеряемого в байтах и KiB, пропорционально сокращает время загрузки документа. Чем меньше базовый объем данных, тем быстрее конструируется CSSOM-дерево и снимается блокировка отображения контента на экране.
Ускоренная обработка стилей напрямую коррелирует с улучшением ключевых показателей производительности фронтенда:
- FCP: Быстрая доставка стилей по сети позволяет браузеру раньше отобразить первые пиксели документа, включая базовый текст, фоновые заливки и границы структурных элементов интерфейса.
- LCP: Объемные таблицы стилей отодвигают момент отрисовки основного визуального элемента страницы. Снижение веса кода минимизирует задержку перед финальным рендерингом крупного текстового блока или главного изображения в текущей области просмотра.
На сетевом уровне удаление избыточных символов из структуры документа приводит к существенному сокращению объема передаваемых данных по сети. Оптимизированный трафик данных снижает утилизацию доступной полосы пропускания и ускоряет прохождение пакетов через инфраструктуру узлов. Сокращение количества байтов снижает вероятность того, что загрузка файла потребует дополнительных циклов обмена данными при доставке через соединения с высокой сетевой задержкой.
В рамках подготовки проекта к этапу продакшна применяется концепция совместного использования текстовой минификации с алгоритмами потокового серверного сжатия, такими как GZip или Brotli. Серверные алгоритмы построены на принципах поиска повторяющихся паттернов в массиве данных. Предварительное удаление форматирующих пробелов, табуляций и переносов строк повышает плотность полезной нагрузки и увеличивает частоту совпадений синтаксических токенов. Благодаря этому GZip и Brotli упаковывают предварительно минимизированный CSS-поток значительно эффективнее, достигая максимального сокращения физического объема файлов перед отправкой клиенту.
Требования к входным данным и структура результата
В качестве исходных данных принимается стандартный код формата text/css. Фундаментальным условием корректной обработки является синтаксическая валидность предоставляемых таблиц стилей. Процесс текстового преобразования опирается на целостность исходного документа, поэтому отсутствие закрывающих фигурных скобок, пропущенные точки с запятой или некорректно экранированные символы до начала обработки могут привести к нарушению логики каскада после удаления изолирующих пробелов и переносов.
Структура входных данных может содержать сложные синтаксические конструкции. Процесс минификации предусматривает точную работу со следующими элементами исходного кода:
- Инлайновые стили: Допускается передача фрагментов кода, изначально предназначенных для использования внутри атрибутов HTML-элементов, без привязки к внешним селекторам.
- Блоки url(...): При наличии ресурсов, таких как шрифты, векторная графика или растровые изображения, закодированные в виде строк base64, текстовый массив внутри круглых скобок сохраняется в неизменном виде. Строки base64 не подвергаются модификации, что исключает риск повреждения внедренных данных при удалении окружающего форматирования.
Выходным результатом операции выступает единая, непрерывная текстовая строка, содержащая все исходные правила. Из-за отсутствия структурных отступов и визуального разделения блоков код теряет читаемость для человека, приобретая форму, предназначенную исключительно для машинного парсинга.
Полученный массив данных полностью готов к интеграции в проектную инфраструктуру. Использование результата предполагает два основных вектора:
- Прямое внедрение: Строка стилей копируется для вставки непосредственно в секцию head документа для ускорения отрисовки критического интерфейса.
- Внешний документ: Сжатый код сохраняется как самостоятельный файл с расширением .min.css. Использование суффикса min в названии является стандартным маркером для идентификации файлов, прошедших процедуру удаления избыточных символов.
Сценарии применения в пайплайне веб-разработки
Разделение кода на рабочую и публикуемую версии является техническим стандартом при развертывании проектов в среде production. На этапе создания интерфейса исходный код пишется в формате, удобном для разработчика: с подробным форматированием, логическими блоками и визуальными границами, что необходимо для поддержки архитектуры проекта. Перед доставкой кода конечным пользователям выполняется обязательная конвертация этого человекочитаемого формата в машинно-читаемый.
Полученная в результате конвертации плотная строка стилей оптимизирована исключительно для быстрого парсинга движком браузера и построения дерева CSSOM. Использование такого подхода в пайплайне разработки позволяет решить две противоположные задачи:
- Сохранение читабельности: Исходные файлы остаются в системе контроля версий для удобного внесения правок командой инженеров.
- Производительность релиза: Минимизированный код становится финальным артефактом сборки, который отправляется на сервер, хостинг или узел CDN для обслуживания клиентских запросов.
Для объективной оценки результатов подготовки файлов к релизу применяются базовые метрики эффективности. Главным показателем выступает коэффициент сжатия (Compression Ratio). Эта метрика демонстрирует долю удаленного избыточного кода и рассчитывается путем прямого математического сопоставления первоначального размера документа с полученным результатом.
| Метрика | Описание и расчетное значение |
|---|---|
| Исходный размер | Объем оригинального файла с форматированием, выраженный в байтах. Представляет собой точку отсчета до применения конвертации. |
| Сжатый результат | Физический объем итоговой строки кода. Отражает реальный вес артефакта, который будет загружаться клиентским устройством. |
| Абсолютная экономия | Разница между исходным и сжатым размером. Показывает точное количество байт форматирования, исключенных из итогового документа. |
| Коэффициент сжатия | Относительный показатель оптимизации. Вычисляется по логике: (Исходный размер - Сжатый результат) / Исходный размер * 100. Выражается в процентах. |
Отслеживание коэффициента сжатия на этапе развертывания служит индикатором качества подготовки статических ресурсов. Анализ сопоставления исходного и сжатого размеров дает инженерам точные данные о том, какую долю от общего веса файлов занимали структуры, не влияющие на отрисовку документа, и позволяет прогнозировать потребление ресурсов при масштабировании кодовой базы.