Онлайн-инструмент распознает и извлекает элементы списка из изображения, преобразуя фотографии документов, скриншоты или сканы в редактируемый цифровой текст. При работе с графическими файлами перечни товаров, задач или характеристик представляют собой обычный набор пикселей, недоступный для прямого копирования и построчного редактирования. Алгоритм анализирует визуальную структуру загруженной картинки, находит текстовые блоки и отделяет пункты перечня друг от друга. На выходе формируется упорядоченный текстовый набор данных, где каждая позиция исходного списка выступает отдельным элементом, готовым к вставке в документ, таблицу или базу данных.
В отличие от сплошного чтения текста с картинки, целевое извлечение пунктов требует точного сохранения границ каждой отдельной позиции и порядка их следования.
Исходными данными для обработки служат графические файлы с печатными или рукописными перечнями: нумерованными, маркированными, одноуровневыми или многоуровневыми. Система считывает символы с помощью OCR, определяет визуальные признаки начала новой строки, распознает отступы, цифры и маркеры. Даже если один пункт занимает несколько строк на фотографии, инструмент объединяет их в единую логическую запись, не разрывая фразу на несвязанные части. Такой подход избавляет от ручного перепечатывания номенклатуры, бумажных чек-листов, спецификаций или списков со скриншотов рабочих программ.
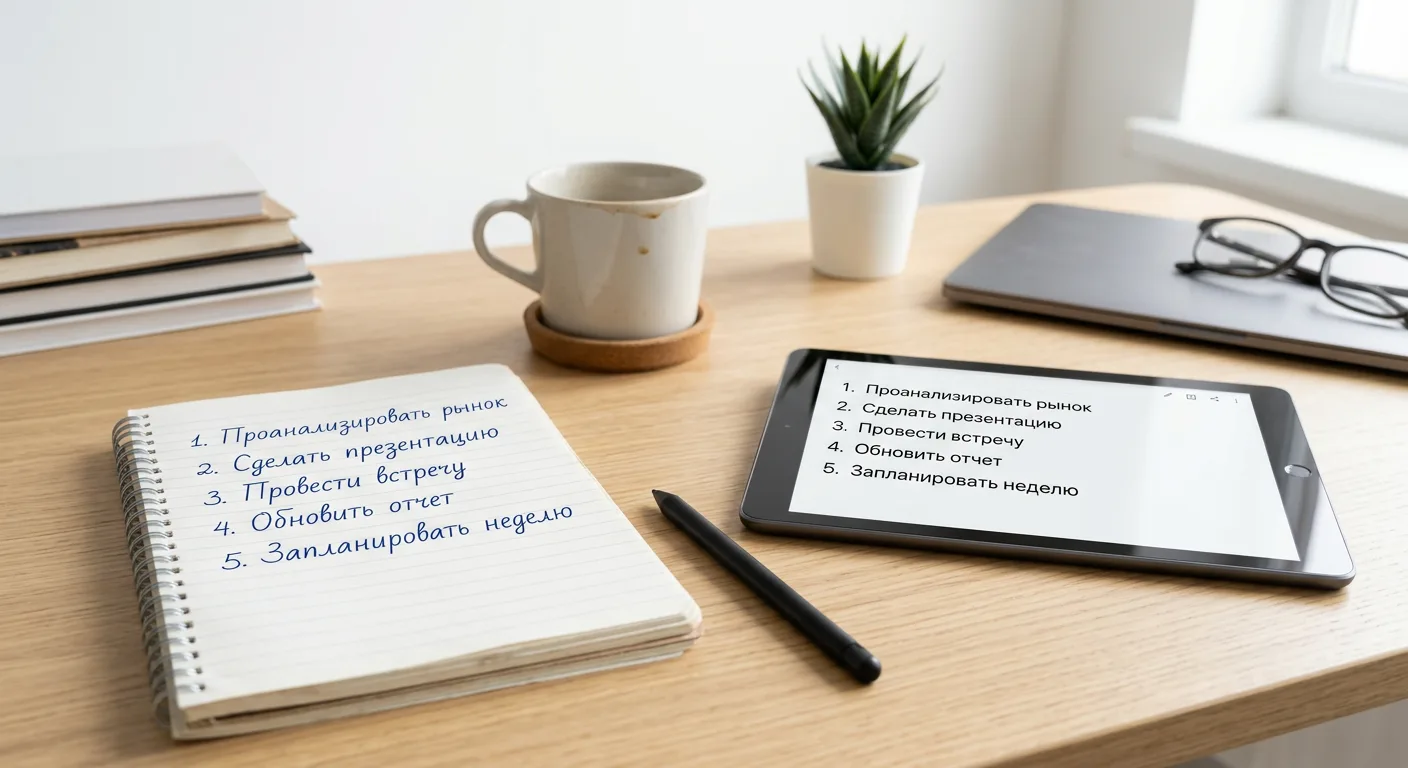
Принцип распознавания и извлечения пунктов списка из изображений
Задача извлечения структурированных перечней из графики выходит за рамки простого чтения букв и цифр. При стандартном считывании текста с картинки все найденные слова часто сливаются в сплошной абзац или разбиваются строго по физическим границам строк на изображении. Для выделения отдельных позиций списка требуется комбинация двух процессов: распознавания символов с помощью OCR и пространственного анализа макета документа.
Техническая логика обработки строится на том, что любой список на изображении обладает визуальными и геометрическими признаками. Пункты выровнены по вертикальной оси, имеют характерные маркеры в начале строки или отделены друг от друга предсказуемыми интервалами. Анализ этих пространственных закономерностей позволяет понять, где заканчивается одна мысль или товарная позиция и начинается следующая.
Этапы обработки графического файла и выделения структуры
Преобразование пиксельной области в упорядоченный набор текстовых записей происходит последовательно. Каждый этап решает отдельную задачу по отделению полезной структуры от фонового оформления и случайного текста.
- Обнаружение текстовых областей: на изображении определяются зоны, содержащие символы, и отсекаются пустые поля, графические рамки, декоративные линии или иллюстрации.
- Сегментация на блоки и строки: найденный массив текста делится на отдельные горизонтальные линии и логические абзацы на основе межстрочных интервалов и пустых пространств.
- Оптическое распознавание с помощью OCR: графические очертания знаков внутри каждой выделенной строки переводятся в цифровые коды символов, формируя слова и числа.
- Идентификация признаков списка: в начале строк фиксируются специфические элементы - цифры с точкой или скобкой, буквенные индексы, тире, точки, галочки и другие графические маркеры.
- Анализ геометрии и отступов: сопоставляются координаты начала строк по горизонтали, что необходимо для определения вложенности пунктов и границ одного элемента.
- Фильтрация и сборка перечня: посторонние текстовые блоки отбрасываются, а строки, относящиеся к одной позиции, склеиваются в единую запись с сохранением исходной очередности.
Анализ макета и определение границ отдельного пункта
Главная сложность при разборе списков на изображениях - отличить перенос длинной фразы на новую строку от начала следующего пункта. Если ориентироваться только на геометрический конец строки у правого края картинки, один длинный элемент списка распадется на несколько самостоятельных фрагментов. Чтобы избежать такого дробления, при анализе макета оценивается совокупность визуальных и текстовых признаков.
В таблице приведены основные структурные ориентиры, по которым разграничиваются элементы перечня и формируется итоговая последовательность:
| Структурный признак на изображении | Что означает при анализе макета | Влияние на формирование списка |
|---|---|---|
| Наличие маркера или порядкового номера в начале строки | Явный индикатор старта новой позиции в перечне | Строка выделяется как самостоятельный элемент списка |
| Отсутствие маркера при совпадении левого отступа с текстом предыдущей строки | Вынужденный перенос длинного предложения внутри текущей позиции | Текст присоединяется к предыдущему пункту без разрыва записи |
| Увеличенный отступ слева и смещение маркера вглубь страницы | Признак дочернего элемента или подпункта в структуре | Позиция фиксируется как вложенный элемент или отдельный пункт с сохранением порядка чтения |
| Увеличенный вертикальный интервал между соседними строками | Визуальный разделитель между логическими блоками при отсутствии маркеров | Граница интервала разделяет соседние элементы перечня |
| Крупный кегль, выравнивание по центру или отсутствие признаков перечисления | Заголовок документа, вводный абзац, колонтитул или примечание | Блок отделяется от основного списка и не смешивается с рядовыми пунктами |
Отделение списка от остального содержимого
Реальные изображения редко содержат исключительно сам перечень. На фотографиях страниц, сканах накладных или снимках экрана помимо целевых пунктов присутствуют заголовки, даты, подписи, элементы пользовательского интерфейса или пояснительные абзацы. Если извлекать абсолютно весь распознанный текст подряд, в итоговый список попадет информационный мусор, который придется удалять вручную.
Отделение целевого перечня от постороннего текста базируется на поиске повторяющихся структурных паттернов. Группа строк, имеющих одинаковое выравнивание по левому краю, схожие межстрочные интервалы и однотипные начальные символы, классифицируется как единая зона списка. Одиночные строки в верхней или нижней части изображения, которые не вписываются в эту сетку координат и не продолжают логику нумерации, распознаются как внешние элементы макета. За счет такой пространственной фильтрации на выходе формируется чистый упорядоченный перечень, где каждый пункт соответствует реальной позиции исходного документа.
Характеристики исходных изображений и типов списков
Задача перевода перечней из графического вида в редактируемый текст решается на базе трех основных категорий входных изображений: снимков с камер мобильных устройств или фотоаппаратов, отсканированных страниц бумажных носителей и скриншотов цифровых экранов. Каждый тип источника формирует специфическую картину распределения пикселей, что напрямую определяет логику обнаружения строк и выделения отдельных позиций.
Скриншоты программных окон, веб-страниц, таблиц или мобильных приложений представляют собой изображения, сгенерированные непосредственно видеосистемой устройства. В таких данных символы имеют четкие пиксельные границы, однородный фон и строго горизонтальные базовые линии текста. Строки располагаются по предсказуемой координатной сетке, а отступы между пунктами кратны фиксированному числу пикселей.
Отсканированные страницы книг, договоров, ведомостей или бланков также характеризуются равномерным освещением и плоской геометрией листа, но несут на себе следы физического носителя. На таких изображениях может проявляться текстура бумаги, просвечивание текста с обратной стороны листа или мелкие дефекты печати. Фотографии документов, сделанные на камеру смартфона в бытовых или рабочих условиях, отличаются наибольшей вариативностью: лист может лежать на неровной поверхности, а расстояние от объектива до разных краев списка часто не совпадает.
Особенности распознавания печатного и рукописного текста
Характер начертания символов на изображении определяет сложность их идентификации при OCR. Печатный текст и компьютерные шрифты строятся по стандартизированным глифам: каждая буква в пределах одного шрифтового гарнитура имеет одинаковую геометрию, стабильную ширину штриха и предсказуемый межбуквенный интервал. Это позволяет однозначно отделять знаки друг от друга и отличать текстовые буквы от графических маркеров в начале строки.
Рукописные перечни - например, сфотографированные списки покупок, рабочие заметки в блокноте или заполненные от руки бланки - не имеют жесткой стандартизации. При обработке рукописного ввода возникают характерные особенности начертания:
- Связность символов при скорописи, когда соседние буквы внутри слова соединяются непрерывными линиями и не имеют четких вертикальных границ разделения.
- Индивидуальная вариативность форм, из-за которой одна и та же буква в разных строках одного списка может иметь разный наклон, высоту и ширину петли.
- Плавающая базовая линия, когда строка постепенно уходит вверх или вниз к правому краю листа при отсутствии разлиновки.
- Нестандартные рукописные пометки в начале пунктов, такие как галочки, крестики, косые черты или обведенные в кружок цифры, нарисованные с разным нажимом.
Разбор печатных символов из-за строгой геометрии штрихов дает предсказуемый результат даже при мелком кегле, тогда как чтение рукописных заметок требует раздельности написания букв и разборчивого почерка.
Работа с кириллицей, латиницей и смешанными алфавитами
Списки на изображениях часто содержат текст на разных языках или объединяют несколько алфавитов внутри одного пункта. Типичный пример - товарные накладные, перечни оборудования, списки литературы или технические спецификации, где описание позиции дано на кириллице, а название бренда, модель, артикул или серийный номер записаны латиницей.
Основная техническая сложность при чтении таких данных связана с омоглифами - символами из разных алфавитов и цифрового ряда, которые имеют идентичное или крайне схожее графическое начертание. Без учета словарного окружения и контекста строки отдельные знаки легко спутать между собой:
- Прописные и строчные буквы С, О, Р, Х, А, Е, Т, М, В, К в кириллическом и латинском наборах символов.
- Цифра 0 и буква О в артикулах, кодах номенклатуры или нумерации пунктов.
- Арабская цифра 1, римская цифра I, прописная латинская буква I и строчная латинская l, которые часто выступают как начальными индексами списка, так и частью текста.
- Цифра 3 и кириллическая буква З при чтении номеров подпунктов или количественных показателей.
Правильное разграничение алфавитов внутри одной позиции опирается на анализ соседних знаков. Если символ стоит внутри слова, состоящего из кириллических букв, он интерпретируется как кириллица, а в окружении латинских символов или внутри буквенно-цифрового индекса - как соответствующий знак латинского алфавита или цифра.
Структурные виды списков на изображениях
Помимо качества самого текста, на логику извлечения отдельных элементов влияет пространственная верстка перечня. В документах и на скриншотах встречаются как простые линейные структуры, так и сложные составные макеты. В таблице ниже приведены основные структурные типы списков и признаки, по которым определяются границы их элементов.
| Структурный вид перечня | Визуальные и геометрические особенности на изображении | Принцип разделения на отдельные позиции |
|---|---|---|
| Одноуровневый список | Все пункты имеют единую линию выравнивания по левому краю и равнозначные начальные обозначения | Каждая строка с начальным признаком перечисления выделяется как независимый элемент одного порядка |
| Многоуровневый перечень | Наличие вложенных подпунктов со ступенчатым смещением вправо и составной индексацией вида 1.1, 1.2 или сменой типа маркера | Иерархия и границы подпунктов фиксируются по величине левого отступа и структуре составного индекса |
| Маркированный список | Перед каждым элементом стоит повторяющийся графический символ: точка, тире, квадрат, ромб, стрелка или галочка | Появление очередного графического маркера на линии отступа служит сигналом начала нового пункта |
| Нумерованный перечень | Позиции начинаются с последовательных арабских или римских цифр либо буквенных литер со скобкой или точкой | Разбивка опирается на распознавание возрастающей последовательности чисел или букв алфавита в начале строк |
| Многоколоночный список | Элементы распределены в два и более вертикальных столбца на одной странице для экономии места | Пространство делится по вертикальным пустым коридорам между колонками, после чего столбцы читаются последовательно |
Строки с переносами и многострочные пункты
Отдельную задачу при анализе верстки представляют перечни, в которых текст одного пункта не помещается в одну линию и переносится на следующую строку или занимает целый абзац. Если при извлечении данных просто разделять текст по каждому переносу строки, один длинный пункт окажется разорванным на несколько несвязанных частей.
Разграничение однострочных позиций и строк с переносами выполняется за счет сопоставления координат начала строки и наличия маркеров. Когда длинное предложение переходит на вторую линию, в начале этой новой строки отсутствует маркер или порядковый номер, а сам текст начинается либо вровень с текстовым блоком первой строки (висячий отступ), либо с края колонки без дополнительного межпунктового интервала. Если на конце предыдущей строки стоит знак дефиса при словарном переносе, а следующая строка продолжает предложение со строчной буквы, обе линии объединяются в единый смысловой элемент списка. Новая позиция фиксируется только тогда, когда на очередной строке снова появляется маркер, очередной номер или увеличенный вертикальный отступ.
Влияние качества фотографии на точность распознавания элементов
Даже четко оформленный перечень может быть прочитан с ошибками, если исходный снимок имеет оптические или цифровые дефекты. Точность перевода графического списка в текст складывается из двух составляющих: правильного прочтения отдельных букв при OCR и верного определения границ каждого пункта во время сегментации. Визуальные искажения нарушают оба этих процесса, приводя как к опечаткам внутри слов, так и к разрушению самой структуры перечня.
Оптические характеристики снимка и читаемость символов
Для уверенного отделения букв от фона и распознавания мелких знаков препинания изображение должно передавать четкую геометрию каждого печатного или рукописного знака. На этот процесс напрямую влияют базовые параметры съемки и освещения:
- Разрешение изображения и детализация. При недостаточной плотности пикселей контуры букв превращаются в ступенчатые размытые пятна. В таких условиях мелкие элементы, определяющие структуру списка - точки после цифр, дефисы, тире и круглые маркеры - теряют форму или полностью сливаются с фоном. В результате признак начала нового пункта пропадает, а схожие по начертанию символы (например, цифра 1, латинская буква l и вертикальная черта, либо буквы «ш» и «щ») путаются между собой.
- Контрастность текста относительно фона. Распознавание опирается на явную разницу яркости между темными линиями шрифта и светлой подложкой. Выцветшие чернила на кассовом чеке, серый карандаш на желтоватой бумаге или текст поверх цветной иллюстрации снижают эту разницу. При низком контрасте тонкие соединительные линии внутри букв исчезают, из-за чего один символ может быть воспринят как два отдельных знака или вовсе пропущен.
- Резкость символов и фокусировка. Смазывание кадра из-за движения камеры при съемке с рук или неправильной фокусировки приводит к размытию границ глифов. Ореолы вокруг букв уменьшают просветы между соседними знаками. Когда расстояние между буквами или словами заполняется полутонами, отдельные слова сливаются в непрерывную символьную строку, а внутренние замкнутые пространства в буквах вроде «о», «е» или «а» затягиваются, делая их нечитаемыми.
- Визуальные шумы, тени и блики. Съемка при слабом освещении создает цифровой зернистый шум, а фактурная бумага, пятна, следы сгибов листа или посторонние вкрапления добавляют мелкие темные точки. Эти артефакты нередко принимаются за точки, запятые или маркеры начала строки, что порождает ложные пункты списка. Резкие тени от рук или смартфона при фотографировании создают перепад яркости: при переводе снимка в черно-белый вид затененная область документа может превратиться в сплошное черное пятно, полностью скрывающее текст. Схожий эффект дают световые блики на глянцевой бумаге или заламинированных страницах, которые буквально «выжигают» фрагменты слов и номеров позиций.
Геометрические искажения и нарушение границ пунктов
Если качество пикселей определяет точность чтения отдельных слов, то геометрия снимка и плотность верстки отвечают за правильное разделение текста на самостоятельные элементы списка. Определение начала и конца каждой позиции строится на вычислении горизонтальных строк и вертикальных уровней отступа. Нарушение пропорций листа искажает эту координатную сетку.
Съемка документа под углом вызывает перспективные искажения, при которых прямоугольный лист приобретает форму трапеции. Вместе с ним деформируется и текстовый блок: строки начинают сходиться веером, размер шрифта по мере удаления от объектива уменьшается, а вертикальная линия, вдоль которой выстроены маркеры или номера пунктов, наклоняется. Из-за смещения левого края пункты одного уровня перестают находиться на одной вертикальной оси. Это приводит к тому, что обычный одноуровневый перечень может интерпретироваться как многоуровневый список с вложенными подпунктами либо терять связь между маркером и основным текстом.
Похожая проблема возникает при наклоне строк, когда камера повернута относительно горизонтали документа или текст изначально написан от руки по диагонали. Вместо того чтобы идти строго параллельно верхнему краю кадра, строка постепенно поднимается или опускается. При анализе расположения текста конец приподнятой нижней строки может оказаться на одной горизонтальной высоте с началом предыдущей строки. В результате две соседние позиции перечня ошибочно сцепляются в одно длинное предложение или читаются с нарушением очередности слов.
Радиальные искажения и изгиб страницы часто встречаются при фотографировании разворотов толстых книг, блокнотов на пружине или бумажных листов, лежащих на неровной поверхности. Строки в таких случаях приобретают дугообразную форму, прогибаясь у корешка или краев. Когда линия текста изгибается, слова на одной стороне страницы оказываются значительно ниже слов в середине той же строки. Это провоцирует разрыв единого пункта на части или перескакивание чтения со строки на строку в месте наибольшего изгиба.
Дополнительные трудности создает сложная и плотная верстка самого оригинала. Если в исходном документе установлен минимальный межстрочный интервал, выносные элементы букв верхней строки (например, нижние хвостики букв «у», «р», «д», «ц») почти соприкасаются с заглавными буквами или высокими символами нижней линии. Отсутствие чистого горизонтального просвета между строками не дает четко провести границу между соседними пунктами, вызывая их вертикальное слияние. А в перечнях со сложным оформлением - например, когда от названия позиции к цене или количеству тянется длинное отточие, присутствуют декоративные рамки, фоновые плашки или тесное соседство с боковыми врезками - вспомогательные графические элементы могут восприниматься как продолжение текста, объединяя разрозненные блоки или колонки в одну общую строку.
Сводная таблица дефектов изображения и их последствий
В таблице ниже сопоставлены основные недостатки исходных фотографий с теми искажениями, которые они вызывают при распознавании текста и выделении структуры списка.
| Дефект исходного изображения | Влияние на чтение символов при OCR | Влияние на сегментацию пунктов списка |
|---|---|---|
| Низкое разрешение и размытие фокуса | Искажение контуров букв, подмена похожих по форме знаков, слияние соседних символов внутри слова | Потеря мелких точек и дефисов, из-за чего пропадает признак начала нового элемента |
| Слабая контрастность и засвеченные блики | Пропуск бледных букв и цифр, разрыв тонких штрихов, выпадение целых фрагментов слов в зоне засветки | Исчезновение номеров или маркеров на краях листа, приводящее к присоединению пункта к предыдущему тексту |
| Тени, пятна и цифровой шум | Появление лишних знаков препинания и случайных символов на месте темных точек и сгибов бумаги | Формирование ложных строк из-за восприятия пятен как маркеров, потеря текста в плотных теневых зонах |
| Наклон кадра и изгиб листа | Снижение точности распознавания деформированных букв на краях и у корешка страницы | Пересечение горизонтальных уровней соседних строк, слияние разных позиций или разрыв одной строки на части |
| Перспективное искажение при съемке под углом | Ухудшение читаемости мелкого текста в дальней от камеры части документа | Нарушение вертикального выравнивания маркеров и отступов, ошибки при определении иерархии и границ списка |
| Плотная верстка и малый межстрочный интервал | Слипание верхних и нижних выносных элементов букв из разных рядов, мешающее узнать символы | Отсутствие четкого разделительного коридора между линиями, вертикальное объединение соседних пунктов |
Структурирование извлеченных пунктов и работа с результатом
Результатом обработки изображения с перечнем становится упорядоченный набор текстовых строк, доступный для прямого редактирования, копирования и переноса в рабочие среды. В отличие от простого распознавания сплошного текста, где графические данные переводятся в единый массив символов, при извлечении списка каждый найденный элемент обособляется в самостоятельную текстовую единицу. Это избавляет от необходимости вручную разбивать слитный абзац на отдельные позиции после завершения чтения символов.
Формирование строковых списков и разделение элементов
Перевод неструктурированных графических данных в цифровой перечень строится на выборе способа разграничения отдельных позиций. Базовым вариантом представления результата выступает построчное разделение, при котором каждый распознанный пункт размещается на новой строке за счет управляющего символа перевода каретки. Если исходный элемент на изображении занимал несколько визуальных рядов из-за переноса длинной фразы, при правильном определении границ он объединяется в одну непрерывную строку без внутренних разрывов.
Другой подход к организации выходных данных предполагает объединение элементов через заданные текстовые разделители. Вместо переноса строки между соседними пунктами вставляется выбранный знак: запятая, точка с запятой, вертикальная черта или символ табуляции. Такой формат превращает вертикальный перечень в линейную последовательность или готовую строку значений, пригодную для прямой вставки в качестве параметров запроса или разметки.
Выбор способа организации извлеченного текста зависит от требований к итоговому формату данных:
- Построчный вывод с разделением абзацами подходит для чтения, редактирования пунктов вручную и размещения перечней в текстовых блоках.
- Разделение через запятую или точку с запятой применяется при формировании компактных перечислений внутри одного предложения или подготовке строковых массивов.
- Использование символов табуляции или фиксированных разделителей упрощает распределение значений по отдельным ячейкам и полям при переносе данных.
- Сохранение исходных номеров или текстовых префиксов перед каждым пунктом требуется тогда, когда важна явная маркировка позиций внутри плоского текста.
- Удаление всех служебных знаков начала строки оставляет только чистые значения элементов, готовые к повторному форматированию.
Сохранение последовательности и логического порядка
При формировании итогового текстового перечня критическое значение имеет соблюдение исходной очередности позиций. В простых одноколоночных списках элементы выстраиваются строго сверху вниз по мере увеличения вертикальной координаты строки. Если перечень на изображении был разбит на несколько столбцов или содержал вложенные подпункты, линейный текстовый результат должен воспроизводить естественный порядок чтения: сначала последовательно извлекаются все пункты левой колонки, затем происходит переход к следующей, а дочерние позиции располагаются непосредственно под своим родительским элементом.
Нарушение последовательности при переводе графики в текст приводит к перемешиванию позиций из разных смысловых блоков или к ситуации, когда строки из соседних столбцов чередуются через одну. Контроль порядка следования особенно важен для пронумерованных инструкций, пошаговых алгоритмов и перечней, где позиция элемента жестко привязана к его приоритету или индексу.
Очистка пунктов от лишних символов и базовая постобработка
Сырой текст, полученный непосредственно после оптического распознавания, часто содержит визуальный мусор, перенесенный с исходного изображения. Графические маркеры списка, такие как закрашенные кружки, квадраты, галочки или стрелки, при попытке их буквального прочтения превращаются в случайные буквы, знаки препинания или спецсимволы в самом начале строки. Задача очистки состоит в том, чтобы отсечь эти ложные начальные знаки и оставить только содержательную часть каждого пункта.
Помимо удаления артефактов на месте маркеров, базовая постобработка включает нормализацию пробелов, устранение висячих дефисов, оставшихся от построчных переносов слов на узком листе, и исправление типичных ошибок чтения схожих по начертанию знаков. В таблице приведены основные виды текстовых искажений в распознанных пунктах и способы их приведения к рабочему виду:
| Тип дефекта в распознанной строке | Причина возникновения при чтении изображения | Принцип очистки и постобработки текста |
|---|---|---|
| Случайные символы в начале пункта (буквы «о», «в», звездочки, тире с точками) | Попытка интерпретировать графический буллит, иконку или рукописную галочку как печатный знак | Удаление изолированных начальных символов и лишних пробелов перед первым осмысленным словом позиции |
| Разрыв слова дефисом и пробелом в середине строки | Механическое склеивание двух строк одного длинного пункта с сохранением знака переноса с края листа | Удаление дефиса переноса и соединительного пробела для восстановления целостности разделенного слова |
| Подмена цифр буквами и наоборот в номерах и кодах (0 и О, 1 и l или I, 5 и S) | Визуальное сходство глифов в шрифтах без засечек или при размытии контуров на фотографии | Замена ошибочных символов с учетом окружения: приведение знаков к цифрам внутри числовых индексов и к буквам внутри слов |
| Двойные пробелы и мусорные точки внутри текста | Неравномерные отступы между словами в оригинале, мелкие пятна на бумаге или от줄ки (точечные линии) | Сжатие последовательностей пробельных символов до одного пробела и фильтрация одиночных знаков препинания |
| Смешение букв кириллицы и латиницы в одном слове (С и C, А и A, В и B) | Переключение языковой модели на омоглифах при чтении двуязычных перечней или незнакомых аббревиатур | Унификация алфавита внутри отдельного слова по преобладающему языку распознанного фрагмента |
Финальная проверка полученного списка перед использованием сводится к сверке количества извлеченных строк с числом позиций на исходном изображении и быстрому просмотру граничных участков. Если два коротких пункта слились в одну строку или длинная позиция распалась на две независимые части, корректировка выполняется простым добавлением или удалением переноса строки уже внутри готового текстового поля.
Практические сценарии извлечения списков из фотографий и скриншотов
Перевод графических перечней в разделенный по элементам цифровой текст заменяет ручной набор данных там, где информация зафиксирована только на бумажном носителе, информационном стенде или закрытом для копирования экране. Полученный массив строк сразу пригоден для вставки в рабочие среды, сортировки, фильтрации или поиска по ключевым словам.
Оцифровка бумажных заметок, чек-листов и рабочих перечней
В повседневной и проектной работе списки часто создаются офлайн: на страницах блокнотов, стикерах, флипчартах, маркерных досках или распечатанных бланках осмотра. Фотографирование таких носителей с последующим выделением отдельных пунктов применяется для быстрого переноса задач в цифровые планировщики, трекеры задач и корпоративные мессенджеры.
Типовые задачи при обработке фотографий рабочих записей и проверочных листов охватывают следующие процессы:
- Формирование реестра поручений по итогам совещаний путем съемки записей с офисной доски или листа флипчарта, где каждый тезис после распознавания становится отдельной карточкой или строкой в плане работ.
- Перенос бумажных чек-листов технического обслуживания, обходных листов и протоколов поверки в электронные журналы для фиксации выполненных операций и архивного хранения.
- Конвертация рукописных или печатных списков покупок, заготовок, материалов для ремонта и комплектовочных перечней в заметки на смартфоне с возможностью отмечать закрытые позиции.
- Сбор оглавлений книг, списков рекомендованной литературы, библиографических указателей и учебных программ с фотографий печатных изданий для составления конспектов и рефератов.
При работе с заполненными бумажными чек-листами важно учитывать рукописные пометки на полях - галочки, крестики и вычеркивания. В процессе чтения текста знаки отметок напротив строк могут интерпретироваться как случайные буквы или спецсимволы в начале пункта, поэтому при подготовке итогового перечня такие префиксы удаляются на этапе очистки либо заменяются на стандартные статусы выполнения уже в целевом документе.
Перевод номенклатуры, прайс-листов, спецификаций и инвентарных ведомостей в текст
В складском учете, снабжении, строительстве и торговле значительная часть первичной документации поступает в виде бумажных накладных, распечатанных каталогов или неиндексированных сканов без текстового слоя. Извлечение позиций из подобных изображений используется для сверки поставок, подготовки смет и актуализации справочников без ручного перепечатывания сотен артикулов.
В зависимости от вида коммерческого или технического документа полученный текстовый перечень решает конкретные учетные задачи, представленные в таблице ниже:
| Тип исходного документа на фото или скане | Состав извлекаемых элементов списка | Практическое применение текстового результата |
|---|---|---|
| Товарная номенклатура и складские реестры | Артикулы, заводские коды, полные наименования изделий и единицы измерения | Импорт позиций в учетные системы, проверка наличия дубликатов и сопоставление с базой поставщика |
| Прайс-листы и коммерческие предложения | Названия товаров или услуг в связке с тарифными кодами и ценовыми значениями | Загрузка в табличные редакторы для расчета наценок, сравнения цен конкурентов и формирования смет |
| Технические спецификации и ведомости материалов | Перечни узлов, деталей, марок сырья, кабельных журналов и комплектующих по проекту | Формирование заявок на закупку, комплектация производственных заказов и входной контроль на объекте |
| Инвентарные и сличительные ведомости | Инвентарные номера, наименования основных средств и учетных единиц | Проведение ревизий, быстрый поиск расхождений через фильтрацию строк и обновление описей имущества |
Номенклатурные позиции и спецификации обычно содержат сложные буквенно-цифровые индексы, серийные номера и размерности через косую черту или дефис. После перевода фотографии ведомости в построчный список такие данные удобно разделять по столбцам в табличном редакторе, используя пробел, табуляцию или знак пунктуации в качестве разделителя между кодом детали, ее названием и количеством.
Извлечение перечней из скриншотов программ, презентаций и таблиц
Нередко нужный список отображается на экране устройства, но прямое выделение и копирование текста заблокировано или технически невозможно. Такая ситуация возникает при просмотре видеозаписей вебинаров, демонстрации экрана во время видеозвонков, работе с закрытыми веб-интерфейсами, устаревшим прикладным ПО, системными окнами или защищенными документами.
Создание скриншота экрана с последующим распознаванием перечня применяется в следующих рабочих ситуациях:
- Захват слайдов из онлайн-презентаций, видеолекций и трансляций конференций для быстрого сохранения тезисов, планов проекта, дорожных карт и списков характеристик продукта.
- Выгрузка перечней файлов, папок, установленных компонентов, переменных окружения или выпадающих меню из диалоговых окон операционной системы и специализированных программ, где не предусмотрен экспорт данных в текст.
- Копирование строк из заблокированных для редактирования таблиц, графических дашбордов, отчетов в формате изображений и карточек товаров в интернет-каталогах.
- Сбор списков участников, контактов или логов событий из окон корпоративных платформ и терминалов для формирования отчетности.
Дальнейшая интеграция данных в документы, таблицы и базы данных
Способ использования извлеченного перечня зависит от целевой среды, в которую передаются распознанные строки. Для текстовых документов и систем управления контентом готовый построчный вывод вставляется напрямую с применением стандартного форматирования абзацев или встроенных списков редактора.
При переносе перечня в табличные редакторы каждая строка, разделенная символом перевода каретки, при вставке занимает отдельную ячейку вертикального столбца, что сразу формирует готовую структуру для расчетов по формулам, построения сводных таблиц или фильтрации значений. Если же извлеченный список предназначается для реляционных баз данных, систем управления запасами или конфигурационных скриптов, элементы объединяются через запятую, точку с запятой или другой заданный разделитель - это дает возможность сформировать корректный CSV-массив или условия для поисковых запросов к базе.