Получить текст с изображения в редактируемом виде позволяет специализированный браузерный инструмент, применяющий алгоритмы OCR для анализа графических файлов. После загрузки картинки система сканирует пиксельную сетку, определяет контрастные границы символов и переводит визуальную информацию в цифровой формат. Преобразование выполняется напрямую через веб-интерфейс без установки дополнительных программ.
Обработка происходит за несколько секунд. Пользователю не требуется настраивать серверное окружение.
Входными данными выступают файлы форматов JPG и PNG. Встроенный механизм распознавания сегментирует изображение на отдельные блоки, строки и символы, отсекая фоновые шумы. Далее выделенные контуры сопоставляются с эталонными паттернами шрифтов. Выходным результатом становится сплошной машиночитаемый массив данных. Сгенерированную информацию можно моментально скопировать в буфер обмена для переноса в профильные текстовые редакторы, таблицы или базы данных.
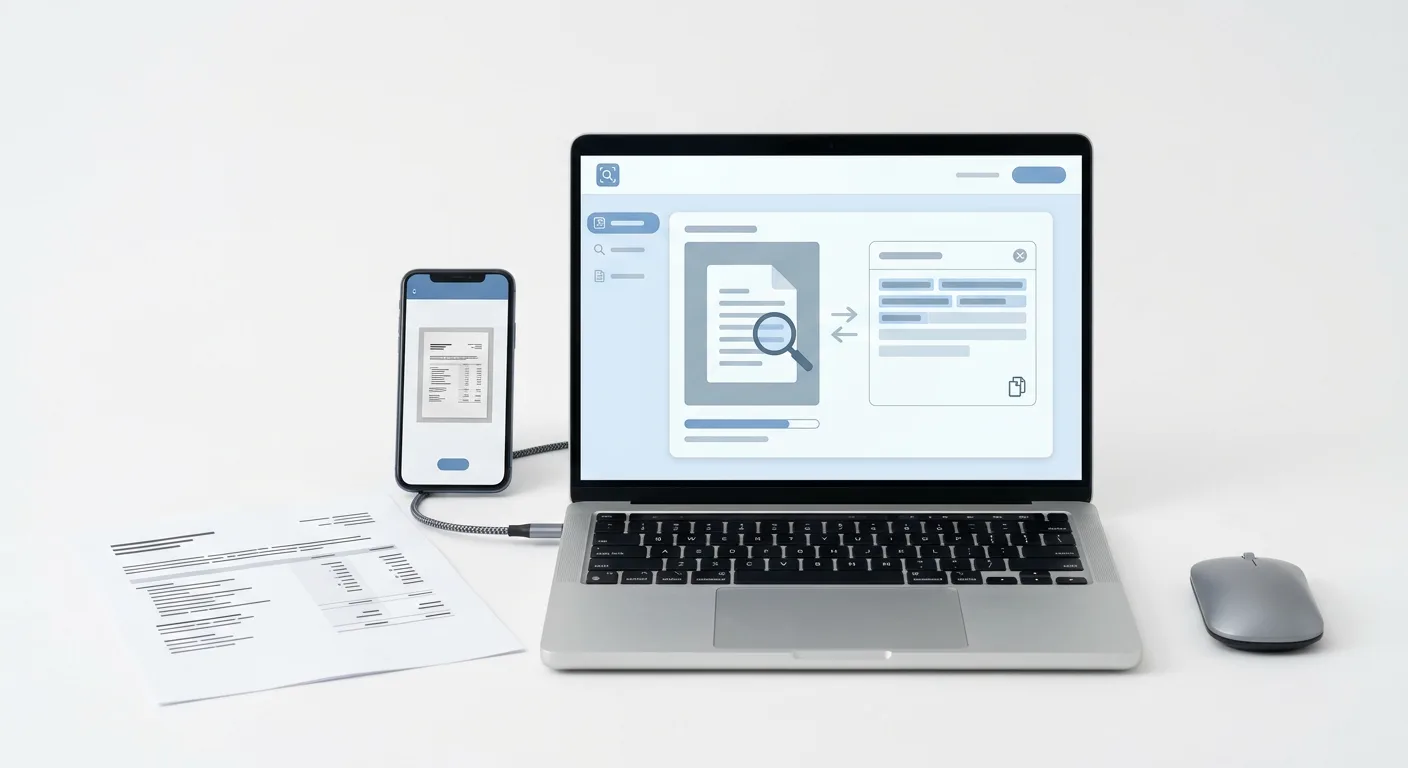
Механика оптического распознавания символов (OCR) в браузере
Технология Optical Character Recognition (OCR) отвечает за программный перевод растрового изображения в массив цифровых текстовых символов. Графический файл для вычислительной системы представляет собой матрицу пикселей, где каждый элемент имеет определенное цветовое значение и координаты. Задача технологии заключается в математическом анализе этой матрицы, поиске контрастных переходов и идентификации визуальных форм, которые соответствуют известным буквенным, числовым или пунктуационным знакам. В результате такого преобразования статичный графический слой трансформируется в редактируемую кодировку.
Процесс извлечения текстовых данных из изображения при веб-обработке разделен на несколько последовательных этапов:
- Анализ структуры картинки. Алгоритм первично сканирует загруженный файл для определения общего макета. На этом этапе локализуются области с предполагаемым текстом и отсеивается нерелевантное графическое содержимое или пустое пространство.
- Сегментация. Найденные текстовые блоки последовательно разделяются на более мелкие элементы. Сначала определяются границы строк, затем строки делятся на слова на основе пробелов. Финальным шагом сегментации выступает изоляция каждого отдельного символа.
- Сопоставление шаблонов. Выделенная пиксельная область, содержащая один символ, накладывается на базу эталонных матриц известных шрифтов для поиска наиболее точного совпадения.
- Извлечение признаков. Параллельно с сопоставлением шаблонов алгоритм анализирует топологию символа. Оцениваются геометрические характеристики: наличие прямых линий, углов, замкнутых петель и точек пересечения. Это повышает точность распознавания нетипичных или деформированных начертаний.
После завершения аналитических циклов происходит формирование финального машиночитаемого текста. Система присваивает каждому распознанному визуальному знаку соответствующий цифровой код. Затем изолированные символы объединяются обратно в слова и строки, строго соблюдая исходную последовательность, зафиксированную на этапе сегментации. Таким образом из набора независимых пикселей генерируется связный и структурированный текстовый формат.
Требования к качеству изображений для точного извлечения текста
Успешное завершение всех аналитических циклов и получение связного машиночитаемого текста напрямую зависят от состояния исходных визуальных данных. Чем четче пиксельная структура загружаемого файла, тем выше вероятность безошибочного сопоставления с эталонными матрицами и меньше риск потери информации на этапе сегментации.
Для обработки применяются стандартные растровые файлы в форматах JPG, JPEG, PNG и WebP. Указанные форматы обеспечивают необходимую детализацию графических элементов и поддерживают достаточную плотность данных для корректного сканирования макета.
Факторы, влияющие на качество идентификации символов
На способность системы изолировать и распознать каждый отдельный визуальный знак критически влияют физические характеристики картинки:
- Разрешение и DPI. Высокая плотность пикселей позволяет детально зафиксировать контуры букв и цифр. При низком разрешении соседние элементы слипаются, а тонкие линии разрываются, что делает невозможным извлечение геометрических признаков символа.
- Контрастность. Резкое цветовое различие между текстом и фоном является главным условием для правильного определения границ строк. Оптимальный вариант - темный шрифт на светлом однотонном фоне. Недостаточный контраст приводит к игнорированию слов или пропуску целых текстовых блоков.
- Графические дефекты. Цифровой шум при съемке в условиях недостаточной освещенности, агрессивные артефакты сжатия и оптическое размытие необратимо искажают топологию символа, усложняя поиск совпадений в базе шрифтов.
- Перспективное искажение. Фотографии, сделанные под углом, искривляют направляющие линии текста. Это нарушает горизонтальную структуру макета, усложняя деление на строки и сохранение исходной последовательности знаков.
Рекомендации по подготовке входных данных
Предварительная обработка снимков или скриншотов перед загрузкой минимизирует количество ошибок и снижает потребность в ручной корректировке финального текста. Для обеспечения высокой точности распознавания целесообразно выполнить базовую подготовку файла:
- Плотный кроп (кадрирование). Обрезка лишнего фона, широких полей, теней и нерелевантной графики оставляет в кадре исключительно целевой текст. Это исключает попытки сканирования посторонних объектов и фокусирует процесс обработки только на полезной площади.
- Исключение световых бликов. Локальные засветы от вспышки или ламп на глянцевой бумаге и мониторах уничтожают пиксельные данные в пораженной области. Текст в местах бликов становится полностью нечитаемым для оптики. Съемку следует осуществлять при равномерном рассеянном освещении для сохранения целостности всех знаков.
Процесс преобразования: от загрузки картинки до редактируемого текста
После того как исходный графический файл подготовлен с учетом базовых рекомендаций по кадрированию и освещенности, начинается этап непосредственного извлечения данных. Процедура конвертации визуальной информации в текстовый формат в браузере включает несколько последовательных шагов, не требующих участия стороннего программного обеспечения.
Основные этапы обработки файла
Процесс извлечения символов представляет собой линейный алгоритм, который выполняется в рабочей среде браузерного приложения (Web App). Выполнение задачи проходит по следующему сценарию:
- Загрузка графического файла. Изображение передается в приложение. На этом этапе пиксельные данные снимка или скриншота загружаются в память браузера для последующего анализа.
- Запуск алгоритма обнаружения текста. Система инициализирует процесс сканирования структуры картинки. Анализируются контрастные переходы, выявляются направляющие линии, а найденные графические контуры сопоставляются с известными шаблонами букв, цифр и знаков.
- Генерация результата. Идентифицированные символы выстраиваются в логическую последовательность. Разрозненные знаки формируют слова и строки, генерируя итоговый текстовый массив.
Формат выходных данных
Результатом работы алгоритма является простой редактируемый текст. Вся извлеченная информация предоставляется в виде сплошного строкового формата. При такой конвертации графики исходное визуальное оформление, цвет, размер и специфические стили шрифтов не сохраняются.
Сгенерированный текст доступен для прямого взаимодействия. Его можно редактировать непосредственно в окне вывода или полностью скопировать в буфер обмена операционной системы. Скопированные данные готовы к немедленной вставке в любые сторонние текстовые редакторы, системы электронного документооборота, мессенджеры или формы на других веб-страницах.
Необходимость вычитки и постобработки
Машинное распознавание символов базируется на вероятностном сопоставлении контуров, поэтому полученный результат требует самостоятельной вычитки. Даже при идеальном качестве входного файла существует риск возникновения ошибок сопоставления символов, обусловленных оптическим сходством различных знаков.
При ручной постобработке извлеченного текста следует обращать внимание на следующие типичные неточности:
- Подмена визуально похожих символов. Алгоритм может перепутать заглавную букву О и цифру ноль, либо строчную букву l и цифру 1.
- Ошибки сегментации слов. Недостаточный трекинг (межбуквенный интервал) в исходном шрифте иногда приводит к тому, что система воспринимает два близко стоящих знака как один, или наоборот, разделяет один сложный символ на два отдельных.
- Потеря пунктуации. Мелкие знаки препинания, такие как точки или запятые, могут быть пропущены алгоритмом, если они сливаются с фоном или имеют слабую контрастность на оригинальном изображении.
Сверка финального текста с исходным изображением позволяет оперативно выявить и исправить подобные дефекты оптического распознавания. Этот заключительный этап контроля обеспечивает корректность и достоверность извлеченной информации перед ее дальнейшим использованием.
Практические сценарии использования извлечения текста онлайн
Полученный после оптического распознавания массив редактируемых символов применяется для решения широкого спектра задач, связанных с переносом и обработкой информации. Преобразование статичных графических данных в текст устраняет необходимость ручного перепечатывания и ускоряет работу с документами.
Оцифровка печатных материалов
Перевод физических носителей в цифровой редактируемый вид является классической задачей для технологии распознавания. В качестве исходных файлов выступают отсканированные копии или фотографии бумажных оригиналов. Такой подход востребован в следующих ситуациях:
- Обработка юридической и деловой документации, включая договоры, акты и соглашения, для последующего редактирования или внесения в системы электронного документооборота.
- Извлечение текста из печатных пользовательских инструкций, технических паспортов и мануалов для формирования цифровых баз знаний.
- Оцифровка кассовых чеков, квитанций и товарных накладных для ведения финансовой или складской отчетности.
Извлечение информации из цифровой среды
Текстовая информация часто отображается на экране устройства, но остается недоступной для выделения и копирования средствами операционной системы или браузера. Источником графических входных данных в этом случае служит скриншот. Данный метод применяется для получения текста из следующих источников:
- Элементы интерфейса программного обеспечения, системных окон или мобильных приложений.
- Отдельные кадры из обучающих видеороликов, вебинаров или трансляций, содержащие текстовые слайды, формулы в виде текста или субтитры.
- Веб-страницы, на которых скриптами заблокирована функция выделения содержимого и вызова контекстного меню.
Работа с графическим контентом и презентациями
Текст, жестко интегрированный в визуальные макеты, требует извлечения для дальнейшей лингвистической или редакторской работы. Рекламные материалы, инфографика и слайды презентаций, как правило, распространяются в виде растровых изображений. Оптическое распознавание позволяет отделить буквенно-цифровое содержимое от графического оформления.
Извлеченные таким образом данные переносятся в текстовые редакторы для создания файлов в форматах TXT, DOCX или документов с разметкой Markdown. В дальнейшем очищенный от графики текст используется для рерайтинга, обновления маркетинговых материалов или обработки в системах машинного перевода для локализации контента.
Ограничения браузерного распознавания изображений
Базовые алгоритмы OCR, работающие в веб-среде, предназначены для быстрого извлечения четкого типографского текста. Несмотря на высокую эффективность при обработке стандартизированных цифровых документов, процесс имеет ряд технических пределов. Результат преобразования пиксельного массива в машиночитаемые символы ограничен визуальными характеристиками исходника и архитектурой алгоритмов сопоставления.
Сложная письменность и нестандартные графические элементы
Существует значительная разница между распознаванием стандартного печатного шрифта и сложной письменности. Математические модели, применяемые для идентификации текста, оптимизированы под строгую геометрию, прямые линии и равномерные интервалы классической типографики. Отклонения от этих стандартов вызывают ошибки сегментации и сопоставления.
Рукописные элементы, каллиграфия и стилизованные декоративные шрифты обладают высокой вариативностью начертания, что затрудняет их идентификацию. Дополнительные проблемы создают печати, штампы, подписи и полупрозрачные водяные знаки. Накладываясь на основное содержимое, они искажают контуры букв, сливаются с текстом и делают невозможным корректное извлечение признаков символов.
Математические уравнения и специальные символы
Обработка научной, технической или инженерной графики сопровождается трудностями при идентификации неалфавитных знаков. Базовое распознавание ориентировано на стандартные кодировки и популярные языковые наборы. При работе со сложными структурами возникают следующие проблемы:
- Многоуровневые математические формулы, дроби и матрицы не сохраняют свою пространственную иерархию при переводе в плоский текст.
- Специфические символы, интегралы, индексы и греческий алфавит часто интерпретируются как пунктуация или случайный набор базовых букв.
- Блок-схемы и алгоритмы, содержащие текст внутри геометрических фигур, могут быть распознаны с нарушением логической последовательности.
Преобразование сложной верстки
Процесс извлечения направлен исключительно на получение символьных данных, что неизбежно приводит к потере исходного визуального оформления. При конвертации графики в сплошной редактируемый текстовый массив алгоритмы игнорируют дизайнерскую структуру документа.
Многоколоночные макеты, характерные для журнальной верстки или научных статей, часто сливаются в единый поток, нарушая порядок чтения. Оригинальное форматирование полностью утрачивается: гарнитуры шрифтов, размер кегля, выделение цветом, абзацные отступы и выравнивание не переносятся в итоговый результат. Таблицы, представленные в виде растровой сетки, теряют свои границы, а содержимое ячеек преобразуется в линейную последовательность слов, требующую последующего ручного структурирования.
Зависимость от определения языка
Успешное извлечение информации напрямую зависит от правильного автоопределения языка исходника. Алгоритмы сопоставления шаблонов используют специфические для каждого языка словари и правила вероятности появления символов. Если язык определен неверно, система будет пытаться подобрать визуально похожие буквы из неправильного алфавита, что приведет к генерации бессмысленного набора знаков.
Особую сложность представляют смешанные тексты, содержащие одновременно кириллицу, латиницу и иероглифы. Переключение между языковыми моделями на уровне отдельных слов или предложений без четкого визуального разделения снижает общую точность распознавания графического файла.