Точное расположение текста в пределах изображения определяется онлайн-инструментом при обработке загруженной картинки для автоматического поиска и выделения всех участков, содержащих символы, слова или строки. В качестве входных данных используется исходный графический файл. Алгоритм сканирует изображение и изолирует значимый контент от сложного фона, рамок, табличных линий и случайного визуального шума. Результатом операции становится разметка найденных текстовых зон с точными границами каждого блока.
Локализация текстовых областей - это самостоятельный этап компьютерного зрения, который предшествует непосредственному чтению символов.
В системах OCR процесс разделен на две независимые стадии: сначала алгоритм находит пространственные координаты текстовых блоков на матрице картинки, и только затем модуль распознавания переводит графические начертания внутри найденных рамок в редактируемые печатные знаки. Без предварительной детекции координат механизм распознавания пытается интерпретировать фоновые текстуры, логотипы или артефакты сжатия как буквы, что приводит к появлению мусорных символов в итоговом выводе. Четкое ограничение зон поиска снижает количество ошибок при чтении документов со сложной версткой, фотографий вывесок, кассовых чеков и снимков экрана.
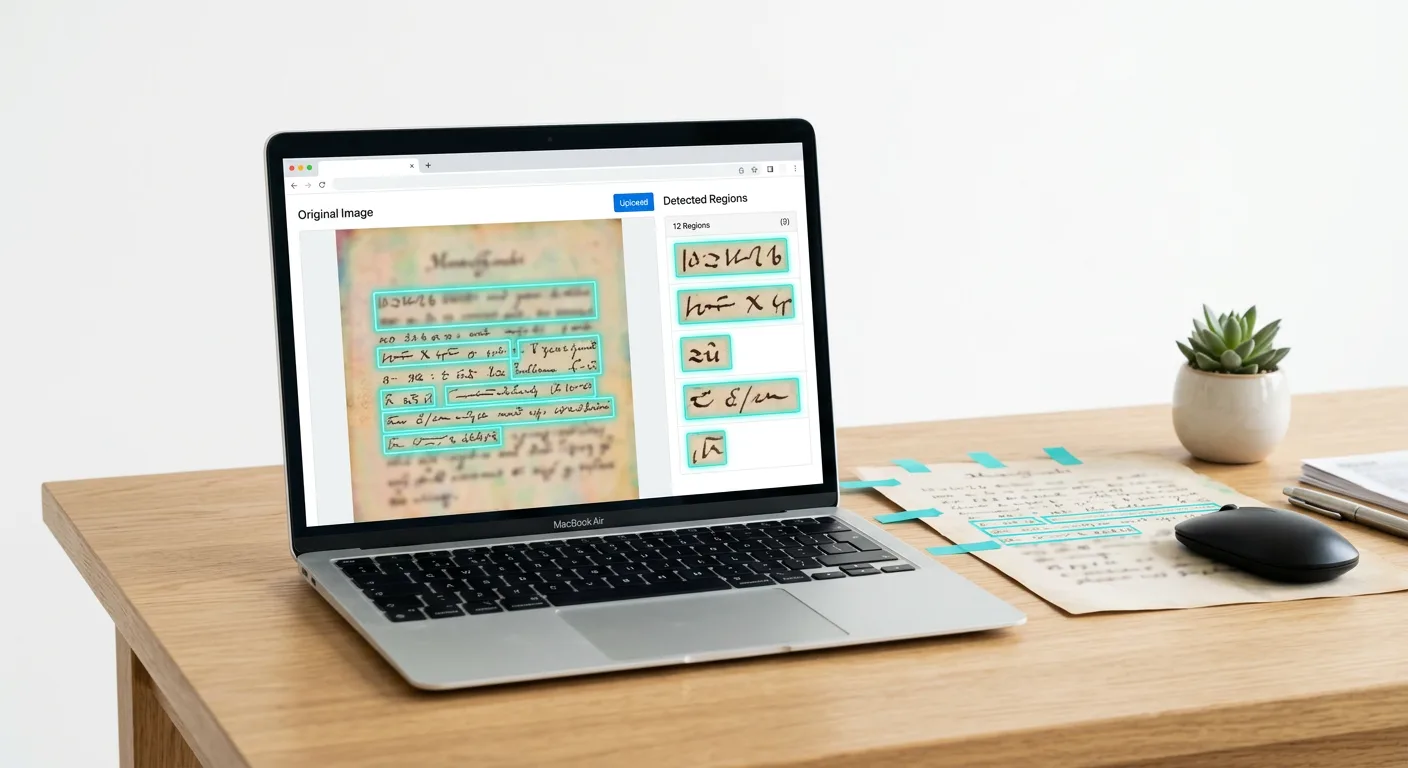
Принципы детекции и локализации текстовых областей
Процесс поиска текста сводится к вычислению точных пространственных координат текстовых блоков на двумерной матрице исходного изображения. В качестве координатной сетки выступает массив пикселей с началом отсчета в верхнем левом углу, где положение каждого найденного фрагмента фиксируется по горизонтальной оси X и вертикальной оси Y. Точность геометрического описания найденной зоны напрямую влияет на то, попадут ли в область дальнейшей обработки все части букв без захвата соседних строк или графических разделителей.
Геометрические способы разметки текстовых зон
Выбор математической модели для описания контура зависит от пространственного расположения строки, угла ее наклона и кривизны поверхности на фотографии. Для фиксации найденных участков применяются различные геометрические примитивы, отличающиеся количеством опорных точек и гибкостью контура.
| Тип геометрической разметки | Структура координат | Оптимальное применение | Ключевое ограничение |
|---|---|---|---|
| Выровненный bounding box | Две точки (X_min, Y_min, X_max, Y_max) или точка с шириной и высотой | Строго горизонтальные строки в стандартных документах и таблицах | Захватывает лишний фон при малейшем наклоне строки |
| Повернутый Text detection box | Четыре вершины прямоугольника или центр, размеры и угол поворота | Наклонные надписи, развернутые под углом листы, диагональные штампы | Не повторяет изгиб строки, если текст расположен по дуге |
| Произвольный полигон | Массив из N последовательных пар координат (X_n, Y_n) по периметру | Изогнутый текст, деформированные упаковки, сложная верстка | Требует больше вычислительных ресурсов для построения контура |
Стандартные Text detection boxes эффективны при оцифровке ровных страниц, но на фотографиях реальных объектов прямоугольная рамка вокруг наклонной или волнообразной надписи неизбежно включает в себя куски фона и части соседних слов. Использование многоугольников решает эту проблему за счет плотного облегания текстового массива по фактическому контуру букв.
Топология текста и построение осевых линий
При локализации строк со сложной геометрией простого поиска внешних углов недостаточно, поэтому задача решается через анализ внутренней топологии объекта. В основе такого подхода лежит регрессия границы, когда математическая модель предсказывает смещение от внутренних точек текстовой области до ее внешнего контура Boundary.
Для точного описания формы изгиба вычисляется медиальная ось, представляющая собой геометрическое место точек, равноудаленных от верхнего и нижнего краев строки. На базе этого каркаса формируется TCL - сжатая осевая линия, проходящая строго через центр тяжести символов. Опора на TCL и медиальную ось помогает надежно разделить близко расположенные строки: даже если внешние границы соседних абзацев почти соприкасаются по вертикали, их центральные линии остаются четко изолированными друг от друга. Полная форма текстового блока затем восстанавливается путем расширения центральной линии к краям на расчетный радиус высоты букв.
Методы сегментации при выделении областей
На уровне попиксельного анализа изображения детекция опирается на два подхода к сегментации, каждый из которых решает свою часть задачи по изоляции контента:
- Semantic Segmentation. Каждый пиксель матрицы классифицируется по бинарному принципу принадлежности к классу «текст» или классу «фон». Этот метод безошибочно находит все присутствующие на картинке символы, но при плотной верстке сливает соседние слова и строки в единое неразрывное пятно.
- Instance segmentation. Метод разделяет отдельные экземпляры объектов внутри одного класса. На этапе сегментации экземпляров сплошная текстовая маска дробится на самостоятельные изолированные блоки - конкретные слова, словосочетания или строки, получающие индивидуальные контуры разметки.
Анализ макета и порядок чтения
Локализация не ограничивается простым нахождением координат разрозненных блоков. Для корректной передачи данных на этап чтения требуется структурный анализ макета документа и выстраивание логического порядка чтения.
Сложность возникает при обработке нестандартных направлений письма и фигурной верстки. Изогнутый текст на логотипах, круглых печатях или уличных баннерах требует предварительного отслеживания траектории полигона, чтобы символы внутри зоны считывались последовательно вдоль линии изгиба, а не слева направо по прямой. Отдельную задачу представляет вертикальный текст, встречающийся в табличных заголовках, на корешках книг или в традиционной азиатской письменности. В таких случаях отношение высоты блока к его ширине значительно превышает единицу, что меняет вектор обхода символов на направление сверху вниз.
При многоколоночной верстке, характерной для журналов, газет, кассовых чеков и финансовых бланков, найденные полигоны группируются в логические абзацы и колонки. Выстраивание правильного порядка чтения базируется на анализе взаимного расположения координат: сначала сортируются блоки внутри первой левой колонки сверху вниз, и только после ее завершения фокус переходит к верхнему блоку следующего столбца. Без такой пространственной сортировки строки из разных колонок, находящиеся на одной горизонтальной линии по оси Y, склеиваются в одну бессмысленную фразу.
Алгоритмы компьютерного зрения и нейросетевые модели детекции
Задачи пространственной сортировки и поиска сложных текстовых траекторий требуют перехода от классического сопоставления шаблонов к глубокому обучению (deep learning). Ранние алгоритмы пытались находить символы по жестко заданным геометрическим пропорциям, перепадам контрастности или фиксированным эталонным маскам. Такой подход давал сбои при малейшем изменении шрифта, наклоне камеры или наличии текстурного фона. Нейросетевые модели анализируют не изолированные пиксельные шаблоны, а многоуровневые визуальные признаки: микроконтуры штрихов, плотность границ и пространственный контекст всей сцены.
Фундаментом для извлечения этих признаков выступают сверточные нейронные сети. В качестве базового каркаса (backbone) часто применяется архитектура ResNet50, которая последовательно пропускает матрицу изображения через слои свертки, выделяя сначала простые грани и углы, а затем сложные паттерны, характерные для строчных и прописных знаков. Поскольку размер шрифта на одном изображении может варьироваться от мелких сносок до крупных заголовков, базовые сети дополняются пирамидальными структурами FPN и полносверточными сетями FCN. FPN объединяет карты признаков разного масштаба, сохраняя точность локализации как для мелких символов, так и для массивных букв, а FCN позволяет строить попиксельные карты вероятностей для картинок произвольного разрешения.
В двухэтапных архитектурах поверх карт признаков работают сети генерации регионов, такие как RPN (Region Proposal Network). RPN сканирует обработанную матрицу и выдвигает гипотезы - формирует черновые области-кандидаты, где с высокой вероятностью присутствует текст. В моделях класса Mask R-CNN эти регионы-кандидаты проходят дополнительное уточнение: сеть одновременно корректирует координаты рамок и генерирует точные бинарные маски для каждого отдельного текстового блока внутри найденной зоны.
Пословные и посимвольные методы локализации
В зависимости от того, какую структурную единицу нейросеть ищет на изображении в первую очередь, специализированные алгоритмы детекции делятся на два направления: пословные (Word-based) и посимвольные (Character-based) методы.
Пословные алгоритмы обучаются находить целые слова или текстовые строки как единые неделимые объекты. Такой подход опирается на принципы общей детекции объектов: сеть ищет горизонтальные или наклонные скопления штрихов, разделенные пробелами. Это дает высокую скорость обработки на стандартных документах с печатным текстом, однако пословные модели теряют точность при встрече с длинными составными словами, нестандартными межбуквенными интервалами (разрядкой) или сильно изогнутыми надписями, где границы слова не укладываются в простую геометрию.
Посимвольные методы решают проблему нестандартных форм за счет смещения фокуса на базовые элементы письменности - отдельные буквы, цифры и знаки препинания. Поскольку отдельный символ даже на круглом штампе или волнистом баннере сохраняет относительно стабильную локальную геометрию, обнаружить его проще, чем всю искаженную фразу целиком. После нахождения отдельных знаков алгоритм запускает механизм постобработки, который оценивает расстояние и ориентацию соседних элементов, связывая их в слова или непрерывные текстовые линии.
Механика работы модели CRAFT
Наглядным примером посимвольного подхода с последующей группировкой служит архитектура CRAFT (craft-text-detector). Вместо прямого предсказания координат рамок эта модель решает задачу через построение двухканальных гауссовых тепловых карт, анализируя центры символов и пространство между ними.
Процесс детекции в архитектуре CRAFT состоит из следующих этапов обработки:
- Формирование тепловой карты вероятности символа (Text score heatmap). Нейросеть оценивает каждый пиксель изображения и строит распределение вероятностей, где пиковые значения приходятся строго на геометрические центры отдельных букв или цифр.
- Построение карты связей (Link score heatmap). Параллельно второй канал сети генерирует тепловую карту, которая оценивает вероятность того, что два соседних символа принадлежат одному и тому же слову. Высокие значения на этой карте заполняют межбуквенные интервалы внутри слова, но обрываются на межсловных пробелах.
- Выделение первичных рамок (char-boxes). На основе пиков первой тепловой карты вокруг каждого найденного знака формируются локальные ограничивающие области.
- Сборка блоков через LinkRefiner. Для объединения разрозненных char-boxes в единые слова или длинные строки подключается модуль LinkRefiner. Он сопоставляет данные обеих карт и стягивает соседние символьные рамки с высокой оценкой связности в общий контур, точно повторяющий изгиб или наклон текстовой линии.
Профильные архитектуры и фреймворки компьютерного зрения
Разнообразие прикладных задач - от чтения кассовых чеков до поиска уличных вывесок - привело к появлению специализированных нейросетевых архитектур и комплексных программных библиотек. Каждое решение использует собственные математические механизмы для повышения точности границ или ускорения вычислений.
Ниже приведено сравнение профильных моделей и инструментальных сред, применяемых для поиска и локализации текста в компьютерном зрении:
| Архитектура или библиотека | Категория решения | Технический принцип локализации и особенности |
|---|---|---|
| TextSnake | Специализированная модель детекции | Представляет изогнутые строки как последовательность перекрывающихся круглых дисков с заданным радиусом и углом наклона, которые нанизываются на осевую линию текста. |
| TextFuseNet | Модель слияния признаков | Извлекает и объединяет признаки сразу на трех уровнях представления: глобальном (вся сцена), уровне слов и уровне отдельных символов, что помогает удерживать контуры при частичном перекрытии текста. |
| Mask TextSpotter | Сквозная архитектура | Использует двухэтапную сегментацию для одновременного поиска границ слов и попиксельного выделения символов, позволяя обрабатывать текст произвольной геометрической формы. |
| TextPerceptron | Сегментационная модель | Применяет сегментацию ключевых зон (центральной области, верхней, нижней, левой и правой границ) с последующим геометрическим восстановлением целостного полигона строки. |
| PP-OCRv6 | Комплексная система | Оптимизированный стек моделей, сочетающий легковесные сверточные и трансформерные блоки для быстрого поиска текстовых зон на документах и сложных фотографиях. |
| EasyOCR | Прикладная библиотека | Готовый программный модуль, использующий под капотом алгоритм CRAFT для этапа первичной детекции текстовых полигонов перед их передачей на чтение. |
| MMOCR | Инструментальный фреймворк | Модульная среда компьютерного зрения, объединяющая десятки взаимозаменяемых моделей детекции (включая текстовые сегментаторы и регрессоры границ) для настройки под специфические типы документов. |
| Tesseract-OCR | Классический движок | Использует алгоритмы анализа связных компонентов, поиска табличных линий и оценки распределения пробелов для сегментации макета страницы на колонки, абзацы и ровные строки. |
Выбор конкретной архитектуры в системах анализа изображений зависит от природы исходных данных: для ровных отсканированных страниц достаточно классического анализа макета в стиле Tesseract-OCR, тогда как фотографии вывесок, мятых этикеток или штампов требуют гибких сегментационных и посимвольных нейросетей, таких как CRAFT, TextSnake или TextFuseNet.
Влияние качества исходного изображения и методы препроцессинга
Даже самые совершенные сверточные и сегментационные модели работают непосредственно с числовой матрицей растрового файла. На физическом уровне любая загружаемая картинка представляет собой двумерную сетку пикселей, где каждой ячейке присвоены значения яркости и цвета. Чтобы алгоритмы компьютерного зрения точно отделили штрихи букв от окружающего пространства, между символами и подложкой должен существовать выраженный градиент яркости. Оценить это распределение помогает анализ гистограммы яркостей пикселей: на качественном исходнике с четким текстом график имеет два выраженных пика (один соответствует темным пикселям букв, другой - светлым пикселям бумажного или экранного листа), разделенных глубоким спадом.
Если исходный снимок сделан при плохом освещении, под острым углом или сжат с потерями, распределение яркостей на гистограмме смазывается, а границы символов на сетке пикселей разрушаются. В таких условиях детектор может пропустить бледные строки либо ошибочно выделить элементы фоновой текстуры как текстовые блоки.
Типичные дефекты исходных файлов и их влияние на локализацию
Точность вычисления координат текстовых зон напрямую зависит от оптических и цифровых характеристик исходника. На практике задачи обнаружения текста чаще всего осложняются пятью факторами:
- Низкое разрешение изображения и малый показатель DPI приводят к нехватке пространственных данных. Когда высота строчной буквы составляет всего несколько пикселей, тонкие штрихи, засечки и межбуквенные просветы исчезают, из-за чего мелкие надписи перестают отличаться от обычного цифрового шума.
- Пикселизация возникает при сильном увеличении мелких фрагментов или чрезмерном сжатии файла. Характерная ступенчатая структура по краям букв и блочные артефакты компрессии искажают топологию символов, заставляя алгоритмы дробить цельные слова на изолированные фрагменты.
- Размытые изображения появляются из-за сбоя автофокуса камеры или движения руки в момент съемки. Размытие уничтожает резкие перепады яркости на границах штрихов: края символов плавно перетекают в фон, что ведет к занижению отклика на картах признаков и смещению границ выделяемых областей.
- Перспективное искажение характерно для фотографий документов, уличных указателей или упаковок, снятых не под прямым углом. Строки при этом сходятся веером, а размер букв внутри одного слова меняется по мере удаления от объектива, что серьезно затрудняет построение стандартных прямоугольных рамок.
- Сложный фон включает в себя цветные градиенты, водяные знаки, защитные сетки бланков, блики на глянцевой бумаге, тени от переплета книги или пестрые текстуры. Высокочастотные элементы такого фона создают ложные контуры, которые конкурируют с реальными буквами при выделении текстовых регионов.
Математические и алгоритмические методы предварительной обработки
Для компенсации оптических дефектов перед подачей матрицы на вход детектора применяется препроцессинг - каскад математических трансформаций растра, направленный на подавление фона и усиление признаков текста.
Базовым этапом улучшения читаемости выступает коррекция яркостного диапазона. Операция нормализации пересчитывает значения пикселей так, чтобы они равномерно занимали весь доступный спектр (например, от 0 до 255 в восьмибитной шкале серого). Если на снимке присутствуют глубокие тени или засвеченные участки, применяется эквализация гистограммы - перераспределение частот яркостей, которое вытягивает детали из слишком темных или пересвеченных зон. Дополнительно выполняется программное повышение контраста и резкости с помощью сверточных ядер (высокочастотных фильтров), которые усиливают локальные перепады яркости на краях штрихов, компенсируя легкую расфокусировку оптики.
Особую роль в выделении контуров играет перевод цветного или полутонового изображения в строго двухцветное (черно-белое) представление. В зависимости от равномерности освещения исходника в компьютерном зрении применяются различные алгоритмы пороговой фильтрации и бинаризации:
| Метод фильтрации | Принцип математического расчета | Оптимальные условия применения |
|---|---|---|
| Жесткая пороговая бинаризация (THRESH_BINARY) | Всем пикселям со значением яркости выше заданной константы присваивается максимальное значение (белый), а остальным - нулевое (черный). | Идеально ровные цифровые скриншоты и студийные сканы документов с однородным белым фоном без теней. |
| Глобальный метод Оцу (THRESH_OTSU) | Алгоритм анализирует всю гистограмму яркостей пикселей и вычисляет единый оптимальный порог разделения так, чтобы минимизировать разброс яркостей внутри класса текста и класса фона. | Четкие контрастные изображения с выраженной бимодальной гистограммой, где фон и текст имеют стабильные оттенки по всей площади кадра. |
| Адаптивная фильтрация (динамический порог) | Изображение разбивается на малые окрестности (блоки пикселей), и для каждого участка порог бинаризации рассчитывается индивидуально на основе среднего или гауссовского взвешенного значения соседей. | Фотографии страниц со сложным освещением, косыми тенями от смартфона, бликами ламп или неравномерно пожелтевшей бумагой. |
В случаях, когда на исходной картинке светлые буквы расположены на темной подложке (например, ночные темы интерфейсов, вывески или негативы), используется операция Invert Image - инвертирование цветов. При таком преобразовании значение каждого пикселя вычитается из максимального порога шкалы яркости, что приводит матрицу к привычному для большинства классических детекторов виду «темный текст на светлом фоне».
Морфологические и геометрические трансформации
После очистки яркостной структуры вступают в силу операции, изменяющие геометрию и топологию пиксельных кластеров. Для устранения мелкого мусора, пыли со стекла сканера, следов печати с обратной стороны листа или зернистости матрицы камеры выполняется удаление шумов и артефактов посредством медианной и гауссовой фильтрации, а также морфологического размыкания.
Ключевым инструментом формирования целостных текстовых зон на этапе препроцессинга является дилатационный фильтр (dilation) - морфологическая операция наращивания. При проходе структурирующего элемента (специальной матрицы-шаблона, вытянутой по горизонтали) по бинаризованному изображению контуры светлых или темных областей расширяются. За счет такого направленного утолщения штрихов отдельные буквы, расположенные близко друг к другу, сливаются в единое пятно. Это слияние символов в единую область детекции позволяет легко обнаружить границы целого слова или строки даже простыми алгоритмами поиска контуров без привлечения тяжелых нейросетей.
Наконец, для устранения пространственных деформаций растра используются аффинные и проективные преобразования. Геометрическое выравнивание страниц (Perspective Transformation) опирается на поиск четырех угловых опорных точек документа или текстовой таблички и умножение координат каждого пикселя на матрицу гомографии. Такая операция разворачивает снятый под углом лист в плоскую фронтальную проекцию, восстанавливая параллельность строк и естественные пропорции шрифта. Завершается подготовка фрагментов операцией плотного кропа - точной обрезкой найденного региона по координатам его рамки с отсечением всех внешних полей, что позволяет передать на следующий этап чтения исключительно полезную текстовую матрицу.
Метрики оценки точности локализации и пороговые параметры
После геометрической коррекции и обрезки регионов возникает задача математической верификации результатов. Чтобы понять, насколько корректно алгоритм выделил текстовые блоки и отделил их от фона, применяется аппарат статистической и геометрической оценки. Без строгих критериев проверки невозможно настроить чувствительность детектора: слишком мягкие условия приведут к захвату мусорных элементов, а чрезмерно жесткие - к пропуску бледных или мелких надписей.
Геометрический критерий IoU и протокол DetEval
Базовым показателем пространственного совпадения при верификации моделей компьютерного зрения выступает метрика IoU. Она определяет степень наложения предсказанной алгоритмом рамки на эталонную разметку (Ground Truth). Вычисление строится на отношении площади пересечения двух фигур к общей площади их объединения.
IoU = Площадь пересечения / Площадь объединенияЕсли найденный блок полностью совпадает с эталонным, коэффициент равен 1. При полном отсутствии общих пикселей показатель падает до 0. На практике детекция считается успешной, когда полученное значение превышает заранее установленный порог (в стандартных тестах часто используется уровень 0.5). Однако базовый критерий IoU ориентирован на строгое соответствие «один к одному» и плохо справляется с типичными для текстовых задач расхождениями: когда алгоритм объединяет несколько слов в одну длинную рамку или, наоборот, дробит целое слово на отдельные слоги.
Для решения проблемы фрагментации и слияния рамок применяется специализированный протокол оценки DetEval. В отличие от простого порогового отсечения по площади, DetEval анализирует топологию наложений и учитывает три типа взаимосвязей между эталонными и найденными зонами:
- Соответствие «один к одному» (one-to-one) - идеальный сценарий, при котором один предсказанный контур покрывает ровно один реальный текстовый объект с достаточной площадью взаимного перекрытия.
- Связь «один ко многим» (one-to-many) - ситуация дробления (split), когда одно реальное слово было размечено детектором как серия из нескольких мелких соприкасающихся блоков.
- Связь «многие к одному» (many-to-one) - сценарий слияния (merge), когда одна большая рамка, сгенерированная моделью, захватывает сразу несколько независимых слов или соседних строк.
Учет составных совпадений через матрицы перекрытий в протоколе DetEval дает более объективную картину качества локализации, поскольку для последующего чтения разбиение строки на отдельные слова или захват фразы целиком не является критической ошибкой, если сами символы не были обрезаны.
Базовые метрики качества детекции
На основе подсчета верных срабатываний, пропусков и ошибочных захватов фона рассчитываются три фундаментальные статистические метрики: точность локализации (precision), полнота обнаружения (recall) и сводная F-мера. Каждая из этих величин отражает определенный аспект надежности работы поискового алгоритма.
| Метрика | Математическая суть | Практическая интерпретация в задаче поиска текста |
|---|---|---|
| Precision (Точность) | Отношение верно найденных текстовых зон к общему числу всех сгенерированных алгоритмом рамок. | Показывает чистоту выборки: какая доля выделенных блоков действительно содержит текст, а не фоновый шум или элементы графики. |
| Recall (Полнота) | Отношение верно локализованных блоков к общему количеству реальных текстовых объектов на картинке. | Демонстрирует способность алгоритма находить весь присутствующий контент без пропуска мелких, размытых или низкоконтрастных надписей. |
| F-мера (F-score) | Гармоническое среднее между показателями Precision и Recall. | Агрегированный индикатор сбалансированности модели, позволяющий оценить общую эффективность поиска при изменении настроек чувствительности. |
Между точностью и полнотой существует обратная зависимость. Если настроить алгоритм на поиск малейших намеков на буквы, полнота (recall) приблизится к максимуму, но вместе с реальными словами будут выделены дефекты бумаги и края таблиц, что обрушит точность (precision). Расчет гармонического среднего через F-меру помогает найти точку оптимума, где количество пропусков и ложных тревог сбалансировано:
F-мера = 2 × (Precision × Recall) / (Precision + Recall)Пороговые параметры фильтрации и оценка уверенности
Управление балансом между полнотой и точностью в алгоритмах, работающих с картами вероятностей, осуществляется через регулировку пороговых коэффициентов. Нейросеть не выдает готовые координаты напрямую - сначала она присваивает каждому пикселю или региону численный вес, отражающий вероятность принадлежности к тексту. Отсечение сомнительных кандидатов происходит по трем ключевым параметрам:
- Порог уверенности наличия текста (text_threshold) - минимальное значение вероятности на тепловой карте, при котором группа пикселей классифицируется как символ или часть текстового штриха. Снижение этого параметра позволяет захватывать полупрозрачные водяные знаки и выцветшие буквы, но повышает риск выделения случайных пятен.
- Порог связности символов в слово (link_threshold) - коэффициент, определяющий минимальную силу притяжения между соседними знаками для их слияния в единый массив. При высоком значении порога слово с широким межбуквенным интервалом (разрядкой) распадется на отдельные изолированные символы; при слишком низком - соседние колонки текста или слова в строке сольются в один общий блок.
- Итоговая оценка уверенности (score) - агрегированный показатель надежности для всей сформированной рамки, вычисляемый как среднее значение вероятностей входящих в нее пикселей. Если итоговый score сформированного полигона оказывается ниже заданного лимита, вся рамка отбрасывается как статистическая погрешность.
Роль визуального контекста при фильтрации ложных срабатываний
Даже тонкая калибровка порогов text_threshold и link_threshold не всегда спасает от ошибок на изображениях со сложной средой. Главная причина ложных срабатываний (False Positives) кроется в геометрическом сходстве многих искусственных и природных объектов с элементами шрифта. Мелкие локальные паттерны - решетки радиаторов, кирпичная кладка, штрихкоды, узоры на ткани, ветви деревьев или пунктирные линии в бланках - имеют такие же перепады яркости и частоту чередования контрастных полос, как и настоящие буквы.
Для отсечения подобных текстур и графических элементов ключевую роль играет анализ широкого визуального контекста. Когда алгоритм оценивает область изолированно, узкий вертикальный столбик пикселей невозможно отличить от буквы «I» или «l». Учет окружающего пространства позволяет оценить структурные закономерности более высокого порядка: наличие базовой линии строки, регулярность интервалов, однородность толщины штриха у соседних объектов и характер фона вокруг гипотетического слова. Если подозрительный паттерн является частью бесконечной периодической структуры (например, секцией забора или ячейкой сетки рабицы), контекстный анализ понижает итоговый score такой зоны, предотвращая передачу нетекстового мусора на этап оптического распознавания.
Типы обнаруживаемого текстового контента и практические сценарии
Отсечение фонового шума позволяет перейти к решению прикладных задач, где характер исходного изображения напрямую определяет геометрию и плотность искомых полигонов. В зависимости от способа получения картинки и среды съемки входные материалы делятся на несколько категорий, каждая из которых формирует специфические условия для пространственной локализации строк и слов.
Сравнение основных видов исходных изображений демонстрирует, как физическая природа носителя влияет на топологию текстовых зон:
| Категория исходного изображения | Характер фона и геометрии строк | Ключевая задача локализации |
|---|---|---|
| Отсканированные документы | Однородная подложка, строгая горизонтальная ориентация, фиксированные поля и предсказуемый межстрочный интервал | Разделение плотных колонок, колонтитулов, сносок и основного массива абзацев |
| Снимки экрана (скриншоты) | Идеально четкие границы пиксельной сетки, отсутствие оптических искажений, наличие рамок интерфейса, кнопок и иконок | Отделение коротких текстовых меток в элементах управления от графических пиктограмм |
| Фотографии чеков и счетов-фактур | Термобумага с низким контрастом, заломы носителя, разрывы штрихов матричной печати, плотное расположение позиций и цен | Удержание единой строки при больших пробелах между наименованием товара и итоговой суммой |
| Фотографии вывесок и объектов в естественной среде | Произвольный ракурс съемки, сложные текстуры окружения, блики, тени, нестандартные декоративные гарнитуры и объемные буквы | Построение точных многоугольников вокруг надписей с произвольным наклоном и изгибом |
Особенности детекции различных типов графических и текстовых данных
Внутри одного документа или кадра могут соседствовать области с совершенно разной графической структурой. Точность выделения координат зависит от того, насколько стабильны визуальные признаки конкретного типа записей:
- Печатный текст и омни-шрифты. Стандартная типографика в книгах, договорах и отчетах опирается на унифицированные пропорции глифов. Понятие омни-шрифтов охватывает широкий спектр наборных гарнитур (с засечками, гротески, моноширинные варианты), которые сохраняют стабильную толщину штриха, выверенную базовую линию и предсказуемый кернинг. Для детектора это наиболее предсказуемый класс объектов, где границы слов формируют четкие прямоугольные блоки.
- Рукописный текст и рукописи. В отличие от печатного набора, почерк характеризуется непрерывными связями между буквами, переменным наклоном, нестабильным нажимом пишущего узла и выносными элементами (петлями, росчерками), которые часто пересекают соседние строки по вертикали. При поиске таких зон контур локализации должен адаптироваться к волнообразной траектории строки и не разрывать слова из-за нестандартных пауз между символами.
- Таблицы и регулярные сетки. При анализе табличных данных задача поиска разделяется на два уровня: обнаружение внешней структуры (линий разграничения строк и столбцов) и локализация текста непосредственно внутри ячеек. Если границы таблицы прорисованы сплошными линиями, существует риск слияния вертикальных перегородок с крайними символами слов. При отсутствии видимой сетки группировка данных опирается исключительно на анализ пустых пространств и выравнивание блоков по вертикальным осям.
- Математические формулы. Алгебраические и физические выражения имеют двумерную пространственную структуру. Наличие верхних и нижних индексов, многоэтажных дробей, знаков интегралов, радикалов и матриц разрушает стандартное представление о плоской строке. Локализация формул требует объединения разномасштабных символов, смещенных относительно основной оси, в единую логическую рамку, чтобы мелкие индексы не отбрасывались как точечный шум и не привязывались к соседним абзацам.
- Серийные номера и маркировка. Коды на промышленных деталях, упаковках, банковских картах или кузовах часто наносятся методами лазерной гравировки, тиснения или каплеструйной печати (точечный шрифт). Здесь символы состоят из отдельных несвязанных точек или имеют минимальный перепад яркости с металлическим и пластиковым фоном. Для сборки таких разрозненных элементов в единый блок решающее значение имеет оценка шага между знаками.
- Текст внутри печатей и штампов. Оттиски содержат высокую концентрацию графических помех. Круглая нотариальная печать или прямоугольная именная печать обычно включают текст, расположенный по дуге вдоль концентрических окружностей, микротекст, защитные гильоширные сетки и гербовую символику в центре. Кроме того, оттиск часто накладывается поверх основного текста документа и личной подписи. Выделение таких зон невозможно с помощью простых горизонтальных рамок - требуются многоточечные полигоны, повторяющие кривизну дуги и отделяющие буквы от линий самой рамки штампа.
Мультиязычность первичной локализации и зональный подход
Важное свойство первичной пространственной детекции заключается в ее независимости от конкретного языка и алфавита на этапе поиска координат. Пока речь идет исключительно об обнаружении текстовых полигонов до момента запуска языковой модели OCR, алгоритмы компьютерного зрения оценивают фундаментальные топологические признаки письма: контрастные переходы границ штриха, периодичность чередования знаков и плотность заполнения строки.
Благодаря этому базовый принцип выделения текстовых областей одинаково применим к кириллице, латинице, греческому письму, а также к сложной письменности. Иероглифические системы (китайская, японская) отличаются высокой плотностью штрихов внутри условного квадрата и отсутствием пробелов между словами, тогда как арабская вязь или деванагари характеризуются непрерывной горизонтальной связностью символов в пределах слова. Несмотря на эти различия, на уровне тепловых карт вероятности любая письменность образует контрастные кластеры с выраженной осевой линией, что позволяет находить координаты строк еще до того, как потребуется определить конкретный язык документа.
Полученный на выходе массив координат найденных регионов служит основой для применения методики Zonal OCR. Суть зонального подхода состоит в том, что после обнаружения всех текстовых блоков на изображении дальнейшей обработке и извлечению данных подвергается не весь лист целиком, а только строго определенные целевые зоны, отфильтрованные по их пространственному положению или геометрическим пропорциям.
В прикладных задачах документооборота и автоматизации такой подход решает сразу несколько проблем. При обработке типовых бланков, квитанций, паспортов или накладных нет необходимости распознавать сотни слов стандартного юридического текста или рекламных сносок. Зональная выборка позволяет изолировать исключительно значимые поля: блок с итоговой суммой в правом нижнем углу счета, зону серийного номера в шапке бланка или ячейку с датой. Это сокращает вычислительные затраты на этапе оптического распознавания и предотвращает попадание лишнего текстового массива в результирующую структуру данных.