Инструмент выполняет удаление выбранных страниц из PDF для получения целевого документа без избыточной информации. Процесс начинается с загрузки исходного файла в систему. Далее пользователь указывает конкретные номера или непрерывные диапазоны листов, которые необходимо исключить.
Алгоритм изымает заданные элементы из внутренней структуры документа. После завершения обработки генерируется итоговый файл.
Такая операция решает задачу быстрой очистки материалов от нерелевантных данных. При этом обеспечивается полное сохранение оригинального содержимого оставшейся части файла. Текст, векторная графика и исходное форматирование на нетронутых страницах остаются в неизменном виде.
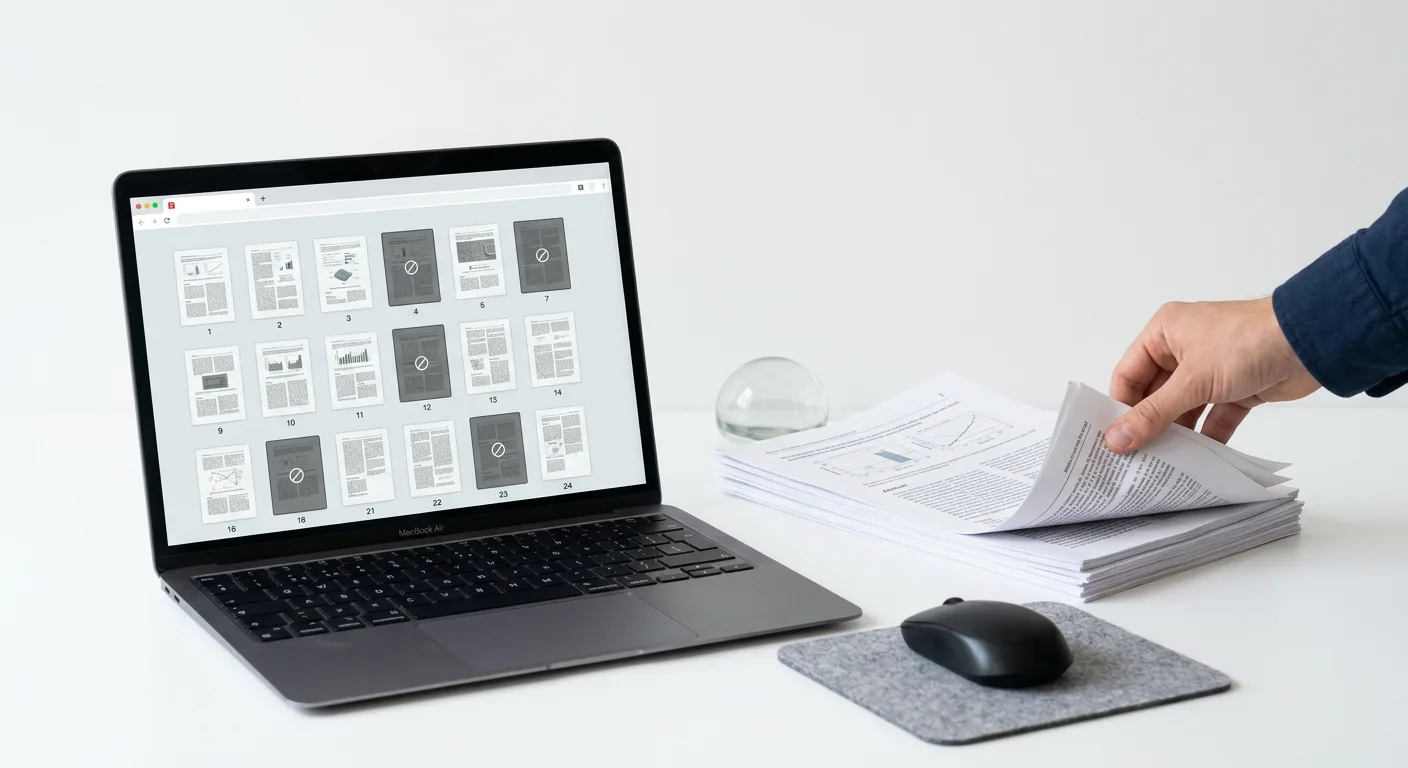
Алгоритм обработки и изменения структуры PDF-файла
Операция удаления базируется на прямом редактировании внутренней архитектуры документа. В качестве входных данных выступают исходный файл формата PDF и массив номеров страниц, подлежащих исключению.
Техническая логика выполнения задачи разделена на последовательные этапы обработки данных:
- Парсинг иерархической структуры документа, организованной в виде PDF Page Tree.
- Идентификация и удаление указанных узлов страниц из общего дерева документа.
- Перестроение внутренних связей для восстановления целостности файловой структуры после изъятия элементов.
Выходными данными выступает новый PDF-документ. Процесс изменения файловой структуры происходит исключительно на уровне объектов. Исключение узлов выполняется без растрового пережатия, промежуточной конвертации или изменения слоев данных на оставляемых страницах.
Синтаксис диапазонов и методы адресации удаляемых страниц
Идентификация целевых элементов для исключения осуществляется на основе их абсолютного физического порядка в структуре файла. Индекс первой страницы всегда равен единице, независимо от типографской нумерации, наличия римских цифр в предисловии или значений, напечатанных в колонтитулах. Применение абсолютной физической адресации исключает конфликты при обработке документов, где нумерация оглавления не совпадает с фактической последовательностью листов.
Формирование массива удаляемых страниц базируется на использовании нескольких методов ввода, которые позволяют точно определить ненужные элементы.
Указание точных номеров единичных страниц
Точечное изъятие выполняется путем ввода дискретных числовых значений. Этот метод применяется для работы с разрозненными листами, не образующими непрерывный блок. Разделение значений запятыми формирует перечень конкретных физических индексов, подлежащих удалению из исходного файла.
Синтаксис непрерывных диапазонов
Исключение объемных блоков документа осуществляется через определение границ интервала. Синтаксис требует указания начальной и конечной физической страницы, между которыми ставится дефис. Адресация интервалами сокращает объем вводимых данных при необходимости изъять целые разделы, главы или длинные приложения.
Логика выбора по атрибутам
Система адресации допускает выделение страниц на основе характеристики их четности или нечетности. Выбор по позиционным атрибутам позволяет сгенерировать массив для систематического изъятия половины листов документа без ручного перечисления каждого отдельного номера.
Логика парсинга входных параметров консолидирует пересекающиеся диапазоны, единичные номера и выборки по атрибутам. Итоговый запрос интерпретируется как единый массив уникальных физических индексов, который передается алгоритму для перестроения внутренней структуры документа.
Практические сценарии применения инструмента
Операция направленного изъятия страниц востребована в электронном документообороте для решения задач по форматированию, защите данных и оптимизации файлов. Применение сформированного массива физических индексов позволяет адаптировать исходный PDF под конкретные требования без изменения структуры оставшейся части.
Подготовка отсканированных копий
При потоковом сканировании двусторонних материалов или использовании аппаратных автоподатчиков бумаги итоговый файл неизбежно включает пустые обороты, смазанные дубликаты или дефектные листы с артефактами. Удаление таких страниц очищает документ от технического брака. Операция оставляет только корректные читаемые развороты, формируя чистую цифровую копию для последующего распознавания текста, печати или загрузки в систему хранения.
Обеспечение конфиденциальности при передаче данных
Отправка многокомпонентной корпоративной документации контрагентам требует строгого контроля над транслируемой информацией. Удаление конкретных диапазонов применяется для подготовки усеченных версий документов перед передачей третьим лицам. Типичные примеры изъятия:
- Исключение детализированных финансовых отчетов и смет из общих коммерческих предложений.
- Удаление листов, содержащих персональные данные, реквизиты или сканы паспортов, перед отправкой договоров внешним подрядчикам.
- Изъятие защищенных технических спецификаций, проприетарных формул и инженерных схем из базовых инструкций по эксплуатации.
Физическое исключение листов гарантирует, что адресат получит исключительно ту часть документации, которая предназначена для его уровня доступа.
Оптимизация размера файла для пересылки
Объемные PDF-файлы, такие как каталоги продукции, сводные годовые отчеты или многотомные регламенты, часто превышают жесткие лимиты почтовых серверов на размер вложения. Исключение нерелевантных информационных блоков позволяет эффективно сократить итоговый вес файла для беспрепятственной отправки по email.
В этом сценарии из структуры документа точечно удаляются тяжелые графические обложки, полноцветные рекламные развороты, неиспользуемые главы на других языках или длинные справочные приложения. В результате генерируется компактный файл, содержащий только целевую информацию, что минимизирует расход трафика и ускоряет процесс доставки данных конечному пользователю.
Сохранение исходного качества и атрибутов документа
Итоговый файл представляет собой точную копию оставленных частей исходного документа. Визуальные характеристики и внутренние свойства данных не подвергаются модификации в результате изъятия лишних листов.
Для каждой сохраненной страницы в полном объеме переносятся следующие элементы:
- Разрешение растровых изображений (DPI), что критично для отсканированных договоров, детализированных схем и фотографий.
- Встроенные шрифты, гарантирующие идентичное отображение типографики независимо от наличия исходных файлов шрифтов на устройстве получателя.
- Векторная графика, сохраняющая свойства масштабирования без потери резкости и появления артефактов сжатия.
- Цветовые профили, обеспечивающие точную передачу оттенков при просмотре на мониторе или последующей профессиональной печати.
Поведение навигации и метаданных
Интерактивная архитектура документа также интегрируется в генерируемый результат. Дерево закладок (bookmarks) и сформированные оглавления сохраняют свою первоначальную иерархию. Метаданные базового уровня переносятся в итоговый файл, позволяя пользователю ориентироваться в структуре разделов через стандартную навигационную панель программы-просмотрщика.
Специфика изъятия листов напрямую влияет на логику работы перекрестных ссылок. Внутренние гиперссылки, ведущие на удаленные страницы, перестают функционировать. Интерактивные элементы внутри текста или оглавления, ссылающиеся на исключенные приложения или главы, становятся неактивными, так как их целевой узел физически отсутствует в новом документе. При этом переходы между сохраненными страницами, а также любые ссылки на внешние веб-ресурсы продолжают работать корректно.
Конфиденциальность и безопасность обработки данных
Работа с корпоративной документацией, контрактами и личными архивами в веб-среде требует строгого соблюдения стандартов конфиденциальности. Базовым правилом выступает принцип временной обработки данных. Исходные файлы передаются в систему исключительно для выполнения конкретной технической задачи - чтения структуры документа, исключения выбранных узлов страниц и компиляции нового файла. Текстовое и графическое содержимое остающихся или удаляемых листов не подвергается машинному анализу, сбору или индексации.
Автоматическое удаление загруженных файлов
Ключевым механизмом защиты пользовательской информации является правило автоматического стирания данных. Технический процесс онлайн-обработки подразумевает строго ограниченный жизненный цикл документов:
- Исходный документ находится в памяти только на время парсинга дерева страниц и изъятия указанных диапазонов.
- Сгенерированный итоговый файл сохраняется временно для обеспечения возможности скачивания на локальное устройство.
- По завершении операции исходные данные и полученный результат необратимо удаляются без возможности восстановления.
Такой алгоритм делает безопасной работу с финансовой отчетностью, юридическими актами и любыми материалами, содержащими коммерческую тайну или персональные данные, исключая долгосрочное хранение чужой информации.
Кроссплатформенность и аппаратная независимость
Архитектура веб-инструментов переносит вычислительную нагрузку по перестроению структуры файлов на серверную сторону. Это обеспечивает полную независимость процесса от используемой операционной системы. Для загрузки базовых файлов, настройки номеров удаляемых страниц и сохранения итогового результата требуется только наличие современного веб-браузера.
Отсутствие привязки к конкретной среде выполнения позволяет применять заявленную операцию на широком спектре устройств:
- Настольные компьютеры и рабочие станции под управлением Windows, macOS или Linux.
- Мобильные платформы и планшеты, где локальное редактирование сложной структуры файлов часто затруднено.
- Корпоративные терминалы со строгими политиками информационной безопасности, запрещающими установку стороннего программного обеспечения.
Стандартизация через браузерные протоколы гарантирует, что логика адресации удаляемых листов, синтаксис диапазонов и качество генерируемого результата остаются идентичными независимо от типа оборудования, с которого инициирована сессия обработки.