Разбиение PDF-документа на отдельные файлы представляет собой операцию по извлечению конкретных страниц из исходного массива данных и формированию из них новых независимых документов. Инструмент Qivrora принимает загруженный пользователем файл и программно обрабатывает его внутреннюю структуру для точного выделения нужных сегментов.
Логика работы сервиса базируется на строгом следовании пользовательским правилам выборки. Оператор задает входные параметры, указывая конкретные номера листов или их непрерывные диапазоны. На основе этих значений система парсит исходный документ и генерирует новые PDF-файлы, включающие исключительно запрошенную информацию. Исходный многостраничный файл при этом остается неизменным.
Каждый извлеченный фрагмент сохраняется как самостоятельный файл формата PDF. Полученные документы полностью готовы к последующей пересылке, архивации или интеграции в сторонние рабочие процессы.
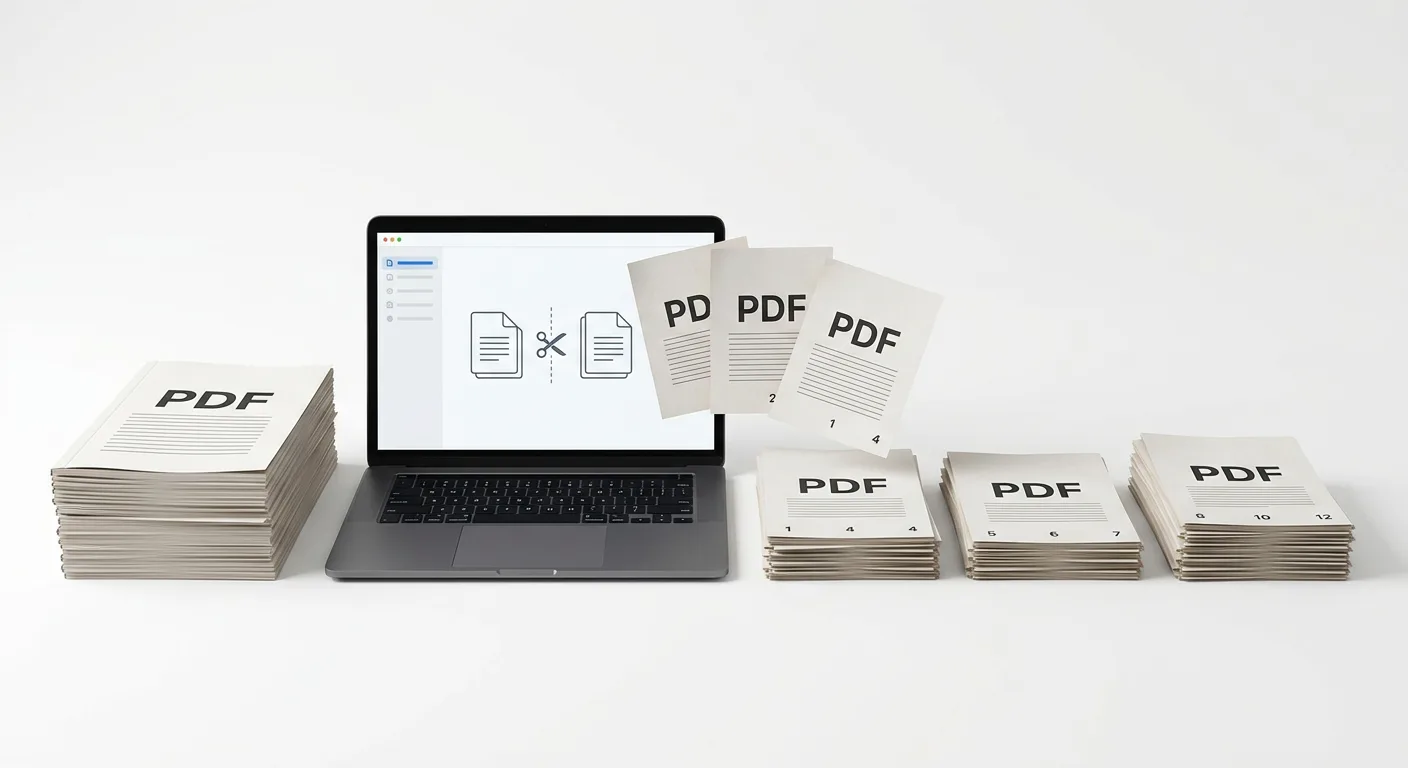
Режимы фрагментации: постраничное разделение и выбор диапазонов
Процесс извлечения данных управляется параметрами, которые задают логику формирования новых документов. Операция выполняется в двух основных форматах: полное постраничное разделение и выборочное извлечение на основе заданных числовых значений.
Постраничное разделение документа
Этот режим применяется для полной дефрагментации исходного массива данных. При выполнении данной операции каждая страница многостраничного документа конвертируется в отдельный независимый одностраничный файл. Обработка проходит по всему объему загруженного файла последовательно, от начала до конца. Итогом становится пакет сформированных файлов, количество которых строго равно количеству страниц во входном документе.
Извлечение по заданным диапазонам
Для точечной выборки сегментов применяется ручной ввод параметров. В этом случае новые документы генерируются исключительно на основе указанных числовых координат. Логика запросов базируется на специальном синтаксисе, который позволяет комбинировать одиночные листы и длинные последовательности в рамках одной команды.
Синтаксис ввода параметров подчиняется следующим правилам разметки:
- Использование дефиса: применяется для обозначения непрерывного диапазона страниц, которые необходимо извлечь как единый фрагмент.
- Использование запятой: служит разделителем при перечислении разрозненных номеров страниц или нескольких непересекающихся диапазонов.
В качестве эталонного примера ввода входных параметров используется строка вида:
1-5, 8, 11-12
. При обработке такого запроса система выполняет выборку соответствующих листов исходного файла. Результатом являются сформированные PDF-файлы, полностью соответствующие заданным правилам выборки: блок страниц с первой по пятую, отдельная восьмая страница и блок из одиннадцатой и двенадцатой страниц.
В обоих режимах алгоритм строго следует установленным правилам. Итогом выполнения операции всегда выступают новые валидные документы формата PDF, содержащие только запрошенную информацию без захвата смежных или неуказанных сегментов.
Сохранение исходной структуры и целостности PDF-данных
Процесс извлечения заданных страниц осуществляется на уровне внутренней структуры документа. Обработка файла происходит без применения растровой конвертации, что исключает преобразование исходных страниц в графические изображения. За счет прямого извлечения структурных объектов качество результирующих файлов остается полностью идентичным оригиналу.
Отсутствие промежуточного рендеринга гарантирует точное сохранение первоначального форматирования. В новые файлы переносятся все встроенные шрифты и параметры типографики. Векторные элементы, включая линии, геометрические фигуры и масштабируемую графику, сохраняют свою математическую основу и остаются четкими при любом уровне увеличения.
При фрагментации файла алгоритм обеспечивает полный перенос текстового слоя. В сформированных документах текст остается полноценным машиночитаемым элементом, а не пиксельным отпечатком. Это позволяет пользователю беспрепятственно задействовать встроенные функции поиска по словам, а также выделять и копировать фрагменты текста для работы в других приложениях.
Помимо визуального и текстового контента, процедура извлечения сохраняет технические метаданные каждой отдельной страницы. К наследуемым параметрам в результирующих файлах относятся:
- Точный размер листа, охватывающий как стандартные форматы, так и нестандартные габариты документа.
- Ориентация страницы с жесткой фиксацией исходного книжного или альбомного расположения.
- Геометрия страницы, включая внутренние отступы и границы контента.
Технический подход к копированию данных на структурном уровне обеспечивает формирование валидных документов формата PDF, которые содержат оригинальную информацию без визуальных искажений и потери функциональных возможностей.
Практические сценарии извлечения страниц из документов
Операция фрагментации файлов PDF применяется для структурирования информации и адаптации неструктурированных массивов данных под требования конкретных бизнес-процессов. Выборка нужных частей из общего файлового контейнера позволяет оптимизировать цифровое хранение и упростить адресный обмен документами.
Обработка пакетов бухгалтерской документации
При потоковом сканировании первичной финансовой документации аппаратные средства часто формируют единый многостраничный файл. Такой цифровой архив может содержать десятки разнородных материалов, идущих подряд: счета на оплату, товарно-транспортные накладные, акты сверки и кассовые ордера. Постраничное разделение подобного массива применяется для конвертации непрерывного скана в набор независимых файлов.
Полученные в результате поштучной фрагментации отдельные PDF-документы загружаются в учетные системы. Это позволяет прикреплять конкретный акт или счет к соответствующей проводке или карточке контрагента. Разделение устраняет необходимость хранить тяжелый пакет документов ради одной транзакции и исключает путаницу при налоговых проверках, когда требуется предоставить строго определенный первичный документ.
Извлечение структурных элементов из технических руководств
Спецификации, стандарты ГОСТ, проектная документация и руководства по эксплуатации оборудования часто представляют собой объемные файлы со сложной иерархией. В ситуациях, когда требуется передать инженеру на объекте или внешнему подрядчику только релевантную часть данных, применяется метод извлечения по диапазонам страниц.
Использование параметров выборки диапазонов позволяет точечно изолировать конкретную главу, отдельное техническое приложение или детализированную векторную схему. Сформированный файл содержит исключительно запрошенные страницы. Такой подход радикально снижает объем передаваемых данных и позволяет техническому специалисту сосредоточиться на конкретной инструкции без необходимости навигации по всему массиву исходного руководства.
Изоляция листов подписания в юридических договорах
В корпоративном документообороте процесс согласования контрактов часто требует отдельной работы с листами, содержащими реквизиты, подписи и печати сторон. Процедура точечного извлечения отдельной страницы применяется для сепарации финального листа от многостраничного текста соглашения.
Полученный одностраничный файл с факсимиле используется для формирования реестра подписанных контрактов, прикрепления к электронной карточке сделки или отправки контрагенту в качестве подтверждения акцепта. Выделение листа подписания гарантирует передачу исключительно целевой информации и упрощает проверку наличия всех необходимых печатей без загрузки полного текста документа.
Безопасность передачи и обработки конфиденциальных документов
Работа с юридическими контрактами, финансовой отчетностью и закрытой проектной документацией требует соблюдения строгих стандартов защиты информации. Процесс онлайн-разделения файлов опирается на архитектуру, исключающую несанкционированный доступ к содержимому на всех этапах взаимодействия с исходными материалами.
Защита данных в процессе маршрутизации реализуется через изолированные каналы связи. Передача входных данных на сервер и последующая загрузка сформированных выходных файлов осуществляются с использованием зашифрованных протоколов TLS/SSL. Применение криптографической защиты транспортного уровня гарантирует целостность пакетов и предотвращает перехват документации при обмене информацией между локальным устройством и вычислительным узлом.
На этапе фрагментации PDF-документа применяется принцип эфемерной обработки. Исходные файлы не копируются на жесткие диски и не заносятся в базы данных. Документ временно размещается в изолированной памяти системы исключительно на период выполнения алгоритма извлечения страниц.
Сразу после завершения операции разделения и формирования целевых файлов запускается протокол автоматического удаления. Исходный массив и сгенерированные результаты безвозвратно стираются из памяти системы. Отсутствие постоянного хранения гарантирует, что факсимиле, технические чертежи и коммерческие условия контрактов уничтожаются по окончании сессии, исключая риск утечки конфиденциальных сведений.