Замена строк столбцами в таблице представляет собой процесс реструктуризации массива данных, при котором происходит изменение расположения элементов по горизонтали и вертикали. Операция транспонирования переворачивает сетку значений. Бывшие заголовки колонок становятся названиями рядов, а вертикальные списки выстраиваются в горизонтальную линию.
Инструмент предназначен для прямой конвертации скопированных строк в столбцы и выполнения обратной операции. Пользователю достаточно вставить исходный текстовый фрагмент из буфера обмена в рабочую область. Алгоритм считывает структуру и инвертирует оси координат. Сами числовые или текстовые значения ячеек остаются полностью неизменными.
Перегруппировка массива выполняется строго на уровне осей без нарушения логических связей внутри исходной структуры.
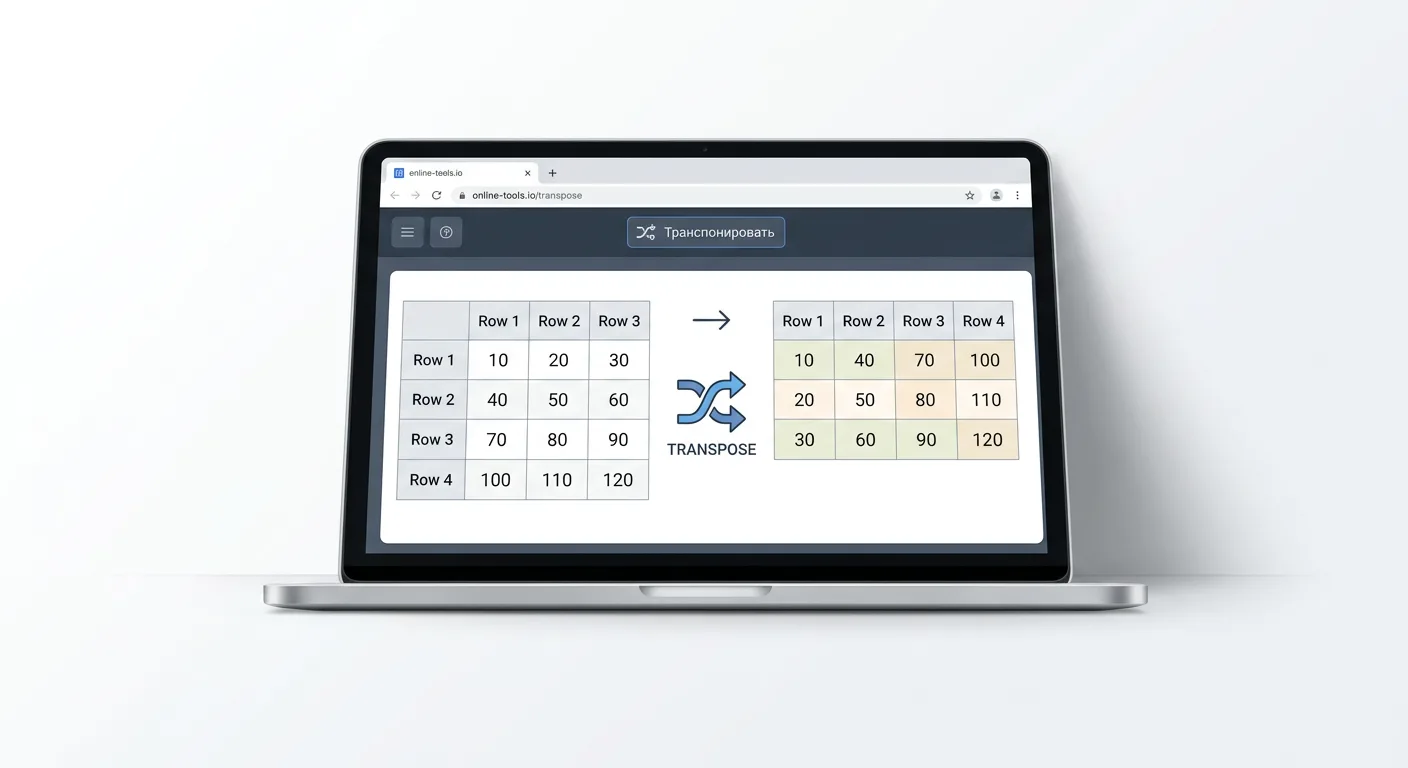
Структурная основа транспонирования массивов данных
В основе транспонирования лежит принцип изменения ориентации двумерного массива. При выполнении данной операции горизонтальная и вертикальная оси координат меняются местами. Структура данных перестраивается таким образом, что все элементы, ранее расположенные в горизонтальный ряд, формируют вертикальную колонку, а элементы колонки выстраиваются в горизонтальную линию.
С математической точки зрения процесс реструктуризации подчиняется строгому правилу координатного сдвига. Каждое значение в табличной сетке имеет уникальный адрес: индекс по горизонтали и индекс по вертикали. Значение, находящееся на пересечении строки i и столбца j, закономерно перемещается в новую позицию. В преобразованной структуре его новыми координатами становятся строка j и столбец i. Содержимое самой ячейки при этом переходе остается полностью идентичным исходному.
Подобное изменение координат элементов неизбежно трансформирует общую размерность таблицы. Исходный диапазон ячеек, состоящий из N строк и M столбцов, после конвертации преобразуется в новый диапазон размером M строк на N столбцов. Прямоугольная сетка данных вытягивается в противоположном направлении.
Основные параметры изменения ориентации данных представлены в сравнительной таблице:
| Характеристика массива | Исходная структура данных | Преобразованная структура данных |
|---|---|---|
| Координаты отдельного элемента | Строка i, Столбец j | Строка j, Столбец i |
| Общая размерность сетки | N строк, M столбцов | M строк, N столбцов |
| Объем элементов (вместимость) | Произведение N на M | Произведение M на N |
Несмотря на полную инверсию визуальной формы и адресации каждого элемента, общее количество ячеек в структурированных данных сохраняется неизменным. Математическое произведение количества строк на количество столбцов дает идентичный результат до и после преобразования. Операция перегруппировки осей обеспечивает строгую целостность массива, исключая как потерю существующих значений, так и добавление новых пустых ячеек вне заданного диапазона.
Порядок изменения расположения строк и столбцов
Практическое выполнение конвертации массива строится на прямом взаимодействии с буфером обмена операционной системы. Процесс разделен на этапы передачи исходной информации, изменения структуры и извлечения готового результата, что позволяет избежать ручного перемещения отдельных ячеек.
Рабочий цикл реструктуризации данных включает следующую последовательность действий:
- Ввод исходных данных. Предварительно выделенный и скопированный диапазон ячеек вставляется в рабочую область. Переданный текстовый массив служит базой для выполнения преобразования.
- Инверсия осей таблицы. Выполняется математическая и логическая перегруппировка элементов, при которой горизонтальные и вертикальные направляющие сетки меняются местами.
- Генерация выходных данных. Формируется преобразованный массив с новой адресацией. Главным структурным признаком выполненной операции является то, что бывшие заголовки столбцов становятся заголовками строк, выстраиваясь в единый вертикальный столбик.
- Извлечение результата. Готовая таблица с измененной ориентацией копируется в буфер обмена с использованием стандартной комбинации клавиш CTRL+C.
Смещение фокуса с горизонтальной плоскости на вертикальную происходит синхронно для всех элементов массива. При формировании направленного вниз столбика из бывших горизонтальных заголовков, все ассоциированные значения корректно перемещаются в соответствующие строки. Завершающий этап с применением CTRL+C обеспечивает доступность инвертированных данных для немедленной вставки в необходимый документ, таблицу или текстовое поле.
Обработка разделителей в форматах CSV, TSV и буфере обмена
Текстовое представление структурированных данных опирается на систему управляющих символов. При передаче массива механизм парсинга осуществляется за счет распознавания этих маркеров, которые определяют границы отдельных элементов и формируют строгую сетку координат для последующей инверсии.
При копировании информации из табличных редакторов исходная структура сохраняется в буфере обмена благодаря двум базовым типам разделителей:
- Разделитель полей. Символ табуляции отделяет содержимое одной ячейки от другой в пределах горизонтальной направляющей.
- Разделитель строк. Символ перевода строки сигнализирует о завершении текущего ряда и начале нового, формируя вертикальную ось.
Подобный принцип текстовой разметки полностью соответствует стандартам хранения баз данных. Формат TSV изначально построен на использовании табуляции в качестве разграничителя. В формате CSV для отделения значений применяется запятая, при этом общая логика формирования двумерной сетки через маркеры остается неизменной. При выполнении операции считываются исходные знаки, перестраивается последовательность элементов по правилу изменения ориентации и генерируется новый текстовый блок с обновленным расположением разделителей.
Критическим аспектом при изменении осей является обработка пустых ячеек. Отсутствие видимого текста внутри диапазона не отменяет наличия самой ячейки в сетке. В строковом представлении пустая позиция обозначается двумя идущими подряд разделителями полей либо разделителем, непосредственно примыкающим к символу перевода строки.
Сохранение изначальной кросс-табличной структуры при реструктуризации обеспечивается правильной интерпретацией таких пустот:
- Незаполненные позиции обрабатываются как полноправные элементы массива со своими координатами.
- Позиция пустой ячейки инвертируется по общему алгоритму наравне с заполненными ячейками.
- Наличие пустых узлов не приводит к схлопыванию столбцов, объединению строк или смещению соседних значений.
Благодаря строгому учету всех разделительных знаков, преобразованный массив сохраняет пропорциональность. Это предотвращает искажение связей между перемещенными заголовками и ассоциированными с ними данными, гарантируя корректную вставку результата.
Практические сценарии применения транспонированных таблиц
Точная реструктуризация текстовых массивов решает ряд прикладных задач при анализе, импорте и верстке данных. Изменение изначальной ориентации ячеек применяется для адаптации информации под требования конкретных систем обработки и визуализации.
Подготовка данных для построения графиков
При визуализации информации в табличных редакторах распределение значений по координатным осям определяет итоговый вид диаграммы. Инструменты построения графиков по умолчанию алгоритмизированы так, что ожидают расположения категорий в первом столбце, а числовых рядов данных - в соседних столбцах. Если исходный набор данных имеет горизонтальную структуру, где категории распределены по строке, система не сможет правильно сгруппировать показатели. Предварительная замена осей X и Y путем инверсии таблицы обеспечивает корректную привязку рядов к осям координат и автоматическое формирование правильной легенды графика.
Адаптация отображения для мобильных устройств и HTML-верстки
Широкие таблицы, содержащие большое количество столбцов и минимальное количество строк, вызывают проблемы при отображении на узких экранах. Использование постоянной горизонтальной прокрутки нарушает логику потребления контента. Преобразование избыточно широкой таблицы в вертикальный список позволяет адаптировать данные для корректного отображения. После изменения расположения осей бывшие горизонтальные заголовки выстраиваются в левый столбец характеристик, а их значения располагаются справа. Полученный компактный массив считывается последовательно, легко встраивается в HTML-верстку и масштабируется в мобильных интерфейсах.
Форматирование структур ключ-значение для баз данных
Операции импорта информации в базы данных требуют строгого совпадения структуры загружаемого файла со схемой целевой таблицы. Довольно часто исходные данные предоставляются в виде вертикальных списков, где параметры идут друг за другом в одном столбце. Для корректной пакетной загрузки требуется извлечение этого столбца и конвертация его содержимого в строку. Такое изменение осей позволяет сформировать плоскую запись в формате ключ-значение, где каждая строка представляет собой отдельный объект с набором атрибутов. Приведение массива к такому виду необходимо для безошибочного маппинга полей и интеграции данных.
Стандартные методы табличных процессоров Специальная вставка и функция ТРАНСП
Операция изменения ориентации массива является базовой потребностью при работе со структурированными данными. Популярные табличные редакторы содержат встроенный инструментарий для инверсии осей. Решение задачи внутри электронной таблицы осуществляется двумя основными способами в зависимости от того, требуется ли сохранение математической связи с исходным диапазоном.
Статическое транспонирование через буфер обмена
Метод статического преобразования применяется для создания независимой перевернутой копии выделенного массива. При таком подходе переносятся исключительно текущие значения ячеек и их визуальное форматирование, без сохранения привязки к первоисточнику. Выполнение операции базируется на алгоритме взаимодействия с буфером обмена.
- Выделение требуемого прямоугольного диапазона ячеек
- Копирование выделенного фрагмента данных в буфер обмена
- Позиционирование курсора в пустой ячейке для задания верхней левой границы нового массива
- Вызов контекстного меню и переход к параметру Специальная вставка
- Активация пункта Транспонировать и подтверждение выполнения операции
Динамическое связывание через формулу массива
Сценарии, подразумевающие регулярное обновление исходных данных, требуют создания зависимой структуры. Для этого применяется функция TRANSPOSE, которая в русскоязычных локализациях редакторов обозначается как ТРАНСП. Использование формулы позволяет создать массив, автоматически меняющий свои значения при любом редактировании оригинальной таблицы.
Процесс динамического связывания требует предварительного выделения пустого диапазона, размерность которого строго обратно пропорциональна исходному. В строку формул вводится выражение с указанием целевых координат, после чего применяется специализированное сочетание клавиш для инициализации формулы массива. Сформированная таким образом таблица функционирует как единый вычисляемый объект, блокируя возможность изменения отдельных ячеек внутри нового диапазона.
Отличия браузерной конвертации от табличных редакторов
Использование полновесных программных комплексов оправдано при построении сложных аналитических моделей. При этом для промежуточной подготовки информации часто применяется браузерная конвертация текста с разделителями. Различия между алгоритмами обработки определяют оптимальность выбора инструмента для конкретного сценария.
| Критерий оценки | Встроенные функции редакторов | Браузерная обработка текста |
|---|---|---|
| Объект преобразования | Ячейки с метаданными, формулами и пользовательским форматированием | Плоские текстовые строки, разделенные символами табуляции или запятыми |
| Среда исполнения | Требует инсталляции программного обеспечения или авторизации в облаке | Выполняется в локальной среде браузера без привязки к конкретной операционной системе |
| Вычислительная нагрузка | Потребляет ресурсы для рендеринга сетки и фонового пересчета зависимостей | Осуществляет реструктуризацию строковых данных в оперативной памяти |
| Целевое применение | Формирование связанных отчетов и архитектуры внутри одного документа | Оперативная подготовка фрагментов перед миграцией между независимыми системами |