Изменение порядка столбцов в таблице решает задачу реструктуризации макета без ручного выделения, вырезания и вставки отдельных ячеек. Инструмент физически перестраивает расположение колонок по горизонтальной оси. Сами исходные значения данных при этом не модифицируются.
Ключевое условие алгоритма переформатирования - строгое сохранение целостности строк.
При перемещении выбранной колонки на новую позицию все горизонтальные связи между ячейками остаются неизменными. Входными данными выступают текстовые массивы с разделителями, включая данные из буфера обмена или файлы формата CSV. Инструмент считывает исходную сетку, меняет индексы целевых столбцов согласно заданному порядку и немедленно формирует обновленный текст. Результатом операции становится перестроенный массив с требуемой последовательностью колонок, полностью готовый к последующему экспорту.
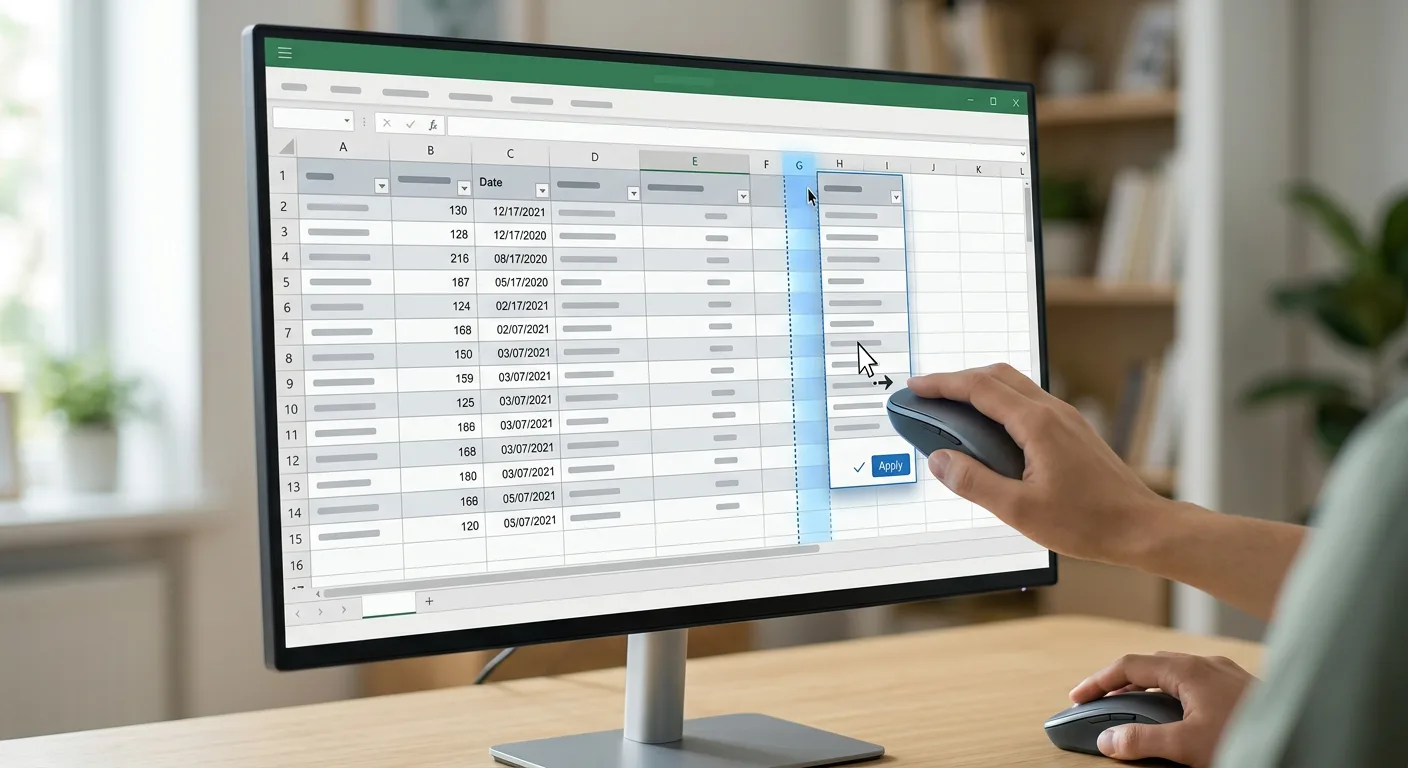
Принцип реструктуризации табличных данных
Любая таблица представляет собой двумерную матрицу, образованную пересечением горизонтальных строк и вертикальных столбцов. Точка пересечения этих осей формирует ячейку, выступающую базовой единицей хранения информации. Взаимосвязь всех строк и колонок определяет общую структуру таблицы, где каждый элемент имеет строгие координаты в пространстве сетки.
Визуальное и логическое распределение данных формирует макет таблицы. Основным ориентиром в таком макете выступает заголовок столбца, задающий контекст для всего нижележащего вертикального массива ячеек. Механика реструктуризации базируется на операции изменения индекса столбца - его порядкового номера относительно начала матрицы.
Процесс изменения позиции колонки опирается на математическое поведение осей координат:
- Ось X (горизонтальная направляющая): определяет последовательность вертикальных массивов. Перемещение колонки изменяет ее позицию исключительно по оси X, переназначая индекс исходного столбца и сдвигая соседние массивы.
- Ось Y (вертикальная направляющая): отвечает за связность данных в рамках одной записи. При смещении координат столбца по оси X все связи данных по вертикальной оси Y остаются неизменными.
Смещение индекса приводит к перераспределению блоков вдоль горизонтальной оси. Каждая ячейка перемещаемой колонки жестко привязана к своей строке. Благодаря фиксации вертикальных связей, после изменения позиции столбца в матрице обеспечивается полная идентичность исходных записей без нарушения логики данных.
Форматы входных данных и роль разделителей
Передача исходного диапазона данных осуществляется через буфер обмена операционной системы. При копировании выделенного массива из табличных процессоров, источником которых выступают Excel, ODS или аналогичные программы, визуальная сетка преобразуется в неформатированный текст. В таком текстовом представлении сохраняется строгая логическая структура исходной матрицы благодаря использованию специальных служебных символов между значениями.
Текстовые представления таблиц базируются на плоских форматах данных, где отсутствует визуальное оформление, ширина ячеек или заливка. Поддерживаются форматы CSV, TSV и стандартный TXT. В этих форматах распределение информации по осям опирается исключительно на символы-маркеры, выступающие границами блоков информации.
Основные текстовые форматы и их структурные маркеры формируют предсказуемую среду для обработки массивов.
| Формат представления | Типичный маркер | Техническая функция в строке |
|---|---|---|
| TSV | Знак табуляции | Изоляция ячеек при копировании напрямую из табличного процессора |
| CSV | Запятая или точка с запятой | Разделение значений при экспорте баз данных и выгрузках |
| TXT | Пользовательский символ | Организация данных с использованием нестандартных границ |
Разделитель выступает технической границей, определяющей пределы конкретной ячейки в рамках одной текстовой строки. Этот маркер позволяет системе отличить данные одного столбца от данных соседнего. Преобразование сплошного текста обратно в матричную структуру опирается на два типа разделителей:
- Горизонтальные маркеры: знак табуляции, запятая или другой символ сигнализируют о завершении текущей ячейки и начале следующей колонки по оси X.
- Вертикальные маркеры: символ переноса строки маркирует окончание текущей записи и формирование нового горизонтального массива по оси Y.
Точная идентификация разделителя колонок является критичным условием для корректного перемещения столбца. Поскольку смещение колонки требует изменения ее индекса в каждой строке, сплошной текст должен быть безошибочно разбит на дискретные блоки. Несовпадение фактического разделителя в скопированном тексте с ожидаемым маркером приведет к слиянию соседних колонок в единый неразрывный блок. В таком случае изолированное обращение к целевому столбцу и изменение его позиции в макете таблицы станет невозможным.
Алгоритм изменения макета и порядка колонок
Переформатирование табличного массива осуществляется локально в браузере. Загруженный текст с разделителями обрабатывается вычислительными ресурсами клиентского устройства, без передачи исходной информации на внешние серверы. Процесс изменения макета запускается после того, как сплошной текст корректно разбит на двумерную матрицу на основе идентифицированных маркеров.
Логика реструктуризации базируется на переназначении числовых индексов по горизонтальной оси. Каждому столбцу в исходной таблице соответствует определенный идентификатор, отражающий его текущую позицию. Для выполнения перестановки алгоритм требует фиксации исходного столбца и определения его новой целевой позиции. Операция привязывается исключительно к порядковому номеру колонки, независимо от наличия заголовков или объема символов внутри конкретных ячеек.
Обработка данных происходит строго по заданному пользователем порядку следования. Если исходная таблица имеет структуру колонок в базовой последовательности 1-2-3, перемещение третьего столбца на первую позицию приведет к формированию нового шаблона макета: 3-1-2. Выбранное правило преобразования применяется ко всем строкам таблицы одновременно и идентично. Синхронное применение паттерна ко всему массиву гарантирует, что горизонтальные связи между ячейками внутри одной записи останутся нетронутыми при смене координат столбца.
Перестроение массива данных для каждой строки опирается на следующий механический принцип:
- Изоляция целевого массива: Выбранный столбец виртуально извлекается из текущей последовательности индексов.
- Смещение смежных колонок: Оставшиеся столбцы смыкаются для заполнения освободившейся исходной позиции, а в целевой зоне сдвигаются вправо, подготавливая место для вставки.
- Рокировка данных: Изолированный столбец интегрируется в новую заданную координату перестроенного макета.
- Фиксация матрицы: Алгоритм закрепляет обновленную последовательность ячеек, подготавливая строку к последующему объединению через разделитель.
Поскольку алгоритм перестроения работает с индексами массивов в оперативной памяти браузера, смена позиций происходит мгновенно для всех итераций. Это исключает ручное копирование и перенос отдельных блоков текста, обеспечивая математически точную перестановку элементов по заданному вектору.
Сценарии применения перестановки столбцов
Операция изменения порядка колонок применяется для решения прикладных задач по стандартизации массивов данных. Реструктуризация позволяет адаптировать табличную информацию под технические требования принимающих систем или улучшить логику распределения информации для визуального анализа.
Подготовка выгрузок для импорта в CRM-системы и базы данных
Системы управления клиентами и корпоративные базы данных требуют строгого соответствия макета загружаемого файла внутреннему шаблону. Исходная CSV-выгрузка из стороннего сервиса или рекламного кабинета часто содержит нужные данные, но с иным расположением полей по горизонтальной оси. Например, исходный массив сформирован в порядке «Email - Телефон - Имя», а целевая система ожидает структуру «Имя - Телефон - Email».
Приведение макета к жесткому шаблону импорта гарантирует корректное распределение значений по соответствующим ячейкам базы данных. Изменение позиций столбцов до момента загрузки предотвращает системные ошибки парсинга и исключает ситуацию, при которой текстовые строки попадают в поля, предназначенные исключительно для числовых идентификаторов.
Адаптация сырых данных для создания отчетов
При работе с системными логами, транзакциями или результатами парсинга ключевые метрики могут располагаться в середине или в конце табличного массива. Для формирования понятного отчета требуется выстроить информацию по степени ее значимости.
Перемещение колонок с именами, идентификаторами пользователей, статусами заказов или итоговыми финансовыми показателями в начало таблицы значительно упрощает чтение сырых данных. Такая реструктуризация подготавливает массив к передаче в аналитические отделы или к формированию сводных таблиц, где базовые критерии группировки должны предшествовать второстепенным параметрам и техническим меткам.
Выравнивание структуры независимых таблиц
Интеграция информации из нескольких разных источников часто требует приведения таблиц к единому формату. Если первая таблица имеет структуру макета «Артикул - Цена - Остаток», а вторая выстроена по принципу «Остаток - Артикул - Цена», прямое объединение таких массивов приведет к смешиванию разных типов данных в одном вертикальном диапазоне.
Смещение нужных колонок во второй таблице позволяет полностью синхронизировать ее макет с эталонным первым массивом. Одинаковый порядок следования столбцов является обязательным условием для последующего прямого слияния строк или поиска дубликатов при работе во внешних табличных редакторах и базах данных.
Экспорт и интеграция преобразованной таблицы
Результат изменения макета формируется в виде нового текстового массива. В сгенерированном блоке данных значения и разделители выстроены в строгом соответствии с обновленным порядком следования столбцов. Исходные связи по горизонтальной и вертикальной осям сохраняются, образуя целостную структуру, готовую к дальнейшему использованию.
Извлечение переформатированной матрицы осуществляется посредством копирования текста в буфер обмена операционной системы. Этот стандартизированный способ передачи данных обеспечивает прямую интеграцию массива с большинством программ для работы с электронными таблицами.
Перенос данных в табличные процессоры
Скопированный текстовый массив предназначен для последующей вставки в целевую рабочую среду. При переносе информации в Excel, Google Sheets или аналогичные приложения происходит обратное чтение текста и его распределение по визуальной сетке ячеек. Программа-приемник анализирует скопированные разделители и корректно размещает значения согласно новому, реструктурированному макету.
Для интеграции данных выполняется стандартная операция вставки в подготовленный диапазон или на пустой рабочий лист:
- Выбор начальной ячейки в целевом приложении.
- Вставка содержимого буфера обмена.
- Автоматическое распределение текста по столбцам на основе присутствующих разделителей.
Визуализация и графическое форматирование
Текстовое представление матрицы включает только сами данные и структурные символы-разделители. Массив не содержит метаданных о графическом оформлении документа, так как задача реструктуризации касается исключительно логики расположения информации.
Итоговая визуализация таблицы полностью формируется на стороне конечного табличного редактора, принимающего реструктурированную информацию. Все графические свойства применяются и настраиваются локально в Excel или Google Sheets после завершения импорта. К таким параметрам относятся:
- Ширина колонок в зависимости от длины содержимого ячеек.
- Отображение, цвет и толщина линий между колонками и строками.
- Параметры шрифта, заливка ячеек и выравнивание текста.
- Пользовательские форматы данных для числовых значений, дат или валют.
Подобное разделение процессов перестроения макета и настройки визуального стиля позволяет избежать переноса конфликтующих форматов и гарантирует чистую вставку сырых данных в любой корпоративный или личный шаблон отчета.