Первичная обработка табличных массивов часто упирается в проблему фрагментированной информации. Восстановление данных в пустых полях является обязательным техническим этапом подготовки датасета перед запуском вычислений. Строгие алгоритмы машинного обучения и финансового анализа требуют полных числовых матриц. Наличие пропусков приводит к искажению метрик или генерации системных ошибок при выполнении скриптов.
Инструмент выполняет автоматическое преобразование входного набора данных. Сначала алгоритм сканирует загруженную структуру и точно локализует ячейки, содержащие Null, NaN или классические missing values. После этапа идентификации система применяет выбранные пользователем правила замещения. Программа заполняет обнаруженные пустоты фиксированными константами или динамическими значениями, рассчитанными по математическим и статистическим формулам.
Конечным результатом операции выступает целостный датафрейм. Исходный объем выборки сохраняется без удаления строк с проблемными ячейками.
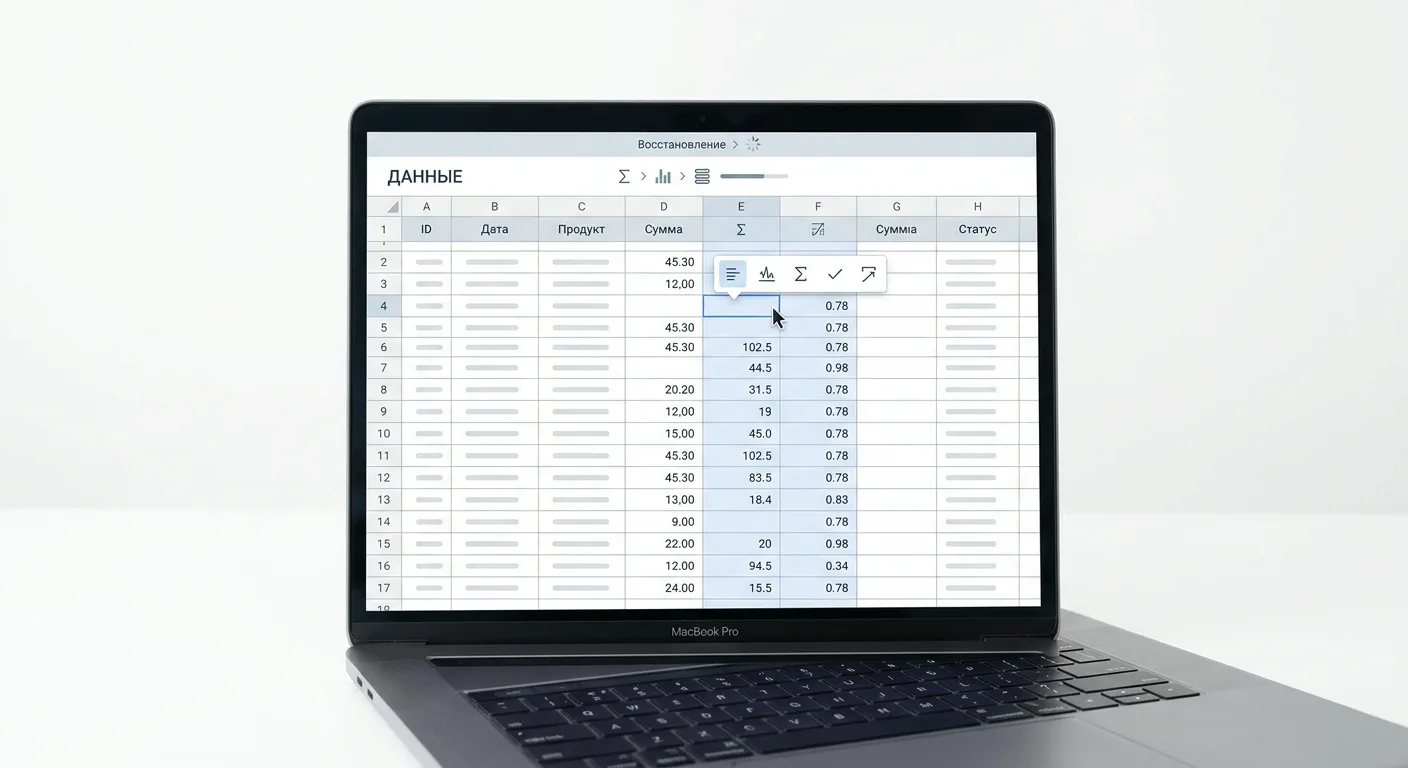
Идентификация пропусков и структура входных данных
Для корректной обработки загружаемой информации требуется строгая двумерная структура. Исходный набор данных интерпретируется как табличный массив, или DataFrame, который состоит из строк и столбцов. Строки отражают отдельные наблюдения или записи датасета, а столбцы содержат конкретные признаки или переменные. На пересечении столбцов и строк формируются ячейки, выступающие минимальными единицами хранения информации. Успешный анализ требует одинакового количества элементов в каждой строке для формирования симметричной матрицы.
Инструмент поддерживает работу с текстовыми источниками в нескольких стандартизированных форматах. Выбор формата задает алгоритм разбора текста на табличные компоненты:
- CSV: значения разделяются запятыми или точками с запятой, а каждая новая строка исходника становится строкой датафрейма.
- JSON: данные представлены в виде массивов объектов, где ключи определяют названия столбцов, а значения - содержимое ячеек.
- txt: неформатированные текстовые документы, где разделителями столбцов служат символы табуляции или пробелы.
- Структурированный текст: скопированные массивы данных, сохраняющие сеточную логику при переносе из внешних табличных редакторов.
В реальных датасетах фрагментированная информация фиксируется различными способами. Способ записи пустого значения зависит от первичной системы сбора данных, языка программирования или формата выгрузки. Инструмент ориентирован на распознавание типовых технических маркеров отсутствующих данных.
| Маркер | Техническое значение в структуре данных |
|---|---|
| Null | Базовый индикатор пустого поля, характерный для выгрузок из реляционных баз данных. |
| NaN | Стандартное обозначение отсутствующего числового значения, возникающее при ошибках вычислений или конвертации типов. |
| None | Специфический маркер отсутствующего объекта, часто встречающийся в данных, сгенерированных скриптами. |
| Пустая строка | Ячейка, не содержащая символов, образующаяся при наличии двух подряд идущих разделителей. |
Перед применением правил обработки система выполняет предварительный парсинг входного массива. Текстовый источник считывается и разбивается на отдельные элементы согласно синтаксису выбранного формата. После формирования рабочего датафрейма алгоритм сканирует содержимое каждой ячейки.
Логика идентификации строится на прямом сопоставлении. Программа проверяет ячейки на наличие маркеров Null, NaN, None или пустых пространств. Если содержимое ячейки совпадает с одним из критериев отсутствующих данных, она помечается как целевая для дальнейшего восстановления. Ячейки с корректными числовыми или текстовыми значениями игнорируются на данном этапе. Изоляция проблемных полей до начала вычислений гарантирует, что последующие операции затронут только пустые фрагменты, сохраняя исходную информацию без изменений.
Правила одиночной импутации: статистические метрики и константы
После успешной изоляции проблемных полей применяется стратегия одиночной импутации. Данный подход подразумевает расчет единственного заменяющего значения для каждого обнаруженного пропуска на основе доступной информации в рамках обрабатываемого столбца. Выбор конкретного математического правила строго зависит от типа признака: количественного или категориального. Применение статистических вычислений требует предварительного анализа структуры данных, так как некорректно подобранный алгоритм искажает распределение исходной переменной.
Импутация количественных признаков
Для непрерывных числовых переменных используются метрики центральной тенденции. Алгоритмы вычисляют итоговое значение, опираясь исключительно на валидные ячейки датафрейма, игнорируя ранее размеченные пустые пространства.
- Заполнение средним арифметическим. Вычисляется как сумма всех известных числовых значений столбца, разделенная на их количество. Данный метод применяется для непрерывных данных, имеющих симметричное распределение. Главное условие успешного использования этого правила - отсутствие сильных выбросов. Аномально высокие или низкие значения критически смещают итоговый результат, делая среднее арифметическое нерепрезентативным для основной массы данных.
- Заполнение медианой. Представляет собой вычисление значения, делящего отсортированный по возрастанию массив пополам. Если количество элементов четное, определяется среднее между двумя центральными значениями. В отличие от среднего арифметического, медиана математически устойчива к аномалиям. Правило применяется для данных с несимметричным распределением, сильными искажениями или наличием ярко выраженных экстремумов.
Обработка категориальных и дискретных данных
Текстовые поля, классы, статусы и идентификаторы не поддаются стандартным алгебраическим операциям. Для заполнения пропусков в нечисловых форматах используется частотный анализ.
Заполнение модой базируется на поиске наиболее часто встречающегося элемента в целевом столбце. Выполняется подсчет количества вхождений каждой уникальной категории, после чего значение с максимальной частотой используется для замены всех пустых ячеек в этом векторе. Данный метод применяется для номинальных переменных, а также для дискретных числовых данных, где вычисление дробных значений лишено физического или логического смысла.
Константная замена
В ряде практических сценариев статистический расчет на основе распределения не требуется, а природа пропущенных данных имеет однозначную интерпретацию. В таких случаях применяется заполнение константой, при котором все пустые ячейки заменяются фиксированным значением, одинаковым для всего столбца.
| Тип константы | Практический сценарий применения |
|---|---|
| Нулевое значение | Применяется для числовых полей, где отсутствие данных фактически означает ноль. Сценарий характерен для финансовых отчетов, данных о продажах, счетчиков транзакций или количественных метрик активности. |
| Пользовательское значение | Ввод специфической текстовой или числовой метки. Используется для явной маркировки отсутствующей информации без попытки ее угадать, например, путем вставки категориальных маркеров Отсутствует или Неизвестно. |
Использование констант позволяет сохранить размерность массива данных, не внося дополнительных статистических предположений о природе пропусков. Применение этого правила требует уверенности в том, что выбранное значение не пересекается с реальными валидными данными датафрейма.
Восстановление пропущенных значений в последовательностях и временных рядах
При работе со структурированными последовательностями, такими как временные ряды или отсортированные журналы событий, порядок следования строк имеет критическое значение. Использование глобальных статистических метрик для таких массивов часто искажает локальную динамику данных. В подобных сценариях применяются методы, учитывающие логическую или временную близость ячеек.
Методы переноса соседних наблюдений
Базовый подход к заполнению пропусков в упорядоченных данных заключается в копировании существующего значения из смежной строки. Данная логика базируется на допущении, что состояние наблюдаемого объекта или метрики оставалось неизменным в период отсутствия фиксации данных.
- Метод LOCF и операция ffill предполагают перенос последнего известного значения вперед по оси строк. Значение из ячейки, предшествующей началу пропуска, дублируется во все последующие пустые поля вплоть до появления новых валидных данных.
- Метод NOCB и операция bfill работают в обратном направлении, осуществляя перенос следующего известного значения назад. Первое валидное значение, зафиксированное после интервала с пропусками, используется для заполнения предшествующих пустых ячеек.
Эти операции эффективны для данных, имеющих ступенчатый характер изменений. Практический сценарий применения включает обработку показаний метрик, фиксируемых только в момент изменения состояния, или финансовых реестров, где баланс остается статичным до проведения следующей транзакции.
Линейная интерполяция
Для непрерывных данных, подверженных постепенным изменениям и формирующих тренды, простое копирование соседних значений приводит к появлению неестественных плоских участков на графиках распределения. В таких ситуациях применяется линейная интерполяция.
Базовый принцип линейной интерполяции заключается в аппроксимации пропущенных значений между двумя известными точками на основе линейной функции. Вычисление определяет разницу между последним известным значением до пропуска и первым известным значением после него. Затем рассчитываются промежуточные значения с допущением постоянной скорости изменения на данном отрезке.
| Характер исходных данных | Метод восстановления | Практический сценарий |
|---|---|---|
| Дискретные состояния, триггеры | LOCF или NOCB | Статусы подписок, уровни складских запасов, фиксация сетевых инцидентов |
| Непрерывные числовые значения | Линейная интерполяция | Метеорологические графики, биржевые котировки, датчики физических величин |
Применение интерполяции позволяет сохранить направление тренда внутри заполняемого интервала и обеспечивает плавный математический переход между фактическими наблюдениями. Это обеспечивает корректность последующего анализа данных с выраженной временно́й зависимостью.
Альтернативная стратегия: удаление строк (Listwise Deletion)
Заполнение пустых ячеек расчетными значениями не является единственным методом обработки структурированных датасетов. Альтернативным подходом выступает Complete-case Analysis, технически часто обозначаемый как операция dropna. Данный метод исключает из исходного набора данных любые строки, содержащие хотя бы одно пустое поле. В результате формируется усеченный датафрейм, состоящий исключительно из полных записей.
Применение удаления строк математически оправдано при соблюдении строгих статистических условий. Ключевым критерием является природа пропусков, классифицируемая как MCAR. Это означает, что отсутствие данных является абсолютно случайным событием, не зависящим от других наблюдаемых или ненаблюдаемых переменных в наборе. Если вероятность появления пустой ячейки одинакова для всех записей, удаление таких строк не приведет к искажению внутренних взаимосвязей в данных.
Вторым важным условием выступает объем исключаемой информации. На практике метод Complete-case Analysis применяется, когда доля строк с пропусками составляет незначительный процент от общей выборки. Массовое отбрасывание записей при высокой концентрации пустых ячеек приводит к критической потере статистической мощности исходного набора.
Выбор между удалением неполных записей и процедурой импутации базируется на оценке их влияния на структуру выходного набора данных.
| Характеристика набора данных | Стратегия удаления (Complete-case Analysis) | Стратегия заполнения (Imputation) |
|---|---|---|
| Объем итоговой выборки | Сокращается пропорционально количеству строк, содержащих пропуски | Сохраняется равным исходному набору данных без потери строк |
| Репрезентативность при случайных пропусках (MCAR) | Сохраняется, распределение переменных остается естественным | Сохраняется при условии корректного выбора константы или математической метрики |
| Репрезентативность при неслучайных пропусках | Нарушается, возникает систематическое смещение выборки из-за потери специфических сегментов | Позволяет частично компенсировать смещение за счет восстановления значений на основе существующих трендов |
Удаление строк представляет собой прямолинейную стратегию очистки таблиц, применимую при минимальном количестве случайных пропусков. Если природа отсутствующих значений имеет скрытую закономерность, отбрасывание неполных записей сделает итоговую выборку нерепрезентативной. В ситуациях, когда каждая строка представляет высокую ценность для анализа, а пропуски носят систематический характер, приоритет отдается методам восстановления значений.
Влияние импутации на статистические свойства выборки
Любое математическое вмешательство в структуру набора данных изменяет его исходные характеристики. Процедура импутации, позволяя избежать потери строк, неизбежно трансформирует распределение признаков. Понимание этих изменений необходимо для корректной оценки качества данных и предотвращения искажений в результатах.
Заполнение пустых полей средним арифметическим или фиксированной константой оказывает прямое воздействие на дисперсию и стандартное отклонение. Поскольку в выборку добавляются абсолютно идентичные значения, лишенные естественной изменчивости, математический разброс данных относительно центральной оси сокращается. Чем выше доля ячеек, восстановленных с помощью одной метрики, тем сильнее искусственное занижение общей вариации признака.
Массовое применение одиночной импутации формирует неестественные пики концентрации значений. Степень изменения мер центральной тенденции напрямую зависит от используемого алгоритма расчета.
| Метод одиночной импутации | Влияние на дисперсию и стандартное отклонение | Влияние на центральную тенденцию |
|---|---|---|
| Среднее арифметическое | Сильное искусственное занижение вариации | Сохраняет исходное среднее, но искажает медиану и квартили |
| Медиана | Снижение разброса, формирование резкого пика в центре распределения | Сохраняет медиану, смещает среднее арифметическое |
| Заданная константа | Искажение исходной формы распределения, создание искусственного кластера | Глобальное смещение всех метрик в сторону выбранной константы |
Помимо изменения параметров разброса, одиночная импутация несет риск возникновения систематической ошибки. Если отсутствие информации в ячейках обусловлено скрытыми факторами, подстановка усредненных или константных показателей маскирует реальные закономерности. В таких случаях возникает критическое смещение оценок, при котором восстановленный набор данных перестает отражать объективную физическую или бизнес-модель.
Для обеспечения надежности аналитических выводов процедура подготовки структурированных таблиц должна удовлетворять строгим критериям. Успешное выполнение операций по восстановлению ячеек характеризуется следующими показателями качества выходного датафрейма:
- Сохранение базовой формы статистического распределения для непрерывных количественных переменных.
- Минимизация искусственного сужения дисперсии при обработке столбцов с высокой долей пустых полей.
- Строгое соответствие выбранной метрики типу данных исходного столбца.
- Отсутствие систематического смещения мер центральной тенденции за пределы допустимой аналитической погрешности.
- Ограничение доли константных замен для предотвращения эффекта переобучения при последующем использовании данных в предиктивных моделях.