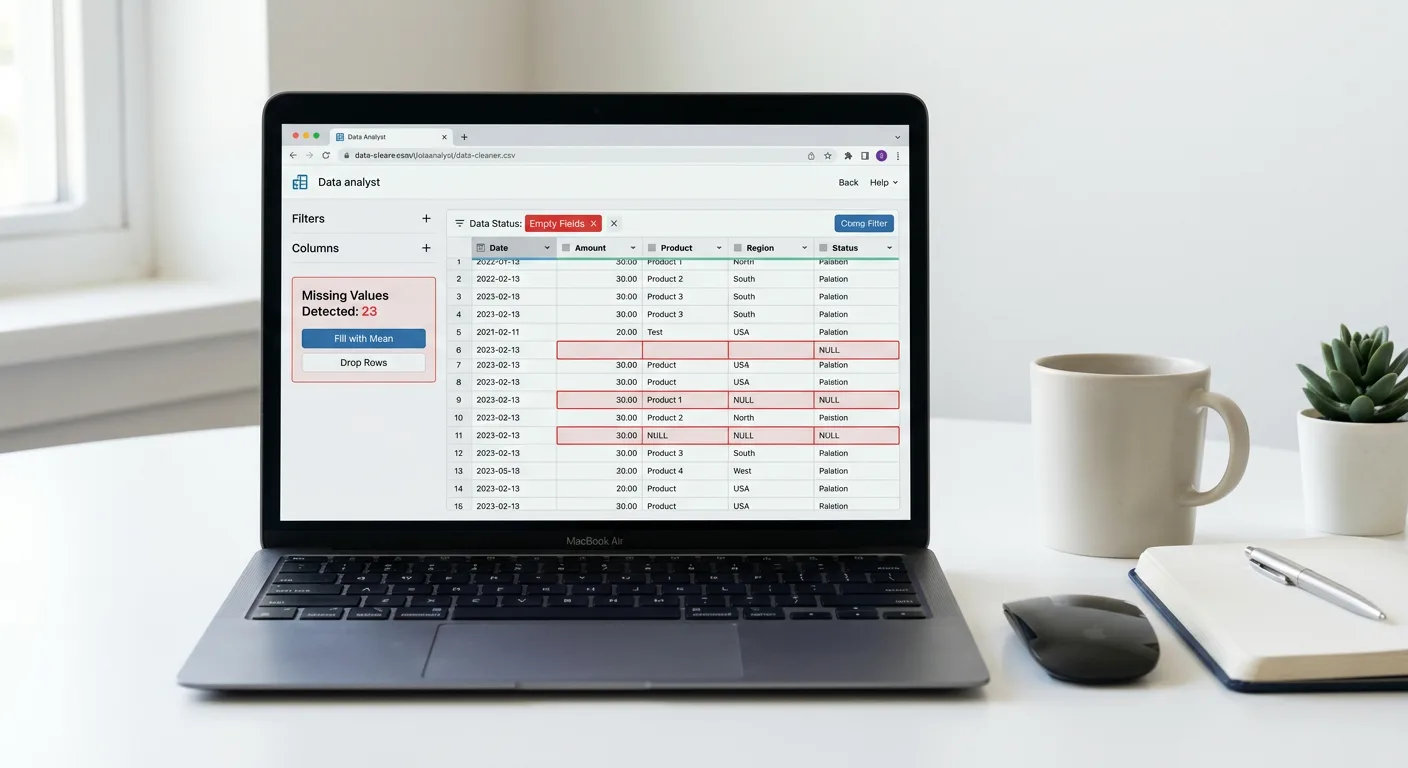
Выявление пустых полей в наборе данных - это первый технический шаг в процедуре контроля качества информации. Инструмент Qivrora сканирует загруженные массивы и локализует пропущенные значения. Анализ структурной целостности файлов форматов CSV, JSON или XLSX предотвращает алгоритмические ошибки на последующих этапах. Точная фиксация пустых ячеек показывает реальную пригодность массива для дальнейших вычислений.
Основная цель инструмента заключается в изолированном поиске незаполненных элементов, которые технически классифицируются как missing values. Данная процедура формирует функциональный базис data cleaning. Алгоритм последовательно проходит по всем переменным датасета, выявляя узлы без присвоенных значений. Программная проверка находит системные пустоты, которые часто остаются незамеченными при визуальном осмотре таблиц. Пользователь получает сводку с точными координатами всех найденных пустот.
Точная локализация пропусков строго необходима перед запуском аналитического процессинга. Игнорирование этапа предварительной проверки неизбежно ведет к математическим искажениям и падению скриптов при построении моделей.
Природа пропущенных значений: NaN, Null и пустые элементы
Пропущенные значения в контексте обработки датафреймов представляют собой ячейки или узлы данных, в которых отсутствует ожидаемая информация. В терминологии анализа данных это состояние классифицируется как unobserved data. Подобные элементы возникают на этапе сбора, передачи или конвертации массивов, формируя пробелы в структурной сетке таблицы.
В зависимости от исходного формата файла и программной среды отсутствующие данные принимают различные технические эквиваленты. Аналитические системы распознают несколько стандартных маркеров пустоты, которые фиксируются при первичном сканировании массива.
- NaN: Стандартный маркер для обозначения отсутствующих или неопределенных чисел с плавающей точкой в вычислительных массивах.
- Null: Индикатор отсутствия значения или объекта, характерный для реляционных баз данных и иерархических структур JSON.
- #N/A: Специфический маркер электронных таблиц, указывающий на недоступность данных для конкретной ячейки.
Фундаментальное правило предварительной работы с данными заключается в строгом разделении фактического отсутствия информации и специфических значений переменных. Смешивание этих состояний искажает саму структуру массива на аппаратном уровне.
| Состояние данных | Техническое описание | Статус в наборе данных |
|---|---|---|
| Пустой элемент | Отсутствие записанного значения (unobserved data) | Неопределенность, требующая локализации и обработки |
| Нулевое значение (0) | Специфическое число в пределах числовой переменной | Валидная точка данных, результат реального измерения |
| Пустая строка | Строковый объект нулевой длины | Заполненный текстовый атрибут, занимающий ячейку |
Характер представления пропусков напрямую зависит от архитектуры набора данных. В многомерном датасете пропуски выглядят как локальные разрывы в пересечениях строк и столбцов. В такой табличной матрице может отсутствовать один конкретный атрибут записи, при этом остальные переменные для данной строки остаются полностью заполненными и функциональными.
В структуре одномерного временного ряда пропущенное значение имеет иную природу. Здесь пустой элемент представляет собой разрыв непрерывности на хронологической оси. Отсутствующая точка данных означает пропуск фиксации сигнала в конкретный момент времени, что нарушает эквидистантность интервалов между последовательными наблюдениями.
Логика и метрики обнаружения пустых ячеек
Процесс локализации отсутствующих данных базируется на применении булевой логики к матрице набора данных. Каждая ячейка массива проверяется на соответствие условию отсутствия валидного значения. В результате этой операции исходный набор данных концептуально проецируется на бинарную маску, где каждый элемент принимает значение истинности: позиция либо пуста, либо содержит записанные данные.
Математический аппарат выявления опирается на логические предикаты, действующие по принципу алгоритмов isna, isnull и notnull. Условия isna и isnull возвращают положительный результат для ячеек, не содержащих информации, маркируя их как пропуски. Обратное условие notnull применяется для подтверждения наличия фактических точек данных.
Применение таких логических условий позволяет фильтровать строки датасета и маршрутизировать дальнейшие проверки. Наложение булевой маски изолирует точки данных с отсутствующими значениями от общей массы наблюдений. Это дает возможность извлекать конкретные срезы массива, содержащие дефекты заполнения. Фильтрация по столбцам показывает переменные с нарушенной целостностью, а фильтрация по строкам выявляет конкретные записи, где произошел сбой фиксации признака.
Количественные показатели оценки пропусков
После покомпонентной проверки массива логическими операторами результаты агрегируются. Для оценки масштаба проблемы и принятия решений о пригодности массива к работе используются стандартизированные метрики выявления.
- Абсолютное количество пропусков. Сумма всех пустых ячеек в пределах отдельной переменной или конкретной записи. Данный показатель демонстрирует точный физический объем потерянных наблюдений и служит базовым индикатором качества сбора данных для конкретного атрибута.
- Процент пропущенных значений. Отношение абсолютного количества пропусков к общему объему данных в рассматриваемом векторе. Вычисляется делением числа пустых элементов на общую длину вектора наблюдений. Показатель стандартизирует оценку и позволяет напрямую сравнивать степень поврежденности различных переменных, независимо от их изначальной размерности.
- Non-Null Count. Количество ячеек, содержащих фактически записанные точки данных. Вычисляется как разность между общей размерностью вектора и абсолютным количеством обнаруженных пропусков. Метрика определяет реальный объем полезной информации, который остается доступным после изоляции пустых полей.
Комплексный расчет данных метрик дает точную топологию распределения пустот в матрице. Анализ абсолютных и относительных показателей по каждой оси набора данных позволяет точно определить зоны максимальной концентрации пропусков перед переходом к анализу причин их возникновения.
Механизмы возникновения пропусков: MCAR, MAR и MNAR
Локализация пустых ячеек и расчет количественных метрик формируют точное представление о масштабе потерь в матрице данных. Следующий аналитический этап заключается в определении логики распределения пустот. В статистике и анализе данных выделяют три фундаментальных механизма, описывающих природу возникновения пропущенных значений. Понимание этих механизмов необходимо для оценки структурной целостности собранного массива.
Полностью случайные пропуски
Механизм MCAR предполагает, что вероятность отсутствия значения в конкретной ячейке не зависит ни от наблюдаемых переменных в наборе данных, ни от самого пропущенного значения. Потеря информации происходит абсолютно хаотично и равномерно по всей выборке.
Типичным практическим сценарием является аппаратный сбой. Например, при записи логов телеметрии происходит кратковременный обрыв сетевого соединения, из-за чего часть показателей не поступает в базу. Факт отсутствия записи никак не связан с тем, какие именно значения фиксировались в этот момент. При механизме MCAR оставшаяся часть массива сохраняет свойства исходной репрезентативной выборки, так как данные пропадают независимо от контекста наблюдений.
Случайные пропуски
При механизме MAR вероятность появления пустой ячейки обусловлена значениями других, уже известных и заполненных атрибутов в наборе данных, но не зависит от самого скрытого показателя. Распределение пропусков подчиняется определенному паттерну, который можно математически или логически объяснить через смежные векторы матрицы.
Подобная ситуация часто возникает при сборе демографической информации или анкетировании. Респонденты определенной возрастной категории могут систематически оставлять пустым поле с вопросом о технических характеристиках используемого программного обеспечения. В данном случае вероятность образования пустого поля зависит от известной переменной, но не зависит от фактического ответа, который должен был быть записан. Выявление паттернов MAR позволяет прогнозировать структуру отсутствующих данных на основе корреляций с заполненными столбцами.
Неслучайные пропуски
Механизм MNAR представляет собой наиболее сложный тип повреждения матрицы. Он возникает в ситуациях, когда вероятность появления пустого поля напрямую зависит от значения, которое должно было находиться в этой ячейке.
На практике это выражается в систематическом отсутствии данных на границах диапазонов. Например, датчики с ограниченным пределом измерений могут возвращать пустые элементы при фиксации критически высоких нагрузок, выходящих за рамки их калибровки. В результате из массива исключаются именно экстремальные значения. Подобное распределение пропусков радикально искажает описательную статистику отдельной переменной и делает выборку смещенной.
Влияние механизмов на data wrangling
Обнаружение пустых полей является технической процедурой изоляции проблемных участков массива. Однако именно определение механизма пропусков на основе полученной топологии диктует легитимность применения конкретных методов в рамках последующего data wrangling.
Обоснованность дальнейших аналитических манипуляций полностью опирается на природу потерянных данных. Если анализ распределения подтверждает паттерн MCAR, это служит математическим обоснованием для применения базовых алгоритмов трансформации массива без риска критических искажений. Выявление структуры MAR требует обязательного учета взаимосвязей между векторами при расчетах. Обнаружение признаков MNAR сигнализирует о фундаментальном смещении данных, при котором стандартные процедуры процессинга приведут к генерации ошибочных аналитических выводов. Точная квалификация выявленных пустот выступает обязательным критерием выбора стратегий подготовки датафрейма.
Влияние невыявленных пропусков на аналитический конвейер
Процедура контроля качества данных выступает обязательным барьером между сырым массивом и этапом построения аналитических моделей. Интеграция неочищенного датафрейма с пропущенными значениями в конвейер обработки приводит к каскадным математическим ошибкам. Если пустые ячейки остаются невыявленными, алгоритмы либо прерывают выполнение вычислений из-за конфликта форматов, либо некорректно интерпретируют неявные пропуски как фактические показатели.
Наличие скрытых пустых полей при процессинге провоцирует следующие аналитические риски:
- Смещение параметров. Возникает при неравномерном распределении пустот относительно целевых переменных. Вычислительные модели усваивают ложные закономерности, формируя математически смещенный результат.
- Искажение описательной статистики. Невыявленные пропуски напрямую влияют на расчет мер центральной тенденции. Отсутствующие элементы искусственно сдвигают средние значения и медианы, а также нарушают расчет дисперсии и ковариационных связей.
- Потеря репрезентативности выборки. Систематическое отсутствие данных в определенных кластерах наблюдений приводит к тому, что рабочий массив перестает отражать реальную структуру генеральной совокупности.
Скрытые пустые элементы создают условия для потенциальной утечки данных при построении прогнозных систем. Данная структурная ошибка возникает, когда метрики распределения пропусков неявно используются алгоритмами на ранних этапах процессинга, до корректного разделения датафрейма на изолированные сегменты. Глобальная информация о пустых ячейках проникает в тренировочные наборы, что вызывает чрезмерно оптимистичную оценку качества модели и неизбежную деградацию вычислений при работе с новыми потоками данных.
Первичный этап выявления и точной локализации пропусков строго необходим для изоляции проблемных участков до начала любых математических трансформаций. Понимание полной топологии пустых ячеек гарантирует, что конвейер аналитики опирается на корректную базу, предотвращая генерацию технически успешного, но статистически недействительного результата.
Стратегии обработки после выявления отсутствующих данных
Точная локализация пустых ячеек завершает этап первичной диагностики набора данных. Инструмент выполняет исключительно выявление, фильтрацию и подсчет пропусков, не внося изменений в исходный массив информации. Процессы удаления строк или математического заполнения пустот не осуществляются на этапе обнаружения. Полученная топология распределения отсутствующих значений служит аналитической базой для выбора теоретической стратегии дальнейшего процессинга.
После идентификации проблемных участков аналитический конвейер требует применения методов очистки или восстановления. Выбор конкретного подхода базируется на общем проценте пустых полей, их расположении и выявленном механизме возникновения пропусков. Концептуально последующие действия разделяются на стратегии удаления и стратегии импутации.
Методы удаления пропусков
Исключение неполных наблюдений применяется преимущественно в ситуациях, когда объем пустых элементов минимален, а их распределение не носит систематического характера. Данный подход направлен на работу с абсолютно чистой матрицей данных, но требует осторожности из-за риска потери информации.
- Complete case analysis. Метод, также известный как listwise deletion, подразумевает полное исключение из датафрейма любой строки, содержащей хотя бы одну пустую ячейку. Подход гарантирует, что дальнейшие вычисления проводятся только на полностью наблюдаемых данных, однако в многомерных массивах это может привести к критическому сокращению общего объема выборки.
- Удаление столбцов. Стратегия применяется к отдельным переменным, в которых концентрация пропусков превышает допустимый порог, делая признак неинформативным. Полное исключение столбца позволяет сохранить строки для анализа оставшихся, более качественных переменных.
Методы восстановления данных
Импутация представляет собой процесс логического или математического синтезирования значений для замены пустых ячеек. Стратегия направлена на сохранение исходного размера выборки и предотвращение статистических искажений, которые возникают при массовом удалении наблюдений.
- Заполнение средним арифметическим. Базовый метод импутации числовых переменных, при котором пустое поле заменяется мерой центральной тенденции, рассчитанной по доступным значениям столбца. Подход технически прост, но искусственно занижает дисперсию переменной.
- LOCF. Специфический алгоритм для анализа одномерных временных рядов, переносящий последнее известное наблюдение на позицию последующей пустой ячейки. Метод эффективен при обработке последовательностей с низкой волатильностью, где текущее состояние сильно зависит от предыдущего.
- Множественная импутация. Продвинутый статистический процесс, генерирующий несколько вероятных вариантов заполненного набора данных. Алгоритм опирается на ковариационные связи между всеми переменными датафрейма, учитывая математическую неопределенность отсутствующих элементов и минимизируя смещение результатов.
Противопоставление двух глобальных подходов требует оценки рисков для каждой конкретной выборки после завершения работы инструмента по поиску пропусков.
| Стратегия обработки | Ключевое преимущество | Основной аналитический риск | Теоретическое применение |
|---|---|---|---|
| Listwise deletion | Отсутствие синтетических данных и искажений оригинальных значений | Резкое снижение статистической мощности из-за потери строк | Доля пустых ячеек незначительна, пропуски носят случайный характер |
| Удаление столбцов | Изоляция массива от признаков с критическим дефицитом информации | Потеря потенциально важных предикторов для вычислительных моделей | Переменная содержит подавляющее большинство незаполненных элементов |
| Базовая импутация | Полное сохранение объема выборки для дальнейших вычислений | Искусственное изменение метрик распределения и снижение дисперсии | Малый процент пропусков в числовых переменных со стабильным распределением |
| Множественная импутация | Сохранение структуры взаимосвязей между переменными датафрейма | Высокая вычислительная сложность последующей обработки | Значительный объем пропусков, требующий точной статистической коррекции |