Очистка CSV от повторяющихся строк представляет собой операцию нормализации данных, направленную на удаление идентичных записей из табличных массивов. Инструмент принимает на вход файл формата CSV со структурированным текстовым содержимым. Алгоритм последовательно обрабатывает информацию на уровне целых строк. На выходе формируется очищенный набор данных. Он содержит исключительно уникальные записи.
Наличие одинаковых строк часто возникает при слиянии нескольких таблиц или сбоях экспорта. Избыточность напрямую искажает метрики и вызывает ошибки при импорте таблиц в базы данных. Дедупликация решает эту проблему. Программа сканирует текстовый массив и отсекает все выявляемые повторы.
Результатом работы является чистый файл. Устранение избыточности обеспечивает корректную загрузку данных в CRM и снижает нагрузку на системы последующей программной обработки.
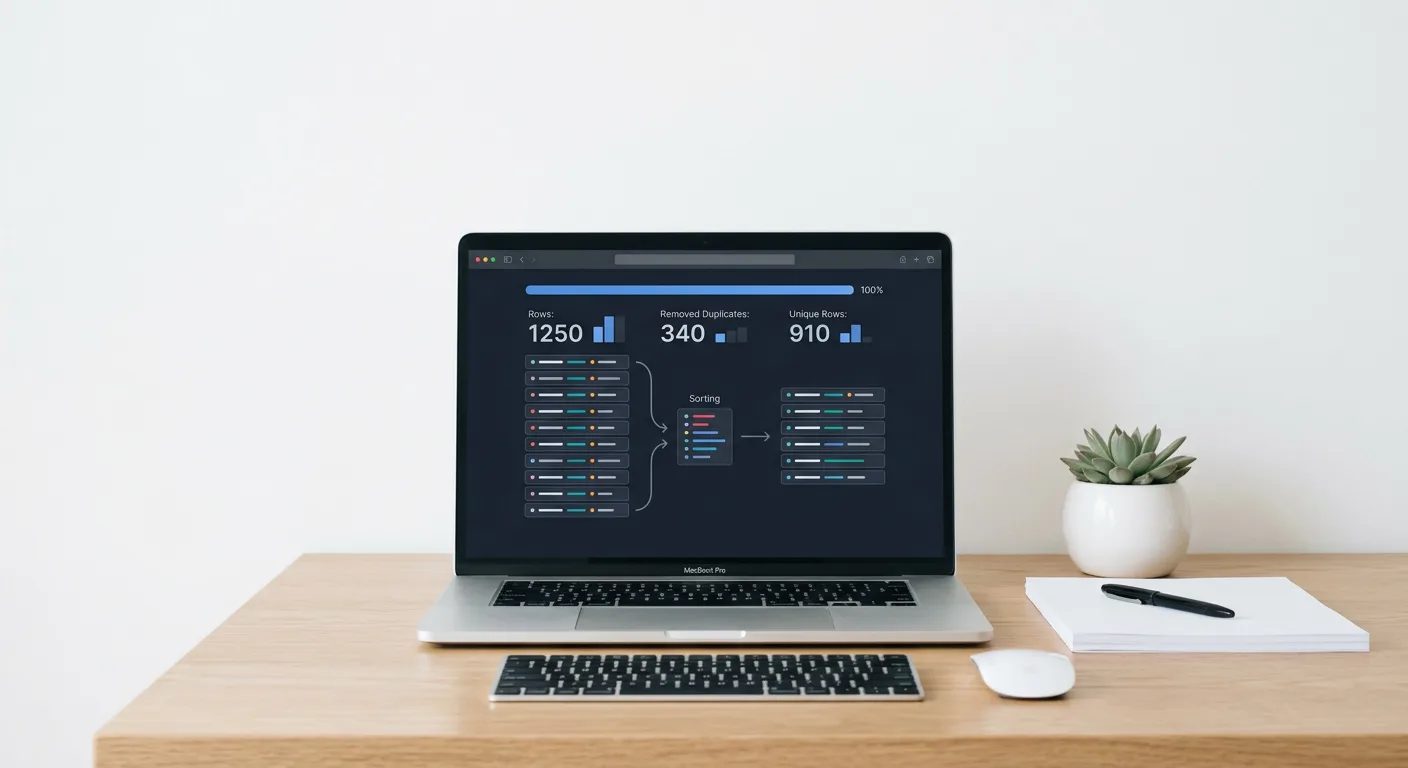
Логика точного совпадения (Exact Matching) при дедупликации
Процесс выявления повторяющихся записей базируется на анализе целых строк. Сравнение происходит не по отдельным ячейкам или выбранным столбцам, а на уровне всей записи от начала до конца. При таком подходе каждая строка исходного файла обрабатывается как единая непрерывная последовательность символов.
Для определения идентичности применяется логика точного совпадения (Exact matching). Данный принцип означает, что две строки признаются дубликатами исключительно в том случае, если длина строки и каждый символ на соответствующей позиции полностью совпадают. Сравнивается вся текстовая последовательность целиком.
Обработка текстового массива осуществляется последовательно сверху вниз. Алгоритм дедупликации использует строгое правило сохранения первого вхождения для формирования очищенного результата. Процесс работает по следующему сценарию:
- При сканировании файла сверху вниз первая встреченная уникальная последовательность символов фиксируется и сохраняется в итоговый набор данных.
- При дальнейшем продвижении по массиву каждая следующая строка сравнивается с уже зафиксированными уникальными записями.
- Если текущая последовательность символов точно совпадает с одной из ранее сохраненных строк, она классифицируется как избыточная.
- Все последующие копии первоначальной записи исключаются из финального результата.
Такой механизм гарантирует, что в очищенном наборе данных останется только оригинальная строка, находящаяся выше остальных по тексту исходного документа. Применение логики первого вхождения иллюстрирует следующая таблица:
| Порядок обработки в массиве | Анализируемая строка | Результат дедупликации |
|---|---|---|
| Строка 1 | ID01,ItemA,100 | Сохраняется (первое вхождение уникальной записи) |
| Строка 2 | ID02,ItemB,200 | Сохраняется (первое вхождение новой уникальной записи) |
| Строка 3 | ID01,ItemA,100 | Исключается (точное совпадение со Строкой 1) |
| Строка 4 | ID01,ItemA,100 | Исключается (точное совпадение со Строкой 1) |
В результате последовательного применения правила Exact matching финальный набор содержит оригинальную структуру данных, полностью избавленную от последующих точных повторений.
Специфика обработки формата CSV и стандарта RFC 4180
Для корректного удаления повторяющихся записей необходимо безошибочно определять границы каждой строки в текстовом массиве. Формат CSV базируется на спецификации RFC 4180, которая устанавливает строгие правила структурирования и интерпретации данных. Согласно этому стандарту, текстовый документ не просто делится по техническим символам окончания строки, а требует синтаксического анализа для точного отделения реальных границ записей от внутреннего содержимого ячеек.
Ключевая сложность при чтении массивов заключается в обработке экранированных символов переноса. Текстовое значение внутри отдельной ячейки может содержать собственный перенос на новую строку. Стандарт предписывает заключать такие проблемные блоки данных в двойные кавычки. При чтении файла последовательность символов между парными кавычками воспринимается как единый элемент массива, игнорируя любые технические переносы внутри него. Если алгоритм чтения игнорирует это правило, многострочная ячейка неконтролируемо дробится на несколько самостоятельных строк. В результате нарушается структурная целостность данных, а дедупликация приводит к ошибочным результатам, так как разорванные фрагменты не могут совпасть с оригинальными записями.
Чтение структурированных текстовых файлов сопровождается учетом ряда базовых технических параметров, от которых зависит правильное извлечение строк перед их сравнением:
- Кодировка текстового документа. Стандартом для обмена данными выступает UTF-8. Важным аспектом является наличие или отсутствие сигнатуры BOM. Если маркер последовательности байтов не учитывается при чтении, первая строка файла получает скрытый префикс, что делает ее визуально идентичной, но технически отличной от последующих дубликатов.
- Символ-разделитель колонок. Символ определяет границы ячеек внутри одной строки. Классическая спецификация подразумевает использование запятой, однако многие региональные настройки экспорта применяют точку с запятой во избежание конфликтов с десятичными дробями в числах.
- Структура файлов TSV. Данный формат является прямым производным от CSV, где в качестве разделителя значений применяется символ табуляции. Логика определения границ строк, экранирования кавычками и интерпретации данных остается полностью аналогичной стандарту RFC 4180.
Строгое соблюдение спецификации формата гарантирует, что на этап посимвольного сравнения поступят математически точные последовательности символов, представляющие собой целые, неискаженные строки из исходного документа.
Влияние артефактов данных на результаты сравнения строк
Даже при корректном чтении файла согласно спецификации исходная информация внутри ячеек часто содержит технические аномалии. Поскольку алгоритм сопоставляет последовательности символов побайтово, строки, которые визуально кажутся абсолютно идентичными, могут распознаваться как уникальные записи. Такое расхождение возникает из-за присутствия скрытых артефактов в текстовом массиве.
На математическую точность сравнения целых строк напрямую влияют следующие факторы:
- Разница в регистре. Вычислительные системы воспринимают заглавные и строчные буквы как разные символы с уникальными числовыми кодами. Строка, содержащая значение в верхнем регистре, не совпадет с аналогичным текстом, записанным в нижнем регистре.
- Лишние пробелы. Наличие пробела в начале или в конце текстового значения меняет общую длину и состав строки. Человеческий глаз при беглом просмотре игнорирует отступ перед текстом, но при строгом алгоритмическом сравнении это критическое отличие.
- Невидимые символы (invisible chars). При экспорте баз данных или копировании информации из внешних систем в текст часто попадают специфические элементы форматирования. Распространенным примером выступает неразрывный пробел NBSP, который на экране выглядит как обычный интервал между словами, но имеет совершенно другой машинный код.
- Пустые строки. Строка без пользовательских данных технически представляет собой последовательность разделителей. Если в исходном документе присутствует несколько пустых строк, они будут интерпретироваться как дубликаты одной пустой записи.
Наличие скрытых артефактов требует проведения процедур предварительной гигиены данных (data hygiene). Приведение всех значений к единому регистру, отсечение лишних пробелов по краям ячеек и очистка от невидимых символов гарантируют, что визуально одинаковые записи станут технически идентичными. Только после нормализации исходного массива дедупликация может обеспечить стопроцентную точность выявления повторяющихся строк.
Практические сценарии применения очищенных наборов данных
Исключение идентичных записей из исходного массива решает проблему избыточности информации при анализе и переносе данных между системами. Готовый набор уникальных строк применяется в следующих прикладных задачах:
- Консолидация баз данных CRM. При слиянии информации из нескольких источников часто возникают пересекающиеся записи. Очистка документа от повторяющихся строк перед импортом предотвращает создание дублирующих профилей клиентов, исключает путаницу в истории коммуникаций и гарантирует корректность аналитики продаж.
- Фильтрация email-списков для рассылок. Подготовка базы контактов требует оставления только уникальных адресов. Использование очищенного списка позволяет избежать отправки идентичных писем одному и тому же адресату, защищает почтовый домен от санкций спам-фильтров и повышает точность расчета метрик открываемости.
- Нормализация каталогов товаров. При агрегации ассортимента от разных поставщиков в единый файл неизбежно появляются одинаковые позиции. Удаление повторяющихся артикулов и SKU формирует корректную структуру базы данных. Загрузка нормализованного массива предотвращает появление дубликатов карточек товаров на витрине и ошибки при учете складских остатков.
- Обработка массивов SEO-ключевых слов. Сбор семантики из разных аналитических платформ генерирует списки поисковых запросов с высокой степенью пересечения. Дедупликация таких массивов перед экспортом и дальнейшим анализом сокращает физический объем документа. Работа исключительно с уникальным списком фраз ускоряет процесс кластеризации и снижает расход лимитов в сторонних сервисах мониторинга позиций.