Автоматическая очистка списка от повторяющихся строк выполняет прямую трансформацию исходного текстового массива в перечень уникальных элементов. Инструмент удаляет все идентичные совпадения. В результате остается только чистый набор данных.
В качестве входных данных система принимает готовые списки и сплошной текст с переносами. Перенос строки выступает обязательным разделителем. Именно он формирует границы отдельных элементов при загрузке массива.
Выходной результат представляет собой готовый строковый массив, полностью очищенный от дублирующихся записей. Формируется компактный перечень. Его можно копировать или сохранять в форматы CSV и XLSX для последующего использования в базах данных или передачи через API.
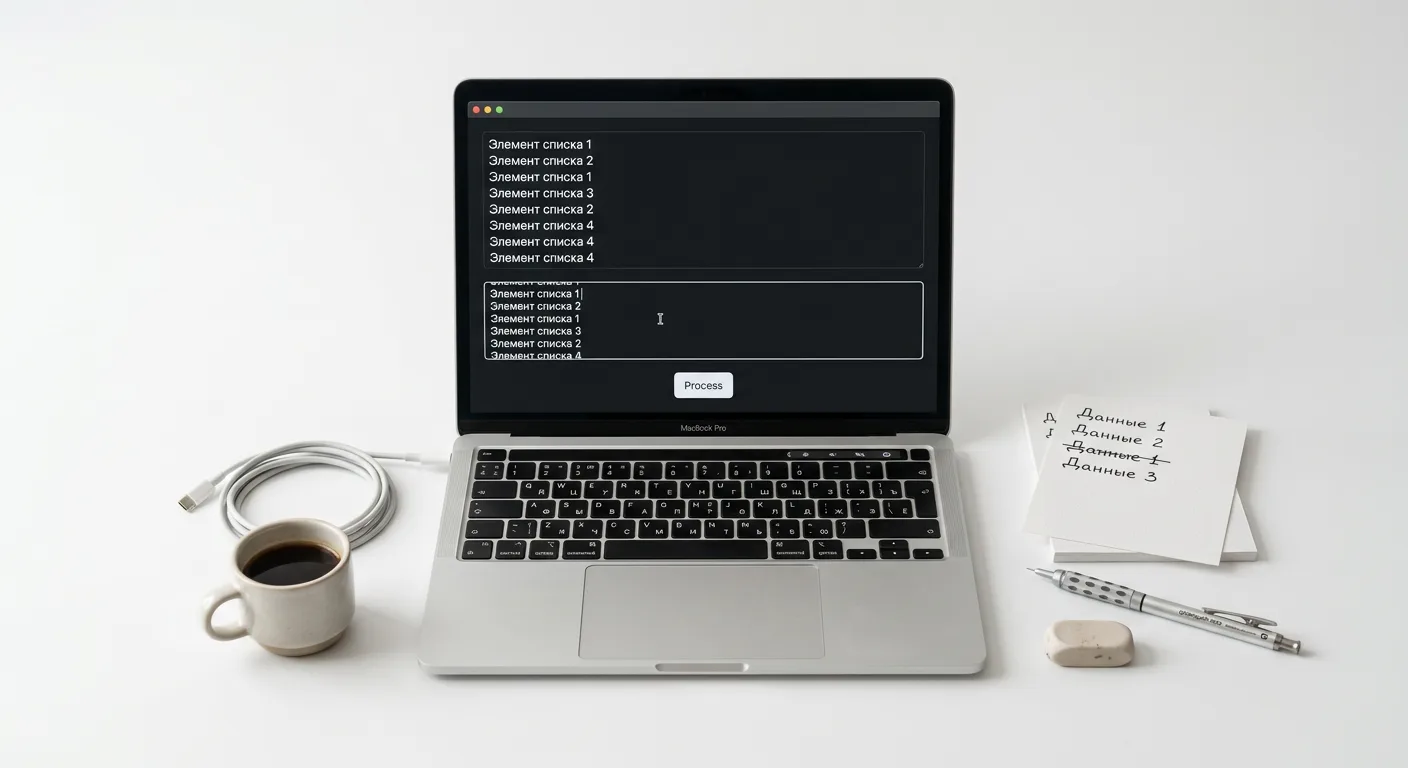
Принцип работы алгоритма посимвольного сравнения и дедупликации
Процесс обработки массива данных начинается с разделения введенного текста на независимые элементы. Основным разделителем выступает символ переноса строки. При анализе входных данных каждый перенос фиксируется как жесткая граница, которая отделяет одну запись от другой. Благодаря этому сплошной текст трансформируется в одномерный строковый массив, где каждая отдельная строка становится самостоятельной единицей для дальнейших вычислений.
После преобразования текста в массив запускается механизм выявления дубликатов, работающий на базе алгоритма посимвольного сравнения. Для установления идентичности двух элементов выполняется их последовательная машинная сверка.
Алгоритм фиксирует точное совпадение только при выполнении следующих условий:
- Равенство общей длины сравниваемых строк.
- Идентичность каждого отдельного символа в проверяемой последовательности.
- Полное совпадение порядка расположения символов от начала до конца строки.
Если хотя бы один символ отличается, строки признаются уникальными по отношению друг к другу. При полном совпадении последовательности срабатывает правило фильтрации.
Процедура дедупликации опирается на принцип сохранения первого вхождения. Сканирование строкового массива осуществляется последовательно сверху вниз. Когда алгоритм встречает новую строку, она регистрируется и переносится в итоговый список. Каждая последующая строка сверяется с уже сохраненным перечнем. Если обнаруживается идентичная запись, текущий элемент классифицируется как дублирующий и удаляется из обработки. Таким образом, первая встреченная версия записи всегда остается нетронутой, а все последующие копии полностью отсекаются, формируя итоговый уникальный перечень.
Форматы входных данных и типы строковых массивов
Процесс выявления точных совпадений универсален и не зависит от смысловой нагрузки текста. Главным и единственным структурным требованием к исходному массиву данных является использование символа переноса строки в качестве разделителя. Каждая самостоятельная запись должна располагаться на отдельной строке. При соблюдении этого условия возможна обработка массивов, содержащих практически любые типы текстовой информации.
Поддерживаемые типы текстовых данных включают:
- Списки ключевых слов.
- Базы email-адресов.
- Списки URL.
- Артикулы (SKU).
- Идентификаторы пользователей (ID).
- Системные логи.
Вектор применения охватывает как короткие буквенно-цифровые последовательности, так и длинные составные записи. Независимо от того, состоит ли элемент из одного слова, набора цифр или сложной комбинации символов и знаков препинания, он воспринимается как единая строковая переменная от начала до символа разрыва строки.
Примеры структурной организации различных типов данных в массиве:
| Тип данных | Характер содержимого строки |
|---|---|
| Списки ключевых слов | Слова или фразы, разделенные пробелами внутри одной строки |
| Базы email-адресов | Латинские символы, цифры и обязательный знак @ без пробелов |
| Списки URL | Полные или относительные веб-адреса, включающие протокол, домен и пути |
| Артикулы (SKU) и ID | Уникальные буквенно-цифровые коды, часто с дефисами или подчеркиваниями |
| Системные логи | Длинные строки, содержащие временные метки, сетевые адреса и статусы событий |
Поскольку анализ производится строго на посимвольном уровне, формат данных внутри строки не подвергается дополнительному синтаксическому или семантическому разбору. Наличие кириллицы, латиницы, цифр или специализированных символов не нарушает механизм сравнения, при условии, что границы каждого отдельного элемента четко обозначены переносом на новую строку.
Очистка данных для SEO, контекстной рекламы и email-маркетинга
Подготовка семантического ядра требует объединения выгрузок из множества аналитических баз. На этапе агрегации в единый текстовый массив неизбежно попадают идентичные поисковые запросы. Удаление дублирующихся ключевых фраз является обязательным шагом перед загрузкой массива в инструменты кластеризации. Фильтрация повторов сокращает объем обрабатываемых данных и предотвращает появление пересекающихся кластеров при распределении запросов по посадочным страницам.
В контекстной рекламе этот же принцип применяется при работе со списками минус-слов. Рекламные платформы устанавливают строгие лимиты на количество загружаемых минус-фраз на уровне кампании. Очистка массива от дубликатов высвобождает квоты для добавления новых минус-слов, что позволяет максимально эффективно использовать ограничения системы для блокировки нецелевого трафика.
При техническом аудите или анализе ссылочных профилей формируются списки целевых URL. Очистка выгрузок необходима перед пакетной проверкой кодов состояния сервера или сбором метатегов. Наличие одинаковых адресов в исходном массиве приводит к повторному обращению парсеров к одной и той же странице. Построчная фильтрация оставляет только уникальные URL, экономя серверные ресурсы и сокращая общее время выполнения скриптов.
Для email-маркетинга дедупликация строк применяется при подготовке баз контактов к массовым рассылкам. При слиянии списков подписчиков из CRM, форм захвата и внешних баз один адрес часто попадает в итоговый массив несколько раз. Загрузка неочищенного списка в платформу рассылки приводит к техническим и репутационным проблемам.
Исключение повторных email-адресов перед импортом выполняет следующие задачи:
- Предотвращение двойных отправок писем одному пользователю.
- Снижение показателя жалоб на спам и минимизация массовых отписок.
- Сокращение расходов на тарификацию в почтовых сервисах, где стоимость зависит от объема базы или количества отправленных сообщений.
- Поддержание корректной статистики доставляемости и открываемости рассылки.
Дедупликация системных логов, идентификаторов и выгрузок из БД
Работа с массивами данных из CRM и реляционных БД требует регулярной подготовки текстовых выгрузок перед аналитикой, формированием отчетов или миграцией. При экспорте транзакционных записей часто формируются избыточные списки, содержащие дублирующиеся строки из-за особенностей сохранения информации о связанных событиях.
Фильтрация строковых массивов применяется для извлечения массива уникальных значений из сырых экспортов. Практические сценарии обработки структурных бизнес-данных включают работу со следующими параметрами:
| Тип данных | Сценарий применения очистки |
|---|---|
| Идентификаторы пользователей (ID) | Определение фактического количества уникальных клиентов в выгрузке транзакций за выбранный период, где один аккаунт может совершить множество действий. |
| Артикулы товаров (SKU) | Подготовка сводных прайс-листов, товарных матриц или инвентаризационных ведомостей при слиянии данных из нескольких складских учетных систем. |
| Номера заказов | Исключение повторений при агрегации логов служб доставки, где один заказ генерирует множественные строки при каждой смене статуса логистики. |
В контексте системного администрирования дедупликация текстовых массивов используется для первичного парсинга серверных логов. Системные журналы генерируют объемные текстовые файлы, состоящие из последовательных строк зарегистрированных событий.
Исключение дубликатов при аудите логов выполняет следующие аналитические функции:
- Фильтрация повторяющихся системных предупреждений и кодов ошибок для оценки общего спектра сбоев в инфраструктуре без привязки к частоте их возникновения.
- Формирование чистого списка уникальных IP-адресов, обращавшихся к серверу или ресурсу, для последующей настройки сетевых экранов, аудита безопасности или блокировки вредоносного трафика.
- Очистка списков эндпоинтов и системных путей при профилировании производительности приложений.
Ключевым условием для корректной фильтрации журналов является изолированное построчное расположение целевых данных. Если в исходный список загружаются полные сырые строки лога, содержащие динамические параметры (например, уникальные метки времени для каждого события), алгоритм посимвольного сравнения классифицирует такие записи как абсолютно разные.
Для успешного извлечения уникального списка IP-адресов или идентификаторов требуется, чтобы на каждой отдельной строке массива находился только сам анализируемый параметр без сопровождающей переменной информации. В таком формате посимвольная проверка корректно выявляет все точные совпадения и формирует очищенный пул уникальных значений.
Влияние регистра и невидимых символов на поиск точных совпадений
Базовый алгоритм выявления дубликатов функционирует на основе строгого посимвольного сравнения строк. Процесс анализа не учитывает семантическое значение текста, а сопоставляет последовательность символов в кодировке. Любое минимальное отклонение в структуре строки приводит к тому, что система классифицирует записи как абсолютно разные и сохраняет их в итоговом массиве.
Частой причиной появления неочевидных дубликатов становятся невидимые символы, такие как пробелы или знаки табуляции. При копировании данных из табличных редакторов, парсинге веб-страниц или выгрузке из баз данных к исходному тексту часто добавляются пробелы в начале или в конце строки. С алгоритмической точки зрения строка, оканчивающаяся пробелом, не идентична такой же строке без него. Для корректной дедупликации подобных массивов необходима предварительная очистка записей от крайних пробельных символов - операция trimming. Без отсечения невидимых символов точный поиск оставит обе вариации в очищенном списке.
Аналогичная техническая логика применяется к регистру символов. Строчные и прописные буквы имеют разные числовые идентификаторы в таблицах кодировок. Написание одного слова с заглавной и со строчной буквы делает эти две строки непересекающимися для базового алгоритма. Если в обрабатываемом списке присутствуют email-адреса, артикулы или промокоды, написанные в разных регистрах, стандартная проверка на точные совпадения не распознает их как дубликаты.
| Исходная строка | Сравниваемая строка | Результат точного сравнения | Техническая причина расхождения |
|---|---|---|---|
| user@domain.com | user@domain.com | Уникальные значения | Наличие начального пробела |
| SKU-8900 | sku-8900 | Уникальные значения | Разный регистр символов |
| report.pdf | report.pdf | Уникальные значения | Наличие конечного пробела |
Стандартное построчное сравнение предназначено исключительно для удаления точных копий. Существует фундаментальная разница между абсолютными совпадениями и нечеткими дубликатами. Нечеткие дубликаты представляют собой строки, которые имеют одинаковый смысл или относятся к одному объекту, но отличаются по своей символьной структуре.
При стандартной дедупликации не удаляются следующие типы нечетких совпадений:
- Перестановки слов в пределах одной строки, что критично при очистке поисковых запросов для SEO. Записи вида «купить телефон москва» и «москва купить телефон» воспринимаются как уникальные.
- Морфологические изменения, включающие использование других падежей, склонений, чисел или временных форм одного и того же слова.
- Пунктуационные и орфографические расхождения, такие как наличие или отсутствие дефисов, точек, запятых или случайные опечатки в словах.
Поскольку символьные последовательности в перечисленных случаях не совпадают на сто процентов, базовый алгоритм точного поиска оставляет их в финальном списке. Выявление морфологических дублей или анализ перестановок требует применения иных методов обработки текста, таких как лемматизация, стемминг или расчет расстояния Левенштейна, которые лежат за пределами задачи прямого посимвольного сопоставления строк.