Очистка набора данных от повторов подготавливает неструктурированные текстовые массивы к последующей обработке. Инструмент анализирует входящий текстовый блок, сравнивает элементы и формирует новый массив, в котором остаются только уникальные записи. Эта операция исключает избыточность информации при работе с базами контактов, логами или выгрузками товарных артикулов.
В основе работы лежит алгоритм точного сравнения. Проверяется строгое посимвольное совпадение. Дубликатом считается только абсолютная копия существующей строки.
Ключевой фактор корректной дедупликации - предварительная нормализация текста. Визуально идентичные слова технически распознаются как разные значения, если в одной строке изменена заглавная буква или добавлен невидимый пробел. Инструмент позволяет управлять чувствительностью к регистру и отсекать пустые символы по краям, чтобы избежать пропуска скрытых повторов.
Итоговый массив выводится в виде чистого списка уникальных значений. Пользователь может переопределить выходной разделитель для быстрого экспорта очищенной базы в форматы вроде CSV или XLSX. Это сохраняет нужную структуру данных для немедленного импорта в целевые таблицы.
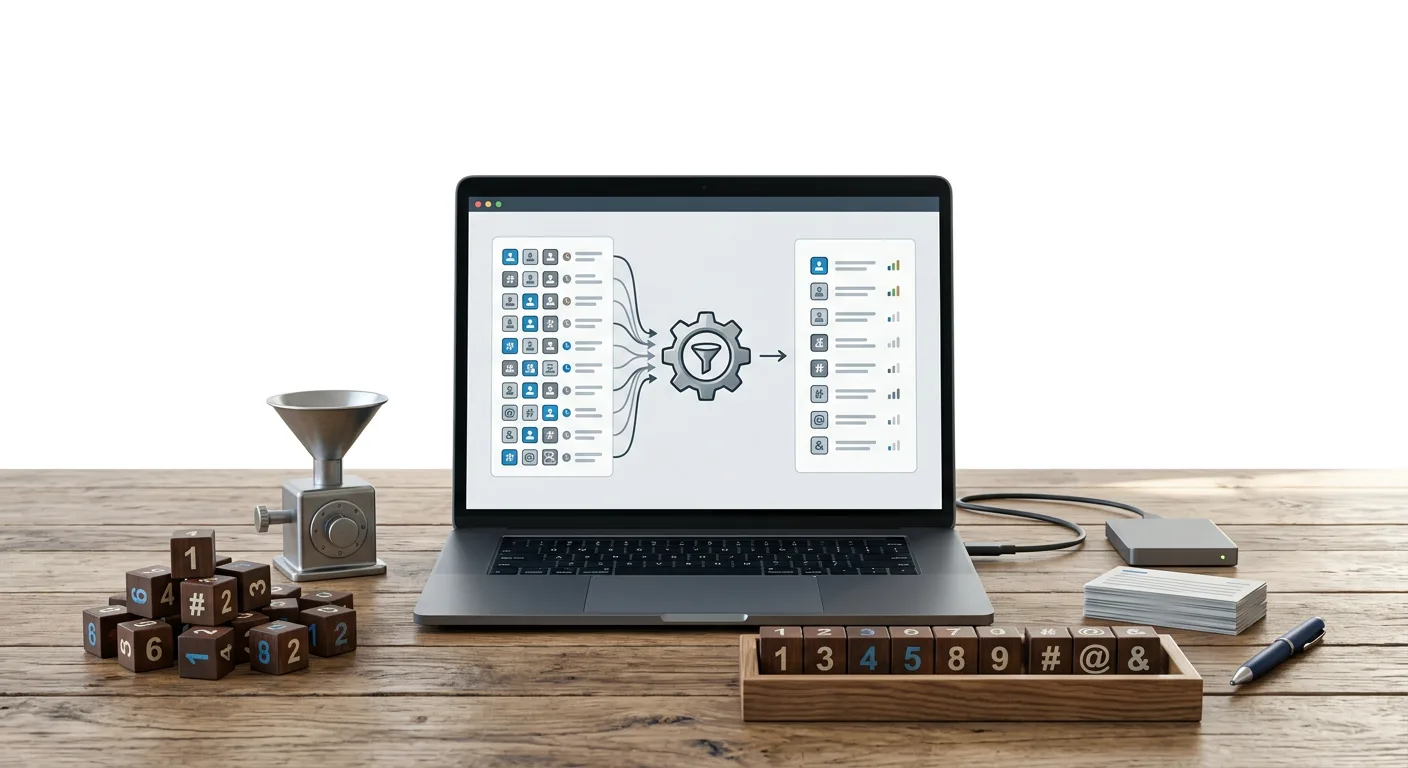
Алгоритм точного сравнения строк (Exact Matching)
Распознавание дублирующих записей базируется на математической логике строгого равенства. При использовании алгоритма точного сравнения (Exact Matching) каждая строка в массиве данных рассматривается как упорядоченная последовательность символов. Определение дубликата происходит исключительно при стопроцентном совпадении длин сравниваемых строк и идентичности каждого символа на соответствующей позиции. Любое структурное расхождение означает, что строки признаются самостоятельными значениями.
В процессе пошагового обхода массива алгоритм классифицирует каждую проверяемую запись, разделяя текстовые элементы на две категории:
- Уникальные строки - элементы, которые встречаются в обрабатываемом наборе данных впервые. Алгоритм фиксирует такую текстовую последовательность как оригинальную и сохраняет ее.
- Последовательные дубликаты - абсолютные копии ранее зафиксированной оригинальной строки, которые появляются на последующих позициях в массиве. Эти элементы классифицируются как избыточная информация и исключаются из финального списка.
Метод строгого посимвольного совпадения применяется для безопасной очистки данных без риска потерь. В вычислительной практике существуют алгоритмы нечеткого поиска (Fuzzy matching), базой для которых выступает расстояние Levenshtein. Такие математические модели оценивают степень сходства между текстами и выявляют дубликаты даже при наличии опечаток или переставленных слов. Однако для строгой дедупликации списков нечеткая логика не подходит, так как визуально схожие строки могут нести разную смысловую или системную нагрузку. Использование исключительно алгоритма Exact Matching гарантирует, что отсеивается только стопроцентная копия оригинальной записи.
Предварительная обработка и нормализация данных
Поскольку алгоритм точного сравнения требует стопроцентного совпадения всех символов, сырые текстовые массивы нуждаются в предварительной подготовке. Разное написание одних и тех же слов, случайные нажатия клавиши пробела или скрытые знаки форматирования приводят к тому, что фактически одинаковые записи распознаются машинной логикой как уникальные. Нормализация данных приводит список к единому стандарту перед запуском поиска дубликатов.
Влияние регистра символов
Буквы в верхнем и нижнем регистре имеют разные машинные коды. Логика распознавания дубликатов напрямую зависит от выбранного режима чувствительности к регистру.
| Режим обработки | Пример входных данных | Результат дедупликации |
|---|---|---|
| Учет регистра (Case-sensitive) | Value, value, VALUE | Три самостоятельные уникальные строки |
| Игнорирование регистра (Case-insensitive) | Value, value, VALUE | Одна строка (дубликаты удалены) |
Игнорирование регистра применяется, когда важна текстовая или смысловая идентичность значения вне зависимости от того, как оно было введено. Строгий учет регистра необходим при обработке системных идентификаторов, ключей или хешей, где изменение размера буквы полностью меняет суть записи.
Очистка невидимых символов и пробелов
Визуально неразличимые элементы являются наиболее частой причиной пропуска дубликатов при базовой очистке массивов. Алгоритм воспринимает строку с невидимым символом на конце как совершенно новую последовательность. Для корректной дедупликации требуется нейтрализовать следующие структурные помехи:
- Пробелы по краям строк (Trimming) - удаление обычных пробелов, случайно поставленных в начале или конце записи при ручном вводе или копировании.
- Неразрывные пробелы - символы форматирования, часто переносимые из веб-страниц или текстовых процессоров. Они выглядят как обычный отступ, но нарушают логику посимвольного совпадения.
- Символы табуляции - невидимые отступы, возникающие внутри строк при некорректном экспорте баз данных или слиянии ячеек.
- Символы переноса строк - знаки возврата каретки, которые ломают линейную структуру конкретной записи и создают ложные разрывы.
Фильтрация пустых строк
При выгрузке сырых данных часто образуются пустые строки или строки, содержащие исключительно пробелы. В процессе дедупликации множество таких строк воспринимается алгоритмом как один оригинальный пустой элемент и набор его последовательных дубликатов. Принудительная фильтрация пустых записей на этапе предварительной обработки предотвращает их попадание в цикл сравнения и исключает появление неинформативных пустот в финальном наборе данных.
Структурирование входных массивов и работа с разделителями
Для корректной идентификации дубликатов сырой массив текста должен быть правильно разделен на независимые элементы. Алгоритм точного сравнения опирается на системные разделители, чтобы определить границы каждой отдельной сущности внутри сплошного блока данных.
Принципы сегментации значений
Логика разбиения массива зависит от символа, выступающего маркером завершения одной записи и начала следующей. При подаче данных для обработки применяется несколько стандартов разделителей, которые определяют структурный каркас текстового блока:
- Перенос строки - базовая форма структурирования вертикальных списков. Каждая новая строка воспринимается как самостоятельная единица данных.
- Запятая - классический разделитель для линейных перечислений. Текст, заключенный между двумя запятыми, считывается как изолированный элемент.
- Точка с запятой - строчный разделитель, который применяется для предотвращения конфликтов сегментации в тех случаях, когда обычная запятая является неотъемлемой частью самих сравниваемых значений.
Интеграция данных из табличных процессоров
Процесс интеграции информации из файлов форматов CSV и XLSX или прямое извлечение массивов из интерфейсов Microsoft Excel и Google Таблицы подчиняется правилам текстовой конвертации. При работе с такими источниками данные транспортируются в текстовое поле через системный буфер обмена.
Копирование вертикального столбца из табличного редактора автоматически преобразует набор ячеек в плоский текстовый список. Во время системного переноса структурные границы ячеек конвертируются в символы переноса строки. Благодаря этому механизму алгоритм считывает содержимое каждой отдельной ячейки исходной таблицы как строго независимую сущность для последующего этапа посимвольного сравнения.
| Исходный источник данных | Механизм разделения записей | Интерпретация алгоритмом |
|---|---|---|
| Текстовый столбец | Символ переноса строки | Каждая отдельная визуальная строка выступает независимым объектом сравнения |
| Линейный массив | Запятая или точка с запятой | Фрагмент текста между двумя знаками пунктуации распознается как одна запись |
| Microsoft Excel, Google Таблицы, CSV, XLSX | Конвертация границ ячеек через буфер обмена | Внутреннее содержимое изолированной ячейки приравнивается к отдельной строке |
Формирование результата и статистика очистки
Объективным итогом операции дедупликации выступает новый массив данных, содержащий исключительно уникальные значения. Исходная структура полностью очищается от выявленных абсолютных повторов, формируя список, готовый к последующему экспорту и применению. Полученный результат представляет собой чистую выборку, которая может быть напрямую интегрирована в целевые базы данных, табличные процессоры или программную среду.
Параметры форматирования вывода
Для обеспечения строгой совместимости очищенного списка с различными внешними системами применяется форматирование результата через выбор целевого разделителя. Этот параметр определяет, каким образом уникальные значения будут отделены друг от друга в финальном текстовом блоке. Замена разделителей позволяет на лету адаптировать массив под требования конкретного синтаксиса или формата импорта.
- Новая строка: формирует классический вертикальный список. Каждое уникальное значение переносится на отдельную строку. Этот формат оптимален для визуального контроля и обратного копирования данных в столбцы табличных процессоров.
- Запятая: преобразует массив в плоскую текстовую строку, где элементы разделены запятыми. Подходит для формирования стандартных массивов данных и создания структур CSV.
- Вертикальная черта: применяется в качестве альтернативного текстового разделителя. Использование этого символа критически важно при экспорте данных, внутри которых уже содержатся запятые или пробелы, что предотвращает структурные конфликты при последующем парсинге.
- Одинарные или двойные кавычки: используются для экранирования строковых значений. Обрамление каждого уникального элемента кавычками необходимо при подготовке данных для интеграции в программный код, структурирования JSON-объектов или формирования прямых запросов к базам данных.
Расчет базовой текстовой статистики
Процесс фильтрации строкового массива сопровождается вычислением количественных метрик, которые позволяют оценить качество исходного набора данных и эффективность проведенной очистки. Статистика базируется на прямом математическом сопоставлении объемов информации до и после выполнения алгоритма строгого сравнения.
| Метрика | Принцип вычисления | Интерпретация показателя |
|---|---|---|
| Изначальное количество строк | Прямой подсчет всех выделенных элементов входного массива до начала этапа фильтрации | Отражает сырой базовый объем предоставленных для анализа данных вместе со всем информационным шумом |
| Количество уникальных значений | Подсчет независимых элементов в итоговом массиве после исключения всех выявленных дубликатов | Указывает на реальный объем полезной информации в списке, готовой к целевому использованию |
| Статистика повторений | Вычисление математической разницы между изначальным количеством строк и количеством уникальных значений | Демонстрирует точное число удаленных избыточных записей и общую степень дублирования массива |
Практические сценарии применения дедупликации
Исключение повторяющихся записей выступает базовым этапом обеспечения целостности и качества данных. Наличие идентичных строк в рабочих массивах приводит к искажению аналитики, дублированию транзакций и техническим сбоям при интеграции систем. Процедура строгого сравнения строк востребована в задачах, где критически важно оперировать исключительно уникальными сущностями.
Маркетинговые рассылки и коммуникации
При агрегации контактных баз из нескольких источников часто возникают пересечения списков. Очистка баз email-адресов предотвращает многократную отправку одного и того же сообщения конечному получателю. Наличие уникального списка контактов напрямую влияет на доставляемость писем, защищает почтовый домен от попадания в спам-фильтры и оптимизирует затраты на использование сервисов рассылки, тарификация которых обычно зависит от объема загруженной адресной базы.
Электронная коммерция и товарный учет
Управление ассортиментом требует строгой уникальности идентификаторов. Удаление дублирующихся артикулов товаров или SKU необходимо при загрузке прайс-листов от разных поставщиков, массовом обновлении каталога или синхронизации остатков со складскими программами. Фильтрация массива исключает риск создания дублирующих карточек товаров, предотвращает ошибки при сопоставлении цен и обеспечивает корректную обработку складских операций.
Консолидация баз данных
Слияние нескольких информационных систем или объединение выгрузок из разных CRM неизбежно сопровождается пересечением клиентских записей. Фильтрация массивов, содержащих id пользователей или ИНН компаний, позволяет выделить уникальные первичные ключи из сырого дампа. Полученный после обработки список служит надежной основой для обновления таблиц без нарушения ссылочной целостности и появления избыточных дублей в архитектуре базы.
SEO и обработка семантики
Сбор поисковых запросов через инструменты парсинга генерирует объемные списки, в которых одни и те же фразы встречаются многократно. Подготовка семантического ядра требует чистки ключевых запросов. Строгая дедупликация массива отсекает все полные совпадения, формируя базовую структуру уникальных фраз. Этот процесс позволяет подготовить чистый набор данных для последующей фильтрации от неполных дубликатов, кластеризации и распределения запросов по посадочным страницам, исключая двойной учет статистики.