Очистка текста от кавычек представляет собой техническую операцию по полному удалению соответствующих спецсимволов из массива данных. Инструмент решает прикладную задачу нормализации строк перед их импортом в базы данных, публикацией или программной обработкой. Система сканирует загруженный контент и вырезает заданные знаки препинания. Процесс исключает необходимость ручного поиска и замены элементов в объемных документах.
Алгоритм распознает как парные, так и одиночные символы. Входными данными служит неформатированная строка или массив текста, содержащий элементы цитирования. Результатом выполнения операции становится очищенный текстовый блок. Исходное форматирование остального контента строго сохраняется. Буквы, цифры, пробелы, табуляции и нецелевые знаки препинания остаются на своих исходных позициях без смещений.
Подобная предварительная обработка востребована при подготовке данных для форматов CSV, JSON и XML. Наличие неэкранированных кавычек нарушает синтаксис структуры при передаче информации через API или генерации разметки HTML. Инструмент выполняет тотальное удаление этих знаков. Полученный неформатированный текст полностью готов к безопасной интеграции в среды, чувствительные к спецсимволам.
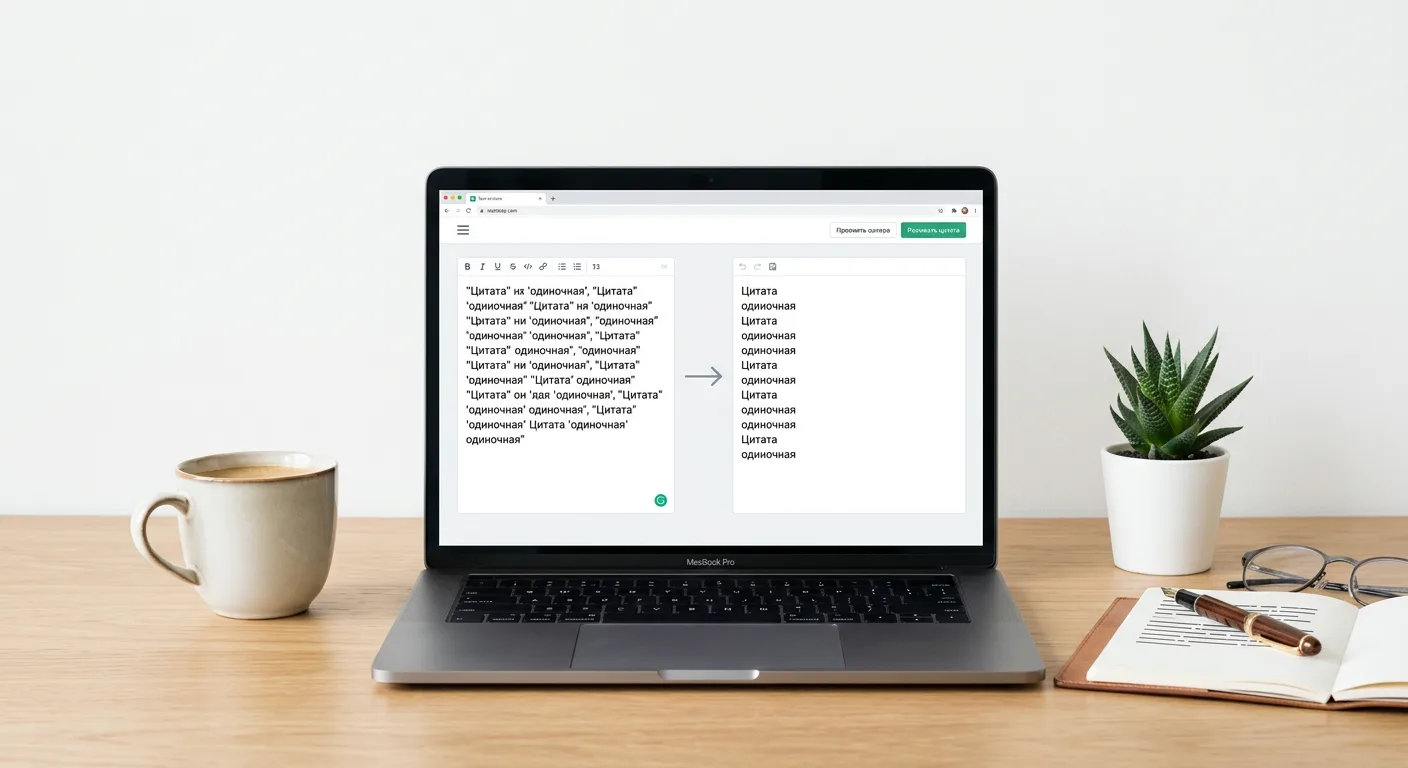
Символы и типы удаляемых кавычек
Предметная область инструмента охватывает широкий спектр знаков препинания, применяемых для оформления прямой речи, цитирования, выделения названий или определения строковых литералов. В зависимости от источника текста, используемой кодировки и региональных типографских стандартов, в массиве данных присутствуют различные графические вариации этих элементов. Логика фильтрации настроена на точное распознавание как стандартных ASCII-символов, так и специфических Unicode-символов, относящихся к данной лексикографической категории.
Удалению подлежат все виды элементов цитирования, независимо от их позиции в слове или предложении. Операция нормализации охватывает следующие конкретные типы символов:
| Тип символа | Техническое и типографское описание |
|---|---|
| Двойные прямые кавычки | Базовый симметричный ASCII-символ, повсеместно используемый в синтаксисе языков программирования, форматах обмена данными и неформатированных документах. |
| Одинарные прямые кавычки | Стандартный одиночный знак, применяемый для обозначения строковых переменных в коде и вложенного цитирования в простых текстовых редакторах. |
| Типографские смарт-кавычки (фигурные) | Асимметричные парные Unicode-символы верхнего регистра. Автоматически подставляются текстовыми процессорами для визуального улучшения типографики документа. |
| Французские кавычки-ёлочки | Парные угловые знаки, традиционно применяемые в качестве основного стандарта цитирования в кириллической, французской и ряде других европейских раскладок. |
| Немецкие кавычки-лапки | Специфические типографские элементы, характеризующиеся нижним расположением открывающего знака и верхним расположением закрывающего. |
| Знак апострофа | Надстрочный знак препинания, визуально совпадающий с одинарной кавычкой. Распознается алгоритмом и вырезается из слов вместе с остальными элементами группы. |
Комплексный подход к идентификации знаков препинания гарантирует тотальную очистку строки. Даже если в одном исходном документе смешаны базовые прямые символы из программного кода и типографские фигурные элементы из скопированного форматированного текста, все они классифицируются как целевые объекты и полностью удаляются из итогового массива данных.
Техническая логика поиска и фильтрации текста
Процесс очистки базируется на алгоритмах обработки строковых данных и лексическом анализе символов. В основе механизма лежит использование регулярных выражений, которые выступают в роли жестких шаблонов поиска для точной идентификации целевых специальных символов в переданном массиве неформатированного текста. Данный подход позволяет находить совпадения вне зависимости от их расположения, уровня вложенности или лингвистического контекста.
Программная реализация задачи фильтрации строится на применении базовой функции поиска и замены
replace
. Эта операция включает два ключевых технических условия:
-
Применение модификатора глобального поиска. Интеграция флага
gв синтаксис регулярного выражения указывает алгоритму на необходимость непрерывной сканирующей обработки всего объема данных. Сканирование не прерывается после нахождения первого искомого знака, а циклично продолжается до достижения конца текстовой строки. - Трансформация через пустое значение. Все идентифицированные по шаблону спецсимволы передаются в метод замены, где в качестве целевого аргумента выступает пустая строка.
Операция замены найденной кавычки на пустую строку является фундаментальным принципом бесшовного удаления элементов. При ликвидации знака препинания на его позицию не подставляется пробел или замещающий маркер. Происходит автоматический сдвиг смежных элементов: символы, находившиеся непосредственно до и сразу после удаляемой кавычки, смыкаются. Такая логика сдвига без пробелов гарантирует структурную целостность исходных слов и предотвращает появление нежелательных двойных пробелов в финальном тексте.
Предобработка данных для кода, CSV и JSON
Операция удаления кавычек применяется при подготовке массива данных для интеграции в программный код, миграции баз данных и парсинге структурных форматов. Очистка строковых литералов и текстовых переменных позволяет извлечь чистые значения без синтаксических артефактов исходной среды.
Практические сценарии нормализации текста при работе с форматами данных включают следующие процессы:
- Извлечение данных из JSON. При ручном парсинге или конвертации структур JSON строковые значения часто копируются вместе с обрамляющими кавычками. Устранение этих знаков необходимо для извлечения raw-данных и передачи чистого текста в системы, не поддерживающие объектную типизацию.
- Нормализация файлов CSV. В данном табличном формате двойные кавычки используются как квалификаторы текста, изолирующие значения, внутри которых присутствуют запятые или переносы строк. При экспорте таких дампов в простые базы данных эти квалификаторы становятся избыточными элементами и требуют удаления для корректного импорта информации.
- Устранение конфликтов с escape-символами. Встраивание внешнего контента в строковые литералы программного кода часто вызывает синтаксические ошибки из-за совпадения кавычек исходного текста с синтаксисом языка. Предварительная очистка текстовых переменных исключает необходимость ручного или алгоритмического экранирования обратными слешами, предотвращая преждевременный разрыв строки при компиляции.
Результатом такой предобработки выступает стандартизированный набор символов, который может быть без конфликтов интегрирован в любой синтаксис, передан в скрипты автоматизации или использован в качестве основы для формирования новых структур данных.
Нормализация типографики при копировании контента
Перенос текстовых массивов из полноценных текстовых процессоров часто сопровождается нежелательным изменением символов. Одной из основных проблем при операции copy-paste выступает автоматическая замена стандартных знаков на типографские смарт-кавычки, что создает сложности при дальнейшей обработке информации.
При копировании контента в буфер обмена исходная программа сохраняет элементы расширенного форматирования. В результате фигурные кавычки, ёлочки или лапки, созданные алгоритмами автозамены текстового редактора, переносятся вместе с основным массивом данных. При вставке такого текста в среды со строгими требованиями к кодировке эти символы могут распознаваться как нестандартные элементы или вызывать сбои при отображении.
Необходимость устранения типографских спецсимволов и приведения данных к базовому виду возникает в следующих ситуациях:
- Публикация материалов в CMS. Системы управления контентом и встроенные веб-редакторы могут некорректно обрабатывать сложные типографские символы при генерации страниц, что приводит к появлению визуальных артефактов или нарушению структуры HTML-кода.
- Интеграция контента в неформатированные среды. Текстовые поля, терминалы и системы конфигурации, ожидающие ввода базовых ASCII-символов, не поддерживают расширенную типографику и требуют предварительной очистки передаваемых строк.
- Подготовка текстов для систем машинного перевода или синтеза речи. Наличие нестандартных Unicode-кавычек может нарушать алгоритмы разбиения текста на предложения или слова.
Результатом удаления смарт-кавычек является чистый неформатированный текст. Полученный массив данных сохраняет исходное смысловое содержание, буквы, цифры и базовую пунктуацию, но освобождается от избыточной типографики. Такой стандартизированный текст готов к безопасной публикации в CMS, вставке в веб-формы или передаче в любые цифровые среды, не поддерживающие сложный рендеринг символов.
Порядок использования инструмента
Процедура устранения целевых спецсимволов из текстового массива требует выполнения последовательного алгоритма. Операция построена на базовом взаимодействии с буфером обмена и не требует предварительной настройки параметров фильтрации.
Для выполнения задачи предусмотрены следующие шаги:
- Ввод исходных данных. Скопируйте неформатированную строку или массив текста, содержащий проблемную типографику, и вставьте его в рабочее поле инструмента через системный буфер обмена.
- Инициация процесса очистки. Запустите операцию обработки, чтобы встроенный алгоритм просканировал предоставленный объем информации и изолировал искомые элементы.
- Получение результата. На данном этапе генерируется выходная строка. В полученном очищенном тексте полностью сохранены все буквы, цифры, пробелы и другие знаки препинания, за исключением целевых кавычек.
- Копирование очищенной строки. Извлеките готовый стандартизированный массив данных в буфер обмена для его дальнейшего практического использования.
Такой порядок действий гарантирует полное удаление избыточной типографики при сохранении оригинальной структуры остального контента. Извлеченная строка сразу готова к безопасному переносу в целевые базы данных, терминалы, редакторы кода или системы публикации.