Автоматическая очистка содержимого от буквенных символов выполняет точную нормализацию неструктурированных текстовых данных. Инструмент сканирует исходный массив. Алгоритм полностью удаляет все буквенные элементы, но строго сохраняет цифры, знаки препинания, пробелы и специальные символы. Пользователь передает смешанный текст, а получает чистый символьно-цифровой каркас.
Основное назначение операции заключается в предварительной обработке технической информации. Удаление нерелевантного текста гарантирует валидность данных перед последующим синтаксическим анализом или парсингом в форматы CSV, JSON и XML.
На вход подается сырая строка с произвольным чередованием знаков. Вычислительный фильтр находит и стирает буквы любых алфавитов. Оставшиеся табуляции, переносы строк и пунктуация удерживают исходное визуальное форматирование, что позволяет алгоритмам безошибочно извлекать изолированные числовые блоки.
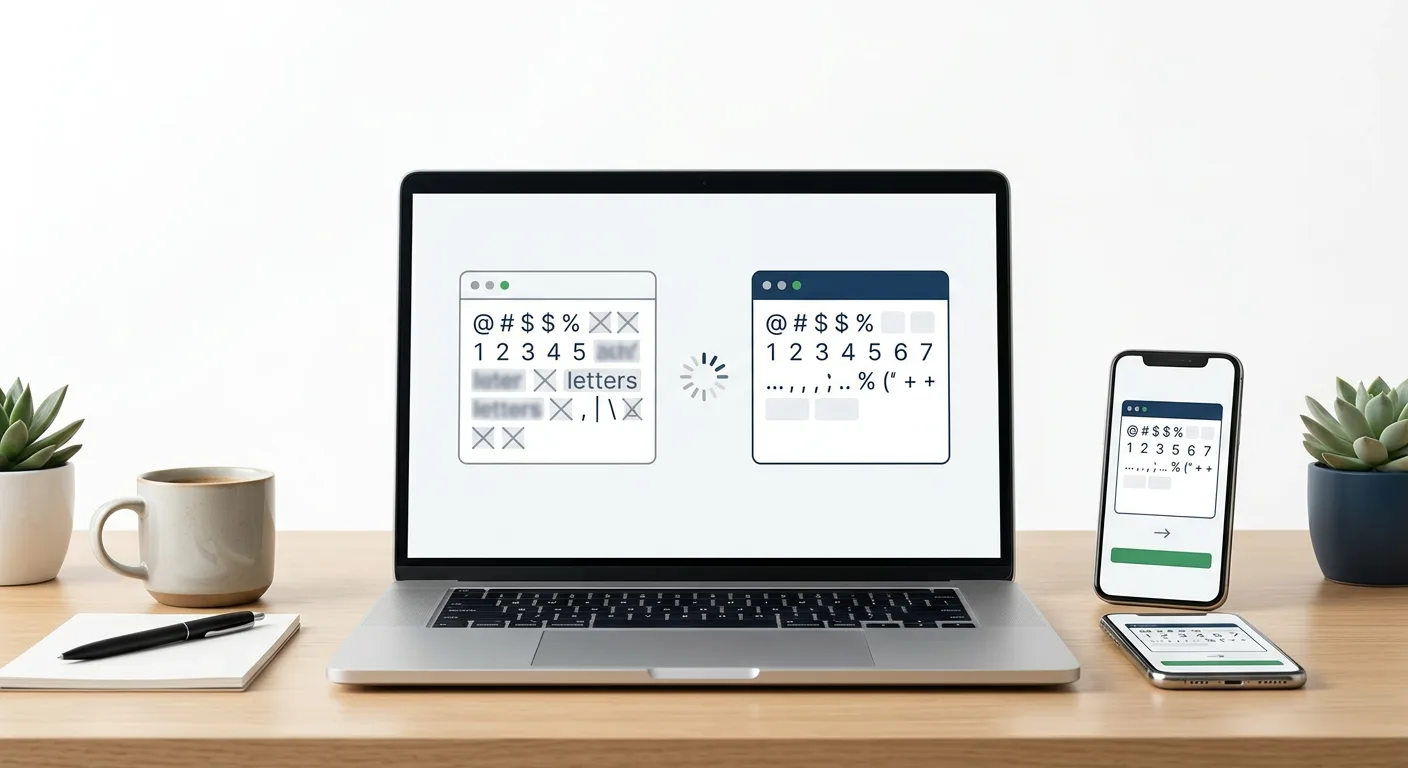
Классификация удаляемых и сохраняемых символов
Процесс нормализации строится на строгом разделении исходного массива данных на две категории. Фильтрация работает на уровне символьных классов, определяя принадлежность каждого знака к тексту, числам или служебной разметке. Такая логика позволяет полностью изолировать буквенную часть без нарушения исходного визуального форматирования.
Операция очистки нацелена исключительно на буквенную составляющую. Из обрабатываемой строки бескомпромиссно удаляются следующие элементы:
- Символы латинского алфавита в верхнем и нижнем регистре.
- Буквы кириллицы.
- Любые другие буквенные не-ASCII символы, принадлежащие к различным мировым языкам и алфавитам.
Для сохранения пригодности данных к дальнейшему анализу применяется защита структурного каркаса. Следующие категории элементов не подлежат стиранию и переносятся в итоговый результат в неизменном виде:
- Цифры.
- Пробельные символы, включая обычные и неразрывные пробелы.
- Маркеры табуляции.
- Символы переноса строк.
- Знаки препинания, включая точки, запятые, точки с запятой, двоеточия, тире, дефисы, кавычки и все виды скобок.
- Специальные и математические знаки, такие как символы валют, проценты, амперсанды, решетки, знаки равенства и косые черты.
На структурном уровне результатом выполнения задачи становится чистый цифро-символьный скелет. Поскольку все элементы невидимого форматирования остаются нетронутыми, оставшиеся небуквенные блоки точно сохраняют свое изначальное пространственное расположение. Промежутки, где ранее находились слова, сводятся к последовательности оригинальных пробелов и разделителей. Общая координатная сетка текста, деление на строки, колонки и абзацы остаются полностью идентичными оригиналу.
Порядок работы с текстовым полем и буфером обмена
Взаимодействие с инструментом базируется на стандартных механизмах операционной системы по управлению буфером обмена. Весь цикл преобразования, от загрузки исходного смешанного массива до получения чистого цифро-символьного каркаса, выполняется через основное рабочее поле.
Процедура передачи данных не требует создания промежуточных документов и выполняется в следующей последовательности:
- Выделение необходимого фрагмента текста в первоисточнике и его копирование в системный буфер обмена с использованием сочетания клавиш Ctrl+C для операционных систем Windows и Linux или Command+C для устройств на macOS.
- Активация текстового поля инструмента и вставка скопированного материала с помощью комбинации Ctrl+V или Command+V.
После помещения информации в рабочую область происходит выполнение заложенной операции фильтрации. Исходный массив трансформируется, оставляя заявленные категории символов на своих местах. Итоговый результат формируется в виде обычного текста с сохранением координатной сетки абзацев и строк, без добавления специфического невидимого форматирования или сторонних маркеров.
Извлечение готовых данных осуществляется через обратную процедуру копирования. Очищенный от букв текст выделяется в поле вывода и забирается в буфер обмена стандартной командой Ctrl+C или Command+C. Полученный массив полностью готов к дальнейшему использованию и может быть перенесен в любой редактор, рабочую среду или форму ввода с помощью команды вставки Ctrl+V или Command+V.
Практическое извлечение числовых данных из смешанного текста
Устранение буквенных символов из неструктурированного массива информации позволяет быстро получить чистый числовой каркас. В повседневных и рабочих задачах текстовые данные часто перемешаны с комментариями, длинными описаниями и пояснениями. Такое соседство затрудняет визуальный поиск, анализ и ручное копирование конкретных значений. Исключение букв оставляет на экране только цифры, математические знаки и оригинальные разделители, формируя готовую базу для работы с показателями.
Потребность в изоляции числовых значений возникает при обработке разрозненных записей, отчетов или рабочих переписок. Полученный результат применяется в следующих сценариях:
- Извлечение номеров телефонов из контактных книг, логов чатов или клиентских заявок, где цифры сопровождаются именами и пометками. Операция сохраняет форматирование номера, включая знак плюса, скобки и дефисы.
- Выделение цен и финансовых показателей из прайс-листов, счетов или рекламных текстов. Устранение словесных описаний оставляет изолированные суммы, десятичные разделители и символы валют.
- Сбор числовых артикулов и серийных номеров из длинных описаний товаров в каталогах или складских ведомостях.
- Анализ координат и статистических выборок. Исключение текста из неструктурированных отчетов оставляет точные значения, доли и количественные метрики.
Наглядное представление результата фильтрации демонстрирует, как сохранение пунктуации помогает удерживать структуру данных, пригодную для визуального или программного анализа:
| Исходный смешанный массив | Результат (числовой каркас) |
|---|---|
| Клиент: +7 (999) 123-45-67, звонить после 18:00 | : +7 (999) 123-45-67, 18:00 |
| Товар 24 дюйма, цена 15 500.50 $ | 24 , 15 500.50 $ |
| Координаты объекта: 55.7558 N, 37.6173 E | : 55.7558 , 37.6173 |
Поскольку алгоритм не затрагивает пробелы, табуляции и переносы строк, исходная геометрия массива не нарушается. Значения, находившиеся на разных строках в первоисточнике, останутся на тех же позициях в итоговом результате. Такая визуальная изоляция позволяет оператору быстро просмотреть очищенную информацию, оценить полноту данных и забрать нужные блоки без риска захватить лишний словесный мусор.
Предварительная очистка данных для форматов CSV и программного кода
Подготовка неструктурированных текстовых массивов к программному анализу требует строгой изоляции значимых данных. В процессах Data cleaning удаление буквенного мусора служит базовым этапом нормализации. Когда исходный материал содержит смесь количественных показателей и словесных описаний, прямая передача такого текста в скрипты приводит к ошибкам типов данных. Исключение букв оставляет только числовые значения и служебные символы, формируя чистую базу для дальнейшей машинной обработки.
Сценарий предварительной очистки востребован перед импортом информации в базы данных или парсингом в форматы CSV, JSON и TXT. Сохранение исходных математических знаков, пунктуации и отступов позволяет сформировать корректный синтаксис после удаления текста:
- Нормализация для CSV: Оставшиеся запятые, точки с запятой и переносы строк сохраняют первоначальную табличную сетку. В результате вместо смешанного текста образуются изолированные числа, готовые к распределению по столбцам.
- Формирование массивов для JSON: Очищенные от словесных описаний числовые последовательности с сохраненными фигурными и квадратными скобками легко конвертируются в массивы без ручного редактирования.
- Подготовка к импорту в базы данных: Удаление лишних слов из ячеек с ценами, габаритами или идентификаторами исключает сбои при записи данных в поля со строгим числовым типом.
При валидации пользовательского ввода также возникает проблема избыточности. Пользователи могут добавлять поясняющие слова, единицы измерения или комментарии в формы, предназначенные исключительно для количественных значений. Операция фильтрации нормализует такие данные, отсекая любые буквенные дополнения и оставляя фактические метрики вместе с необходимыми разделителями.
Пример преобразования смешанного ввода демонстрирует подготовку строк к автоматическому парсингу:
| Исходный текстовый лог | Нормализованный результат | Целевое применение |
|---|---|---|
| Record A: 50.5, Record B: 60.2 | : 50.5, : 60.2 | Извлечение значений, разделенных запятыми |
| [User 15] Items: {4, 8, 15} | [ 15] : {4, 8, 15} | Подготовка числовых множеств для JSON |
| Weight: 45 kg; Length: 120 cm; | : 45 ; : 120 ; | Парсинг параметров по разделителю в виде точки с запятой |
Изоляция полезной нагрузки от контекстных описаний позволяет разработчикам и аналитикам использовать стандартные функции регулярных выражений или встроенные инструменты импорта текстовых редакторов, минуя этап длительной ручной правки смешанных документов.