Определение уникальных элементов второго списка применяется при построечном сравнении двух массивов текста для выявления данных, присутствующих исключительно в целевом наборе. Инструмент выполняет строгую автоматическую фильтрацию. Входными параметрами служат два независимых текстовых блока. Результатом работы алгоритма является перечень записей, которые существуют во втором списке, но полностью отсутствуют в первом.
Базовая логика вычисления строится на прямом исключении данных первого списка из второго. Единицей проверки выступает отдельная текстовая строка. Алгоритм последовательно сканирует второй массив. Каждая его запись проверяется на точное вхождение в первый исходный список. При отсутствии стопроцентного совпадения строка идентифицируется как уникальная и переносится в итоговую выдачу.
Метод построчного сопоставления обрабатывает любые структурированные данные. Разделителем проверяемых элементов по умолчанию служит перенос строки. Подобное исключение массива из массива позволяет изолировать новые значения, отсечь уже обработанные фрагменты и получить чистый набор данных для дальнейшего использования.
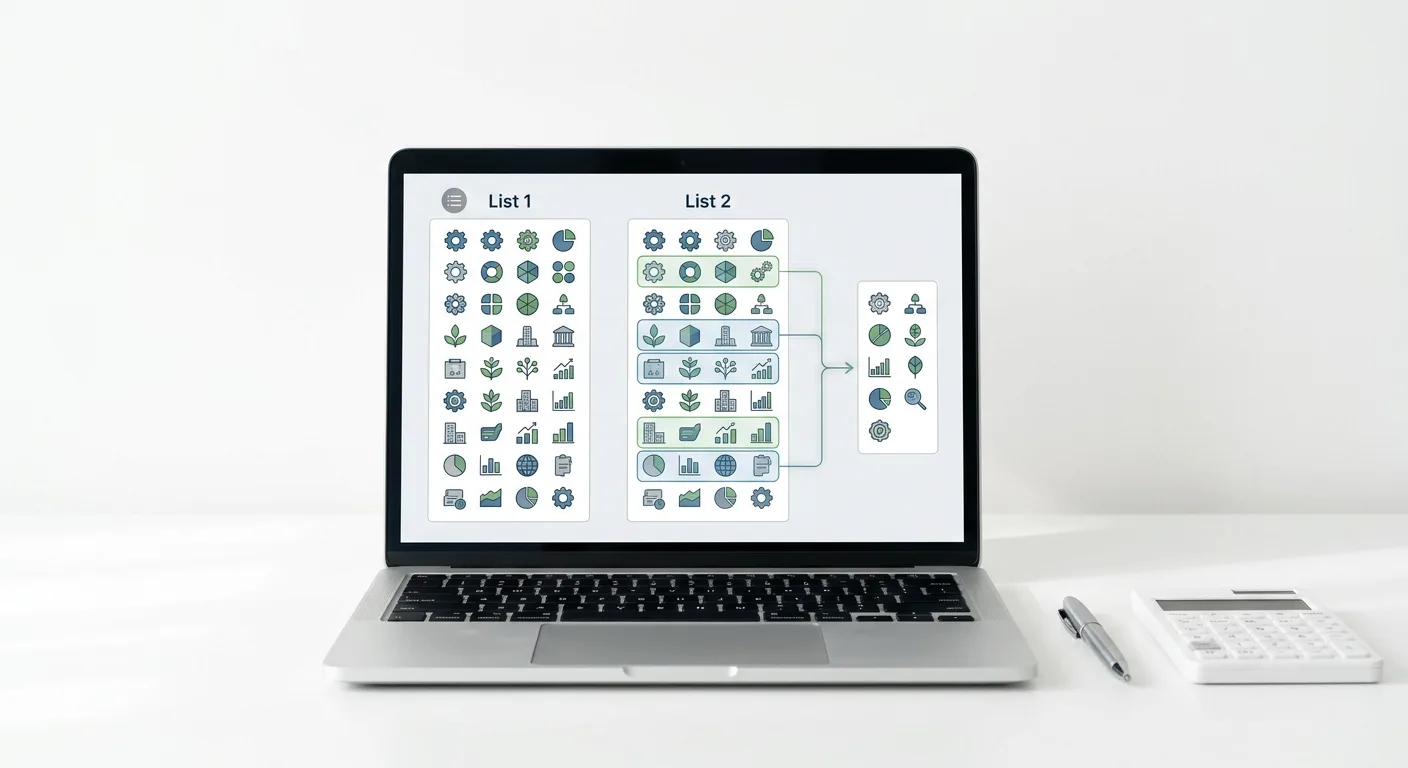
Принцип вычитания списков: логика операции
В основе построчного сравнения лежит математическая и логическая концепция разности множеств (Set Difference). Данная операция определяет элементы, которые принадлежат одному множеству, но абсолютно не пересекаются с другим. Применительно к обработке текстовых массивов это означает формирование нового пула данных, состоящего исключительно из записей целевого списка.
Процесс вычитания списков выполняется в строгой алгоритмической последовательности. Для корректного разбиения сплошного текста на независимые элементы разделителем по умолчанию выступает перенос строки.
Пошаговая логика выявления уникальных значений строится на следующих этапах:
- Берется каждая отдельная текстовая строка из второго массива.
- Выделенная запись сканируется на точное вхождение в первый исходный список.
- Если в процессе сканирования выявляется дубликат, строка отбрасывается.
- Если совпадение в первом массиве не найдено, проверяемая строка признается уникальной и переносится в итоговый результат.
Логика разности множеств имеет строгую направленность. При вычитании первого списка из второго алгоритм полностью игнорирует те элементы первого массива, которых нет во втором. Вектор проверки всегда направлен на анализ целевых строк, что гарантирует получение точного списка новых или недостающих записей.
Типы обрабатываемых данных и практические сценарии
Универсальность построчного сравнения позволяет обрабатывать различные массивы текстовой информации. Поскольку базовой единицей сопоставления выступает целая строка, операция применима к любым структурированным спискам, где каждый элемент расположен с новой строки.
Для вычисления разности массивов пригодны следующие виды входных данных:
- Текстовые строки произвольного содержания и длины.
- Базы email-адресов.
- Списки URL-адресов.
- Числовые идентификаторы, включая ID пользователей, VK ID и базы таргета.
- Артикулы товаров (SKU).
Вычитание списков решает ряд предметных задач, связанных с аналитикой, актуализацией информации и очисткой баз данных. Полученный результат можно использовать для оптимизации рабочих процессов в различных сценариях.
Первый частый сценарий - выявление новых элементов в обновленной базе. При сопоставлении старой версии массива (первый список) с актуальной выгрузкой (второй список) операция отсекает всю ранее существовавшую информацию. Итогом становится чистый перечень недавно добавленных записей.
В сфере цифрового маркетинга данная логика применяется для исключения ранее обработанных контактов из текущего списка рассылки. Если поместить перечень адресов, которым уже отправлено письмо, в первый массив, а полный план рассылки - во второй, результат покажет только те контакты, которые еще не получали сообщение. Это предотвращает риск повторных отправок и снижает вероятность попадания в спам.
В электронной коммерции и управлении каталогами вычитание списков используется для поиска отсутствующих товарных позиций в прайс-листах. Сравнивая текущий ассортимент магазина с полным файлом от поставщика по SKU, можно мгновенно определить перечень новых товаров, которые необходимо добавить на витрину или закупить на склад.
Точность совпадения и требования к нормализации строк
При сопоставлении массивов текста алгоритм выполняет точное построчное сравнение (exact match). Проверка осуществляется на уровне посимвольного совпадения. Операция не использует алгоритмы нечеткого поиска, такие как фаззи-поиск на основе расстояния Левенштейна. Это означает, что для исключения записи из итогового результата она должна присутствовать в первом списке в абсолютно идентичном виде.
Любое отклонение в наборе символов приводит к тому, что визуально одинаковые записи распознаются машиной как разные. Если строка во втором массиве имеет минимальные технические отличия от своего аналога в первом, она классифицируется как уникальный элемент второго списка и попадает в финальную выборку.
Для получения ожидаемого результата при вычитании списков необходимо учитывать следующие факторы невидимого форматирования:
- Разница в регистре букв. Строки, содержащие одинаковый текст, но написанные в разных регистрах, обрабатываются как уникальные элементы.
- Лишние пробелы. Наличие невидимого пробела в начале или в конце строки, а также случайные двойные пробелы между словами разрушают условие точного совпадения.
- Символы табуляции. Технические отступы, часто переносимые при копировании данных из табличных процессоров, меняют исходную структуру строки.
- Пустые строки. Изолированные переносы каретки выступают самостоятельными элементами проверки и сопоставляются на общих основаниях.
Отсутствие предварительной нормализации данных является основной причиной появления ложноположительных срабатываний. Приведение всего текста к единому регистру и удаление лишних пробельных символов до начала сравнения гарантируют, что итоговый результат будет содержать только фактически новые строки, а не дубликаты с ошибками ввода.
Альтернативные методы в Excel и Google Таблицах
Задача выявления строк, присутствующих только во втором массиве, часто решается локально с помощью табличных процессоров. При работе с электронными таблицами списки размещаются в двух независимых столбцах. Поиск уникальных значений второго списка базируется на проверке каждой его ячейки на наличие точного совпадения в диапазоне первого столбца. Для реализации этой логики применяются встроенные математические и поисковые функции.
Использование функции СЧЁТЕСЛИ (COUNTIF)
Функция подсчета по условию проверяет, сколько раз конкретное значение из второго столбца встречается в первом. Если строка является новой и присутствует исключительно во втором списке, количество ее вхождений в первый массив будет равно нулю.
Для реализации метода первый список помещается в столбец A, а второй - в столбец B. В соседнем свободном столбце C прописывается формула для проверки первой строки второго массива:
=СЧЁТЕСЛИ(A:A; B1)После применения формулы ко всем строкам столбца B, табличный процессор выведет числовые значения. Строки с результатом «0» - это искомые элементы, отсутствующие в первом списке. Для завершения задачи применяется стандартный фильтр по столбцу C, в котором оставляются только нулевые значения. Отфильтрованные данные столбца B представляют собой итоговый результат вычитания списков.
Комбинация функций ВПР (VLOOKUP) и ЕОШИБКА (ISERROR)
Функция вертикального просмотра выполняет поиск значения в заданном диапазоне. Если настроить ее на поиск точного совпадения, при отсутствии элемента в первом столбце она вернет стандартную ошибку отсутствия данных - #Н/Д. Эта ошибка используется как маркер уникальности строки второго списка.
Чтобы избежать вывода самой ошибки и получить удобный логический результат, поисковый запрос оборачивается в функцию проверки ошибок:
=ЕОШИБКА(ВПР(B1; A:A; 1; ЛОЖЬ))Интерпретация результатов вычисления выглядит следующим образом:
- ИСТИНА (TRUE). Означает, что функция ВПР не нашла строку в первом столбце и выдала ошибку. Следовательно, это уникальный элемент второго списка.
- ЛОЖЬ (FALSE). Указывает на то, что поиск завершился успешно, ошибка отсутствует, и строка является дубликатом, присутствующим в обоих массивах.
Фильтрация расчетного столбца по значению «ИСТИНА» позволяет изолировать все новые записи.
Визуализация через условное форматирование
Для ситуаций, когда не требуется выносить уникальные строки в отдельный список, а необходимо лишь подсветить их для визуального анализа, применяется инструмент условного форматирования. Метод не использует дополнительные столбцы для расчетов, а меняет фоновый цвет ячеек на основе пользовательской формулы.
Для настройки выделяется весь второй столбец с данными, после чего в правилах форматирования задается логическое условие на основе нулевого вхождения:
=СЧЁТЕСЛИ(A:A; B1)=0Применение этого правила закрасит заданным цветом все ячейки второго столбца, содержимое которых ни разу не встречается в первом столбце. Данный подход эффективен для быстрой выверки небольших прайс-листов или проверки баз данных перед объединением, позволяя наглядно оценить объем новых данных.
Алгоритмическая реализация сравнения массивов
При обработке значительных объемов текстовых данных логика вычитания списков реализуется на уровне программных скриптов. Базовый алгоритм сводится к последовательной проверке каждого элемента целевого массива на предмет его существования в исходном массиве. Для обеспечения высокой скорости выполнения таких операций вместо обычных списков применяются специализированные структуры данных.
Оптимальным решением для задачи изоляции уникальных строк является структура данных «множество» (Set). Ее математическая природа подразумевает хранение исключительно уникальных элементов. При конвертации исходного текстового массива во множество происходит автоматическое удаление всех дубликатов. Главное техническое преимущество этой структуры заключается в использовании хеш-таблиц. Это обеспечивает практически мгновенный поиск элементов со сложностью, не зависящей от общего размера обрабатываемой базы.
Процесс машинного сопоставления опирается на оператор вхождения (in). Логика работы алгоритма строится на простом цикле, который включает несколько последовательных шагов:
- Инициализация множества на основе строк первого списка.
- Последовательный перебор элементов второго списка.
- Проверка каждой целевой строки через оператор вхождения на присутствие в сформированном множестве.
- Добавление элемента в итоговый результат при получении отрицательного ответа от оператора.
В языках программирования, ориентированных на работу с данными, подобный алгоритм вычисления разности реализован в виде оптимизированных готовых функций. В качестве предметного примера можно рассмотреть библиотеку numpy для языка Python и ее встроенную функцию setdiff1d(). Данная функция принимает два массива и возвращает отсортированный массив уникальных значений, которые находятся в первом переданном аргументе, но отсутствуют во втором.
Поскольку предметная задача требует найти новые элементы именно во втором списке, порядок передачи аргументов в функцию инвертируется:
import numpy as np

list1 = np.array(['строка_А', 'строка_Б', 'строка_В'])
list2 = np.array(['строка_Б', 'строка_Г', 'строка_Д'])

result = np.setdiff1d(list2, list1)
# Итоговый массив: ['строка_Г', 'строка_Д']
При выполнении этого кода алгоритм анализирует входные данные на уровне бинарных операций, отсекает пересекающиеся элементы и формирует новый массив. В итоговой переменной остаются только те значения, которые изначально принадлежали второму списку и не имели совпадений в первом. Использование подобных векторных операций позволяет обрабатывать массивы данных быстрее и эффективнее, чем при написании стандартных циклов с ручным применением оператора вхождения.