Определение отличий между версиями текста заключается в попарном сопоставлении двух фрагментов для точного выявления всех несовпадений. Инструмент решает эту задачу путем посимвольной или пословной синхронизации независимых блоков информации. Он находит фактические расхождения между первоначальным и финальным вариантом. Лишние данные отсекаются на этапе загрузки.
Для запуска процесса требуются обязательные входные данные. Ими выступают исходный текст и измененный текст. Передача информации осуществляется через буфер обмена стандартным методом Copy + Paste. Инструмент обрабатывает исключительно сырой текстовый ввод. Любое стороннее форматирование из текстовых процессоров полностью игнорируется.
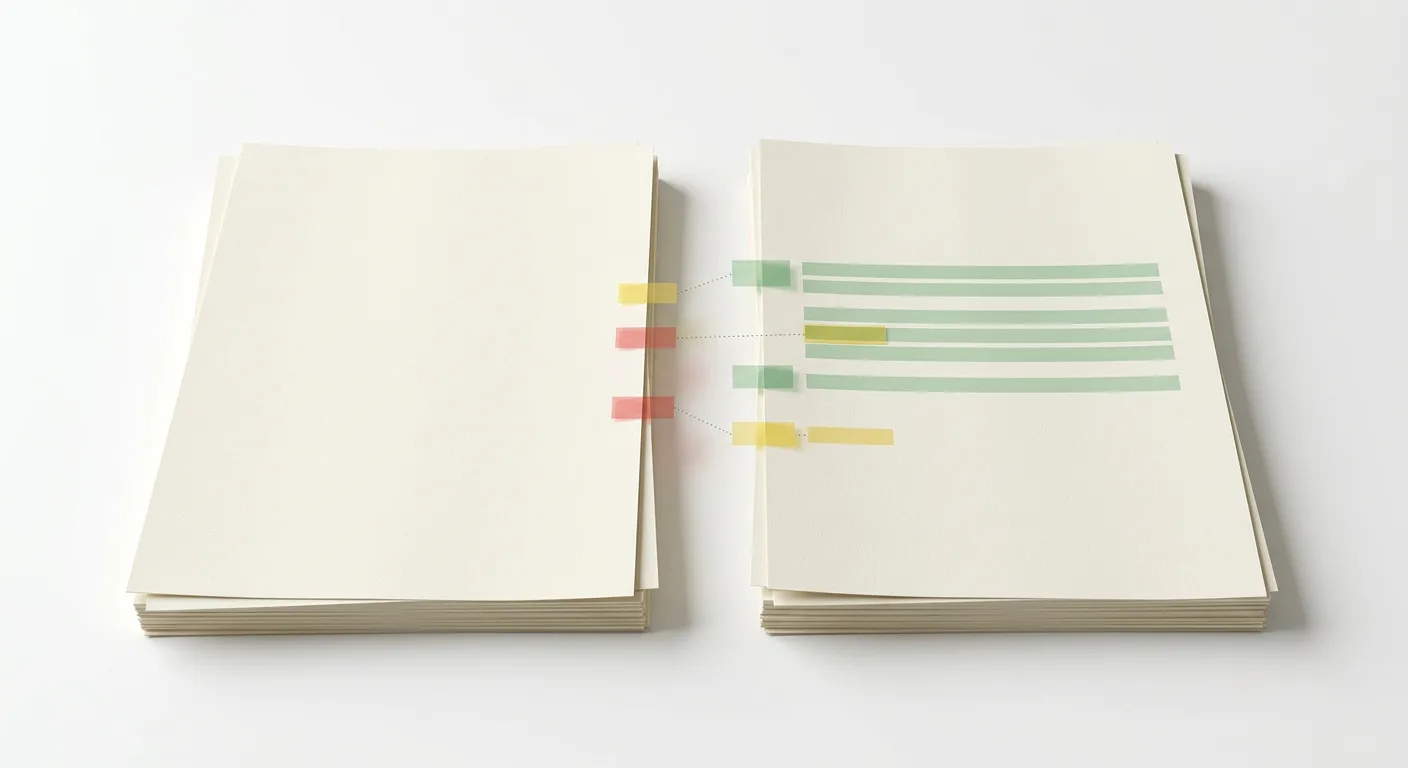
Итогом сравнения является сгенерированный визуальный отчет. Результирующие данные выводятся на экран в виде наглядной разметки. Механизм маркирует три основных состояния контента. Он выделяет удаленные участки, подсвечивает добавленные символы и фиксирует измененные фрагменты. Пользователь мгновенно локализует новые абзацы или вырезанные из оригинала предложения без ручного перечитывания материала.
Логика работы текстового компаратора: алгоритмы сопоставления
Процесс выявления различий строится на математической логике вычисления Diff. Для выполнения операции компаратору требуются две независимые структуры данных. В терминологии сопоставления они обозначаются как исходный документ, или base, и исправленный документ, называемый modified. Базовый вариант служит эталоном, относительно которого вычисляются все последующие трансформации. Модифицированный вариант представляет собой конечный набор данных, подвергнутый анализу на наличие отклонений от первоначального эталона.
Механика анализа базируется на строгом определении статуса каждого фрагмента текста. Алгоритм сравнивает множества элементов base и modified, присваивая им конкретные логические состояния на основе их наличия или отсутствия в анализируемом документе.
- Удаленный контент: фрагмент присутствует в исходном документе, но физически отсутствует в исправленном документе.
- Добавленный контент: фрагмент не существует в базовой версии, но зафиксирован в модифицированной версии.
- Неизменный контент: фрагмент абсолютно идентичен в обеих версиях и используется математической моделью как точка привязки.
Фундаментом для правильной классификации этих состояний выступает алгоритм LCS. Концепция поиска наибольшей общей подпоследовательности решает задачу базовой синхронизации двух текстов до того, как начнется фактическое выделение расхождений. Вычислительный механизм сканирует оба ввода и определяет самую длинную цепочку элементов, которая встречается и в base, и в modified в строго одинаковом порядке.
Найденная общая подпоследовательность образует структурный неизменный каркас. Этот каркас не обязательно должен быть непрерывным. Все элементы, которые не вошли в данную опорную структуру, автоматически классифицируются как изменения. Данные из исходного документа, оставшиеся вне найденной подпоследовательности, распознаются как удаленные участки. Аналогичные несовпадающие данные из исправленного документа определяются алгоритмом как добавленные участки. Подобная логика вычислений исключает рассинхронизацию текста и обеспечивает точное сопоставление даже при масштабных сдвигах предложений.
Уровни детализации при анализе расхождений в тексте
Точность классификации добавленного, удаленного и неизменного контента напрямую зависит от выбранной единицы измерения, которую алгоритм принимает за базовый элемент. Гранулярность сравнения определяет глубину анализа и позволяет настраивать процесс выявления расхождений под конкретную задачу. Вычислительный механизм способен сегментировать исходные данные на трех основных уровнях детализации.
Построчное сравнение
На этом уровне базовой единицей сопоставления выступает целая текстовая строка. Алгоритм анализирует текст до символа переноса каретки и сравнивает полученные блоки целиком. Такой подход обеспечивает быструю идентификацию структурных изменений макроуровня.
Построчная дифференциация фиксирует следующие трансформации исходных данных:
- Удаление или добавление целых абзацев в массиве текста.
- Изменение порядка следования пунктов в структурированных списках.
- Перемещение, удаление или вставка отдельных строк кода.
Пословное сравнение
Увеличение глубины анализа достигается при переходе к пословному сопоставлению. В этом случае текст разбивается на отдельные токены, границами которых обычно служат пробелы и знаки препинания. Механизм сравнения обрабатывает каждое слово как независимый элемент последовательности.
Пословный уровень детализации выявляет локальные изменения внутри визуально неизменных абзацев. Он позволяет точно обнаружить:
- Замену конкретных терминов или использование синонимов.
- Перестановку слов внутри одного предложения без изменения общего объема текста.
- Добавление новых вводных конструкций или удаление отдельных определений.
Посимвольное сопоставление
Максимальная степень детализации достигается при посимвольном анализе, когда базовой единицей становится каждый отдельный знак, включая пробелы и непечатные элементы. Этот уровень обеспечивает абсолютную точность поиска микроскопических расхождений, которые не меняют структуру документа, но влияют на его содержание.
Анализ на уровне отдельных символов необходим для выявления следующих категорий правок:
- Опечатки, пропущенные буквы и орфографические исправления.
- Измененные окончания при корректировке падежей, склонений или времен.
- Лишние или двойные пробелы между словами.
- Разница в регистрах при написании названий.
- Наличие скрытых спецсимволов, символов табуляции или неразрывных пробелов.
Влияние глубины анализа на точность поиска
Выбор уровня гранулярности напрямую определяет характер и полезность получаемого результата. Построчный анализ формирует картину общих структурных сдвигов, но обладает низкой точностью при точечных правках. Например, изменение одной запятой приведет к тому, что на макроуровне алгоритм пометит всю строку как удаленную и добавленную заново в исправленном виде.
Пословный анализ локализует изменения, предотвращая ложное выделение всего абзаца, однако он не способен указать на изменение одной буквы в длинном слове. Посимвольное сопоставление гарантирует обнаружение любых модификаций, исключая вероятность пропуска невидимых символов или опечаток.
Переход от крупной детализации к мелкой позволяет алгоритму сначала синхронизировать крупные структурные блоки текста, а затем с высокой точностью детализировать поиск расхождений внутри конкретных измененных фрагментов.
Интерпретация результатов: чтение визуального Diff-отчета
После завершения синхронизации и гранулярного анализа двух текстовых массивов выявленные расхождения формируются в визуальный отчет. Наиболее наглядным форматом для восприятия таких данных выступает параллельное сопоставление в двух колонках. Левая часть экрана традиционно отражает исходное состояние документа, тогда как правая часть демонстрирует конечный, измененный вариант. Такое расположение позволяет синхронно отслеживать контекст и построчно сверять конкретные фрагменты, не теряя смысловой связи между версиями.
Для быстрой идентификации характера правок применяется система визуальной разметки. Все найденные отличия классифицируются по трем основным состояниям, каждое из которых имеет характерную цветовую или шрифтовую индикацию:
- Удаленные участки: фрагменты текста, которые присутствовали в базе, но отсутствуют в новой редакции. В левой колонке они выделяются специальным фоном или зачеркиванием, сигнализируя об изъятии контента. В правой колонке на соответствующем уровне формируется пустое пространство, что позволяет сохранить визуальную симметрию и синхронизацию последующих строк.
- Добавленные участки: новый контент, внедренный в модифицированную версию. Эти фрагменты отсутствуют в левой колонке, а в правой выделяются контрастным цветом или подчеркиванием, указывая на появление новых данных. Слева при этом отображается пустой компенсаторный блок.
- Измененные фрагменты: участки, где произошла локальная замена символов или слов. При таком состоянии в обеих колонках подсвечиваются соответствующие строки, а внутри них более интенсивным оттенком или специальным шрифтом локализуются конкретные замененные элементы.
Отличие фактических изменений от структурных сдвигов
При чтении визуального отчета важно разделять семантические правки контента и структурное форматирование документа. Структурный сдвиг возникает, когда абзацы или строки меняют свое физическое расположение из-за добавления пустых строк, переносов каретки или изменения отступов, при этом само содержание текста остается неизменным.
Если в модифицированной версии появляются новые разрывы строк, последующий текст смещается вниз. При параллельном анализе корректно выстроенный отчет не помечает смещенный массив как полностью удаленный из одной части и добавленный в другую. Вместо этого в правой колонке фиксируется добавление невидимых символов переноса, а в левой образуются выравнивающие пустые блоки. Сам текст, следующий за сдвигом, остается без цветовой подсветки, так как его содержимое полностью идентично исходной базе.
Фактическое изменение контента всегда сопровождается модификацией видимых символов или значимых пробелов. Обращая внимание на горизонтальное выравнивание блоков и наличие точечной индикации внутри абзацев, можно безошибочно определить: был ли фрагмент локально отредактирован, переписан целиком или просто смещен вниз из-за форматирования предшествующих абзацев.
Практические сценарии сопоставления текстовых данных
Базовая функция ввода двух текстов и попарного сравнения массивов применяется в различных профессиональных сферах. Анализ визуальной разметки расхождений позволяет решать прикладные задачи контроля версий без необходимости вычитывать объемные документы вручную.
Копирайтинг и редактура
В сфере создания контента операция сверки используется для проверки качества материалов. При сопоставлении исходной статьи с рерайтом выявляются участки, оставшиеся без изменений, что дает возможность оценить фактическую глубину переработки текста. Сравнение исходника с финальной версией помогает авторам проанализировать правки, внесенные редактором или корректором. Визуальный отчет показывает конкретные замененные слова, перефразированные абзацы и удаленные фрагменты текста.
Юридический документооборот
Сверка пунктов договоров, дополнительных соглашений и нормативных актов требует высокой точности. Параллельное сравнение двух версий документа позволяет обнаружить скрытые изменения в формулировках, которые могли быть добавлены контрагентом на этапе согласования. Замена одного термина, удаление части предложения или внедрение незаметного подпункта в массиве юридического текста сразу локализуется в колонках отчета, исключая риск утверждения некорректной редакции.
Программирование и WEB администрирование
Сравнение сырого текста регулярно применяется при поиске причин сбоев или проверке обновлений программного обеспечения. Метод попарного сопоставления эффективен для следующих технических задач:
- Анализ конфигурационных скриптов форматов JSON и XML для поиска измененных параметров окружения.
- Сопоставление фрагментов HTML кода при верстке для выявления отсутствующих закрывающих тегов или модифицированных атрибутов.
- Сверка SQL запросов перед выполнением операций с базами данных для нахождения ошибок синтаксиса.
- Сравнение лог-файлов за разные периоды для локализации аномалий в работе серверов.
Работа с массивами данных
При обработке статистических или финансовых выгрузок часто возникает необходимость найти расхождения между двумя списками. Использование сырого текстового ввода позволяет сравнивать инвентарные ведомости, реестры или таблицы CSV, предварительно скопированные в виде обычного текста. Сопоставление таких наборов данных бок о бок быстро выявляет пропущенные строки, добавленные записи или измененные числовые значения в конкретных позициях списка.