Поиск совпадений между двумя списками представляет собой прямую операцию извлечения идентичных строк из двух независимых массивов данных. Инструмент выполняет точную автоматическую сверку элементов.
Входными параметрами служат два перечня текстовых значений. Разделителем элементов выступает стандартный перенос строки. Процесс обработки данных строго детерминирован. На выходе генерируется новый массив, состоящий исключительно из тех элементов, которые одновременно зафиксированы в обоих исходных текстах.
Фактически выполняемая задача реализует логическую операцию пересечения множеств, применяемую к текстовым данным. Программный алгоритм изолирует общие значения и отсекает любые уникальные записи.
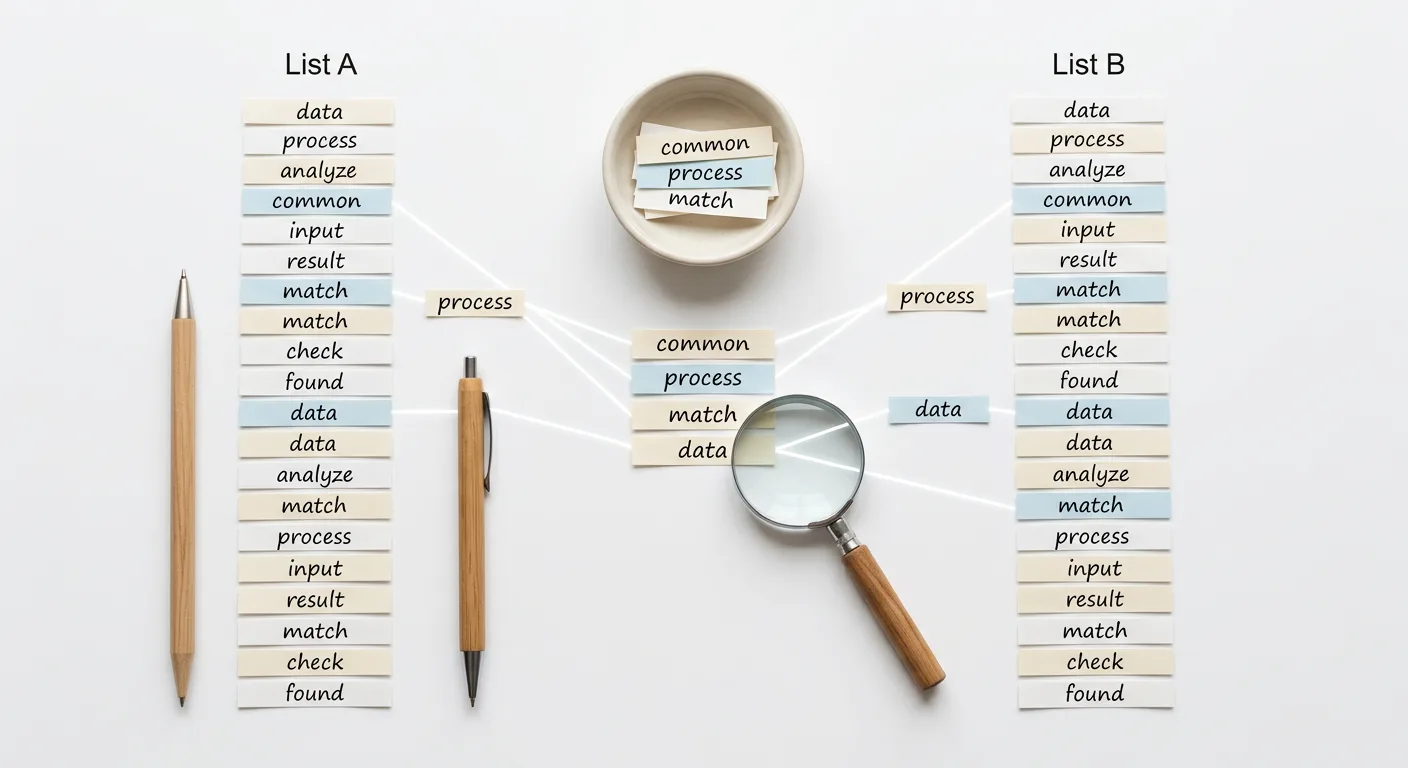
Логика построчного сравнения и пересечения множеств
В основе выявления общих значений лежит математический принцип пересечения множеств, переложенный на работу с текстовыми массивами. Применительно к строковым данным пересечение формирует новую группу элементов, куда включаются исключительно те записи, которые физически присутствуют в обоих анализируемых перечнях. Ни один уникальный элемент из исходных массивов в итоговый результат не переносится.
Алгоритмическая реализация этой задачи базируется на последовательном переборе данных. Процесс инициируется взятием первой строки из первого списка. Далее выполняется полное сканирование второго списка с целью найти точный аналог взятой строки. Если искомое значение обнаруживается во втором массиве, оно фиксируется как совпадение и направляется в итоговый список. После завершения сканирования цикл повторяется для следующей строки из первого перечня, итеративно обрабатывая массив до самого конца.
Главным критерием признания строк одинаковыми выступает принцип точного совпадения. Сверка осуществляется строго посимвольно. Каждая буква, цифра или знак препинания сравниваются в порядке их следования от начала до конца строки.
Текстовые элементы классифицируются как общие только при условии их абсолютной структурной идентичности. Бинарный подход исключает любые допущения при проверке:
- Полное соответствие последовательности всех символов гарантирует выявление общей строки.
- Замена, отсутствие или добавление хотя бы одного знака делает строки принципиально разными.
- Изменение порядка слов внутри фразы полностью меняет структуру символов, отменяя совпадение.
Для наглядности принципа абсолютной идентичности можно рассмотреть базовые паттерны оценки текстовых значений при построчном сравнении.
| Значение из первого списка | Значение из второго списка | Результат посимвольной сверки |
|---|---|---|
| Код детали 815 | Код детали 815 | Точное совпадение |
| Код детали-815 | Код детали 815 | Строки различаются (дефис вместо пробела) |
| Синий элемент | Элемент синий | Строки различаются (другой порядок символов) |
| Процесс А | Процесс А1 | Строки различаются (дополнительный символ) |
Влияние формата данных на точность поиска совпадений
Строгое посимвольное сравнение требует четкого понимания границ каждого элемента в текстовом массиве. Разделителем значений выступает исключительно перенос строки. Каждое нажатие клавиши ввода формирует новую самостоятельную единицу данных. Одна физическая строка текста обрабатывается как один цельный элемент списка, независимо от количества слов, цифр или знаков препинания внутри нее.
Важным фактором, определяющим итоговый результат сверки, является регистр символов. При строгом подходе заглавные и строчные буквы воспринимаются как совершенно разные знаки, поскольку имеют различные кодовые значения. Чувствительность к регистру означает, что элементы с одинаковым буквенным составом, но разным написанием, не образуют пересечения множеств. Текст, начинающийся с заглавной буквы в первом списке, и аналогичный текст, написанный строчными буквами во втором, распознаются как уникальные и не попадают в перечень общих строк.
Наиболее частой причиной ложноотрицательных результатов при поиске одинаковых значений выступают скрытые символы. Человеческий глаз воспринимает текст визуально, тогда как логическая операция учитывает каждый невидимый знак. Наличие лишнего пробела перед первым словом или после последнего символа необратимо меняет общую длину и структуру строки.
К типичным структурным аномалиям, нарушающим абсолютную идентичность визуально одинаковых элементов, относятся следующие паттерны ввода:
- Невидимые пробелы в начале строки, часто возникающие при прямом копировании колонок из табличных редакторов.
- Невидимые пробелы в конце строки, которые остаются незаметными при обычном просмотре текстового документа.
- Пустые строки между элементами списка, которые обрабатываются системой как самостоятельные значения нулевой длины.
Сложности, связанные с форматом данных, хорошо прослеживаются при анализе скрытых расхождений.
| Значение из первого списка | Значение из второго списка | Причина ложноотрицательного результата |
|---|---|---|
| Артикул 100 | артикул 100 | Чувствительность к регистру (заглавная и строчная буква) |
| Значение | Значение | Наличие скрытого пробела в начале первой строки |
| Данные | Данные | Наличие скрытого пробела в конце второй строки |
Для минимизации ошибок и исключения подобных ложных расхождений требуется предварительная очистка данных перед выполнением операции сравнения. Процесс нормализации, известный как trimming, заключается в удалении всех начальных и конечных пробелов, а также в фильтрации массивов от пустых строк. Только чистые текстовые данные гарантируют математически точное нахождение пересечений между независимыми списками.
Сценарии применения: от семантических ядер до e-commerce
Сверка текстовых массивов и нахождение общих строк решает аналитические и учетные задачи в различных профессиональных областях. Операция логического пересечения списков применяется там, где требуется точное сопоставление больших объемов информации, выгруженной из независимых систем.
SEO и контекстная реклама
При работе с семантическими ядрами алгоритм поиска совпадений используется для обработки списков ключевых слов и минус-фраз. Специалисты сравнивают выгрузки из разных аналитических платформ для выявления наиболее частотных запросов, которые присутствуют одновременно во всех исследуемых источниках. В контекстной рекламе перекрестная сверка массивов минус-фраз помогает исключить дублирование нецелевых запросов на уровне разных кампаний и сформировать единый очищенный список для фильтрации трафика.
Маркетинг и аналитика
В задачах сегментации аудитории пересечение множеств применяется для поиска общих контактных данных пользователей. Исходными массивами выступают списки email или ID из таргет-баз. Сравнение выгрузок позволяет определить пользователей, которые одновременно попали в два разных маркетинговых сегмента, или найти пересечения между аудиториями рекламных кампаний. Итоговый список совпадений используется для настройки узкого ретаргетинга на наиболее вовлеченную часть аудитории.
E-commerce
Управление товарным ассортиментом требует регулярной сверки прайс-листов и каталогов. Основным строковым идентификатором в таких задачах выступает SKU. Сравнение массива товарных артикулов от одного поставщика с аналогичным списком от другого дистрибьютора позволяет выявить пересекающиеся позиции. Также операция применяется для сверки базы интернет-магазина с файлами остатков на складе, что помогает своевременно актуализировать информацию о доступных для заказа товарах.
Вебмастеринг
При проведении технического аудита сайтов сравнение массивов применяется для анализа списков URL. Стандартный сценарий включает сопоставление списка адресов, полученных в результате сканирования сайта, с массивом URL из серверных логов. Результат такой операции демонстрирует, какие из существующих страниц ресурса реально посещаются поисковыми роботами. Дополнительно сверка URL используется при объединении нескольких карт сайта для нахождения дублирующихся путей.
Примеры входных данных и получаемых результатов для различных аналитических задач:
| Сфера применения | Первый массив данных | Второй массив данных | Результат операции |
|---|---|---|---|
| SEO | Ключевые слова конкурента А | Ключевые слова конкурента Б | Общие поисковые запросы |
| Аналитика | ID пользователей сегмента 1 | ID пользователей сегмента 2 | Аудитория на стыке сегментов |
| E-commerce | SKU из базы магазина | SKU из прайс-листа поставщика | Товарные позиции в наличии |
| Вебмастеринг | URL просканированных страниц | URL из логов сервера | Обойденные краулером страницы |
Порядок выполнения операции поиска общих строк
Процесс извлечения одинаковых записей из двух независимых текстовых массивов требует соблюдения определенной последовательности действий. Операция выполняется по шагам, начиная от загрузки исходных элементов и заканчивая экспортом готовой выборки.
- Ввод первого массива данных. Исходные текстовые строки помещаются в первую область ввода. Данные могут быть напрямую скопированы из столбцов электронных таблиц, неформатированных TXT-файлов или структурированных CSV-документов. Основное требование к массиву - каждый элемент должен располагаться на новой строке.
- Ввод второго массива данных. Во вторую область ввода помещается список, который будет выступать второй стороной для сопоставления. Структура этого массива должна быть полностью аналогична первой: перенос строки выступает единственным разделителем между записями.
- Инициация проверки на совпадения. После размещения обоих списков запускается операция сравнения. Запускается алгоритм построчной сверки, определяющий наличие каждого элемента первого массива во втором массиве.
- Получение результата. По завершении операции формируется итоговый список. Этот новый массив состоит исключительно из тех значений, которые были найдены одновременно в обоих исходных списках. Строки, присутствующие только в одном из массивов, отсекаются.
- Дальнейшее использование данных. Итоговый список дублирующихся значений доступен для копирования в буфер обмена. Полученный результат готов для экспорта обратно в табличные редакторы, базы данных или сторонние аналитические системы для проведения последующей работы.