Случайное изменение порядка строк текста применяется для получения новой, полностью непредсказуемой последовательности данных. Инструмент Qivrora выполняет эту операцию. Он перестраивает заданные списки. Исходная логика сортировки полностью устраняется.
Базовыми входными данными выступает многострочный текст.
Разделителем элементов служит обычный перенос строки. Программа обрабатывает загруженный массив и перемешивает позиции всех записей. Выходными данными являются те же строки, расположенные в случайном порядке. Текстовое содержимое каждого отдельного фрагмента сохраняется без изменений. Корректируется только итоговое расположение элементов.
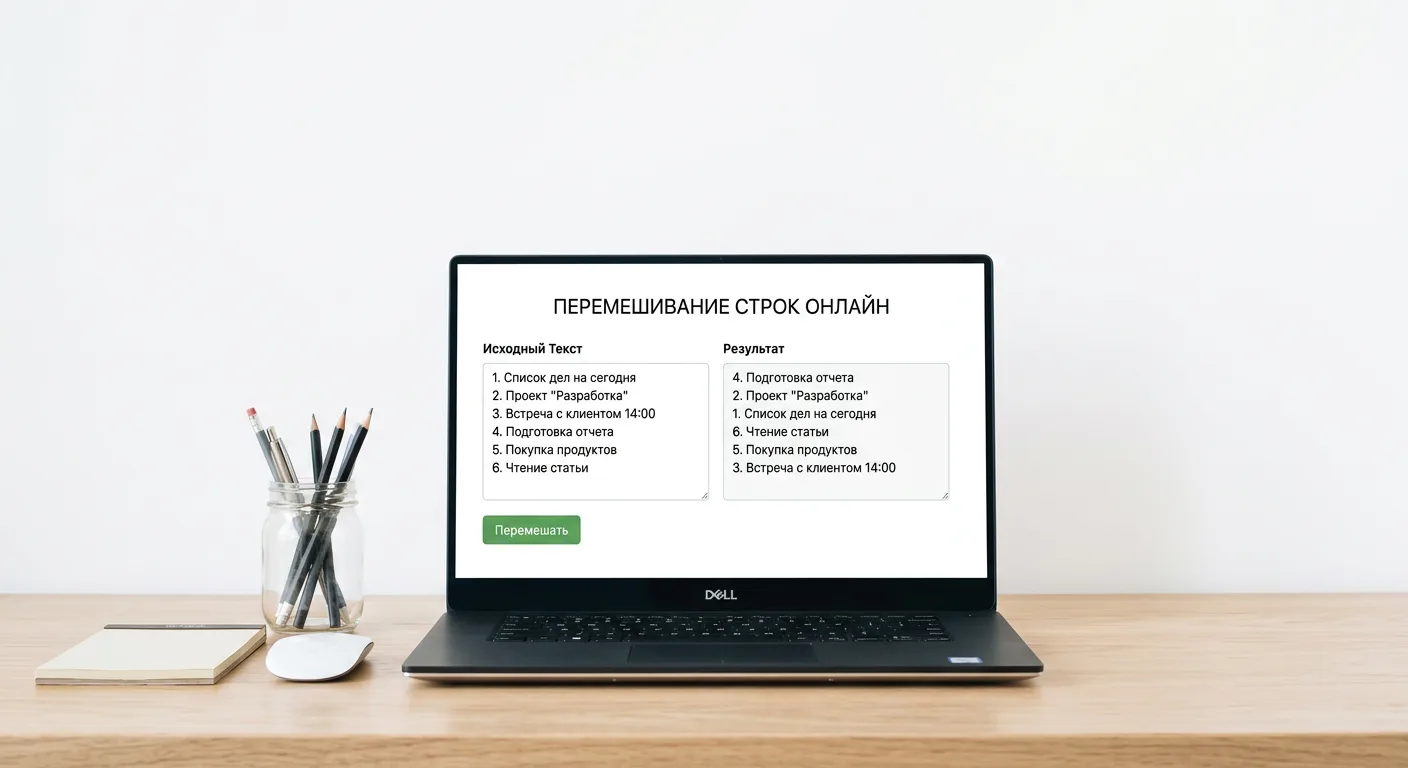
Принцип работы генератора случайных перестановок
Процесс рандомизации начинается с преобразования сплошного многострочного текста в структурированный массив данных. Текстовый ввод разделяется на отдельные элементы, где строгим разделителем выступает символ разрыва строки. Каждая строка становится самостоятельным объектом массива, что позволяет применять к ним математические операции позиционного сдвига.
Для изменения порядка элементов применяется алгоритм Фишера-Йейтса, также известный как тасование Кнута. Данная процедура обходит массив с конца к началу, обменивая текущий элемент со случайно выбранным элементом из оставшейся неперемешанной части списка. Выбор случайного индекса обеспечивается алгоритмами генерации псевдослучайных чисел, такими как функция Math.random. Применение алгоритма Фишера-Йейтса исключает системную предвзятость сортировки и обеспечивает равномерное распределение вероятностей для каждой новой позиции.
Равномерное распределение вероятностей математически гарантирует получение одной из n! возможных перестановок, где n обозначает общее количество строк в загруженном списке. Такая математическая модель обеспечивает полную независимость итоговой последовательности от первоначальной структуры переданных данных.
Логический цикл обработки текстового списка включает следующие этапы:
- Идентификация переносов строк и построение базового массива элементов.
- Генерация псевдослучайного значения для вычисления целевого индекса.
- Перемещение текущей строки на вычисленную позицию в пределах массива.
- Сборка итогового многострочного текста из обновленного массива.
При выполнении перестановок структурная целостность исходных записей строго сохраняется. Вычислительная логика оперирует исключительно индексами массива, определяющими порядковые номера. Исходные данные внутри самих строк не подвергаются парсингу, разделению, модификации или искажению.
Порядок рандомизации текстовых списков
Выполнение операции по изменению первоначальной последовательности записей состоит из трех этапов работы с данными. Процесс не требует предварительного форматирования содержимого самих строк, однако зависит от структуры текстового блока.
- Вставка исходного многострочного текста или списка элементов в поле ввода.
- Инициализация операции случайного перемешивания для запуска алгоритмической обработки.
- Получение итогового результата в виде текста с новой последовательностью записей.
В сгенерированном массиве каждая строка сохраняет свое точное содержимое, включая пунктуацию, регистр символов и внутренние пробелы. Трансформации подвергается исключительно позиция элемента в общей иерархии списка, что позволяет быстро копировать результат для дальнейшего применения.
Обработка пустых строк и разрывов
При подготовке исходных данных требуется учитывать специфику разделения элементов. Алгоритм идентифицирует элементы списка, опираясь строго на символы переноса строки. Пустые строки распознаются вычислительной логикой как полноценные элементы текстового массива.
Если в загружаемом тексте присутствуют двойные переносы, интервалы между абзацами или невидимые пустые строки в самом конце списка, они будут вовлечены в процедуру рандомизации наравне с текстовыми записями. После инициализации перемешивания эти пустые элементы изменят свои позиции и непредсказуемо распределятся внутри итогового результата, создавая визуальные разрывы в новом списке. Для формирования непрерывного текстового массива пустые строки следует удалить из исходного списка до начала операции.
Практические сценарии использования случайного порядка
Изменение позиций элементов в текстовом массиве применяется для решения задач, требующих устранения предвзятости или создания вариативности. Использование базовой операции перестановки строк позволяет адаптировать исходные списки под различные организационные, аналитические и образовательные процессы.
Проведение жеребьевок
Для определения случайной последовательности исходным массивом выступает список участников, где каждое имя, номер или идентификатор размещается с новой строки. Выполнение операции перемешивания формирует независимый непредсказуемый порядок записей. Данный подход применяется в следующих ситуациях:
- Определение очередности выступлений спикеров на мероприятиях.
- Беспристрастное распределение дежурств или типовых рабочих задач между сотрудниками.
- Случайная выборка записей из реестра для проведения независимого аудита.
SEO и сплит-тесты
При работе с семантическими ядрами и подготовке контента изменение порядка строк помогает исключить алгоритмическую и визуальную шаблонность массивов. Рандомизация текстовых списков востребована при подготовке данных для поисковой оптимизации и маркетинговых экспериментов.
- Формирование групп поисковых фраз для проведения A/B тестирования без привязки к их изначальной частотности, длине или алфавитной сортировке.
- Рандомизация списков переменных, синонимичных рядов и структурных блоков при шаблонном размножении текстов.
Подготовка тестов и опросников
При составлении экзаменационных билетов, квизов и анкет часто возникают неосознанные логические паттерны при расположении правильных вариантов. Обработка текстового списка устраняет человеческий фактор при форматировании проверочных материалов.
- Генерация уникальных вариантов одного тестирования посредством изменения общего порядка следования вопросов.
- Случайное распределение вариантов ответов внутри отдельного задания для предотвращения угадывания по шаблону.
Каждый из описанных сценариев опирается исключительно на функцию перераспределения позиций текстовых элементов. Решение задачи сводится к загрузке целевого списка, выполнению операции рандомизации и копированию полученного массива для дальнейшего использования в сторонней системе или документе.
Безопасность и локальная обработка данных в браузере
Обработка текстовых массивов базируется на архитектуре client-side. Вся логика изменения порядка строк выполняется с использованием JavaScript непосредственно в браузере. Вычислительные ресурсы локального устройства применяются для парсинга загруженного многострочного текста, выполнения перестановок и формирования итогового результата.
Исходные строковые данные не передаются на внешние серверы. Инструмент работает без облачных загрузок: скрипт не инициирует сетевые запросы для отправки текста на удаленные вычислительные узлы, не использует серверные хранилища для промежуточного кэширования и не обращается к сторонним сервисам. Процесс перемешивания полностью изолирован в оперативной памяти текущей сессии.
Отсутствие этапа транзита информации по сети устраняет риски перехвата данных. Автономная работа локального скрипта делает инструмент применимым для задач, требующих строгого соблюдения конфиденциальности.
Изолированная среда выполнения JavaScript обеспечивает безопасную рандомизацию следующих категорий информации:
- Внутренние списки, закрытые служебные реестры и инвентаризационные ведомости.
- Клиентские данные, включая экспортированные массивы идентификаторов и контактных сведений.
- Приватные текстовые последовательности, неопубликованные материалы и конфиденциальные проверочные блоки.