Выявление повторяющихся адресов в sitemap решает задачу технической проверки XML-документов, предназначенных для обхода поисковыми роботами. Инструмент выполняет точный поиск дубликатов URL внутри загруженной карты сайта. На вход подается стандартный файл sitemap.xml. Анализатор сканирует его структуру и выделяет идентичные ссылки.
Механика обнаружения основана на синтаксическом парсинге структуры файла. Обработчик считывает предоставленный XML-документ и последовательно обходит дерево элементов, чтобы извлечь строковые значения из каждого тега <loc>. Эти узлы содержат целевые абсолютные адреса. Собранный массив ссылок проходит процедуру дедубликации путем точного посимвольного сравнения. Система ищет полные совпадения путей, игнорируя при этом любые смежные директивы и метаданные.
Результатом операции становится выгрузка найденных копий. Выведенный список повторяющихся URL служит прямым указанием на ошибки при формировании текущего списка адресов.
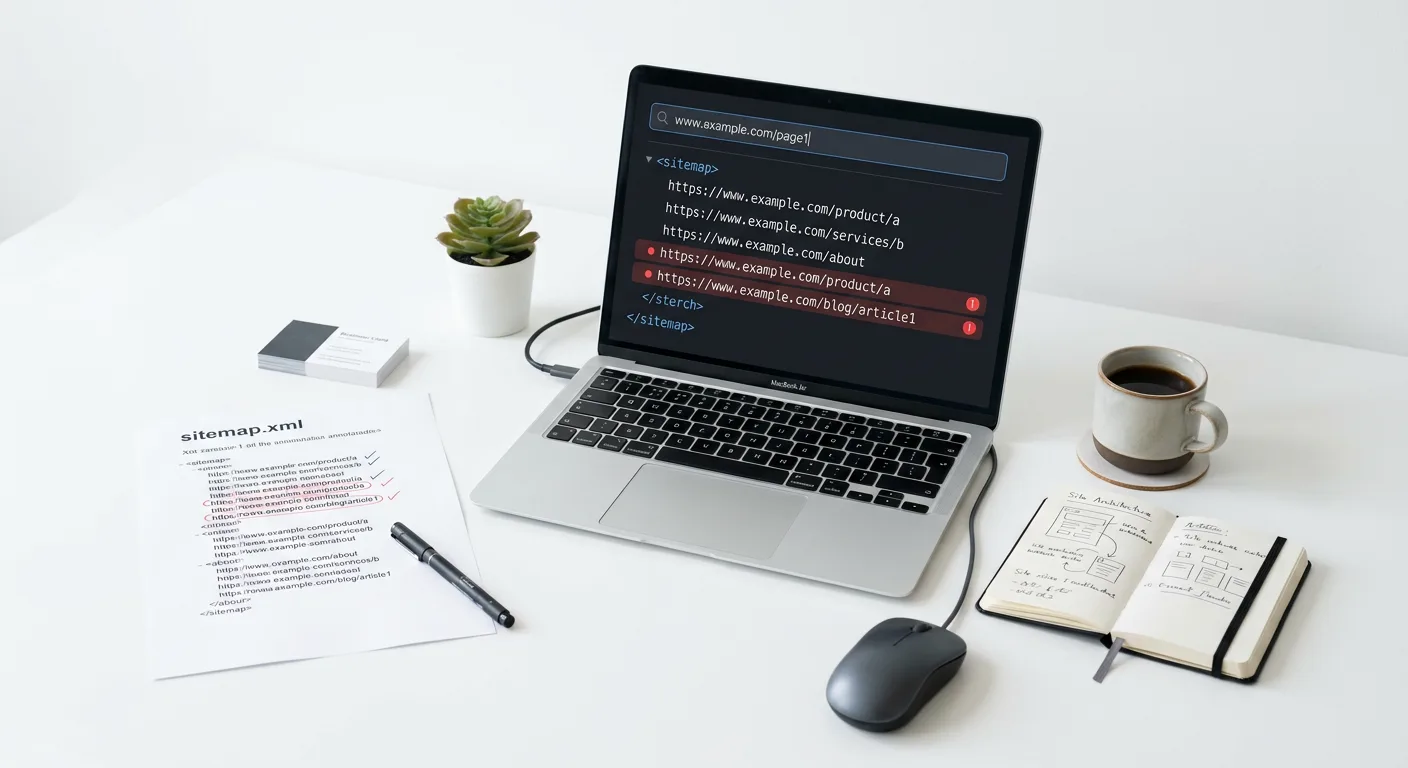
Синтаксис дубликатов в структуре XML Sitemap
Согласно спецификации протокола Sitemaps 0.90, каждый адрес внутри документа должен быть задекларирован в виде абсолютного URL. Это требует обязательного указания целевого протокола передачи данных и полного доменного имени. В рамках валидной карты сайта каждый абсолютный путь должен встречаться в дереве документа только один раз. Нарушение этого правила классифицируется как техническое дублирование, усложняющее обработку файла на стороне краулера.
При определении дубликатов процедура сопоставления учитывает исключительно текстовое содержимое, заключенное внутри тега <loc>. Спецификация позволяет сопровождать каждую ссылку дополнительными узлами, однако они не участвуют в проверке на уникальность. Теги <lastmod>, <changefreq> и <priority> полностью игнорируются. Если два идентичных абсолютных адреса имеют разные даты последней модификации или разные значения приоритета, они все равно считаются дубликатами на основании полного совпадения строки внутри <loc>.
Форматирование URL и технические копии
Несогласованность алгоритмов формирования списка адресов приводит к тому, что одна и та же физическая страница экспортируется в XML-документ под разными абсолютными путями. Различия в синтаксисе создают самостоятельные строки, которые формируют технические дубли. Расхождения в форматировании делятся на следующие категории:
- Протоколы соединения: одновременное присутствие в файле ссылок, начинающихся с http и https.
- Алиасы поддоменов: включение в один список адресов с префиксом www и версий домена без данного префикса.
- Синтаксис завершения пути: генерация ссылок, часть из которых оканчивается на закрывающий слеш, в то время как другие представлены без него.
- Динамические компоненты: добавление GET-параметров к базовому статичному адресу.
Любое из перечисленных синтаксических отклонений меняет исходную строку адреса. Присутствие таких вариаций в пределах одного узла urlset является прямым нарушением логики построения списка, так как создает избыточные записи для единого документа.
Влияние невалидных данных на краулинговый бюджет
Файлы sitemap выполняют функцию прямого маршрутизатора для поисковых систем. При обращении к XML-документу краулеры, такие как Googlebot или паук Яндекса, считывают содержимое узла urlset и помещают извлеченные адреса в очередь на обход. Наличие дублирующихся записей приводит к искажению этой очереди и нецелевому расходу вычислительных ресурсов поисковых роботов.
Ограничения спецификации sitemaps.org
Официальный протокол устанавливает жесткие лимиты на физические параметры одного XML-файла. Документ не должен содержать более 50 000 URL-адресов, а его размер в распакованном виде ограничен 50 МБ. Технические дубликаты искусственно раздувают объем файла.
При достижении пороговых значений возникает необходимость внедрения sitemapindex и дробления карты на несколько дочерних файлов. Если значительная доля строк занята невалидными копиями, архитектура карты сайта необоснованно усложняется. Это требует дополнительных серверных ресурсов на генерацию, хранение и обновление множественных документов, которых можно было бы избежать при чистом списке адресов.
Механика истощения лимита обхода
Краулинговый бюджет представляет собой ограниченное количество страниц, которое поисковый робот готов просканировать на конкретном домене за определенный промежуток времени. Попадание повторяющихся ссылок из тегов <loc> в очередь сканирования вызывает ряд негативных технических последствий:
- Потеря емкости сканирования: робот тратит выделенный лимит на загрузку идентичного контента по разным путям вместо обхода новых разделов.
- Задержка индексирования: уникальные документы дольше ожидают своей очереди на сканирование и добавление в базу данных поисковой системы.
- Избыточная нагрузка на сервер: краулеры генерируют лишние HTTP-запросы к одним и тем же физическим страницам, обрабатывая их как независимые сущности.
- Размытие сигналов: поисковой системе приходится тратить дополнительные ресурсы на анализ контента для определения канонической версии страницы среди множества просканированных вариантов.
Дедубликация списка адресов перед отдачей файла поисковым системам обеспечивает максимальную плотность полезных данных. Передача ботам исключительно уникальных абсолютных путей позволяет целесообразно расходовать краулинговый бюджет и напрямую влияет на скорость обнаружения приоритетных страниц сайта.
Парсинг и механика извлечения адресов
Процесс выявления дубликатов базируется на последовательном синтаксическом анализе XML-документа и извлечении целевых данных. Операция Data Extraction исключает анализ визуального или текстового контента самих веб-страниц, сосредотачиваясь исключительно на структуре файла и значениях конкретных узлов разметки.
Извлечение данных и навигация по структуре
Обработка структурированных данных требует соблюдения стандартов кодирования и чтения форматов. Механика обхода единичной карты сайта включает следующие этапы:
- Идентификация формата: файл считывается и обрабатывается как application/xml или text/xml с обязательным использованием кодировки UTF-8 для корректного распознавания спецсимволов.
- Обход дерева документа: осуществляется последовательная навигация по иерархии XML-кода от корневого элемента вниз по дереву.
- Локализация узлов: алгоритм выполняет поиск всех контейнеров <url>, игнорируя посторонние элементы пространств имен и служебные теги.
- Извлечение значений: из каждого найденного контейнера извлекается строковое содержимое вложенного тега <loc>, содержащего абсолютный путь.
Обработка индексных карт сайта
При обнаружении корневого элемента <sitemapindex> логика обхода адаптируется под многоуровневую архитектуру. В индексных файлах адреса конечных страниц отсутствуют, поэтому парсинг переключается на извлечение путей к дочерним документам.
Вместо поиска узлов <url> происходит обход контейнеров <sitemap>. Из их вложенных тегов <loc> извлекаются ссылки на зависимые карты сайта, которые обычно имеют расширение .xml или формат архива .xml.gz. После получения путей к дочерним документам инициируется их загрузка и распаковка. Процесс поиска тегов <url> и извлечения адресов конечных страниц повторяется для каждого отдельного файла, формируя единый пул строковых значений для последующего анализа.
Алгоритм точного строкового сравнения
Собранный массив извлеченных путей подвергается процедуре дедубликации. Поиск совпадений опирается на точное строковое сравнение текстовых значений, полученных на предыдущих этапах.
Каждый извлеченный адрес проверяется на предмет полной идентичности с другими элементами общего массива. Сравнение происходит посимвольно с учетом регистра, всех параметров и завершающих символов. Логика дедубликации строится на следующих принципах:
- Формирование пула данных: все извлеченные строки помещаются в единую структуру, независимо от того, из какого именно дочернего файла они были получены.
- Поиск пересечений: выполняется посимвольная сверка каждой строки со всеми остальными элементами пула.
- Регистрация совпадений: при обнаружении двух и более абсолютно идентичных строк адрес фиксируется как технический дубль.
- Агрегация результатов: найденные совпадения группируются, формируя итоговый список повторяющихся URL с указанием частоты их появления.
Итоговый список содержит исключительно те адреса, которые встречаются в проанализированном дереве XML-кода более одного раза. Этот перечень предоставляет точную выжимку избыточных данных, очищенную от уникальных путей, что позволяет сфокусироваться на конкретных проблемных узлах карты сайта.
Практические сценарии технического SEO-аудита
Выявление избыточных узлов в структуре карты сайта необходимо для локализации сбоев на стороне сервера или системы управления контентом. Полученный перечень дубликатов применяется инженерами и вебмастерами для диагностики архитектурных ошибок маршрутизации и настройки алгоритмов выгрузки данных. Существует несколько типичных ситуаций, при которых анализ на наличие повторяющихся путей становится основным инструментом контроля валидности XML-структуры.
Миграция на HTTPS и смена имени хоста
В процессе перевода ресурса на защищенный протокол или при переезде на новый домен часто возникают переходные конфликты генерации. Скрипты, формирующие XML-документ, могут временно обращаться к устаревшим или кэшированным записям базы данных. В результате в итоговый файл одновременно выгружаются старые HTTP-адреса и их новые HTTPS-версии, либо возникают cross-domain дубли, содержащие фрагменты предыдущего имени хоста. Идентификация таких пересечений позволяет обнаружить компоненты системы, которые продолжают отдавать устаревшие префиксы протокола или домена.
Ошибки выгрузки CMS в e-commerce
Платформы электронной коммерции генерируют множество динамических путей в зависимости от навигации пользователя. Распространенной архитектурной проблемой CMS является отсутствие строгой фильтрации при экспорте товарных матриц в карту сайта. В таких случаях в генератор попадают параметрические URL вместе с чистыми адресами страниц. Перечень таких избыточных данных обычно включает:
- Идентификаторы применяемых пользовательских фильтров в каталоге.
- Динамические параметры сортировки товарной выдачи.
- Технические переменные и индикаторы пагинации.
Обнаружение дублирующихся базовых путей с прикрепленными строками запроса сигнализирует о необходимости внедрения жестких правил исключения динамических параметров при обходе дерева сайта.
Ручное слияние индексных файлов
При сложной архитектуре проекта данные могут агрегироваться из нескольких независимых источников. Выгрузки из основного сайта и отдельного подраздела, например, корпоративного блога, иногда объединяются в единый корневой тег urlset вручную или с помощью простых промежуточных скриптов-агрегаторов. Отсутствие процедуры предварительной дедубликации при таком слиянии приводит к прямому пересечению URL, когда одни и те же сквозные страницы или категории включаются в итоговый документ из разных исходных карт.
Корректировка алгоритмов генерации
Во всех описанных сценариях собранный перечень повторяющихся адресов служит точным диагностическим материалом. Итоговый список дубликатов используется вебмастерами для внесения целенаправленных изменений в логику работы бэкенда. На базе этих данных производится корректировка скриптов генерации sitemap, настройка корректных правил формирования абсолютных путей и внедрение фильтров для отсечения невалидных параметрических узлов строго до этапа записи конечного файла.