Автоматизированная проверка текстов ссылок на странице начинается с загрузки указанного URL и парсинга его исходного кода. Инструмент решает задачу полного сбора навигационных элементов документа.
Алгоритм последовательно анализирует HTML-структуру. При обходе DOM-дерева система идентифицирует каждый HTML-тег a. Происходит извлечение абсолютно всех гиперссылок, заложенных в коде. Собираются внутренние переходы по сайту и внешние указатели на сторонние ресурсы.
Для каждого найденного элемента фиксируются конкретные параметры. Считывается целевой адрес перехода из атрибута href. Одновременно извлекается текстовое содержимое, расположенное между открывающим и закрывающим тегами.
Собранный массив данных агрегируется. Результатом работы парсера становится сводная статистика распределения текстов привязки по всему проверяемому документу.
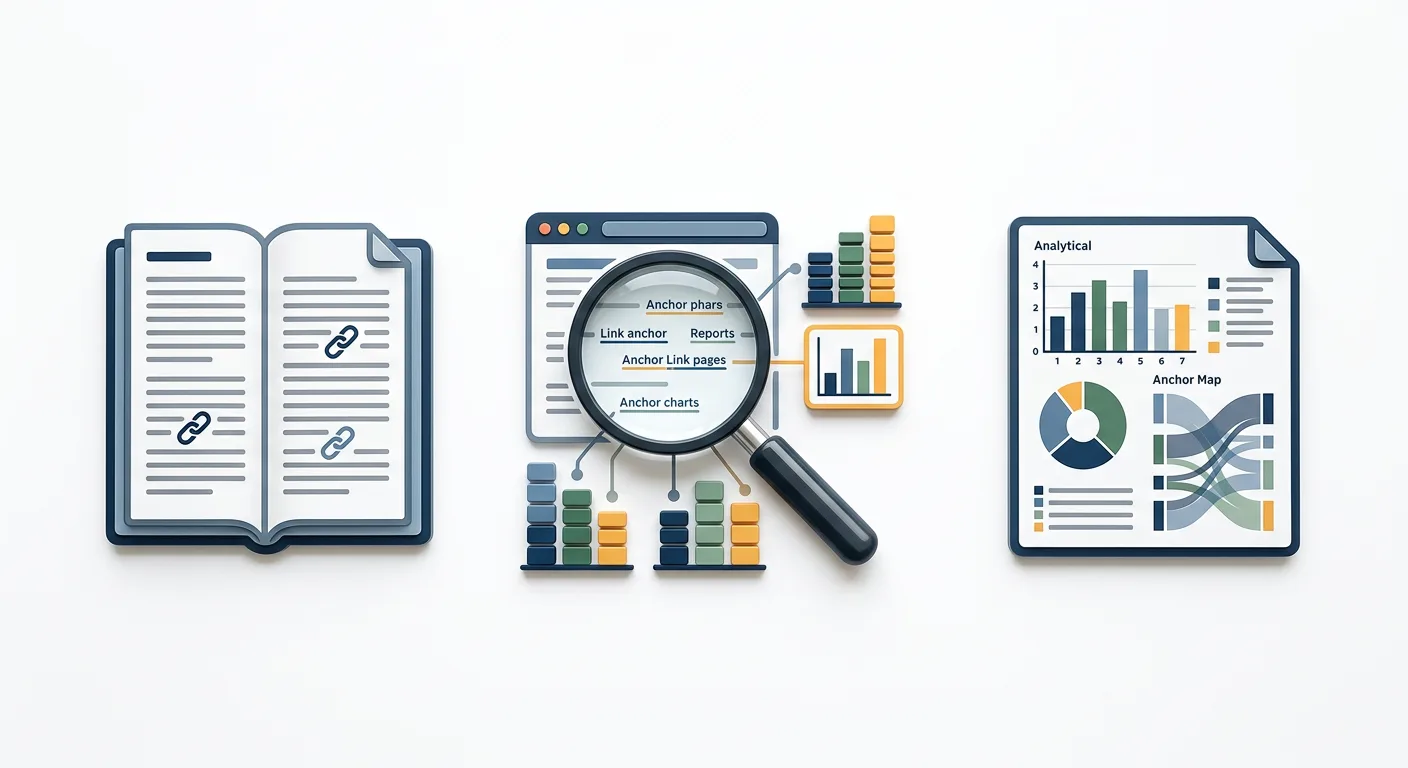
Механика извлечения ссылочных элементов: теги, атрибуты и текстовое окружение
Процесс обработки локализованных навигационных узлов требует детального разбора содержимого каждого тега a. Извлечение данных происходит на уровне атрибутов и вложенных узлов документа. Базовый сценарий обработки текстовой ссылки включает чтение значения атрибута href для определения целевого URL и захват символьной последовательности, расположенной между открывающим и закрывающим тегами. Эта последовательность формирует основной текст привязки.
При анализе графических гиперссылок применяется специализированная логика извлечения. Если внутри тега a расположен тег img, стандартный текстовый узел отсутствует. В таких ситуациях сканируется атрибут alt вложенного изображения. Содержимое этого атрибута извлекается и обрабатывается как полноценный текст привязки, поскольку именно оно передает текстовое описание графического перехода. При пустом или отсутствующем атрибуте alt элемент идентифицируется как графическая ссылка без анкора.
Параллельно со сбором базовых адресов и анкоров происходит считывание вспомогательных параметров ссылочного элемента. Извлекается значение атрибута title, содержащее дополнительную информацию о целевом документе. Также выполняется фиксация околоссылочного текста. Алгоритм захватывает фрагменты текстового окружения, расположенные в исходном коде непосредственно перед тегом a и сразу после него. Захват окружающего текста необходим для последующей оценки тематического контекста размещения гиперссылки внутри абзаца, списка или структурного блока.
Обработка каждого элемента в DOM-дереве формирует стандартизированный набор параметров:
- Целевой адрес перехода, полученный из атрибута href.
- Текст привязки, извлеченный из внутреннего текстового узла тега a.
- Альтернативный текст из атрибута alt в случае использования изображений-ссылок.
- Вспомогательные данные из атрибута title.
- Фрагменты текстового окружения до и после гиперссылки.
Классификация извлечённых анкоров по типам вхождений
После завершения сбора текстовых узлов и атрибутов графических элементов полученный массив данных подлежит сегментации. Группировка текстов привязки позволяет структурировать ссылочный профиль страницы, разделяя гиперссылки на логические категории в зависимости от используемых слов, фраз и символов.
Коммерческие SEO-анкоры
Данный сегмент включает гиперссылки, текст которых содержит продвигаемые поисковые запросы в неизменном виде. Это прямое вхождение, или точные ключи, цель которых - передать целевому документу максимальную текстовую релевантность по конкретному запросу. При классификации такие паттерны идентифицируются по полному совпадению текста привязки с целевой коммерческой фразой без добавления вспомогательных элементов или знаков.
Разбавленные анкоры
Для создания вариативного ссылочного профиля применяются измененные словосочетания. В эту категорию попадают тексты ссылок, содержащие частичное вхождение основного запроса. Группа разбавленных анкоров включает следующие подтипы:
- Словоформы - использование базового ключа с изменением падежа, числа или склонения.
- Смешанные анкоры - интеграция коммерческого запроса с поясняющими словами, предлогами, топонимами или дополнительными информационными терминами внутри одной гиперссылки.
- LSI-анкоры - применение синонимов и тематически связанных терминов, которые формируют релевантный семантический контекст без использования прямого вхождения.
Естественные анкоры
Категория естественных ссылок состоит из паттернов, в которых отсутствуют коммерческие маркеры. Идентификация таких элементов базируется на выявлении конструкций, характерных для органического цитирования. В этот сегмент входят:
- Брендированные анкоры - тексты, содержащие название компании, торговой марки, наименование конкретного продукта или имя автора контента.
- Навигационные анкоры - слова и короткие фразы, указывающие на функциональный или служебный раздел сайта, такие как "Главная", "Контакты", "Каталог".
- Голые URL - безанкорные ссылки, в которых текстом привязки выступает сам адрес целевой страницы, выведенный в исходном виде.
- Генерики - общие фразы, не имеющие самостоятельной семантической ценности в отрыве от околоссылочного окружения. К ним относятся конструкции "здесь", "источник", "подробнее", "перейти по ссылке".
Инструмент позволяет группировать извлеченные паттерны, соотнося каждый найденный текст ссылки с соответствующей категорией. Процесс сегментации преобразует неструктурированный список спарсенных данных в упорядоченную сводку. Распределение текстов по типам вхождений дает возможность вычислить процентную долю точных ключей, разбавленных фраз, брендовых упоминаний и безанкорных URL в общем объеме гиперссылок исходной страницы.
Анализ директив индексирования: dofollow, nofollow, sponsored и ugc
В процессе извлечения анкорных текстов обязательным этапом выступает проверка атрибута rel в ссылочных тегах. Данный атрибут содержит инструкции для краулеров поисковых систем, определяя правила сканирования целевого URL и условия передачи статического веса от страницы-донора к странице-акцептору. Фиксация значений этого параметра позволяет точно классифицировать элементы ссылочного графа и оценить их влияние на ранжирование.
По умолчанию, если атрибут rel полностью отсутствует в структуре гиперссылки или не содержит специфических директив, ссылка классифицируется как dofollow. При таком сценарии поисковые роботы переходят по указанному адресу, а исходная страница делится частью своего ссылочного веса с целевым документом. Наличие явных ограничивающих маркеров меняет логику обработки элемента алгоритмами индексирования.
В современных стандартах разметки выделяются три основные директивы, ограничивающие или специфицирующие передачу веса:
- nofollow - базовая директива, указывающая поисковым системам на отсутствие рекомендательной связи между донором и акцептором. Применяется для ссылок, которые не должны участвовать в расчете ссылочного ранжирования целевой страницы.
- sponsored - спецификатор коммерческих размещений. Используется для разметки рекламных баннеров, партнерских материалов и платных обзоров, явно указывая алгоритмам на неорганическую природу гиперссылки.
- ugc - маркер пользовательского контента. Интегрируется в ссылки, оставленные посетителями ресурса в комментариях, на форумах или в немодерируемых разделах, защищая домен-донор от санкций за возможный линкспам.
Передача статического веса напрямую зависит от распределения этих директив. Элементы dofollow направляют доступный ссылочный капитал страницы-донора ко всем открытым акцепторам. Напротив, ссылки с атрибутами nofollow, sponsored и ugc блокируют передачу авторитетности, де-факто изолируя целевые страницы от потока веса, хотя сами краулеры могут использовать эти URL для обнаружения новых документов.
Для объективной оценки распределения веса гиперссылок требуется строгая фильтрация собранного массива данных по параметрам атрибута rel. Включение в расчеты заблокированных директивами ссылок искажает метрики внутренней перелинковки и внешнего профиля. Сегментация списка на передающие и изолирующие паттерны позволяет рассчитать точный объем анкоров, фактически участвующих в передаче релевантности целевым страницам, отсекая технический шум и коммерческие интеграции.
Оценка внутренней перелинковки и распределения статического веса
Извлеченный массив данных применяется для глубокого аудита архитектуры ресурса. В рамках такого анализа проверяемый URL выступает в роли страницы-донора. Каждая найденная внутренняя гиперссылка без блокирующих директив представляет собой канал, по которому статический вес и тематическая релевантность передаются целевым документам сайта - страницам-акцепторам.
Текст привязки внутренних ссылок служит важнейшим сигналом для поисковых алгоритмов, определяющим смысловой контекст целевого адреса. Изучение списка анкоров, направленных на внутренние разделы, позволяет оценить, насколько корректно страница-донор распределяет свой ссылочный капитал и поддерживает семантическую структуру сайта.
Диагностика передачи релевантности
Важным этапом оценки внутренней навигации является поиск дисбаланса в текстах ссылок. Анализ собранного анкор-листа помогает выявить признаки переоптимизации внутренней перелинковки. Если страница-донор транслирует на акцепторы избыточное количество гиперссылок с одинаковым прямым вхождением ключей, алгоритмы ранжирования могут расценить это как попытку искусственной манипуляции релевантностью. Подобные спамные паттерны часто генерируются некорректно настроенными модулями перелинковки, перегруженными сквозными меню или избыточным выделением ключевых фраз в контенте.
Противоположной проблемой является острый недостаток анкоров с точным вхождением, что приводит к упущенной выгоде при ранжировании целевых страниц. Если массив внутренних ссылок донора состоит преимущественно из общих фраз, навигационных маркеров или голых URL, страницы-акцепторы получают порцию статического веса, но лишаются текстового усиления. Для эффективной передачи релевантности требуется присутствие описательных текстов привязки, прямо указывающих на тематику акцептора.
Детализированный срез данных по внутренним гиперссылкам используется для контроля следующих структурных параметров:
- Оценка контекстной связности - проверка семантического соответствия между текстом анкора на странице-доноре и интентом страницы-акцептора.
- Предотвращение каннибализации запросов - обнаружение архитектурных ошибок, при которых идентичный целевой анкор используется для ссылок на совершенно разные страницы акцепторов.
- Балансировка коммерческих сигналов - выявление перекоса в сторону жестких SEO-анкоров и планирование их разбавления синонимами или LSI-фразами для придания естественности внутренней ссылочной массе.
Корректировка текстов ссылок на основе полученной статистики помогает направить потоки статического веса на приоритетные посадочные страницы, формируя безопасную и понятную для краулеров топологию сайта.
Аудит исходящих внешних ссылок: выявление ссылочного спама
Анализ ссылочного профиля страницы требует обязательного разделения извлеченного массива данных по признаку целевого хоста. Фильтрация списка гиперссылок, при которой выделяются все URL с доменами, отличными от корневого домена анализируемого документа, позволяет сформировать пул исходящих внешних ссылок. Этот сегмент данных необходим для контроля качества внешнего ссылочного окружения и диагностики технической безопасности веб-ресурса.
Проверка текстов привязки внешних ссылок направлена на выявление скрытого линкспама, неконтролируемого размещения коммерческих анкоров и связи с токсичными ресурсами. Исходящая гиперссылка передает часть статического веса страницы внешнему акцептору, формируя семантическую связь между донором и получателем. Появление нерелевантных, неестественных или откровенно спамных текстов ссылок в контенте часто является признаком компрометации CMS, внедрения вредоносного кода или отсутствия модерации в блоках UGC.
Сегментация исходящих ссылок применяется для решения следующих диагностических задач:
- Обнаружение скрытых инъекций - идентификация анкоров, типичных для взломанных сайтов, которые программно внедряются злоумышленниками в DOM-дерево и могут быть скрыты от визуального просмотра через CSS, но остаются доступными для краулеров.
- Локализация токсичных ссылок - выявление текстов привязки, ведущих на домены с плохой репутацией, спам-сети или ресурсы, нарушающие базовые принципы поиска, что формирует негативное ссылочное соседство.
- Контроль коммерческих вхождений - аудит анкоров, содержащих явные транзакционные маркеры, для оценки рисков признания страницы узлом по продаже ссылок.
Релевантность ссылок, уходящих с документа, напрямую влияет на оценку качества самого сайта-донора. Поисковые системы применяют санкции к ресурсам, участвующим в схемах обмена ссылочным весом или массовом распространении спама. Высокая концентрация жестких коммерческих SEO-анкоров среди исходящих ссылок является триггером для пессимизации за продажные ссылки или применения алгоритмов, подобных АГС, которые исключают сайт из доверенной базы. Изоляция внешних доменов в результатах парсинга позволяет своевременно очистить код страницы от деструктивных элементов и минимизировать риски алгоритмического понижения позиций.
Интерпретация облака анкоров и диагностика переоптимизации
Агрегация извлеченных текстов ссылок формирует частотный словарь, который в практике поисковой оптимизации называется облаком анкоров. Этот массив данных отражает количественное распределение уникальных текстовых вхождений в пределах анализируемого документа. Сопоставление частотности каждого текста привязки позволяет оценить структуру ссылочного профиля страницы с точки зрения поисковых алгоритмов и выявить отклонения от стандартов естественного контента.
Анализ частотного словаря направлен на обнаружение аномалий, классифицируемых алгоритмами ранжирования как поисковый спам. Естественная структура гиперссылок характеризуется широким спектром уникальных фраз, тогда как искусственная генерация или агрессивная оптимизация формируют легко распознаваемые алгоритмами паттерны.
Признаки заспамленности ссылочного графа страницы включают следующие метрики распределения:
- Аномальная плотность коммерческих вхождений - доминирование в облаке одинаковых транзакционных фраз без должного разбавления синонимами или нейтральными словами.
- Нарушение естественности ссылочной массы - критический дисбаланс, при котором доля анкоров с точным вхождением ключевого запроса значительно превышает объем навигационных, брендовых и других безанкорных конструкций.
- Сквозной переспам - многократное дублирование одного и того же SEO-анкора в различных структурных блоках документа, создающее избыточный текстовый вес по одному узкому кластеру запросов.
Поисковые системы непрерывно анализируют агрегированные данные текстов привязки для выявления манипуляций. Высокая концентрация спамных конструкций в анкорном облаке является прямым сигналом для применения алгоритмических санкций, снижающих видимость ресурса.
Выявление аномальных анкорных паттернов требует немедленной корректировки из-за рисков алгоритмической пессимизации. Основные фильтры, реагирующие на манипуляции с текстами ссылок:
| Алгоритм или фильтр | Триггер пессимизации | Последствия для документа или хоста |
|---|---|---|
| Google Penguin | Систематическое использование неестественных коммерческих анкоров, высокая плотность точных ключей в ссылочном профиле. | Обесценивание ссылочного веса, локальное снижение позиций конкретных страниц или деиндексация при масштабных нарушениях. |
| Яндекс.Минусинск | Агрессивное использование SEO-анкоров для искусственного влияния на ранжирование по коммерческим запросам. | Жесткое ограничение в ранжировании всего домена на длительный срок с критической потерей поискового трафика. |
| Фильтр за переоптимизацию | Локальный переспам ключевыми словами в текстах внутренних ссылок, нарушающий читабельность контента. | Понижение позиций конкретного документа по группе запросов, соответствующих переоптимизированным вхождениям. |
Диагностика частотного словаря позволяет своевременно локализовать ссылочный спам до момента обновления поисковых баз. Корректировка анкорного облака путем замены жестких коммерческих ключей на LSI-фразы, релевантные текстовые описания или безанкорные элементы нормализует распределение плотности. Восстановление баланса между типами ссылок минимизирует риски алгоритмического давления и стабилизирует ранжирование документа.