Преобразование текста в HTML-разметку переводит неформатированные символьные массивы в структурированный код. На входе система принимает строки обычного текста, лишенные семантической разметки. Выходным результатом является валидная структура, полностью готовая к интеграции в веб-документы.
Браузеры не распознают визуальное форматирование. Обычные переносы строк и отступы игнорируются при рендеринге.
Основная задача инструмента заключается в приведении контента к стандарту, который корректно интерпретируется клиентскими приложениями и поисковыми роботами. Алгоритм анализирует логические блоки plain text и генерирует соответствующий синтаксис. Полученный чистый HTML исключает ошибки отображения и может быть напрямую импортирован в базы данных или шаблоны.
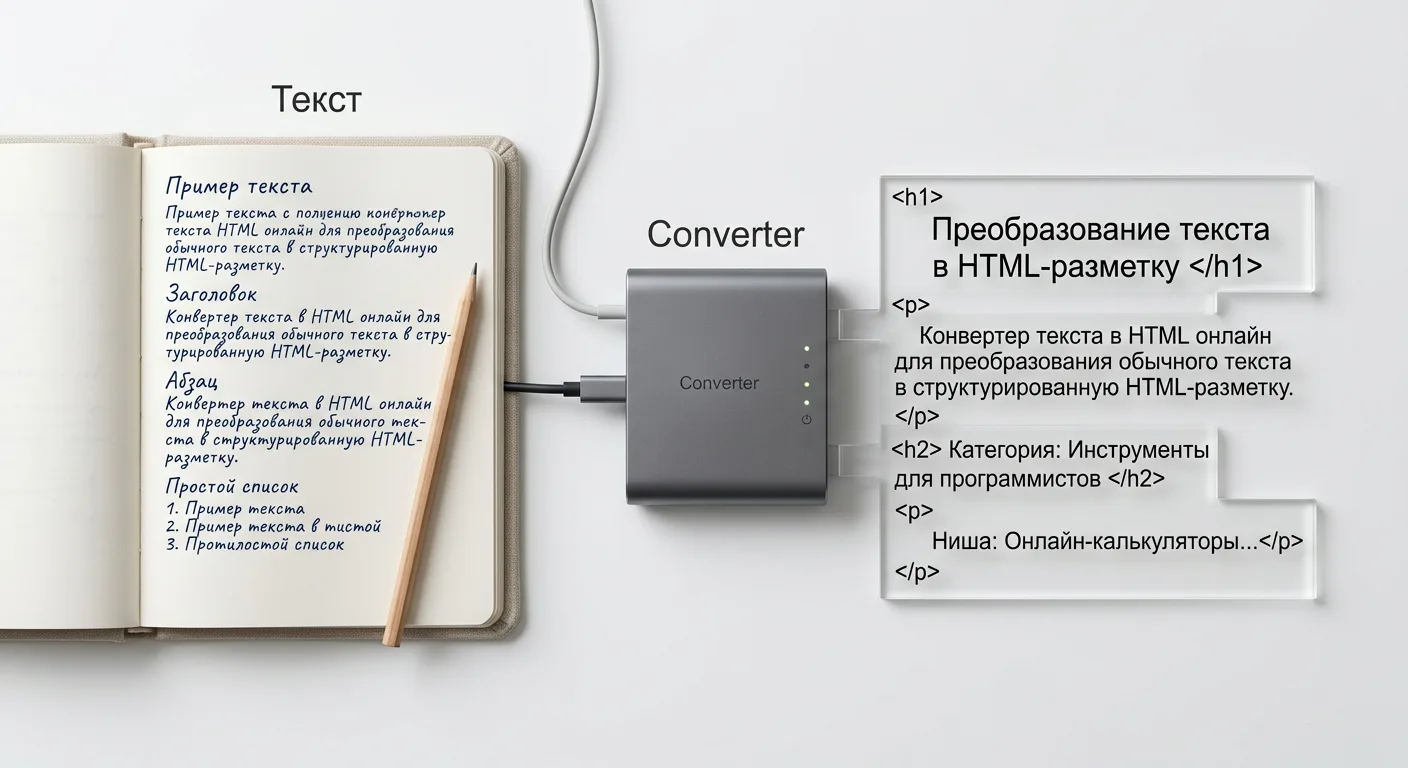
Принципы парсинга текста и генерации базовой HTML-разметки
Процесс синтаксического разбора неформатированного текста строится на поиске специфических паттернов переноса каретки и разделителей. Алгоритм проходит по исходному символьному массиву, идентифицируя логические границы блоков. В основе преобразования лежит система правил, которая сопоставляет невидимые управляющие символы plain text с соответствующими структурными элементами веб-документа.
Ключевым этапом генерации разметки является обработка разрывов строк. В исходном тексте абзацы обычно отделяются друг от друга двойным переводом каретки, тогда как одиночный перенос используется для разрыва строки внутри одной смысловой единицы. Парсер анализирует эти последовательности для формирования правильных тегов, определяющих геометрию контента.
Правила трансляции текстовых структур в HTML-код подчиняются следующей логике:
-
Последовательности из двух и более символов переноса строки интерпретируются как границы абзацев. Текст между такими границами оборачивается в парные теги
<p>и</p>. -
Одиночные символы возврата каретки внутри распознанного абзаца трансформируются в пустые теги
<br>, сохраняя визуальное деление без создания нового блочного контейнера. - Избыточные пробелы и множественные пустые строки по краям логических блоков отсекаются для предотвращения генерации пустых текстовых узлов.
Синтаксический разбор простого текста формирует базовую иерархию элементов для последующего рендеринга в DOM. Браузер выстраивает объектную модель документа исключительно на основе вложенности тегов. Преобразование плоского текста в узлы абзацев создает валидную древовидную структуру, где каждый логический блок становится независимым элементом.
Базовое соответствие управляющих символов и генерируемой разметки представлено ниже:
| Последовательность plain text | Сгенерированный тег | Влияние на структуру DOM |
|---|---|---|
| Одиночный перенос строки |
<br>
|
Принудительный перенос на новую строку внутри текущего текстового узла |
| Двойной перенос строки |
<p>...</p>
|
Создание нового независимого элемента уровня абзаца |
Применение данных алгоритмических принципов гарантирует, что логическая структура исходного материала будет сохранена после обработки движком клиентского приложения. Отсутствие незакрытых тегов и правильная изоляция текстовых фрагментов исключают смешивание соседних элементов и обеспечивают предсказуемое поведение CSS-правил, которые будут применяться к полученному коду.
Экранирование символов и конвертация в HTML-сущности
Преобразование плоского текста требует не только создания структурных тегов, но и безопасной обработки самого содержимого. В исходном тексте часто присутствуют символы, которые совпадают с синтаксическим аппаратом разметки. Если оставить их в первозданном виде, парсер браузера может воспринять их как часть управляющего кода, что приведет к разрушению иерархии DOM или потере пользовательских данных.
Процесс экранирования заключается в алгоритмической замене служебных знаков на их безопасные эквиваленты - HTML-сущности. Это специальные последовательности, которые начинаются с амперсанда и заканчиваются точкой с запятой. Они интерпретируются движком рендеринга исключительно как визуальный текст, а не как команды разметки.
Основной набор символов, подлежащих обязательной конвертации, включает знаки, напрямую участвующие в формировании тегов и атрибутов:
| Исходный спецсимвол | Сгенерированная HTML-сущность | Техническое назначение замены |
|---|---|---|
&
|
&
|
Предотвращает ложную инициализацию других сущностей |
<
|
<
|
Исключает случайное открытие нового HTML-тега |
>
|
>
|
Исключает преждевременное закрытие текущего элемента |
"
|
"
|
Защищает границы строковых значений и атрибутов |
Наличие математических знаков или фрагментов программного кода в обычном тексте регулярно создает ситуации, когда парсер сталкивается с неоднозначностью. Например, запись математического неравенства без экранирования заставляет браузер искать несуществующий тег, следующий сразу за знаком «меньше». Конвертация таких символов устраняет конфликты с синтаксисом HTML на этапе построения документа.
Техническая необходимость применения данного шага обусловлена следующими архитектурными факторами:
- Предотвращение ошибок синтаксического разбора, при которых браузер некорректно разграничивает текстовые узлы и структурные элементы.
- Сохранение целостности исходной информации, гарантирующее, что ни один печатный знак не будет проигнорирован алгоритмами рендеринга.
- Стабилизация вывода в кодировке Unicode, обеспечивающая точное отображение типографики независимо от локальных настроек системного шрифта на устройстве клиента.
Замена зарезервированных знаков на HTML-сущности формирует полностью изолированную и безопасную текстовую среду внутри сгенерированных узлов. Содержимое параграфов перестает влиять на логику обработки документа, выполняя исключительно информационную функцию.
Семантическое структурирование: блочные и строчные элементы
Преобразование неформатированного текста в HTML требует не только безопасного экранирования символов, но и построения строгой логической структуры документа. Исходные данные транслируются в иерархию семантических тегов, которые классифицируются на две основные категории в зависимости от их поведения в потоке рендеринга: блочные и строчные.
Блочные элементы формируют основной структурный каркас страницы. Они занимают всю доступную ширину родительского контейнера и создают визуальные разрывы строк до и после себя. В процессе конвертации к этой категории относятся следующие генерируемые теги:
-
p- определяет текстовые абзацы, являясь базовой единицей группировки предложений; -
div- выступает универсальным контейнером для объединения других структурных блоков; -
h1-h6- формируют иерархию заголовков, определяя уровень значимости разделов; -
blockquote- выделяет обособленные блоки цитирования.
Строчные элементы применяются для разметки фрагментов текста исключительно внутри блочных контейнеров. Они не нарушают текстовый поток, не создают новых строк и занимают пространство, ограниченное только их содержимым. Основные представители этой группы:
-
span- нейтральный строчный контейнер без встроенной семантики; -
strong- указывает на логическую важность и высокую значимость выделенного фрагмента; -
em- добавляет семантическое смысловое ударение к конкретным словам.
| Характеристика | Блочные элементы | Строчные элементы |
|---|---|---|
| Поведение в потоке | Занимают 100% ширины родительского элемента | Размещаются в строку друг за другом |
| Перенос строки | Автоматически добавляется до и после элемента | Отсутствует, обтекаются соседним контентом |
| Основная функция | Создание макета и крупных структурных блоков | Локальная семантическая разметка текста |
Валидность итогового кода напрямую зависит от соблюдения спецификации HTML5, которая жестко регламентирует правила вложенности тегов. Нарушение этой иерархии приводит к ошибкам синтаксического разбора, при которых браузер вынужден применять алгоритмы коррекции DOM, что снижает предсказуемость отображения контента.
Построение семантически верной разметки базируется на следующих архитектурных правилах вложенности:
- Блочные контейнеры могут содержать внутри себя как другие блочные, так и строчные элементы, формируя ветвления любой глубины.
- Строчные элементы могут вкладываться только в другие строчные элементы или содержать обычные текстовые узлы.
-
Строчным элементам категорически запрещено содержать блочные теги. Размещение
divвнутриspanявляется синтаксической ошибкой. -
Элемент
pимеет исключительное ограничение: несмотря на свою блочную природу, абзац может содержать только строчные элементы. Внедрение заголовков, списков или других блоков внутрьpнедопустимо и вызывает автоматическое закрытие текущего абзаца парсером браузера.
Конвертация исходного текста переводит визуальные отступы и логические фрагменты в строгую систему узлов, соответствующую этим правилам. Каждая единица информации оборачивается в подходящий семантический контейнер без нарушения границ родительских и дочерних элементов. В результате формируется синтаксически корректный исходный код, гарантирующий безошибочную интерпретацию документа на этапе построения объектной модели.
Интеграция сгенерированного кода в CMS и Frontend проекты
Синтаксически корректный исходный код, сформированный из обычного текста, представляет собой очищенную структуру узлов, готовую к внедрению в программные среды. Отсутствие избыточных атрибутов делает такую разметку универсальной для безопасной передачи данных между сервером и клиентской частью приложения.
При работе с CMS использование редакторов WYSIWYG часто приводит к генерации мусорного кода, включающего непредсказуемые обертки и встроенные стили. Прямая вставка предварительно конвертированного чистого HTML в режиме редактирования исходного кода исключает конфликты с глобальными таблицами стилей платформы. Вложенный контент наследует исключительно те правила CSS, которые заданы разработчиком для конкретного родительского контейнера.
В контексте архитектуры баз данных сохранение готовой базовой разметки позволяет снизить вычислительную нагрузку на сервер при рендеринге динамических страниц. Текст, уже разделенный на логические элементы, записывается в таблицы. При запросе клиентом эти данные извлекаются и напрямую передаются в шаблон без необходимости повторного синтаксического разбора и форматирования на стороне бэкенда.
Сценарии применения в разработке
Ниже представлены типичные процессы использования очищенной текстовой разметки при интеграции в проекты:
| Среда интеграции | Специфика использования исходного кода |
|---|---|
| Шаблоны email | Почтовые клиенты обладают устаревшими движками рендеринга. Базовая разметка без сложных узловых вложений обеспечивает корректное отображение контента. |
| Frontend фреймворки | Интеграция блочных и строчных элементов через механизмы прямого рендеринга для безопасного вывода пользовательского контента в компонентах. |
| Статические генераторы | Вставка структурированных файлов в сборочные конвейеры для генерации статичных страниц без дополнительных этапов парсинга текстовых узлов. |
Критически важным аспектом полученного кода является полное отсутствие избыточного форматирования. В отличие от текста, перенесенного через буфер обмена из офисных программ, чистая конвертация содержит только фундаментальные структурные теги. Это формирует базу для обеспечения кроссбраузерности по следующим причинам:
- Движки рендеринга Blink, WebKit и Gecko получают стандартизированное дерево DOM без необходимости применять алгоритмы исправления синтаксических ошибок.
- Исключается конфликт между скрытыми встроенными стилями текстовых процессоров и правилами адаптивного дизайна интерфейса.
- Визуальное представление контента остается идентичным на различных устройствах и операционных системах, так как управление поведением узлов полностью делегируется внешним каскадным таблицам стилей.
Изоляция структуры от визуального оформления гарантирует, что полученная разметка будет предсказуемо интегрирована в любой программный интерфейс, сохраняя валидность общей архитектуры документа.
Влияние валидной разметки на SEO и доступность контента
Поисковые алгоритмы опираются на структуру дерева DOM для определения релевантности и контекста страницы. При преобразовании неформатированного текста в валидный HTML одномерный строковый массив трансформируется в иерархическую структуру данных. Поисковые краулеры выделяют ограниченный краулинговый бюджет на сканирование каждого URL. Обработка чистого, семантически структурированного документа требует минимального вычислительного времени, позволяя ботам эффективно индексировать контент без затрат ресурсов на эвристический анализ неразмеченных текстовых узлов.
Сплошной массив текста заставляет поисковые системы применять ресурсоемкие модели обработки естественного языка для попыток угадать логические границы абзацев и тем. Внедрение строгой иерархии тегов решает эту проблему, так как явно декларирует архитектуру документа. Текстовые узлы, заключенные в семантические контейнеры, получают определенный информационный вес, что позволяет алгоритмам безошибочно извлекать сущности и определять приоритет ключевых фраз.
Семантические элементы выполняют функцию машиночитаемых маркеров, которые напрямую управляют процессом парсинга:
- Заголовки формируют жесткую топическую иерархию, указывая алгоритмам связь между основным предметом документа и подчиненными разделами.
- Теги абзацев группируют логические мысли, помогая нейросетевым моделям поисковых систем изолировать границы контекста.
- Списки структурируют перечисления, которые краулеры часто используют для формирования расширенных сниппетов в результатах выдачи.
Помимо поисковой видимости, семантическое структурирование является фундаментальным требованием Accessibility. Ассистивные технологии, такие как программы Screen Reader, не анализируют визуальный рендеринг страницы, а взаимодействуют напрямую с деревом доступности, сгенерированным на основе исходного кода. Неформатированный текст воспроизводится ими как единый, монотонный поток, что исключает возможность быстрой навигации. Валидные HTML-теги создают необходимые звуковые маркеры и структурные ориентиры.
Разница во взаимодействии систем с размеченным и неразмеченным контентом определяет итоговую доступность информации для всех типов агентов:
| Формат данных | Обработка поисковыми алгоритмами | Взаимодействие со Screen Reader |
|---|---|---|
| Неразмеченный текст | Интерпретируется как единый строковый узел. Снижает точность определения релевантности поисковому запросу. | Синтезируется непрерывно без пауз. Навигация по отдельным логическим блокам технически невозможна. |
| Семантический HTML | Обеспечивает точное распределение веса терминов согласно уровню вложенности узлов DOM. | Формирует каркас документа. Пользователь получает возможность изолированно перемещаться по заголовкам и спискам. |