Инструмент выполняет извлечение данных из HTML-таблицы, преобразуя сырую веб-разметку в структурированную информацию. В качестве входного параметра используется обычная строка HTML-кода. Парсер анализирует структуру переданного фрагмента и строго отделяет фактические значения от семантических тегов.
Базовый алгоритм работы конвертера опирается на последовательный обход узлов. Сначала идентифицируется корневой элемент <table>. Далее происходит построчное чтение тегов <tr> с последующим извлечением содержимого заголовочных узлов <th> и стандартных ячеек <td>. Написание пользовательских скриптов не требуется. Процесс парсинга полностью автоматизирован.
Исходным набором данных выступает скопированный фрагмент исходного кода веб-страницы. На выходе формируется массив очищенных текстовых или числовых значений, готовый к прямой передаче по API или экспорту в форматы JSON, CSV и XLSX.
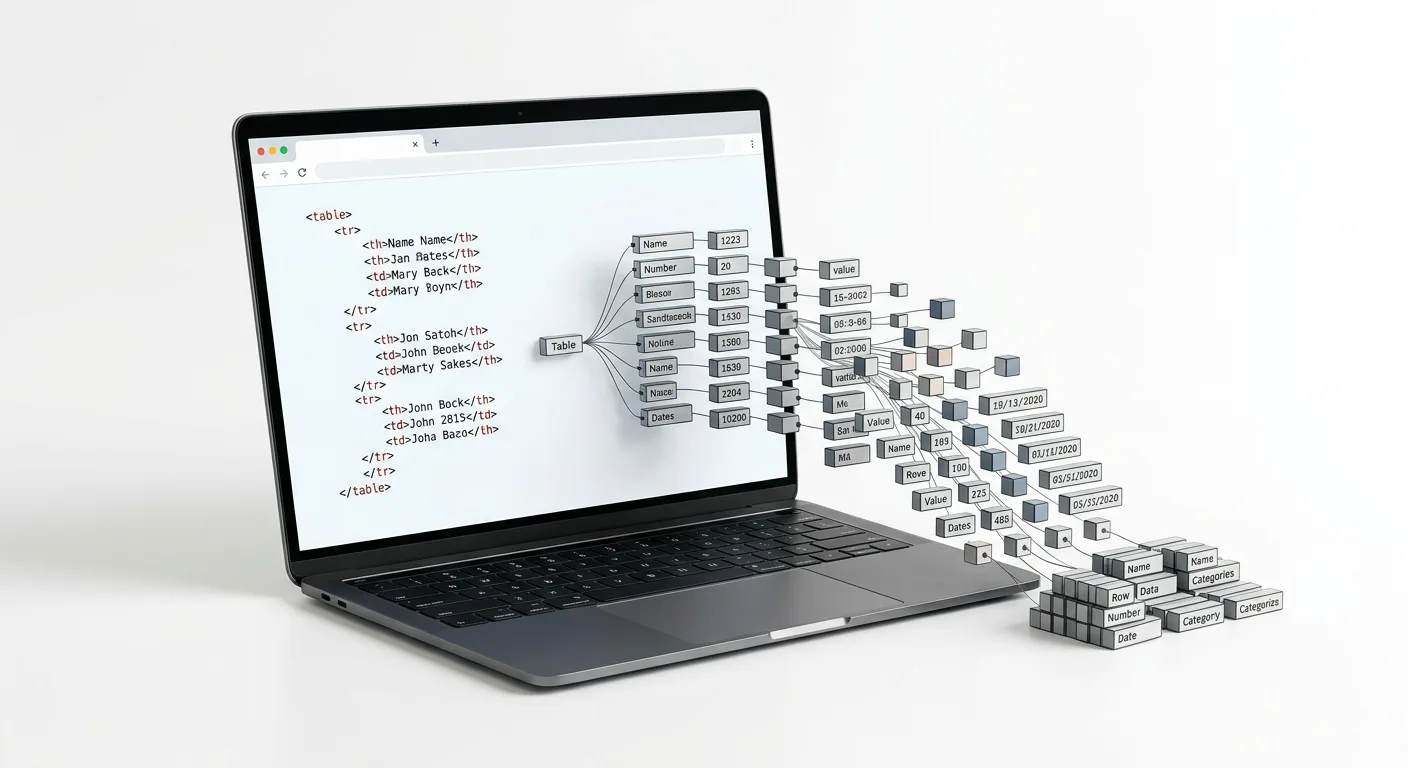
Архитектура HTML-таблицы и алгоритм парсинга данных
Парсинг начинается с построения синтаксического дерева из переданной исходной разметки. Иерархия элементов преобразуется в DOM, где каждый узел представляет отдельный тег. Алгоритм обхода дерева игнорирует любые правила CSS, инлайновые стили и классы визуального форматирования. Инструмент фокусируется исключительно на семантике разметки для корректной идентификации и восстановления исходной структуры двумерного массива.
Обход DOM происходит последовательно. Инструмент считывает родительские и дочерние узлы, формируя координатную сетку данных на основе базовых тегов таблицы. Каждый элемент разметки выполняет строгую техническую роль в процессе преобразования.
| Тег | Роль в структуре данных |
|---|---|
<table>
|
Корневой узел, определяющий границы обрабатываемого двумерного массива. |
<thead>
и
<tbody>
|
Логические секции, разделяющие заголовочную информацию и основные наборы значений. |
<tr>
|
Горизонтальный вектор (строка), объединяющий ячейки в единую структурную запись. |
<th>
|
Узел заголовка, определяющий имя колонки или семантический ключ данных. |
<td>
|
Стандартная ячейка, содержащая скалярное значение для текущей строки и столбца. |
При обработке каждой строки
<tr>
происходит итерация по вложенным узлам
<th>
и
<td>
. Каждая найденная ячейка добавляется в одномерный массив, представляющий текущую запись. Последовательный набор таких записей формирует итоговую структуру данных. Строгая привязка алгоритма к иерархии семантического дерева гарантирует правильное позиционирование каждого значения в сетке, независимо от сложности визуального представления исходной таблицы на веб-странице.
Весь процесс извлечения базируется на концепции Client-side processing. Анализ DOM и сбор значений из ячеек выполняются исключительно на стороне клиента в среде браузера. Исходная разметка обрабатывается локально, без необходимости загрузки исходного кода на сервер для удаленного парсинга. Такая архитектура обеспечивает прямую изоляцию процесса обработки и безопасность при работе с конфиденциальными табличными данными.
Нормализация сложной разметки: атрибуты colspan и rowspan
Преобразование HTML-разметки в плоские структуры данных требует строгой математической равномерности. В целевом двумерном массиве каждая строка должна содержать идентичное количество столбцов, формируя симметричную матрицу. Использование атрибутов
colspan
и
rowspan
нарушает эту геометрию, позволяя одной ячейке перекрывать смежные позиции по горизонтали или вертикали. При прямом последовательном чтении узлов DOM это приводит к смещению индексов: итоговые строки получают разную длину, а значения смещаются в соседние колонки, что полностью разрушает структурную целостность извлекаемой информации.
Для восстановления правильной архитектуры применяется алгоритм проецирования объединенных ячеек на равномерную сетку. Процесс нормализации компенсирует отсутствующие в разметке узлы путем виртуального заполнения пустых координат целевого формата.
-
Расчет горизонтального объединения: Если тег
<td>или<th>содержит атрибутcolspanсо значением больше единицы, значение ячейки резервирует соответствующее количество смежных позиций в текущей строке массива. -
Расчет вертикального объединения: При наличии атрибута
rowspanфиксируется координата ячейки и ее вертикальное смещение. При обработке последующих узлов<tr>на соответствующих индексах столбцов автоматически проецируется исходное значение, сдвигая итерацию парсинга для реальных тегов текущей строки правее.
Такая математическая проекция гарантирует, что независимая ячейка, следующая в DOM-дереве сразу после сложного объединенного блока, попадет строго в свой семантический столбец, исключая каскадный сдвиг данных.
Обработка вложенных структур
Дополнительную логическую проблему при сведении разметки к плоскому виду создают вложенные элементы. Архитектура веб-страниц часто включает многоуровневые заголовки и таблицы внутри других таблиц.
-
Вложенные заголовки: При наличии нескольких строк
<tr>внутри секции<thead>, где верхние уровни используютcolspanдля группировки нижних, нормализация выстраивает структурные связи. Содержимое родительского и дочернего заголовков сопоставляется через индексы столбцов, обеспечивая точную привязку данных к составному имени колонки. -
Вложенные таблицы: Обнаружение тега
<table>внутри стандартной ячейки<td>требует изоляции контекста. Внешняя геометрия основной сетки фиксируется, а содержимое дочерней таблицы обрабатывается в пределах одной координаты родительской ячейки. Это позволяет сохранить общую итерацию по строкам главного массива без искажения количества столбцов.
Спецификации целевых форматов: JSON, CSV, TSV и массивы
После завершения обхода DOM-дерева и нормализации сложной геометрии ячеек полученная двумерная сетка данных преобразуется в выбранный текстовый или программный формат. Правила конвертации зависят от синтаксических требований целевой структуры.
Формирование структуры JSON
При экспорте таблицы в формат JSON стандартом является создание массива объектов, где каждая строка исходной HTML-таблицы представляет собой отдельный объект. Ключевым этапом здесь выступает логическое связывание заголовков с данными ячеек.
-
Значения, извлеченные из узлов
<th>секции<thead>(или первой строки таблицы), выступают в роли строковых ключей. -
Текстовые значения из тегов
<td>последующих строк сопоставляются с ключами по индексу столбца и назначаются значениями этих свойств.
Если исходная разметка не содержит явных заголовков, в качестве ключей генерируются числовые индексы столбцов. Результатом преобразования становится валидная JSON-строка, представляющая собой массив пар ключ-значение, готовый к десериализации в любой среде.
Спецификации текстовых форматов CSV и TSV
Конвертация данных в плоские форматы CSV и TSV требует применения строгих правил разделения значений и экранирования. Это необходимо для сохранения структуры строк, если внутри ячеек присутствуют специальные символы.
-
Разделители столбцов: Для формата CSV разделителем смежных ячеек выступает запятая, для формата TSV применяется невидимый символ табуляции. Переход к новой строке
<tr>всегда обозначается символом переноса строки. -
Правила экранирования: Если текстовое содержимое тега
<td>включает сам разделитель, символ двойной кавычки или внутренний перенос строки, все извлеченное значение ячейки обязательно заключается в двойные кавычки. - Внутренние кавычки: Любая двойная кавычка, являющаяся частью оригинального текста ячейки, экранируется путем дублирования. Это предотвращает ошибку парсинга, при которой целевая система могла бы воспринять символ как преждевременный конец значения.
Синтаксис многомерных программных массивов
Генерация данных непосредственно в виде структур программирования позволяет получить готовый исходный код. Двумерная природа HTML-таблицы математически проецируется на синтаксис вложенных структур выбранного языка.
Для JavaScript формируется синтаксис литералов:
-
Массив массивов: Двумерный индексный массив, где каждый внутренний массив содержит строковые значения отдельного узла
<tr>. Подходит для матричных данных без строгой привязки к именам колонок. - Массив объектов: Структура, идентичная JSON, но представленная в виде нативного кода JS, где ключи могут записываться без кавычек, если они соответствуют правилам именования переменных.
При конвертации в код PHP генерируется синтаксис многомерных массивов:
-
Индексный массив: Формируется конструкция на основе короткого синтаксиса, объединяющая значения строк в списки вида
[ ["ячейка 1", "ячейка 2"] ]. -
Ассоциативный массив: Тексты тегов
<th>преобразуются в строковые ключи для создания структуры вида[ ["Заголовок" => "Значение"] ].
Во всех программных форматах значения ячеек выводятся как строковые литералы. Символы кавычек внутри строк экранируются символом обратного слеша согласно синтаксическим стандартам конкретного языка программирования.
Очистка и санитаризация содержимого ячеек (Data Cleanup)
Извлечение данных из DOM-дерева требует обязательной предварительной подготовки текстовых узлов. В исходной разметке содержимое тегов
<td>
и
<th>
редко представляет собой чистый текст. Оно содержит артефакты верстки, ссылки, встроенные элементы стилизации и спецсимволы, которые необходимо нормализовать перед формированием итогового JSON, CSV или программного массива.
Первым этапом санитаризации является удаление внутренних несемантических и структурных тегов. Внутри ячейки таблицы часто размещаются элементы
<span>
,
<a>
,
<strong>
,
<em>
или
<div>
. Процесс очистки подразумевает игнорирование самих HTML-тегов с полным сохранением их текстового содержимого. Таким образом, из конструкции вида
<td><a href="...">Текст</a></td>
извлекается исключительно строковое значение «Текст», что гарантирует отсутствие мусорного HTML-кода в экспортируемых данных.
Следующий критически важный процесс - декодирование HTML-сущностей. В веб-разработке многие символы экранируются для предотвращения конфликтов с синтаксисом браузера или для сохранения визуального форматирования. При конвертации табличных данных в плоские форматы эти последовательности должны быть преобразованы обратно в их символьные эквиваленты.
| HTML-сущность | Декодированный символ | Техническое назначение в разметке |
|---|---|---|
&
|
&
|
Используется для безопасного вывода амперсанда без риска парсинга сущностей. |
<
и
>
|
<
и
>
|
Экранирование угловых скобок для вывода математических знаков или демонстрации кода. |
|
Пробел | Неразрывный пробел, предотвращающий перенос строки. При очистке заменяется на стандартный пробел. |
"
|
"
|
Экранирование двойных кавычек внутри атрибутов или текстовых узлов. |
Помимо базовых сущностей, преобразованию подлежат числовые коды символов, такие как
©
(знак копирайта) или
€
(знак евро). Преобразование выполняется на уровне обработки строк, чтобы целевой формат (например, JSON) получил корректные юникод-символы, а не их HTML-репрезентацию.
При выполнении всех операций очистки строгим правилом является сохранение исходной кодировки символов. Исходные тексты, содержащие кириллицу, специфические диакритические знаки, иероглифы или эмодзи, обрабатываются без изменения их байтовой структуры (как правило, в стандарте UTF-8). Отсутствие принудительного перекодирования на этапе санитаризации предотвращает повреждение строк и появление нечитаемых символов в сгенерированных массивах или таблицах экспорта.
Практические сценарии использования конвертера в разработке
Извлечение и очистка табличных данных из HTML-разметки решает ряд рутинных инженерных задач. Преобразование визуального представления информации в машиночитаемые форматы востребовано при миграции данных, интеграции систем и прототипировании пользовательских интерфейсов.
Миграция контента legacy-систем и подготовка JSON для API
Устаревшие веб-ресурсы часто хранят структурированную информацию непосредственно в статической HTML-разметке без возможности программной выгрузки. Извлечение таких таблиц в формат JSON позволяет перенести изолированные данные в современные архитектуры. Полученный массив объектов напрямую используется для формирования ответов REST API, наполнения NoSQL баз данных или передачи структурированных пакетов между микросервисами.
Экспорт веб-данных для аналитики и реляционных баз данных
Для аналитической обработки или переноса информации в реляционные структуры применяется конвертация табличной разметки в плоские текстовые форматы CSV и TSV. Сгенерированные файлы с разделителями в виде запятых или табуляции решают следующие задачи:
- Импорт веб-отчетов, расписаний или каталогов в электронные таблицы, такие как Google Sheets и Microsoft Excel, для последующего финансового или статистического анализа.
- Массовая загрузка извлеченных данных в таблицы реляционных баз данных MySQL или SQL с использованием стандартных команд импорта через консоль или графические клиенты.
Генерация массивов данных для фронтенд-разработки
На этапе перехода от статической верстки к динамическим интерфейсам требуется отделение логики от представления. Преобразование сверстанных HTML-таблиц в нативные массивы JS позволяет разработчикам быстро получить готовые структуры данных (mock data). Это применяется для тестирования и настройки компонентов таблиц, пагинации, сортировки и фильтрации на стороне клиента до того, как будет реализован и подключен реальный серверный бэкенд.
Оптимизация времени на парсинг разовых задач
Для разовых задач по извлечению нескольких статических таблиц развертывание полноценной программной среды парсинга избыточно. Использование прямой конвертации исключает необходимость писать сложные и нестабильные регулярные выражения, которые часто ломаются при малейшем изменении HTML-структуры.
Также отпадает потребность в написании, отладке и поддержке пользовательских скриптов на базе библиотек для обхода DOM-дерева, таких как BeautifulSoup или Cheerio. Прямое преобразование разметки существенно сокращает время получения готовых к использованию структур без необходимости настройки локального окружения, установки зависимостей и написания кода для обработки узлов.