Формирование команды добавления INSERT начинается с подготовки исходных данных и их преобразования в корректный синтаксис DML-оператора. Генератор автоматизирует этот процесс. Он принимает входные значения и трансформирует их в готовый SQL-запрос для загрузки записей в таблицы реляционных баз данных. Инструмент исключает ручную сборку строк кода.
Для создания синтаксически правильного запроса алгоритму требуются компоненты целевой схемы. В генерации участвуют три обязательных элемента: имя таблицы, перечень столбцов и соответствующие им значения. На основе этих параметров формируется оператор INSERT INTO. Сгенерированный код полностью готов к интеграции и выполнению в целевой СУБД.
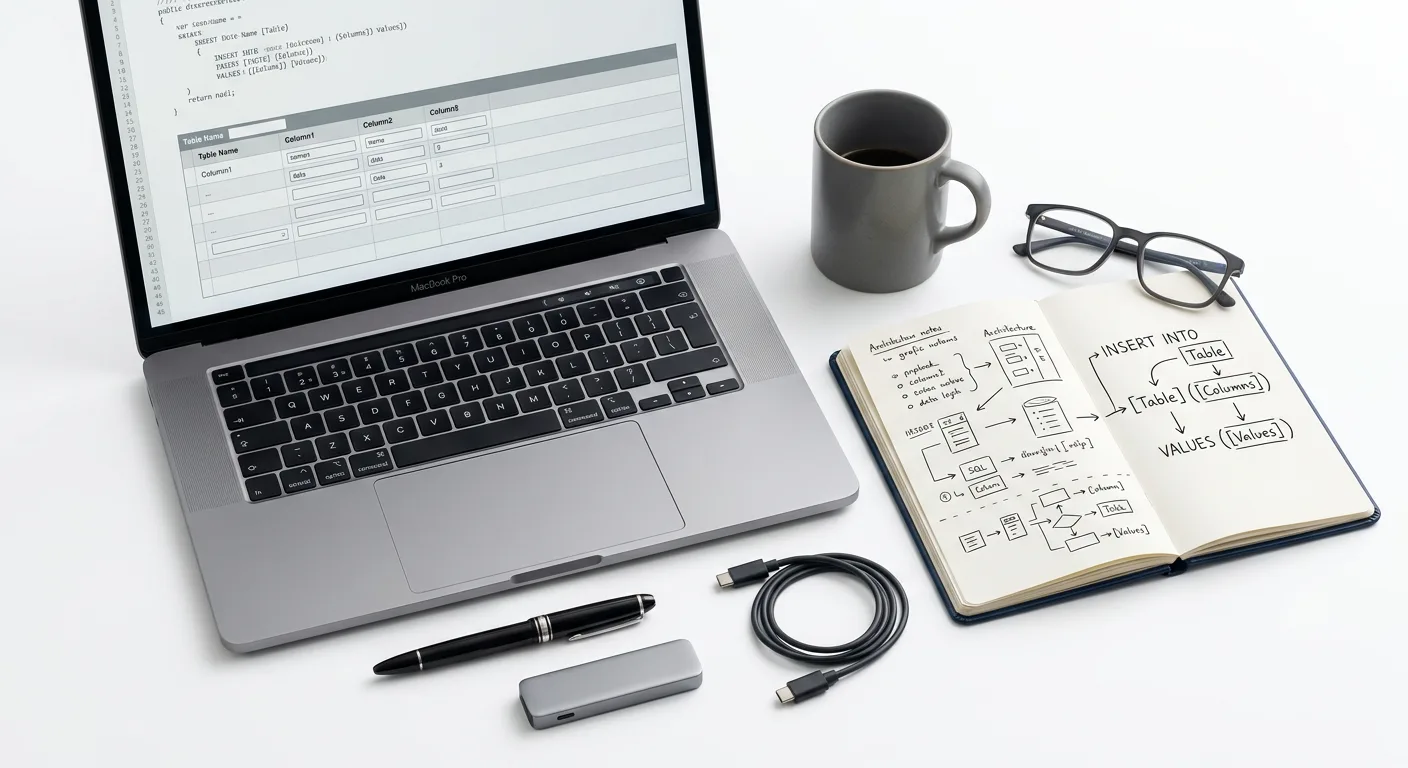
Синтаксис и структура оператора INSERT INTO
Базовая конструкция оператора строится вокруг последовательного объявления целевого объекта и передаваемых данных. Команда состоит из нескольких логических блоков, определяющих, куда именно загружаются записи и какое содержимое они несут. Стандартный синтаксис включает указание целевой таблицы, перечня атрибутов и набора значений.
INSERT INTO table_name (column1, column2, column3)
VALUES (value1, value2, value3);
В начале запроса после директивы INSERT INTO указывается целевая таблица (Table Name). За именем таблицы следует опциональный, но рекомендуемый блок перечисления столбцов (Columns Name). Имена столбцов заключаются в круглые скобки и разделяются запятыми. Завершает базовую конструкцию ключевое слово VALUES, после которого в круглых скобках передаются конкретные наборы данных для добавления в новую строку.
Критическим требованием при формировании запроса является строгое позиционное соответствие между перечнем столбцов и передаваемыми значениями. Это правило известно как 1-to-1 mapping. Первое значение в блоке VALUES физически записывается в первый столбец из объявленного списка, второе значение - во второй столбец, и так далее. Количество объявленных атрибутов должно точно совпадать с количеством элементов в кортеже значений. Нарушение позиционного баланса или несовпадение количества аргументов приводит к синтаксической ошибке на уровне ядра СУБД.
Спецификация языка SQL допускает пропуск перечня столбцов в теле запроса. В таком сценарии DML-команда принимает сокращенный вид, где после имени целевой таблицы сразу следует ключевое слово VALUES.
INSERT INTO table_name
VALUES (value1, value2, value3);
При использовании сокращенного синтаксиса СУБД ожидает передачу значений для абсолютно всех столбцов таблицы в том точном порядке, в котором они были изначально созданы при выполнении операции проектирования схемы базы данных. Подобный подход формирует жесткую зависимость текста запроса от физической структуры хранилища.
Пропуск списка столбцов несет существенные риски при дальнейшей эксплуатации базы данных. Если в структуру таблицы добавляется новый столбец или изменяется физический порядок существующих атрибутов, ранее рабочий оператор без явного указания имен столбцов завершится ошибкой или приведет к загрузке данных в неверные поля. Явное объявление списка столбцов перед блоком VALUES изолирует логику SQL-запроса от структурных изменений на уровне схемы данных и гарантирует предсказуемое распределение значений.
Форматирование значений в зависимости от типов данных SQL
Корректное распределение значений по столбцам - это лишь часть требований реляционных СУБД. Каждое передаваемое значение в блоке VALUES должно быть отформатировано в строгом соответствии с типом данных целевого атрибута. Синтаксические правила языка SQL определяют конкретный формат записи литералов, нарушение которого приводит к ошибке приведения типов или отклонению транзакции.
Строковые и темпоральные типы данных
Для передачи текстовой информации, а также значений даты и времени используются типы данных VARCHAR, TEXT, DATE и TIMESTAMP. Спецификация SQL требует обязательного заключения таких литералов в одинарные кавычки. Ядро СУБД интерпретирует любой неквотированный текст как имя столбца, системную переменную или встроенную функцию.
VALUES ('Server logs activated', '2023-11-25 08:15:00')Если внутри передаваемой строки уже присутствует одинарная кавычка, ее необходимо экранировать для предотвращения преждевременного закрытия строкового литерала и последующей синтаксической ошибки. Стандартный метод экранирования спецсимволов в SQL заключается в дублировании одинарной кавычки непосредственно внутри самой строки.
Числовые типы данных
При работе с количественными, финансовыми или измерительными показателями действуют строгие правила записи, исключающие текстовое форматирование:
- Для целочисленных типов INTEGER и BIGINT значения передаются в открытом виде без кавычек. Передача числа в кавычках заставляет базу данных выполнять неявное приведение типов, что создает лишнюю нагрузку и в строгих режимах SQL вызывает ошибку.
- Для типов DECIMAL и FLOAT обязательным разделителем целой и дробной части выступает точка.
- Использование запятой в дробных числах недопустимо, поскольку синтаксический анализатор распознает ее как переход к следующему аргументу в кортеже VALUES.
VALUES (404, 99.95)Зарезервированные ключевые слова
Спецификация SQL включает специальные лексемы для обозначения отсутствия данных или применения базовых настроек схемы хранилища. Для передачи пустого значения используется ключевое слово NULL. Оно записывается строго без кавычек.
Крайне важно различать системный идентификатор NULL и обычный строковый литерал 'NULL'. При использовании системного зарезервированного слова ячейка таблицы остается пустой на физическом уровне (маркируется как не содержащая данных). При передаче значения 'NULL' в одинарных кавычках в базу данных физически записывается текст, состоящий из четырех символов.
Если при проектировании физической структуры таблицы для конкретного столбца было задано значение по умолчанию, DML-запрос может явно применить его с помощью ключевого слова DEFAULT. Это делегирует генерацию конечного значения на сторону базы данных и также требует записи без использования кавычек.
VALUES (NULL, DEFAULT)Множественное добавление строк (Multi-row INSERT)
Стандарт SQL позволяет добавлять сразу несколько записей в таблицу с помощью одного DML-запроса. Эта концепция известна в реляционных базах данных как Bulk Insert. Вместо многократного повторения базовой команды для каждой отдельной строки исходные наборы данных объединяются в единую синтаксическую конструкцию.
Для формирования такого запроса кортежи со значениями перечисляются в блоке VALUES через запятую. Каждый отдельный набор данных заключается в круглые скобки. Порядок следования литералов внутри каждой пары скобок должен строго соответствовать объявленному списку столбцов целевой таблицы.
VALUES
  ('value1', 100, NULL),
  ('value2', 250, DEFAULT),
  ('value3', 400, NULL);
Использование конструкции множественного добавления критически важно при необходимости импорта или миграции больших объемов статических данных. Построчное выполнение отдельных команд создает узкие места на уровне серверной архитектуры, тогда как объединение записей решает сразу несколько технических задач:
- Снижение накладных расходов на сетевое взаимодействие. Отправка одного крупного пакета данных серверу СУБД происходит значительно быстрее, чем маршрутизация сотен тысяч мелких запросов, каждый из которых требует установки и подтверждения TCP-соединения.
- Уменьшение количества транзакций. База данных обрабатывает весь массив переданных кортежей как единую атомарную операцию. Это минимизирует количество блокировок таблиц и радикально снижает нагрузку на журнал упреждающей записи (Write-Ahead Log).
- Оптимизация вычислительных ресурсов. Синтаксический анализатор SQL-движка строит план выполнения запроса только один раз, после чего ядро базы данных циклически применяет готовую схему ко всем наборам значений из блока VALUES.
При использовании подхода Bulk Insert следует учитывать архитектурные ограничения целевой СУБД. Реляционные базы данных имеют конфигурационные лимиты на максимальный размер входящего пакета или предельное количество строк, обрабатываемых в рамках одного запроса. При формировании сверхбольших массивов данных их целесообразно дробить на логические блоки (батчи) по несколько сотен или тысяч записей для обеспечения стабильности транзакций.
Экранирование идентификаторов и специфика SQL-диалектов
При формировании SQL-запросов имена таблиц и столбцов выступают в роли идентификаторов. Использование необрамленных идентификаторов допустимо в том случае, если они состоят исключительно из латинских букв, цифр и символов подчеркивания, а также не совпадают с зарезервированными словами целевой СУБД. Экранирование (квотирование) необходимо для предотвращения синтаксических ошибок в следующих ситуациях:
- Совпадение имени столбца или таблицы с зарезервированными ключевыми словами (например, ORDER, SELECT, DATE, USER, KEY).
- Наличие пробелов внутри названия идентификатора.
- Использование специальных символов, тире или символов национальных алфавитов в архитектуре базы данных.
- Необходимость строгого сохранения регистра символов (case-sensitivity) в системах, которые по умолчанию приводят неэкранированные имена к нижнему или верхнему регистру.
Синтаксические правила экранирования напрямую зависят от используемого SQL-диалекта. Реляционные базы данных применяют различные символы для выделения границ идентификаторов. Применение некорректного символа квотирования приводит к ошибке синтаксического анализатора на стороне сервера.
| Стандарт / СУБД | Символ экранирования | Пример синтаксиса |
|---|---|---|
| MySQL | Обратные апострофы (Backticks) |
INSERT INTO `user data` (`id`, `order`) VALUES (...)
|
| ANSI SQL / PostgreSQL / Oracle | Двойные кавычки (Double quotes) |
INSERT INTO "user data" ("id", "order") VALUES (...)
|
Для MySQL стандартом является обрамление имен таблиц и полей обратными апострофами. Это позволяет парсеру четко разделять структурные элементы запроса и передаваемые значения. Строковые литералы внутри блока значений продолжают обрамляться одинарными кавычками, что исключает пересечение контекстов на уровне лексического анализа.
Стандарт ANSI SQL предписывает использование двойных кавычек для квотирования идентификаторов. Этому стандарту следуют PostgreSQL и Oracle. Передача идентификатора в двойных кавычках в PostgreSQL заставляет ядро базы данных обрабатывать его со строгим учетом регистра. Идентификатор без кавычек перед выполнением запроса будет автоматически приведен к нижнему регистру, что может привести к ошибке обращения, если таблица была создана с использованием заглавных букв в кавычках.
Ограничения уникальности и поведение при конфликтах (PRIMARY KEY)
Реляционные базы данных обеспечивают целостность хранимой информации за счет системы ограничений. При выполнении команды INSERT ядро СУБД проверяет добавляемые строки на соответствие правилам PRIMARY KEY и UNIQUE. Указанные ограничения гарантируют отсутствие физических дубликатов на уровне выделенных столбцов.
Стандартное поведение SQL-сервера при попытке вставки записи с уже существующим уникальным ключом заключается в немедленной генерации ошибки. Текущая транзакция прерывается, и новые данные отклоняются. Строгий подход защищает структуру базы данных, но требует сложной логики обработки отказов на стороне клиентского приложения при пакетной загрузке массивов информации.
В сценариях интеграции данных применяется концепция идемпотентной загрузки (idempotent data loading). Идемпотентность гарантирует, что многократное выполнение одного и того же запроса приведет систему к ожидаемому состоянию без возникновения критических сбоев. Для реализации подобной логики возможности стандартного оператора добавления расширяются конструкциями типа UPSERT. Механизм перехватывает конфликт ключей и активирует альтернативный сценарий исполнения прямо внутри базы данных.
Разрешение конфликтов в популярных SQL-диалектах
Синтаксис обработки совпадений различается в зависимости от используемого серверного решения. Разработчики СУБД реализуют два основных сценария поведения при обнаружении дубликата:
- Пропуск записи: проблемная строка молча отбрасывается, запрос успешно завершается для остальных переданных кортежей.
- Перезапись данных: новые значения из конфликтной строки применяются к записи, которая уже существует в таблице.
В PostgreSQL для перехвата ошибок уникальности применяется спецификатор ON CONFLICT, который добавляется в конец запроса. Инструкция ON CONFLICT DO NOTHING заставляет парсер игнорировать строку с дублирующимся идентификатором. Инструкция ON CONFLICT DO UPDATE перехватывает конфликтную запись и переключает операцию с добавления на точечное обновление целевых столбцов.
INSERT INTO users (id, status) VALUES (1, 'active') ON CONFLICT (id) DO UPDATE SET status = EXCLUDED.status;СУБД MySQL использует собственный синтаксический аппарат для обработки идемпотентных операций. Ключевое слово IGNORE, добавленное непосредственно после вызова INSERT, понижает критичность ошибки до уровня предупреждения, пропуская уже существующий ключ. Для выполнения обновления применяется конструкция ON DUPLICATE KEY UPDATE, указываемая после блока перечисления значений.
INSERT INTO users (id, status) VALUES (1, 'active') ON DUPLICATE KEY UPDATE status = VALUES(status);Внедрение логики UPSERT в код запроса исключает необходимость выполнять предварительную команду SELECT для проверки наличия записи в таблице. Механизм проверки существования ключа и принятия решения о типе DML-операции переносится на уровень транзакционной подсистемы базы данных, снижая сетевые задержки при обработке запросов.