Инструмент формирует текстовый слой PDF из отсканированных страниц с помощью технологии оптического распознавания символов. Обычный скан документа представляет собой набор растровых изображений, упакованных в файл формата PDF. Программы просмотра воспринимают такие страницы как сплошные картинки без привязки к кодам букв и цифр. Из-за этого внутри файла нельзя выделить абзац курсором, скопировать реквизиты в буфер обмена или найти нужное слово через стандартную строку поиска.
Обработка через алгоритмы OCR решает эту проблему без ручного перепечатывания. Инструмент анализирует графику загруженного документа, находит контуры печатных знаков и переводит их в машиночитаемый вид.
В результате обработки пользователь получает данные в двух практических форматах в зависимости от поставленной задачи:
- Сформированный документ PDF с встроенным текстовым слоем, где поверх исходного скана размещаются распознанные символы для быстрого полнотекстового поиска, индексации и выделения фрагментов с сохранением оригинального внешнего вида страниц.
- Чистый извлеченный текст, полностью готовый к прямому копированию, редактированию, цитированию и переносу в текстовые редакторы или таблицы.
Такое преобразование превращает статичные архивные сканы, договоры и книги в полноценные рабочие документы. При создании поискового слоя исходное визуальное оформление страницы, включая подписи, печати и сложную верстку, остается без изменений.
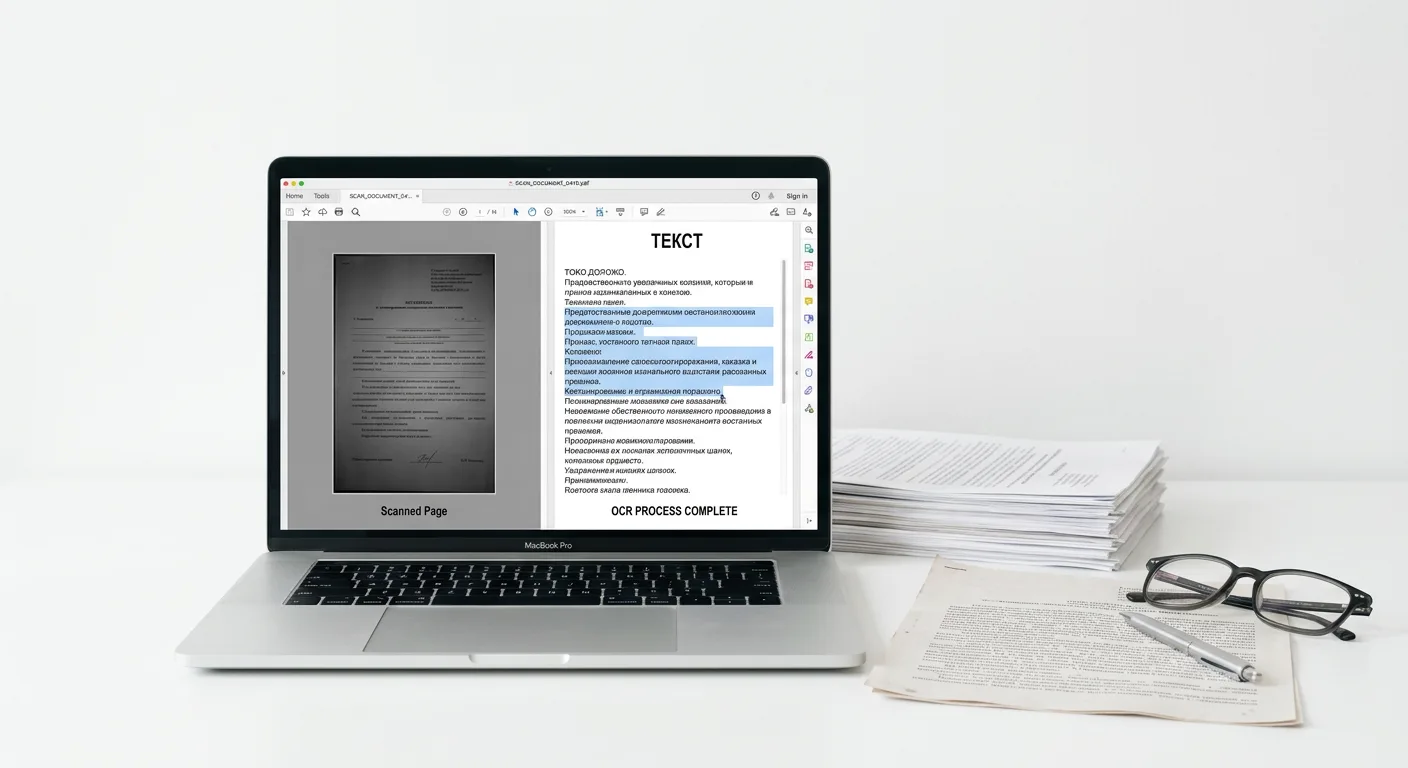
Структура отсканированного PDF и принцип формирования текстового слоя
Файлы формата PDF внешне выглядят одинаково в программах просмотра, но их внутренняя архитектура кардинально различается в зависимости от способа создания. Документ, экспортированный напрямую из текстового процессора или табличного редактора, изначально формируется как цифровой объект. Внутри него записаны точные математические координаты векторных контуров букв, параметры используемых шрифтов и таблицы кодировки, где каждому графическому знаку жестко сопоставлен машинный код символа.
Отсканированный PDF работает как универсальный контейнер, внутрь которого помещены плоские растровые матрицы страниц. Для операционной системы и программы чтения такой файл представляет собой последовательность цветных, серых или черно-белых точек без разделения на фон, иллюстрации, таблицы и печатные знаки. В структуре такого контейнера полностью отсутствуют метаданные о шрифтах и кодах символов, поэтому программа не видит разницы между буквой в абзаце и линией на чертеже.
Сравнение внутренней структуры типов PDF
Технические различия между исходным сканом, изначально цифровым документом и гибридным файлом после обработки определяют способы взаимодействия с их содержимым:
| Параметр структуры | Отсканированный PDF | Цифровой PDF | Гибридный поисковый PDF |
|---|---|---|---|
| Базовое содержимое страницы | Сплошная растровая матрица пикселей | Векторные глифы и встроенные шрифты | Исходное растровое изображение и прозрачный текстовый слой |
| Привязка к кодам символов | Отсутствует | Прямая запись в потоке данных страницы | Синхронизирована по координатам с участками растра |
| Визуальное отображение | Фотографическая копия бумажного оригинала | Генерация шрифтовых контуров в реальном времени | Фотографическая копия бумажного оригинала |
| Реакция на курсор и поиск | Воспринимается как единая картинка | Выделение символов, копирование и поиск | Выделение символов, копирование и поиск |
Механика создания гибридного PDF и наложения слоев
Формирование поискового документа решает задачу совмещения фотографической точности бумажного носителя с возможностями электронной обработки текста. В ходе операции OCR-движок не заменяет и не перерисовывает исходное изображение страницы, а выстраивает поверх или под ним невидимую знаковую сетку, называемую PDF Overlay.
Принцип синхронизации растровой подложки и распознанных данных строится на точном геометрическом позиционировании:
- Определение ограничивающих рамок: во время анализа графики фиксируются прямоугольные области на плоскости страницы, внутри которых расположены отдельные слова и строки, с вычислением их координат по вертикальной и горизонтальной осям.
- Масштабирование скрытых символов: распознанным текстовым кодам задается кегль, межбуквенный интервал и ширина, строго соответствующие физическим размерам напечатанных слов на изображении скана.
- Прозрачная отрисовка: сгенерированный текст записывается в структуру страницы со специальным параметром рендеринга, который делает шрифт полностью прозрачным для глаз пользователя, но видимым для программных интерфейсов.
Благодаря двухслойной архитектуре внешний вид документа не подвергается никаким искажениям. Пользователь на экране видит оригинальную скан-копию со всеми рукописными пометками, оттисками печатей и фактурой бумаги. Когда курсор мыши наводится на строку, программа просмотра обращается не к картинке, а к координатам скрытого слоя PDF Overlay. При выделении фрагмента закрашивается область прозрачного текста, которая в точности совпадает с контурами букв на фоновом изображении.
Аналогичным образом работают операции копирования и поиска. При нажатии комбинации клавиш для копирования в буфер обмена отправляются коды символов из невидимого слоя, а при вводе запроса в поисковую строку программа сканирует скрытый текстовый индекс и подсвечивает на растровой подложке именно те координаты, где расположено искомое слово.
Этапы оптического распознавания символов (OCR) при обработке страниц
Преобразование графического содержимого отсканированной страницы в машиночитаемые символьные данные строится на последовательном конвейере компьютерного зрения. Прежде чем сформировать текстовый поток или привязать коды к координатам на листе, алгоритмы OCR проводят многоступенчатую очистку картинки, разбирают геометрию верстки и декодируют очертания знаков.
Растеризация и графическая нормализация
Обработка начинается с извлечения отдельных страниц из контейнера PDF и их растеризации - приведения содержимого к унифицированной матрице пикселей. Исходное изображение редко бывает идеальным для прямого считывания из-за неравномерного освещения при сканировании, текстуры бумаги или следов пыли на стекле сканера. Чтобы отделить полезный сигнал (печатные знаки) от фоновых помех, выполняется предварительная нормализация графики.
Процесс подготовки растровой матрицы включает несколько базовых преобразований:
- Перевод в градации серого: цветное изображение лишается хроматической составляющей, а каждый пиксель получает одно численное значение яркости от черного до белого, что упрощает дальнейший математический анализ.
- Регулировка контрастности: перераспределение гистограммы яркости усиливает разницу между темными штрихами печатной краски и светлой подложкой листа.
- Бинаризация: ключевой шаг нормализации, при котором полутоновое изображение преобразуется в строго двухцветное (черно-белое). На основе вычисленного локального или глобального порога яркости каждый пиксель однозначно классифицируется либо как часть символа, либо как пустой фон.
- Подавление шума и артефактов сканирования: морфологические фильтры удаляют изолированные темные точки, мелкие кляксы, следы сгибов и проступающий с обратной стороны листа текст, одновременно сглаживая рваные края букв.
Сегментация и структурный анализ макета
После получения чистого бинарного изображения вступает в работу анализ макета страницы. На этом этапе задача заключается в том, чтобы понять пространственную организацию документа и установить правильный порядок чтения информации.
Алгоритмы сегментации сканируют распределение черных и белых пикселей, выделяя пустые коридоры (пробельные зоны) и плотные скопления графики. Сначала отсекаются нетекстовые элементы: иллюстрации, фотографии, разделительные линии и рамки. Оставшиеся области группируются в логические текстовые блоки - заголовки, основные абзацы, сноски и подписи.
Критическую роль играет учет одноколоночной или многоколоночной верстки. Если на странице присутствуют две или три колонки текста, алгоритм фиксирует вертикальные разделители между ними. Без такого структурного разделения считывание шло бы сплошной строкой слева направо через весь лист, склеивая фразы из соседних колонок в бессмысленный набор слов.
Внутри каждого идентифицированного блока проводится более мелкая нарезка по иерархическому принципу:
- Выделение строк: анализ горизонтальных проекций пикселей позволяет найти межстрочные интервалы и разделить абзац на отдельные линейки текста.
- Изоляция слов: внутри каждой строки вычисляются расстояния между группами черных пикселей; широкие промежутки интерпретируются как межсловные пробелы, а узкие - как межбуквенные отступы.
- Сегментация отдельных глифов: слова дробятся на элементарные неделимые контуры, каждый из которых потенциально соответствует одной букве, цифре или знаку препинания.
Классификация символов и лингвистическая сборка
Финальная стадия конвейера отвечает за перевод изолированных графических контуров в цифровые коды символов. Для этого применяются методы компьютерного зрения в связке с языковыми моделями.
При анализе отдельного глифа алгоритмы компьютерного зрения извлекают его топологические и геометрические признаки: количество замкнутых петель, наличие вертикальных и наклонных штрихов, точки пересечения линий, углы изгибов и соотношение сторон матрицы. Полученный вектор признаков сопоставляется с эталонными моделями в базе данных. Поскольку один и тот же знак в разных гарнитурах может выглядеть по-разному, классификатор вычисляет вероятность совпадения контура сразу с несколькими кандидатами.
Графического сходства часто недостаточно для безошибочного результата: например, цифра ноль и заглавная буква «О», а также вертикальная черта, единица и строчная латинская «l» имеют практически идентичные начертания. Чтобы разрешить эту неоднозначность и собрать связные слова, к процессу подключаются языковые модели и словари. Алгоритм оценивает контекст вокруг спорного глифа и проверяет допустимость сочетаний букв для конкретного языка. Если внутри последовательности из букв обнаруживается контур, похожий на цифру «0», языковая модель корректирует гипотезу в пользу буквы «О», формируя грамматически корректное слово в итоговом массиве данных.
Последовательность преобразований от сырого скана до готового текста наглядно демонстрирует таблица этапов обработки:
| Этап конвейера OCR | Базовые операции | Входные данные этапа | Промежуточный или итоговый выход |
|---|---|---|---|
| Нормализация изображения | Растеризация, перевод в оттенки серого, повышение контраста, бинаризация, фильтрация шумов | Страница PDF с растровой подложкой | Контрастная двухцветная матрица пикселей без фоновых артефактов |
| Анализ макета и сегментация | Поиск текстовых блоков, определение колонок, разделение на строки, слова и отдельные глифы | Очищенная черно-белая бинарная матрица | Иерархическая карта координат блоков, строк и изолированных контуров знаков |
| Классификация и сборка | Распознавание признаков контура, сопоставление с кодами символов, контекстная проверка языковой моделью | Массив изолированных глифов и их геометрических признаков | Связные машиночитаемые слова и строки с привязкой к координатам страницы |
Требования к исходным сканам и факторы точности извлечения текста
Качество итогового текстового слоя и чистота извлеченных строк напрямую зависят от оптических, геометрических и типографических характеристик исходных страниц PDF. Даже при корректной отработке всех стадий предобработки физические дефекты растровой подложки способны исказить контуры знаков, что приводит к ошибкам классификации или смещению координат привязки слов.
Физическое разрешение и детализация растра
Ключевым параметром входного изображения выступает плотность пикселей. Отраслевым стандартом для надежной оцифровки печатной документации является разрешение 300 dpi. При такой плотности стандартный шрифт формирует достаточно плотную сетку пикселей, где четко прорисовываются внутрибуквенные просветы, соединительные штрихи и мелкие знаки пунктуации.
Снижение разрешения до 150 dpi и ниже приводит к критической потере информации на уровне матрицы изображения. В документах с низким разрешением возникают два типа деградации контуров:
- Ступенчатая пикселизация краев, из-за которой плавные округлые элементы букв превращаются в грубые ломаные линии, теряющие сходство с эталонными признаками глифа.
- Размытие и слияние соседних знаков, когда из-за недостатка пикселей исчезает межбуквенный интервал, а пары символов вроде «rn» воспринимаются при сегментации как единая буква «m».
Избыточное разрешение выше 600 dpi редко повышает точность для обычной деловой документации, но существенно увеличивает объем входного файла и количество микроскопических артефактов бумаги, которые могут быть ошибочно приняты за точки или запятые.
Геометрические искажения и цветовая инверсия
Алгоритмы поиска строк опираются на предположение, что текст расположен на странице горизонтально и лежит в одной плоскости. Нарушение геометрии при подаче бумаги в сканер или при фотографировании документа создает серьезные препятствия для корректной разметки макета.
К основным пространственным и цветовым факторам, снижающим точность позиционирования текстового слоя, относятся следующие особенности исходника:
- Перекос страницы при сканировании, когда лист уложен под углом к краю стекла экспонирования. При заметном наклоне горизонтальные проекции соседних строк начинают перекрывать друг друга, что мешает правильному определению начала и конца строки и приводит к слиянию фрагментов из разных абзацев.
- Перспективные и нелинейные искажения на сгибах книг или плотно сшитых папок. Вблизи корешка строки изгибаются по дуге, межстрочный интервал сужается, а сами буквы сжимаются по горизонтали и теряют равномерность освещения из-за глубокой тени в месте разворота.
- Инверсия цвета, при которой светлый или белый текст напечатан поверх темной плашки или черного фона. Поскольку базовая логика бинаризации настроена на выделение темных объектов на светлой подложке, инверсные блоки требуют предварительного обращения цветовых каналов, иначе символы сливаются с фоновой маской и пропускаются при сегментации.
Типографические особенности и многоязычный набор
Строение самой гарнитуры определяет сложность выделения индивидуальных признаков каждого знака. Рубленые шрифты без засечек с равномерной толщиной штриха обеспечивают наиболее чистые и предсказуемые контуры. Гарнитуры с засечками требуют более четкой пропечатки: тонкие горизонтальные штрихи при слабом прокрасе на бумаге часто разрываются, из-за чего буква распадается на несколько изолированных фрагментов, а длинные засечки соседних букв, напротив, смыкаются в сплошную линию.
Повышенную сложность представляют декоративные, рукописные и стилизованные глифы с нестандартными пропорциями, росчерками и лигатурами, выходящими за пределы типовых геометрических шаблонов. Отдельного внимания требуют диакритические знаки (умляуты, грависы, акуты, гачеки, краткая над «й» и точки над «ё») и специальные математические, валютные или технические символы. Если надстрочный элемент расположен слишком далеко от основного тела буквы или имеет малый размер, при фильтрации он может быть отброшен как точечный шум сканирования.
Дополнительная неоднозначность возникает в многоязычных документах, где внутри одного абзаца сочетаются кириллица и латиница (например, в договорах с иностранными контрагентами, технических спецификациях с артикулами оборудования или научных статьях с библиографией). Визуально идентичные начертания букв «А», «В», «Е», «К», «М», «Н», «О», «Р», «С», «Т», «Х» имеют совершенно разные цифровые коды в таблицах символов. Для правильного разделения таких фрагментов требуется точный контекстный анализ, иначе латинская аббревиатура в русском предложении окажется записана кириллическими кодами, что сделает невозможным ее поиск по оригинальному названию.
Визуальные перекрытия и сторонние графические элементы
Реальные первичные документы редко состоят исключительно из чистого печатного текста. На этапе согласования и архивного хранения поверх текстовых блоков наносятся оттиски круглых печатей, прямоугольные штампы, рукописные подписи, резолюции и защитные водяные знаки.
Когда линия синей печати или росчерк черной ручки пересекает печатную строку, происходит физическое наложение контуров. На этапе перевода изображения в двухцветную матрицу темный оттиск штампа сливается с черными буквами в единый неразрывный графический объект. В результате нарушаются внешние границы глифов, а алгоритм классификации не может отделить штрих буквы от рамки штампа или витка подписи. Плотные фоновые водяные знаки с низким контрастом создают аналогичную проблему, заполняя внутрибуквенные просветы серым растром и провоцируя ложные срабатывания при выделении символов.
Сводная таблица систематизирует основные характеристики исходных файлов и их влияние на итоговый результат обработки:
| Характеристика исходного PDF | Оптимальное состояние для оцифровки | Проблемный фактор на скане | Влияние на точность текста и PDF-слоя |
|---|---|---|---|
| Разрешение растра | Стандарт 300 dpi с четкими границами штрихов | Низкое разрешение с размытием или пикселизацией | Подмена похожих букв, склеивание соседних знаков, пропуск мелких индексов |
| Геометрия страницы | Ровная плоскость без наклона строк | Перекос листа, изгиб строк и тени у книжного корешка | Нарушение порядка чтения строк, смещение координат выделения относительно слов |
| Цветовая схема текста | Темные символы на однородном светлом фоне | Инверсия цвета (светлые буквы на темной плашке) | Полный пропуск инверсных заголовков и врезок при стандартной бинаризации |
| Типографика и языки | Стандартные шрифты без засечек, единый алфавит | Декоративные гарнитуры, мелкая диакритика, смесь кириллицы и латиницы | Потеря надстрочных знаков, подмена кодов символов между разными алфавитами |
| Графические наложения | Чистый печатный слой без посторонних отметок | Печати, штампы, размашистые подписи и темные водяные знаки поверх строк | Разрушение контуров букв в зоне пересечения, появление нечитаемых символов в выдаче |
Сравнение результатов оцифровки: извлеченный текст и PDF с текстовым слоем
После завершения оптического распознавания сформированный массив символов и координат может быть представлен в двух принципиально разных форматах выдачи. Выбор между чистым текстовым потоком и документом со встроенным слоем зависит от того, требуется ли сохранить визуальную подлинность исходного бланка или нужно получить гибкий материал для переработки и редактирования.
Чистый извлеченный текст и редактируемые потоки данных
Первый тип результата представляет собой неформатированный машиночитаемый поток данных, соответствующий спецификации text/plain. В таком представлении полностью отбрасывается растровая графика, фоновые подложки, цветовое оформление и исходная координатная сетка страницы. Остается исключительно линейная последовательность распознанных символов, сгруппированных в слова, строки и абзацы.
При формировании текстового потока основной акцент смещается на логическую связность строк и удобство последующей правки. Для подготовки данных к переносу в текстовые редакторы или таблицы выполняются следующие операции нормализации:
- Сборка непрерывных предложений за счет удаления принудительных разрывов строк, которые в оригинале были вызваны физическими границами бумажного листа или узкими колонками.
- Склеивание слов, разделенных дефисом переноса на стыке строк, в единые лексические единицы.
- Замена сложных визуальных отступов и табуляций на стандартные одиночные пробелы и управляющие символы перевода строки.
- Линеаризация многоколоночной верстки, при которой блоки текста выстраиваются строго друг за другом в порядке естественного чтения, а не по горизонтальным срезам листа.
Такой формат оптимален, когда визуальный макет оригинала не несет ценности, а на первый план выходит скорость копирования фрагментов, исправления опечаток, изменения шрифтового оформления или вставки текста в новые шаблоны.
Поисковый PDF со встроенным слоем OCR
Второй тип выходных данных сохраняет контейнер PDF и комбинирует в нем два компонента: нетронутое исходное изображение скана и привязанный к нему невидимый текстовый массив. В отличие от чистого текста, здесь приоритетом выступает абсолютная визуальная идентичность оригиналу. Все рукописные пометки, оттиски печатей, штампы, логотипы и сложная геометрия табличных границ остаются на своих местах без малейших искажений.
Машиночитаемый текст в таком файле не предназначен для прямого редактирования или изменения верстки. Его задача - обеспечить индексацию содержимого и возможность взаимодействия с документом через стандартные функции программы просмотра. Поскольку каждая распознанная буква жестко привязана к своим координатам на растровой подложке, текст внутри слоя может содержать разрывы, нестандартные межсловные интервалы и переносы, точно повторяющие геометрию печатного оригинала.
Даже если при распознавании сложного участка с печатью или подписью возникла ошибка в коде символа, человек при чтении документа видит исходную картинку страницы и правильно воспринимает информацию, тогда как в формате text/plain этот же участок превратился бы в набор нечитаемых знаков.
Критерии выбора формата выходных данных
Различия в структуре и поведении двух типов результатов оцифровки наглядно проявляются при сопоставлении их базовых характеристик:
| Параметр сравнения | Извлеченный текст (text/plain) | Поисковый PDF с текстовым слоем |
|---|---|---|
| Визуальное соответствие оригиналу | Отсутствует, сохраняются только коды символов и разбивка на абзацы | Полное, страница выглядит идентично исходному бумажному скану |
| Сохранность печатей, подписей и графики | Графические элементы полностью удаляются из выдачи | Все нетекстовые объекты остаются видимыми на растровой подложке |
| Поведение таблиц и колонок | Преобразуются в последовательный текст, границы ячеек теряются | Визуальная сетка таблицы сохраняется, текст индексируется внутри ячеек |
| Возможность прямого редактирования | Максимальная, текст сразу готов к правке, удалению и форматированию | Ограниченная, изменение текста не меняет изображение на самом скане |
| Обработка переносов и пробелов | Нормализация пробелов, склеивание разорванных строк в целые фразы | Строгая фиксация позиций слов по координатам исходного изображения |
| Восприимчивость к ошибкам распознавания | Любая ошибка сразу видна в тексте и требует ручной корректуры | Ошибки в скрытом слое не мешают визуальному чтению документа глазами |
При копировании текста в буфер обмена напрямую из поискового PDF в вставляемом фрагменте иногда сохраняются жесткие переносы в конце каждой строки, так как текстовый слой жестко повторяет физическую верстку скана. В потоке text/plain эта проблема устраняется на этапе формирования выдачи, что избавляет от необходимости вручную удалять лишние разрывы абзацев при работе с крупными массивами текста.
Прикладные сценарии использования текстового слоя и извлеченных данных
Выбор между сохранением гибридного документа и выгрузкой чистого текстового потока напрямую зависит от дальнейшего маршрута движения информации. В одних рабочих процессах критически важно сохранить юридическую или визуальную аутентичность бумажного носителя, в других - получить гибкий массив символов для переработки, компиляции или озвучивания.
Систематизация архивов и бухгалтерский документооборот
В корпоративном секторе и при ведении личных архивов ежедневно накапливаются сотни страниц отсканированных договоров, актов выполненных работ, счетов-фактур, накладных и квитанций. Хранение таких бумаг в виде обычных растровых PDF превращает архив в неструктурированное хранилище: чтобы найти один документ за прошлый период, приходится открывать каждый файл и просматривать страницы глазами.
Формирование текстового слоя поверх сканов переводит бумажный архив в разряд индексируемых баз данных. При загрузке таких файлов в системы электронного документооборота или облачные хранилища поисковые роботы считывают внедренный слой и привязывают его содержимое к карточке файла. Это открывает доступ к мгновенной фильтрации документов по точным параметрам:
- поиск конкретного контрагента по названию организации или налоговым идентификаторам внутри многостраничных сшивов;
- выборка первичных учетных документов по номеру счета, дате составления или точной сумме транзакции;
- нахождение специфических условий, штрафных санкций или гарантийных обязательств в объемных договорах по ключевым словам;
- быстрая сверка номенклатурных позиций в товарных накладных без построчного визуального чтения.
В этом сценарии сохранение растровой подложки обязательно. При финансовых или аудиторских проверках документ должен отображать оригинальные оттиски печатей, живые подписи сторон и рукописные пометки, но при этом позволять ревизору за секунду перейти к нужному пункту соглашения через стандартную строку поиска.
Аналитическая, юридическая и учебная работа с источниками
Исследователи, студенты, юристы и профильные аналитики регулярно работают с оцифрованными фондами библиотек, архивными выпусками научных журналов, редкими монографиями и сканами старых нормативно-правовых актов. Когда первоисточник представлен только как изображение, включение большой цитаты или статистической сводки в собственную работу требует ручного набора текста с клавиатуры, что отнимает время и приводит к опечаткам.
Извлечение данных посредством OCR автоматизирует сбор фактологической базы. При подготовке судебных исков, аналитических отчетов или дипломных работ специалист может выделить и скопировать точные формулировки законов, фрагменты судебных решений или выдержки из научных статей напрямую в текстовый редактор. Если в отсканированном отчете присутствуют объемные цифровые сводки, выгрузка распознанных символов избавляет от посимвольного переноса чисел: полученные строки достаточно скопировать в табличный процессор и разбить по столбцам с помощью стандартных разделителей.
Ниже представлено распределение рабочих задач в зависимости от того, какой формат выходных данных дает наибольшую практическую пользу в конкретной ситуации:
| Прикладная область | Типовые исходные документы | Оптимальная форма результата | Решаемая практическая задача |
|---|---|---|---|
| Бухгалтерия и делопроизводство | Договоры, акты, счета, товарные накладные, уставы | Поисковый PDF с текстовым слоем | Индексация в корпоративных базах, поиск по реквизитам и суммам с сохранением вида печатей и подписей |
| Юриспруденция и комплаенс | Судебные материалы, архивные нормативные акты, заключения | Оба варианта в зависимости от этапа работы | Навигация по многотомным делам через поиск и точное цитирование правовых норм в процессуальных документах |
| Наука, образование и журналистика | Отсканированные книги, статьи, архивные периодические издания | Извлеченный чистый текст | Быстрый сбор цитат, составление конспектов, перенос статистических таблиц и списков литературы в черновики |
| Цифровая доступность | Учебные пособия, инструкции, регламенты, публичные отчеты | PDF со слоем OCR или текстовый поток | Озвучивание содержимого страниц синтезаторами речи для незрячих и слабовидящих пользователей |
Обеспечение цифровой доступности для вспомогательных технологий
Отдельная важная задача распознавания текста - адаптация информации для людей с нарушениями зрения. Программы чтения с экрана и экранные дикторы ориентируются исключительно по программному коду документа и потокам символов. Когда незрячий пользователь открывает отсканированный PDF без текстового слоя, вспомогательное программное обеспечение воспринимает страницу как пустой графический объект или зачитывает только имя файла, так как внутри контейнера отсутствуют коды букв.
Проведение OCR-обработки делает печатные материалы доступными для речевых синтезаторов и брайлевских дисплеев. Экранный диктор получает доступ к сформированному машинному тексту, последовательно считывает абзацы и преобразует их в звуковую речь. Это позволяет пользователям со слабым зрением самостоятельно изучать отсканированную учебную литературу, рабочие регламенты, медицинские выписки и государственные извещения без посторонней помощи. Для линейного прослушивания больших книг или лекций оптимально подходит чистый извлеченный текст, где нормализованы пробелы и убраны переносы слов, которые при чтении со скрытого слоя PDF иногда вызывают искусственные паузы в синтезированной речи.