Онлайн-инструмент позволяет извлечь текст разных языков из одного изображения и преобразовать его в редактируемый вид. В качестве входных данных используется загруженный графический файл, который содержит печатные фрагменты на двух или более языках. Система выполняет оптическое распознавание символов. На выходе пользователь получает чистый текстовый массив, готовый к копированию, редактированию и дальнейшей обработке.
Стандартные алгоритмы OCR часто выдают ошибки и искажают слова при обработке материалов, где в одной строке или на одной странице соседствуют разные письменности.
Мультиязычное распознавание решает проблему смешанных языковых блоков внутри одного файла. Алгоритм анализирует графическую структуру документа, определяет границы отдельных слов и идентифицирует смену алфавита непосредственно в процессе чтения. Это позволяет без потери символов обрабатывать документы, где кириллица чередуется с латиницей, иероглифами, арабской вязью или другими системами письма. Все распознанные фрагменты собираются в единый текст с сохранением исходной последовательности строк и знаков препинания.
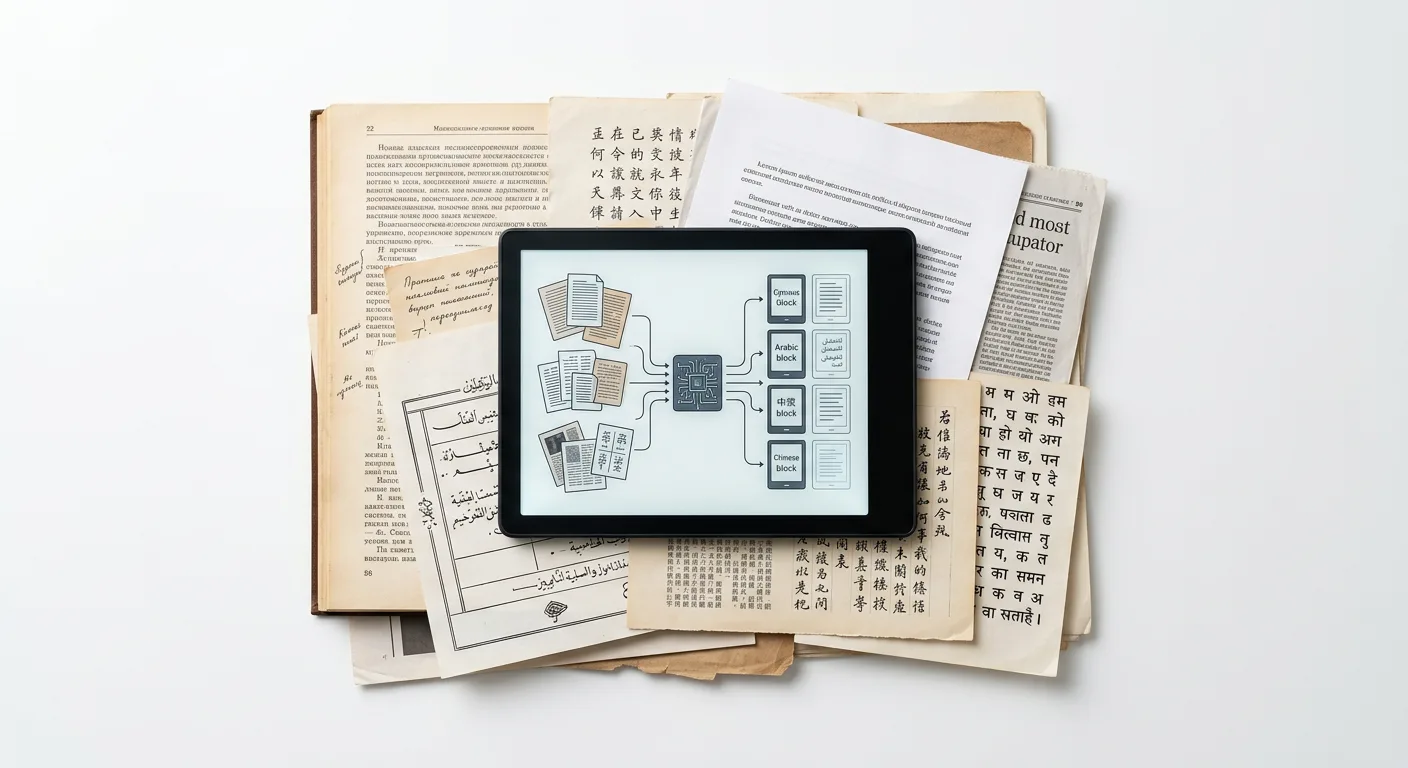
Принцип работы многоязычного OCR при смешении письменностей
Техническая механика распознавания текста на нескольких языках строится на поэтапном разделении графических данных и применении статистического анализа. Когда в одном документе встречаются разные системы письма, классического сопоставления контуров с единым алфавитным шаблоном недостаточно. Процесс требует предварительной классификации графических примитивов до момента их окончательной интерпретации в текстовые коды.
Обработка мультиязычных материалов в предметной области OCR проходит через четыре последовательных этапа:
- Детекция текста - алгоритм обнаружения текстовых областей на изображении находит зоны с высокой плотностью контрастных переходов, отделяя печатные знаки от фона, иллюстраций, рамок и графического мусора.
- Сегментация строк и символов - выделенные текстовые блоки разбиваются на отдельные горизонтальные или вертикальные линии, которые затем нарезаются на изолированные области, содержащие единичные графемы или связные группы штрихов.
- Идентификация письменности - на основе геометрии штрихов, плотности заполнения, наличия базовой линии и характерных визуальных признаков определяется принадлежность каждого сегмента к конкретной графической системе (например, отличие угловатых иероглифических структур от округлых элементов кириллицы или латиницы).
- Считывание символов - графический образ каждого сегмента сопоставляется с эталонными признаками внутри выбранного алфавита, после чего набору пикселей присваивается соответствующий цифровой код.
Динамическое переключение языковых моделей и контекстный анализ
Главная сложность при чтении смешанных строк возникает на стыке разных алфавитов. Если внутри предложения на кириллице встречается термин на латинице или вставка из иероглифов, жесткая привязка к одному словарю приведет к попытке прочитать иностранное слово буквами основного языка. Для предотвращения таких искажений в технологиях распознавания применяется концепция динамического переключения языковых моделей.
Во время прохода по строке оцениваются не только изолированные очертания знаков, но и вероятность их совместного появления. Для этого задействуются статистические модели N-gram и методы NLP. Модель N-gram анализирует последовательности из нескольких идущих подряд символов или слов, вычисляя вероятность того, что текущая комбинация принадлежит конкретному языку.
Механизм разделения смешанных языковых блоков внутри одной строки опирается на сопоставление различных признаков:
| Уровень анализа | Анализируемые параметры | Решаемая задача при смене языка |
|---|---|---|
| Графический фильтр | Высота знаков, плотность штрихов, ширина символьной ячейки, интервалы между графемами | Фиксация резкого изменения геометрии письма при переходе от алфавитного текста к иероглифике |
| Модели N-gram | Частотность сочетаний из двух, трех и более символов в рамках конкретной языковой базы | Отсечение нетипичных буквенных комбинаций и точное определение границы между словами на разных языках |
| Алгоритмы NLP | Морфологические связи, словарные основы, синтаксическая структура фразы | Выбор правильной языковой модели при чтении фрагментов, где соседствуют близкие по начертанию письменности |
Когда в строке фиксируется резкое падение вероятности появления следующего символа в рамках текущего алфавита, активируется проверка альтернативных моделей. Например, при переходе с кириллицы на латиницу алгоритмы NLP и N-gram фиксируют появление буквосочетаний, невозможных в славянских языках, но стандартных для английского или немецкого. В этот момент активный профиль распознавания переключается на соответствующий латинский словарь. Как только иноязычная вставка заканчивается и структура знаков возвращается к исходным параметрам, чтение продолжается по первоначальной модели без разрыва строки.
Особенности распознавания различных алфавитов и систем письма
Точность извлечения многоязычного текста напрямую зависит от графической структуры письменностей, которые соседствуют на одном изображении. Разные языковые семьи строятся по несовпадающим визуальным принципам: от простых линейных наборов букв до многокомпонентных знаков, где один символ занимает фиксированную квадратную ячейку или сливается с соседними элементами в непрерывную вязь.
Алфавитные системы и проблема межъязыковых омоглифов
Алфавитные письменности - кириллица, латинский алфавит и греческий алфавит - имеют общие исторические корни и схожую геометрию знаков. При их совместном появлении на одном изображении главной технической задачей становится разрешение проблемы омоглифов - графически идентичных или крайне близких по начертанию символов, принадлежащих разным алфавитам.
Без учета словарного окружения изолированный символ невозможно однозначно отнести к конкретному языку. Прописные и строчные буквы, такие как A, B, C, E, H, K, M, O, P, T, X, одинаково выглядят в латинице и кириллице, а ряд заглавных начертаний полностью совпадает и с греческим алфавитом. Если в русскоязычном тексте встречается английская аббревиатура или артикул товара, изолированное посимвольное считывание приведет к подмене кодов символов. Например, латинская буква C будет записана как кириллическая С, что нарушит целостность данных при последующем поиске по тексту или копировании параметра в базу данных.
Дополнительную сложность внутри европейских алфавитов создают надстрочные и подстрочные элементы:
- Диакритические знаки и акценты (умлауты, акуты, грависы, седили, тильды, гачеки), которые меняют фонетическое и смысловое значение базовой графемы во французском, немецком, польском, чешском или вьетнамском языках.
- Точки и мелкие выносные элементы, расположенные над базовой линией шрифта (например, разница между русскими буквами Е и Ё, И и Й, турецкими I и İ).
- Типографские и языковые лигатуры (например, знаки æ, œ, ß или слитные сочетания букв fi, fl), где два символа физически соединены в один контур и при базовой вертикальной нарезке строки не разделяются обычным межбуквенным пробелом.
Логографическое, идеографическое и слоговое письмо
При переходе от европейских языков к восточноазиатским текстам меняется сама логика чтения графической области. Вместо нескольких десятков букв классификатор сталкивается с тысячами уникальных структурных единиц, которые не делятся на привычные слова с пробелами.
Китайские иероглифы представляют собой логографическую систему с высокой плотностью штрихов на квадратный миллиметр. Каждый знак вписывается в условный квадрат и состоит из базовых ключей (радикалов) и множества пересекающихся линий. Минимальное отличие в длине черты, наклоне откидной линии или наличии точки полностью меняет значение слова.
Японское письмо усложняет задачу за счет одновременного использования трех подсистем внутри одного предложения:
- Идеографические знаки кандзи, заимствованные из китайской традиции и обладающие плотной внутренней сеткой штрихов.
- Две слоговые азбуки кана - хирагана (с плавными, округлыми контурами для записи грамматических окончаний и исконно японских слов) и катакана (с резкими, угловатыми штрихами для записи иностранных заимствований и технических терминов).
- Включения латинского алфавита (ромадзи) и арабских цифр для обозначения брендов, единиц измерения и индексов.
Корейское письмо хангыль относится к фонематическому письму, но визуально организовано по принципу слоговых блоков. Отдельные буквенные элементы (чамо) не выстраиваются в линейную цепочку друг за другом, а группируются по два, три или четыре знака в двухъярусные или трехъярусные квадратные ячейки. При анализе такой строки необходимо распознавать как внутренние компоненты блока, так и целостную графему слога.
Консонантно-слоговые и редкие письменности
Отдельную категорию составляют письменности Южной и Юго-Восточной Азии, Ближнего Востока и Африки. В них часто отсутствует четкое разделение на изолированные печатные знаки, а гласные звуки обозначаются зависимыми модификаторами вокруг согласной основы.
В таблицах ниже приведены конструктивные особенности сложных и региональных систем письма, определяющие специфику их оптического разбора:
| Система письма | Тип письменности и языковые примеры | Графические особенности при распознавании |
|---|---|---|
| Деванагари (хинди) и гурмукхи | Абугида (консонантно-слоговое письмо для хинди, маратхи, панджаби) | Наличие сплошной верхней горизонтальной черты (широрекха), объединяющей все буквы слова в единый связанный контур, а также сложные многоярусные лигатуры согласных и зависимые знаки гласных (матры) сверху, снизу и по бокам базового знака. |
| Шахмукхи и джави | Абджад (курсивные системы на базе персидско-арабской графики для панджаби и малайского языка) | Непрерывная вязь, где форма каждой буквы меняется в зависимости от позиции в слове (начальная, срединная, конечная, изолированная), а также обилие диакритических точек (нукт) над и под основной линией письма. |
| Тифинаг | Алфавитное письмо (берберские языки Северной Африки) | Строго геометрические формы символов, состоящие из кругов, точек, крестов и прямых отрезков, которые требуют точного отделения от графических маркеров списка, рамок или технических значков на макете. |
| Ол-чики | Алфавитное письмо (язык сантали в Индии) | Специфические округлые графемы с дополнительными диакритическими маркерами назализации, удлинения гласных и глоттализации, примыкающими к основному контуру буквы. |
Роль стандартов кодирования при формировании текстового вывода
Успешное оптическое распознавание контуров на изображении - это лишь половина задачи. Чтобы полученные символы разных языков корректно отображались в одном текстовом файле, редакторе или форме браузера, графические образы должны быть переведены в правильные цифровые коды.
Исторически для разных регионов разрабатывались локальные стандарты кодирования, которые конфликтовали при попытке совместить несколько языков в одном документе:
- Семейство стандартов ISO (например, однобайтовые таблицы для латиницы, кириллицы, греческого и арабского письма), где один и тот же числовой код в разных таблицах отвечал за разные буквы.
- Японский промышленный стандарт JIS, регламентирующий кодирование кандзи и обеих азбук кана.
- Китайские государственные и региональные стандарты GB2312-80 (для упрощенных иероглифов материкового Китая) и Big5 (для традиционных иероглифов Тайваня и Гонконга).
- Корейский стандарт KSC5601, фиксирующий наборы слоговых блоков хангыля и иероглифов ханча.
При совмещении текста из разных локальных кодировок возникало искажение вывода, когда вместо букв одного из языков появлялись нечитаемые спецсимволы. Универсальным решением для многоязычного результата выступает стандарт Unicode. Он объединяет знаки всех существующих алфавитов, иероглифических систем, консонантно-слоговых письменностей и редких шрифтов в единое адресное пространство. Благодаря привязке каждого распознанного символа к уникальной кодовой позиции Unicode в итоговой строке без конфликтов соседствуют кириллица, латиница, японские кандзи, вязь шахмукхи и геометрические знаки тифинаг.
Анализ макета документа и направления письма LTR и RTL
Бесконфликтная запись различных знаков в цифровом виде сама по себе не гарантирует читаемости итогового материала, если нарушена пространственная логика страницы. Алгоритмы анализа структуры документа отвечают за перевод двухмерного графического расположения элементов в линейную последовательность текста. Без предварительного разбора композиции построчное считывание приводит к хаотичному перемешиванию несвязанных фрагментов, особенно когда на одном изображении соседствуют абзацы с разным направлением чтения и сложная сетка верстки.
Обработка комбинаций разнонаправленного текста
В многоязычных материалах часто совмещаются системы письма с противоположным вектором ведения строки. Письменности с направлением LTR читаются от левого края к правому, тогда как системы с направлением RTL (например, арабская вязь, иврит, шахмукхи или джави) строятся от правого края к левому. Особую сложность представляют двунаправленные строки, когда внутри основного предложения на RTL-языке встречаются вставки на латинице, кириллице или числовые значения, которые даже внутри правостороннего текста записываются по правилам LTR.
Для корректной сборки такой строки алгоритмы анализа структуры определяют базовое направление каждого абзаца и точки смены вектора чтения внутри него. Если порядок следования символов не будет перестроен в соответствии с логической последовательностью чтения, слова в итоговом выводе окажутся инвертированными, а знаки препинания и скобки сместятся в неверные позиции на стыках языковых блоков.
В таблице ниже показано, как различается логика обхода текстовых зон в зависимости от направления письма на изображении:
| Тип текстовой структуры | Визуальное расположение на изображении | Логика формирования текстового потока | Типичный риск при ошибке анализа |
|---|---|---|---|
| Однородный блок LTR | Выравнивание по левому краю или по ширине, чтение слева направо | Последовательный обход сверху вниз, внутри строки - от левой границы к правой | Слияние соседних колонок при малом межколоночном интервале |
| Однородный блок RTL | Выравнивание по правому краю, начало строки справа | Обход сверху вниз, внутри строки - от правой границы к левой | Запись слов или букв в обратном порядке при применении правил LTR |
| Смешанная строка (RTL + LTR) | Включение латинских терминов, дат или чисел в строку с правым направлением | Чтение основного потока справа налево с локальной инверсией чтения слева направо для встроенных фрагментов | Перестановка начала и конца фразы, разрыв числовых групп и смещение пунктуации |
| Параллельные разноязычные колонки | Два столбца рядом: один на языке LTR, другой на языке RTL | Изоляция каждой колонки в отдельный блок с собственным правилом чтения и поочередный вывод | Сквозное построчное склеивание левой и правой колонок в одну нечитаемую строку |
Многоколоночная верстка и последовательность сборки
При анализе документов со сложной композицией ключевой задачей является определение правильного порядка чтения. На этапе геометрического разбора алгоритмы сегментации выделяют на изображении отдельные регионы: заголовки, текстовые колонки, врезки, подписи и колонтитулы. Ориентирами для разделения служат вертикальные и горизонтальные пробельные зоны (коридоры фона), выравнивание краев текста и перепады размера шрифта.
Если изображение содержит две или три колонки текста, сквозное сканирование по горизонтали от левого края листа до правого разрушит связность: первая строка первой колонки будет склеена с первой строкой второй колонки. Чтобы сохранить логику повествования, алгоритмы выстраивают иерархическое дерево макета. Сначала полностью собираются и склеиваются строки внутри первой колонки сверху вниз, и только после завершения этого текстового блока фокус переходит к верхнему краю следующей колонки. При этом в двуязычных документах с параллельным переводом порядок обхода колонок зависит от того, какой язык выступает основным.
Табличные данные и границы ячеек
Таблицы требуют иного подхода к склейке строк по сравнению с обычным многоколоночным текстом. В многоколоночной статье текст течет вертикально сверху вниз внутри одного столбца, а в таблице данные логически связаны по горизонтали - от ячейки к ячейке в пределах одного ряда. При этом внутри самой ячейки текст может занимать несколько строк и содержать наименования на разных языках.
Для сохранения структуры табличных данных при извлечении текста учитываются следующие пространственные факторы:
- Явные графические разделители (вертикальные и горизонтальные линии сетки), которые жестко очерчивают контуры каждой ячейки и препятствуют слиянию соседних значений.
- Неявные границы в таблицах без видимой разлиновки, где структура столбцов и рядов вычисляется по вертикальному выравниванию текстовых блоков и регулярным отступам.
- Многострочное заполнение ячеек, требующее сначала склеить все строки внутри замкнутого контура одной ячейки и лишь затем переходить к соседней ячейке справа или слева.
- Смешанное направление письма в разных графах, когда в одном столбце размещено описание на языке с направлением RTL, а в соседних столбцах указаны международные артикулы на латинице и числовые показатели.
Корректная интерпретация границ ячеек и колонок предотвращает потерю смысловых связей между наименованием позиции и ее параметрами, обеспечивая последовательный и логически связный вывод распознанного текста.
Требования к исходному изображению и факторы точности распознавания
Точность извлечения многоязычного текста напрямую зависит от физических и графических характеристик исходного файла. Если при анализе макета важна пространственная геометрия блоков, то на этапе считывания отдельных глифов решающую роль играет детализация растровой сетки. Когда в одной строке или на одной странице соседствуют символы разной графической плотности, требования к четкости контуров возрастают: качество, достаточное для уверенного считывания крупных печатных букв латиницы или кириллицы, может оказаться непригодным для разбора сложных идеограмм или мелких надстрочных знаков.
Разрешение и физическая высота символов в пикселях
Для классических сканов печатных документов базовым ориентиром служит разрешение 300 dpi. Такая плотность точек обеспечивает достаточную детализацию стандартных книжных и офисных кеглей. Однако при работе с цифровыми фотографиями, скриншотами или кадрами с камер смартфона показатель dpi в метаданных файла не отражает реальной читаемости текста. В таких случаях ключевым параметром выступает фактическая высота строки и отдельных знаков в пикселях.
Для простых алфавитных систем без сложной внутренней детализации минимально достаточной считается высота строчных знаков от 20 до 30 пикселей. Ситуация меняется, если изображение содержит плотные идеографические символы, такие как китайские иероглифы или японские кандзи, состоящие из десятка и более пересекающихся черт внутри одного квадратного знакоместа. При малой пиксельной высоте внутренние просветы между штрихами заливаются и сливаются в сплошное темное пятно. Аналогичная проблема возникает с диакритикой и огласовками: при недостаточном разрешении мелкие точки, галочки и черточки над или под буквой имеют размер всего в 1-2 пикселя, из-за чего легко отсеиваются как случайный фон или сливаются с основным телом буквы. Для сохранения читаемости многосоставных знаков и тонких акцентов оптимальная высота текстовой строки должна составлять не менее 30-40 пикселей.
Графические искажения и визуальные помехи
Даже при достаточном разрешении уверенность распознавания снижается из-за оптических дефектов съемки, особенностей верстки или потерь при сохранении файла. Различные виды визуальных искажений по-разному деформируют матрицу символов и приводят к специфическим ошибкам в итоговом тексте:
| Фактор искажения | Механизм влияния на контуры символов | Типичные ошибки в распознанном тексте |
|---|---|---|
| Низкий контраст и неравномерное освещение | Сглаживание перепада яркости между штрихами букв и фоном, появление бликов или глубоких теней на части страницы | Разрыв тонких соединительных линий в буквах, полная потеря бледных участков строки или выцветание знаков препинания |
| Цифровой шум и зернистость | Появление хаотичных темных и цветных точек на светлом фоне при съемке в условиях слабой освещенности | Ложное срабатывание на пятна фона, превращение случайных точек в ложные апострофы, точки или диакритические знаки |
| Артефакты сжатия | Образование блочной сетки и размытых ореолов вокруг контрастных границ букв при агрессивном сохранении с потерями | Слипание соседних узких символов (например, сочетание букв r и n превращается в m), искажение мелких деталей в иероглифах |
| Перекос строк | Наклон текстового блока относительно горизонтальной оси кадра более чем на несколько градусов | Сбой при построчной нарезке текста, когда конец одной строки ошибочно приклеивается к началу следующей или предыдущей |
| Перспективные искажения | Трапециевидная деформация геометрии текста при съемке страницы, вывески или экрана под острым углом | Неравномерный масштаб букв в начале и конце строки, нарушение пропорций ширины и высоты глифов, падение точности на дальнем краю кадра |
| Сложный неоднородный фон | Наложение текста на текстуры, градиенты, водяные знаки, защитные сетки или цветные иллюстрации | Слияние штрихов буквы с линиями фонового рисунка, невозможность точно отделить контур символа от подложки |
| Декоративные и нестандартные шрифты | Экстремальная толщина штрихов, рукописная вязь, художественные завитки, нестандартные пропорции или контурное начертание | Неверная классификация букв из-за отсутствия совпадений со стандартными печатными шаблонами в шрифтовых базах |
Отдельную категорию сложности представляет распознавание текста на фотографиях реальных объектов и уличных сцен, известное как Scene Text Recognition. В отличие от плоских отсканированных листов на белой бумаге, текст на упаковках, дорожных указателях, приборных панелях или витринах почти всегда сочетает сразу несколько негативных факторов: съемку под углом, изгиб поверхности (например, на цилиндрической банке или мятой этикетке), сложный цветной фон и блики от источников света. При обработке таких снимков малейшая потеря резкости делает мелкий многоязычный текст нечитаемым.
Методы предварительной обработки и контекстного восстановления
Для компенсации дефектов исходного изображения в процессах OCR применяется комплекс процедур предварительной подготовки графики и последующей лингвистической проверки. Предварительная обработка приводит сырое растровое изображение к виду, оптимальному для выделения контуров символов, и включает следующие базовые операции:
- Выравнивание геометрии и коррекция наклона (дескьюинг), при которых вычисляется угол отклонения базовых линий текста от горизонтали и производится поворот изображения, а также устраняются трапециевидные искажения перспективы.
- Нормализация яркости и повышение контраста, усиливающие разницу в тоне между темными чернилами и светлой подложкой, что помогает проявить выцветший или слабо пропечатанный текст.
- Адаптивная бинаризация - перевод цветного или полутонового изображения в строго двухцветный (черно-белый) формат. В отличие от простого порогового разделения, адаптивные методы рассчитывают порог яркости локально для каждого небольшого участка изображения, что позволяет четко отделить буквы от фона даже при наличии теней, пятен или градиентной заливки.
- Фильтрация шума и сглаживание, направленные на удаление изолированных мелких точек вокруг букв и затягивание микроразрывов внутри штрихов без повреждения настоящих диакритических знаков и знаков препинания.
После того как графические контуры очищены и переведены в последовательность символов, вступает в действие этап постобработки - контекстное восстановление текста с помощью словарных фильтров. Если из-за дефекта бумаги или пятна на объективе отдельный символ внутри слова был считан с низкой уверенностью или имеет несколько вероятных вариантов интерпретации, результат сверяется с лексическими базами соответствующего языка.
Словарный фильтр сопоставляет распознанную буквенную цепочку с допустимыми словоформами и исправляет единичные ошибки распознавания на основе контекста. Например, если в слове на латинице вместо буквы l была ошибочно считана единица 1 или вертикальная черта, фильтр заменит инородный знак на правильную букву, опираясь на словарное окружение. В многоязычных текстах такая проверка работает параллельно для каждого идентифицированного языкового сегмента, однако она не применяется вслепую к артикулам, серийным номерам, кодам и аббревиатурам, где комбинации букв и цифр не подчиняются правилам обычной орфографии.
Практические сценарии извлечения разноязычного текста из изображений
Способность считывать неподчиняющиеся словарям буквенно-цифровые коды наряду с обычной лексикой особенно востребована при переводе реальных деловых, юридических и технических материалов в редактируемый вид. В прикладных задачах извлечение текста на нескольких языках из одного графического файла применяется тогда, когда ручной перенос данных невозможен из-за отсутствия соответствующей раскладки клавиатуры или высокого риска опечаток при переключении между алфавитами.
Паспортные документы, визы и удостоверения личности
Официальные бланки удостоверений личности, заграничных паспортов, водительских прав и визовых стикеров строятся по принципу параллельного дублирования реквизитов. На одном развороте или пластиковой карте имя владельца, место рождения и название выдавшего органа указываются на государственном языке страны выдачи (например, на кириллице, греческом, арабском или иероглифами) и сразу же дублируются латиницей по международным правилам транслитерации.
При оцифровке таких сканов и фотографий задача многоязычного OCR сводится к точному разделению спаренных строк и подписей к полям, которые часто оформлены через косую черту. Особую роль в таких документах играет машиночитаемая зона в нижней части бланка, состоящая из заглавных букв латинского алфавита, цифр и разделительных символов. Поскольку имена собственные и географические названия в документах могут не входить в стандартные лексические базы, посимвольное распознавание обоих языковых вариантов дает возможность сверить написание в национальном поле с транслитерацией и избежать искажений при заполнении анкет, таможенных деклараций или юридических реестров.
Международные накладные, инвойсы и банковские выписки
В трансграничной торговле, логистике и бухгалтерском учете первичная документация объединяет реквизиты контрагентов из разных юрисдикций. Коммерческие инвойсы, упаковочные листы, таможенные квитанции и банковские выписки регулярно содержат смешанную номенклатуру в пределах одной таблицы.
При извлечении данных из подобных финансовых и транспортных документов на одном изображении встречаются следующие комбинации элементов:
- Наименования товаров и описания услуг на языке поставщика (например, на китайском, немецком или корейском) с параллельным переводом на английский или русский язык в соседней колонке либо в скобках внутри той же ячейки.
- Реквизиты сторон, где юридический адрес и название банка-корреспондента записаны латиницей, а назначение платежа, штампы таможенного оформления и локальные налоговые отметки выполнены на национальном алфавите получателя.
- Международные банковские идентификаторы, коды валют, номенклатурные артикулы и номера контейнеров, жестко привязанные к текстовым строкам описания груза.
Полученный из скана накладной или квитанции редактируемый текст используется для прямого копирования позиций в учетные таблицы, сверки артикулов с базой складского учета и перевода иноязычных примечаний без необходимости вручную набирать незнакомые символы.
Двуязычные визитные карточки и товарные этикетки
Коммерческая полиграфия и упаковка импортной продукции отличаются плотным размещением разнородных языковых блоков на ограниченной площади. На деловых визитных карточках международные компании часто размещают контактные данные на двух языках: на одной стороне или в разных половинах макета указываются имя, должность и название департамента на родном языке сотрудника и на английском языке, дополненные адресом, телефоном и доменом электронной почты.
Еще более плотное смешение письменностей характерно для этикеток и контрэтикеток потребительских товаров, косметики, электроники и продуктов питания. По требованиям торговли состав продукта, пищевая ценность, условия хранения и сведения об изготовителе печатаются единым текстовым массивом сразу на нескольких языках стран сбыта. В таком блоке абзацы или даже отдельные фразы идут вплотную друг к другу, разделяясь только знаками препинания или короткими буквенными индексами стран (например, RU, KZ, EN, DE, FR, CN). Распознавание фотографии этикетки позволяет быстро перевести мелкий печатный текст с цилиндрической или неровной упаковки в цифровой вид для проверки ингредиентов, подготовки карточек товаров для каталогов или составления спецификаций.
Скриншоты интерфейсов, техническая документация и учебные материалы
В инженерной практике, программировании и образовании исходным материалом для распознавания часто служат не сканы бумаги, а снимки экрана, фотографии слайдов презентаций, страницы специализированных справочников и чертежи. Специфика таких изображений заключается в постоянном переключении между основным языком изложения и универсальными международными обозначениями внутри одного предложения.
Характерные особенности структуры текста и прикладное назначение результата для различных типов материалов представлены в таблице:
| Тип исходного изображения | Сочетание языковых систем и нотаций | Применение извлеченного текста |
|---|---|---|
| Скриншоты программных интерфейсов и диалоговых окон | Локализованные элементы меню и пояснения на родном языке в сочетании с системными сообщениями об ошибках, путями к файлам и командами на английском языке. | Поиск точного текста системной ошибки в технической базе знаний, составление инструкций и отчетов о неполадках. |
| Инженерная документация и спецификации оборудования | Описательная часть на национальном языке, англоязычные технические аббревиатуры, латинские и греческие буквы в обозначениях физических величин и допусков. | Перенос параметров оборудования в проектную документацию, перевод таблиц характеристик и поиск комплектующих по маркировке. |
| Учебные пособия, научные статьи и конспекты | Основной текст на родном языке, иноязычные цитаты, библиографические ссылки на разные алфавиты, химические формулы и математическая нотация со знаками операций и индексами. | Составление конспектов, цитирование источников с сохранением оригинальной орфографии авторов и подготовка списков литературы. |
Во всех перечисленных случаях совместная обработка нескольких алфавитов избавляет от потери латинских терминов, переменных и кодов внутри нелатинского текста, сохраняя целостность исходного материала для дальнейшего редактирования или поиска.