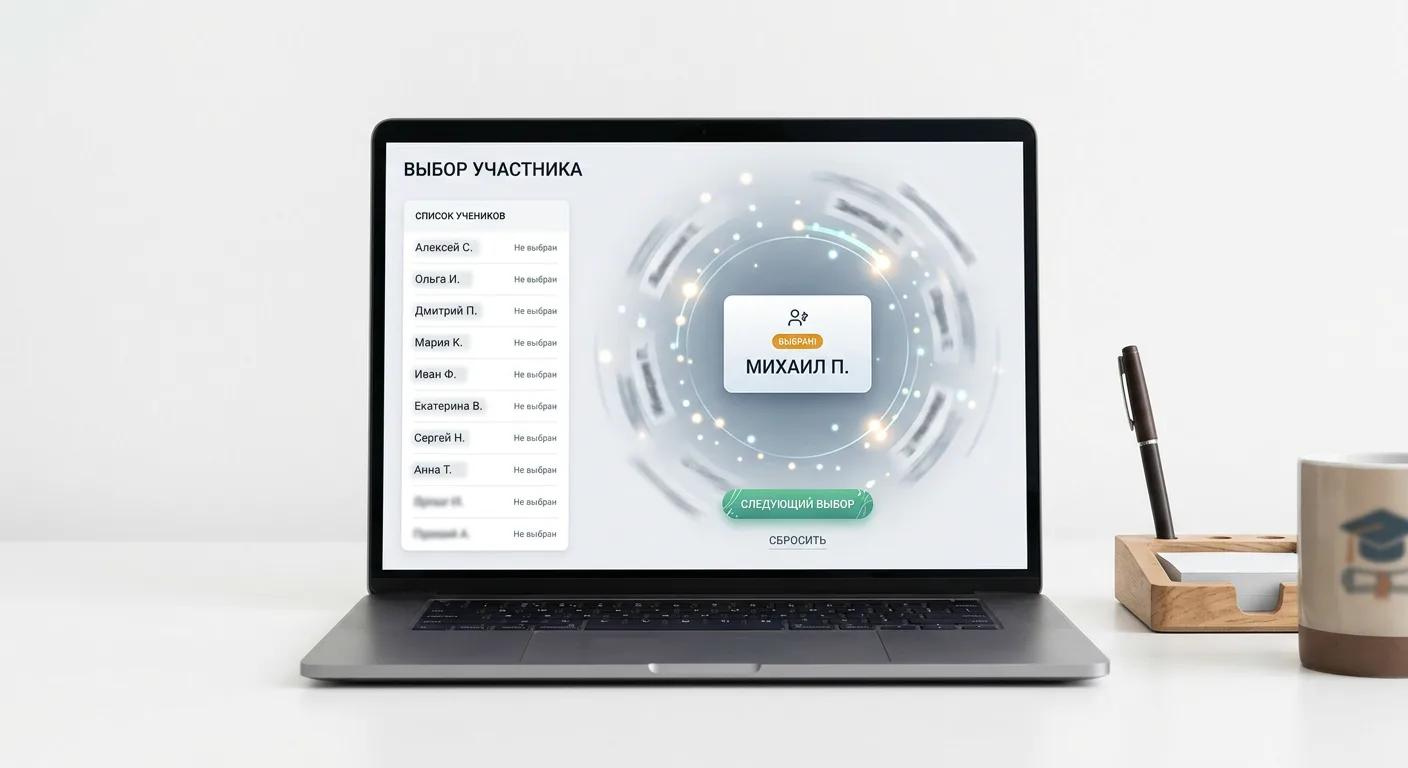
Онлайн-инструмент выполняет выбор участника из списка случайным способом для объективного проведения опросов и распределения задач на учебных занятиях. Алгоритм мгновенно определяет одного ученика из заданного перечня без участия человеческого фактора. Преподаватель избавляется от необходимости самостоятельно решать, кто пойдет к доске или начнет защиту проекта. Каждый присутствующий в классе получает равную математическую вероятность вызова.
В качестве входных данных используется текстовый перечень участников, а итоговым результатом операции становится один выбранный случайным способом ученик.
Механизм отбора применяется для вызова к доске, установления очередности докладов и распределения индивидуальных учебных заданий или экзаменационных билетов. Для запуска процедуры достаточно внести актуальный состав учебной группы в рабочее поле. После обработки введенного массива на экран выводится имя, фамилия или порядковый номер определенного алгоритмом учащегося. Это исключает споры о предвзятости преподавателя и экономит учебное время на организационных этапах урока.
Подготовка списка учеников и требования к исходным данным
Корректность случайного отбора напрямую зависит от качества подготовленного текстового массива. Исходный перечень должен точно отражать фактический состав учебной группы в конкретный момент времени. Любая неточность во входных данных нарушает равновероятность процедуры или приводит к получению неприменимого на практике результата.
Перед запуском отбора преподавателю необходимо провести быструю ревизию списка по трем базовым критериям: актуальность присутствия, однозначность идентификации каждого учащегося и отсутствие технических повторов.
Формирование актуального состава и исключение отсутствующих
Базовый список класса по журналу редко совпадает с реальным количеством людей в аудитории. Если оставить в перечне всех числящихся учеников, выбор может пасть на того, кто пропускает занятие по болезни или уважительной причине. Это потребует повторного запуска процедуры и приведет к потере учебного времени.
Предварительное исключение отсутствующих на занятии учеников до начала выбора гарантирует, что результат операции сразу укажет на готового к ответу участника. Редактирование списка выполняется непосредственно после переклички в начале урока. Аналогичным образом из рабочего пула временно убирают учащихся, освобожденных от текущего вида проверки по педагогическим или медицинским показаниям.
Проверка уникальности записей и учет однофамильцев
Каждая позиция в текстовом перечне должна однозначно указывать на конкретного человека. Основная проблема при составлении списков учебных групп связана с наличием однофамильцев или тезок. Если внести в перечень две одинаковые фамилии без уточняющих признаков, при выпадении такой записи возникнет путаница, кого именно вызывать к доске.
Для обеспечения уникальности текстовых строк применяются простые правила детализации записей:
- Добавление полного имени или инициала к фамилии при наличии в группе однофамильцев (например, Смирнов А и Смирнов Д).
- Указание первой буквы фамилии, если список формируется только по именам и в классе присутствуют тезки (например, Елена К и Елена М).
- Использование дополнительных числовых маркеров или номеров подгрупп при объединении нескольких параллельных классов на общем занятии.
Влияние дублирующихся записей на вероятность выбора
Технические дубликаты возникают при неаккуратном копировании списков из электронных таблиц, текстовых документов или учебных ведомостей. При обработке массива каждая отдельная запись воспринимается как самостоятельная единица отбора, даже если ее текстовое содержимое полностью совпадает с другой позицией в перечне.
Наличие дублирующихся записей напрямую искажает математическую вероятность выбора конкретного участника. Если имя одного ученика ошибочно внесено в список дважды, его индивидуальный шанс быть вызванным увеличивается ровно в два раза по сравнению с остальными одноклассниками. Одновременно с этим снижается доля вероятности для всех остальных присутствующих в списке учащихся, так как общее количество позиций искусственно возрастает.
В таблице ниже показаны типичные ошибки при подготовке исходного перечня и способы их устранения перед началом работы:
| Характеристика исходного списка | Пример некорректных данных | Последствие при случайном выборе | Правильный вариант подготовки |
|---|---|---|---|
| Наличие однофамильцев без уточнений | Морозов, Морозов, Волкова | Невозможность определить, кто из двух однофамильцев должен отвечать | Морозов Илья, Морозов Петр, Волкова Анна |
| Технический дубликат записи | Соколов А, Лебедева М, Соколов А | Увеличение вероятности вызова для дублирующегося ученика в два раза | Соколов А, Лебедева М (удаление лишней копии) |
| Присутствие отсутствующих на уроке | Козлов Д (болеет), Новикова Е | Выпадение отсутствующего ученика и необходимость повторного отбора | Новикова Е (исключение отсутствующих после переклички) |
Тщательная проверка перечня перед проведением опроса занимает менее минуты, но полностью исключает технические накладки и сохраняет доверие аудитории к объективности процедуры.
Математический принцип и алгоритмы случайного выбора из списка
С математической точки зрения подготовленный перечень класса представляет собой конечное упорядоченное множество элементов. Задача объективного отбора одного участника сводится к реализации дискретного равномерного распределения вероятностей, при котором каждый элемент множества имеет строго одинаковые шансы стать результатом единичного испытания.
Базовая вероятность выбора конкретного ученика рассчитывается по классической формуле теории вероятностей:
P = 1 / NВ этом выражении P обозначает индивидуальную вероятность выпадения конкретной позиции (в виде десятичной дроби от 0 до 1), а N - общее количество строк в текущем списке участников. Для перевода полученного значения в более наглядную процентную форму результат умножается на 100. Поскольку величина N находится в знаменателе, индивидуальный шанс обратно пропорционален размеру учебной группы: чем больше учащихся присутствует в перечне, тем меньше математическая доля каждого отдельного человека.
Зависимость индивидуальной вероятности от численности учебной группы наглядно прослеживается при сопоставлении типовых размеров классов и подгрупп:
| Количество участников в списке (N) | Формула расчета доли | Вероятность в виде десятичной дроби (P) | Шанс выбора в процентах |
|---|---|---|---|
| 10 (учебная подгруппа) | 1 / 10 | 0,100 | 10,00% |
| 20 (малый класс) | 1 / 20 | 0,050 | 5,00% |
| 25 (стандартный класс) | 1 / 25 | 0,040 | 4,00% |
| 30 (большой класс) | 1 / 30 | 0,033 | 3,33% |
Алгоритмическое сопоставление индекса и работа PRNG
Вычислительные алгоритмы не оперируют анкетными данными или текстовыми строками напрямую при определении результата. Математический отбор всегда выполняется над числовыми индексами, которые присваиваются позициям списка. Для автоматизации этого процесса применяется PRNG - специализированный алгоритм, создающий последовательность чисел, статистические свойства которой приближены к свойствам истинно случайных величин.
Стандартная процедура выбора одного элемента из конечного перечня проходит через четыре последовательных этапа:
- Индексация исходного массива: каждой текстовой записи в списке сопоставляется порядковый номер от 1 до N (либо от 0 до N − 1 в зависимости от принятой в вычислениях системы отсчета).
- Генерация базового значения: при инициализации запроса PRNG вычисляет число с плавающей запятой на полуинтервале [0; 1), где ноль включен в диапазон, а единица исключена.
- Масштабирование на размер списка: полученная дробь умножается на общее количество участников N, после чего дробная часть отбрасывается (округление вниз до ближайшего целого), что дает точный целочисленный индекс в границах существующего перечня.
- Извлечение результата: вычисленный числовой индекс сопоставляется с соответствующей строкой списка, и записанное в ней имя выводится в качестве итогового значения.
Для наглядности можно разобрать численный пример выбора из списка, содержащего 25 учеников (индексы позиций от 1 до 25). Если при запуске PRNG возвращает базовое значение 0,548, умножение этой величины на 25 дает промежуточный результат 13,7. После отбрасывания дробной части и приведения значения к единичной системе отсчета (13 + 1) формируется итоговый индекс 14. Выбранным оказывается учащийся, чья запись располагается ровно на четырнадцатой строчке перечня.
Независимость испытаний и объективность отбора
Ключевое требование к математическому алгоритму при проведении учебных опросов - статистическая независимость каждого отдельного запуска. В теории вероятностей такие операции рассматриваются как независимые испытания: результат текущего выбора никак не определяется предыдущими исходами и не влияет на последующие вычисления. Алгоритм не обладает памятью о прошлых срабатываниях и каждый раз обрабатывает переданный массив заново.
Использование PRNG устраняет характерные для человека когнитивные искажения при ручном выборе. При устном опросе без вспомогательных средств преподаватель невольно учитывает визуальный контакт, расположение парт в аудитории или привычный порядок фамилий в классном журнале, из-за чего учащиеся из середины алфавитного списка вызываются статистически чаще или реже остальных. При алгоритмическом подходе позиция фамилии (на первой, центральной или последней строчке) не имеет никакого математического веса: вероятность получить индекс 1 в точности равна вероятности получить индекс N.
Логика отбора с возвратом и без возврата при последовательных вызовах
При однократном запуске для определения единственного дежурного или отвечающего математическая модель исчерпывается одним испытанием. Если в рамках одного занятия требуется последовательно вызвать нескольких человек, вступают в силу правила комбинаторики, разделяющие процесс на две базовые схемы: отбор с возвратом и отбор без возврата. Выбор конкретной логики работы со списком напрямую определяет, как будут меняться шансы оставшихся учеников с каждым новым шагом и возможно ли повторное выпадение одной и той же фамилии.
Схема выбора с возвратом
При отборе с возвратом исходный перечень учащихся остается полностью неизменным после каждого запуска. Выбранный элемент условно возвращается обратно в общую совокупность перед следующей итерацией. Поскольку общее число записей N в рабочем списке не сокращается, вероятность выпадения любого конкретного ученика на первом, втором, пятом или десятом шаге остается постоянной величиной и рассчитывается по неизменной формуле 1 / N.
Прямое математическое следствие такой схемы - ненулевая вероятность повторного выбора одного и того же участника. Так как испытания независимы, при сохранении полного списка ничто не препятствует генерации того же самого порядкового индекса дважды подряд или через несколько шагов. С точки зрения теории вероятностей шанс того, что конкретный ученик будет вызван два раза подряд при неизменном перечне из N человек, составляет (1 / N) × (1 / N), то есть 1 / N².
Для одного отдельно взятого учащегося эта вероятность мала, однако в масштабах всего класса шанс увидеть хотя бы одно совпадение при серии запусков растет очень быстро. Если в группе из 20 человек провести 5 последовательных вызовов без редактирования исходного перечня, вероятность того, что хотя бы один ученик выпадет повторно, превышает 41%. По этой причине неизменный список подходит для ситуаций, где повторный вызов допустим по условиям задачи, но требует корректировки, если необходимо опросить строго разных людей.
Схема выбора без возврата
Отбор без возврата предполагает, что каждый уже выбранный участник исключается из рабочего пула перед проведением следующего запуска. Исключение выполняется процедурно или путем ручного удаления соответствующей строки из исходного перечня после того, как ученик получил задание или ответил. В результате объем выборки сокращается ровно на одну единицу после каждой итерации.
При такой схеме испытания перестают быть независимыми в рамках всей серии: исход каждого предыдущего шага меняет условия для следующего. Если из первоначального списка объемом N уже были вызваны и удалены k учащихся, то в текущем перечне остается ровно N - k кандидатов. Вероятность выбора любого из оставшихся в списке учеников на очередном шаге возрастает и определяется по формуле:
P = 1 / (N - k)В приведенном выражении переменные принимают следующие значения:
- P - вероятность выбора конкретного учащегося на текущем шаге (в долях единицы);
- N - исходное количество участников в стартовом списке до начала опроса;
- k - количество уже выбранных и исключенных из перечня учеников к текущему моменту (при этом 0 ≤ k < N).
Главная особенность схемы без возврата заключается в гарантированном отсутствии дублирующихся результатов. Каждый участник может быть выбран не более одного раза за всю серию. Если продолжать процедуру до полного исчерпания перечня (когда k приближается к N), на последнем шаге при k = N - 1 в списке останется единственный человек, и вероятность его выбора составит 1 / (N - (N - 1)) = 1, то есть 100%.
Числовой пример изменения вероятностей при опросе класса
Различие между двумя математическими подходами наглядно проявляется при пошаговом расчете шансов для конкретной учебной группы. Допустим, на занятии присутствуют 20 учеников (N = 20), и требуется последовательно вызвать пятерых из них. В таблице ниже показано, как меняется вероятность вызова для одного конкретного (еще не ответившего) учащегося на каждом из пяти этапов при использовании обеих схем.
| Номер вызова (шаг) | Число уже опрошенных до текущего шага (k) | Остаток учеников в пуле без возврата (N - k) | Вероятность выбора без возврата, P = 1 / (N - k) | Вероятность выбора с возвратом, P = 1 / N |
|---|---|---|---|---|
| 1 | 0 | 20 | 1 / 20 = 0,0500 (5,00%) | 1 / 20 = 0,0500 (5,00%) |
| 2 | 1 | 19 | 1 / 19 ≈ 0,0526 (5,26%) | 1 / 20 = 0,0500 (5,00%) |
| 3 | 2 | 18 | 1 / 18 ≈ 0,0556 (5,56%) | 1 / 20 = 0,0500 (5,00%) |
| 4 | 3 | 17 | 1 / 17 ≈ 0,0588 (5,88%) | 1 / 20 = 0,0500 (5,00%) |
| 5 | 4 | 16 | 1 / 16 = 0,0625 (6,25%) | 1 / 20 = 0,0500 (5,00%) |
Как видно из расчетов, на первом шаге (при k = 0) обе схемы дают идентичный результат: шанс каждого из двадцати присутствующих составляет ровно 5%. Однако уже со второго вызова траектории расходятся. При сохранении исходного списка вероятность фиксируется на отметке 5% до конца урока. При удалении ответивших учеников из перечня шанс каждого оставшегося в списке плавно растет: к пятому вызову, когда четверо одноклассников уже опрошены (k = 4) и выбор происходит из шестнадцати человек, индивидуальная вероятность быть вызванным достигает 6,25%. Если же опрос продолжится до десятого человека (при k = 9 и остатке 11 человек), шанс каждого из оставшихся на десятом шаге составит уже 1 / 11 ≈ 9,09%.
При этом важно различать условную вероятность на конкретном шаге и общую вероятность попасть в число опрошенных до начала всей процедуры. Если из 20 человек планируется гарантированно опросить 5 разных учащихся по схеме без возврата, то перед стартом первого вызова суммарный шанс любого ученика оказаться в этой пятерке составляет 5 / 20 = 0,25 (или 25%). Пошаговое удаление записей из рабочего списка как раз и обеспечивает точное соблюдение этой квоты без риска потратить попытку на уже ответившего участника.
Практические сценарии применения на уроках и учебных занятиях
Базовая операция случайного выбора одного элемента из перечня решает широкий спектр организационных и методических задач в учебном процессе. В зависимости от цели конкретного этапа урока преподаватель использует результат одиночного вызова или выстраивает серию последовательных обращений к списку, опираясь на выбранную схему работы с рабочим пулом участников.
Объективный вызов к доске и проведение устного опроса
При традиционном ведении урока выбор отвечающего часто зависит от неосознанных поведенческих паттернов педагога: взгляда, падающего на первые парты, стремления спросить более активных учеников или, наоборот, попыток привлечь внимание отвлекшихся. Это порождает у класса ощущение предвзятости и позволяет части аудитории просчитывать вероятность вызова по косвенным признакам, таким как порядок фамилий в журнале или дата предыдущего ответа.
Передача выбора алгоритму полностью устраняет субъективный фактор преподавателя. Когда имя отвечающего определяется случайным образом на глазах у аудитории, снимаются любые вопросы о причинах вызова конкретного ученика к доске. Процедура проверки домашнего задания или блиц-опроса по терминам переходит в плоскость нейтрального регламента, где каждый присутствующий находится в заведомо равных условиях.
Поддержание концентрации внимания при фронтальной работе
Динамика вовлеченности группы напрямую зависит от того, насколько вероятно для каждого участника включение в диалог в следующую минуту. При фронтальном разборе новой темы, чтении текста по цепочке или устном счете применение отбора с сохранением полного списка служит инструментом управления вниманием аудитории.
Поскольку уже ответивший ученик не удаляется из перечня и сохраняет стандартный шанс повторного вызова наравне с остальными, в классе исчезает типичный эффект расслабления после успешного ответа. Каждый участник вынужден следить за ходом рассуждений, текущим абзацем или промежуточными вычислениями на доске в течение всего занятия, так как следующий вопрос может быть адресован ему в любой момент независимо от предыстории опроса.
Формирование очередности выступлений и защиты проектов
На семинарах, конференциях и уроках защиты индивидуальных проектов острая организационная проблема связана с определением порядка выхода докладчиков. Добровольный вызов часто приводит к заминкам в начале занятия, а назначение по алфавиту ставит в невыгодное положение одних и тех же учащихся на протяжении всего учебного года.
Последовательный отбор без возврата позволяет сформировать прозрачный график выступлений либо непосредственно в ходе занятия, либо перед его стартом. Процедура организуется по одному из двух рабочих сценариев:
- Пошаговый вызов в реальном времени: первый определенный случайным образом участник приглашается к трибуне, его запись исключается из рабочего перечня, а следующий докладчик определяется только после завершения текущего выступления и ответов на вопросы.
- Предварительная генерация полного регламента: перед началом слушаний операция выбора с удалением выбранной позиции повторяется последовательно до исчерпания списка докладчиков, а полученные имена сразу фиксируются на доске под порядковыми номерами от первого до последнего.
Первый подход поддерживает интригу и внимание аудитории к чужим докладам, тогда как второй дает выступающим возможность заранее подготовить презентационные материалы к своему конкретному слоту в очереди.
Распределение индивидуальных заданий, билетов и тем рефератов
Еще одна прикладная задача - закрепление за каждым учащимся уникальной темы эссе, лабораторного варианта, экзаменационного билета или вопроса для самостоятельной проработки. Для этого базовую операцию случайного выбора одного ученика сочетают с заранее подготовленным нумерованным перечнем учебных заданий.
Последовательное сопоставление выбранного участника и темы выполняется по четкому пошаговому правилу:
- Подготавливается фиксированный список тем или билетов, пронумерованный по порядку от 1 до M (где M не меньше числа присутствующих учеников N).
- На первом шаге запускается случайный выбор по списку класса; ученику, чье имя оказалось результатом операции, назначается тема под номером 1.
- Запись этого ученика исключается из рабочего списка участников, чтобы предотвратить повторное назначение.
- На втором шаге операция повторяется для оставшихся N − 1 учащихся, а выбранному участнику присваивается тема под номером 2.
- Цикл продолжается до тех пор, пока за каждым учеником из списка не будет закреплен свой индивидуальный номер задания.
Такой порядок действий заменяет физическое вытягивание бумажных билетов и позволяет быстро распределить учебную нагрузку как при очной работе в аудитории, так и на дистанционных занятиях.
Сопоставление педагогических задач и правил работы со списком
Выбор конкретной методики работы с перечнем учащихся зависит от того, какой результат требуется получить на текущем этапе учебного занятия. В таблице ниже систематизированы основные сценарии использования операции случайного отбора и соответствующие им правила ведения списка.
| Учебная задача на занятии | Рекомендуемая схема отбора | Действие со списком после каждого шага | Педагогический и организационный результат |
|---|---|---|---|
| Фронтальный блиц-опрос и поддержание внимания при объяснении темы | С возвратом | Список остается неизменным на протяжении всего этапа урока | Постоянная концентрация всего класса, включая тех, кто уже ответил на предыдущие вопросы |
| Развернутый опрос у доске или проверка домашнего задания на оценку | Без возврата | Ответивший ученик исключается из перечня до конца текущего урока | Равномерный охват аудитории без потери времени на повторное выпадение уже оцененных участников |
| Определение очередности докладов и защиты учебных работ | Без возврата | Последовательное исключение каждого назначенного в очередь докладчика | Бесконфликтное построение полного графика выступлений от первого до последнего человека |
| Распределение уникальных тем рефератов, билетов или вариантов | Без возврата | Исключение выбранного ученика сразу после закрепления за ним очередного номера темы | Однозначное взаимное соответствие между участником и индивидуальным заданием без дублирования тем |
Чередование этих сценариев в рамках одного урока дает преподавателю гибкий механизм управления групповой динамикой: от точечной проверки готовности отдельных учащихся в начале занятия до поддержания общего тонуса аудитории при подведении итогов.
Конфиденциальность данных при работе со списками учащихся
При проведении уроков с выводом рабочего окна на интерактивную доску или при демонстрации экрана во время дистанционного обучения возникает задача защиты персональных данных учеников. Для выполнения операции случайного выбора не требуется вводить полные анкетные сведения, такие как фамилия, имя, отчество, дата рождения или номер личного дела. Математическая логика отбора опирается исключительно на наличие отдельных строк в перечне, поэтому любую запись можно заменить коротким условным обозначением, понятным только преподавателю и участникам конкретной учебной группы.
Снижение объема вводимой личной информации защищает приватность учащихся, если запись онлайн-урока сохраняется в облачном хранилище, публикуется на образовательных платформах или просматривается сторонними наблюдателями, например при проведении открытых уроков и аттестационных комиссий. Минимального идентификатора достаточно, чтобы однозначно определить вызванного к доске или назначенного для ответа человека внутри коллектива, не раскрывая его личность за пределами учебной аудитории.
Практические способы обезличивания учебного списка
Выбор формата записи зависит от принятых в учебном заведении правил ведения документации, размера группы и формата занятия. На практике для формирования безопасного перечня применяются следующие варианты минимальных идентификаторов:
- Имя и первая буква фамилии (например, «Алексей К.», «Мария С.») - базовый формат для очных и дистанционных школьных уроков, сохраняющий привычное личное обращение без публикации полных фамилий на общем экране.
- Порядковый номер по классному журналу или экзаменационной ведомости (например, «Ученик 14» или просто «14») - полностью обезличенный вариант, при котором сопоставление выпавшего номера с конкретным человеком происходит по бумажному или закрытому электронному журналу, доступному только педагогу.
- Инициалы и номер подгруппы или ряда (например, «А. В. - 1 гр.») - компактная схема для сдвоенных лекционных потоков, лабораторных практикумов и смешанных групп.
- Учебные шифры или индивидуальные коды студенческих билетов - формализованный подход, востребованный при распределении билетов, проведении зачетов, коллоквиумов и публичной защите курсовых работ.
Ниже приведено сравнение различных форматов идентификации участников по степени сохранения анонимности и удобству восприятия в зависимости от формата учебного процесса.
| Формат записи в списке | Пример входных данных | Уровень анонимности для внешних зрителей | Оптимальные условия применения |
|---|---|---|---|
| Имя и инициал фамилии | Дмитрий В., Елена П. | Средний: личность легко узнается одноклассниками, но скрыта от случайных зрителей видеозаписи | Повседневные школьные уроки, вебинары в закрытых группах, фронтальные и индивидуальные опросы |
| Порядковый номер по журналу | Номер 05, Номер 21 | Высокий: полная защита анкетных данных при наличии ключа сопоставления только у преподавателя | Открытые уроки с присутствием внешней комиссии, запись видеоуроков для публичного доступа |
| Инициалы с уточняющим индексом | И. С. (1), И. С. (2) | Высокий: исключает передачу как имени, так и фамилии в открытый эфир | Дистанционные занятия на внешних видеоплатформах, распределение вариантов контрольных работ |
Рекомендации по безопасной подготовке перечня перед демонстрацией экрана
При копировании исходного списка из электронных журналов, ведомостей успеваемости или табличных документов важно предварительно очистить текст от избыточных столбцов. В рабочее поле не должны попадать контактные телефоны, адреса электронной почты, сведения об успеваемости, медицинские группы или примечания для служебного пользования. Если в группе есть ученики с полностью совпадающими именем и первой буквой фамилии, вместо раскрытия полной фамилии достаточно добавить вторую букву (например, «Александр См.» и «Александр Ск.») или приписать к имени порядковый номер по списку. Такой подход сохраняет однозначность результата выбора и полностью исключает демонстрацию чувствительных персональных данных в публичном пространстве.